意外发现土塬,希望可以交一些 XJTU 的朋友 😊
想听听 XJTU 的朋友们日常都在做什么呢?有什么有意思的活动吗?等等
我今天做了一天的数电作业 😇
这个楼后面也许会是一个日记楼,初步打算当朋友圈一样发 🥰
欢迎围观闲聊
三更:
楼里应该会有学习笔记(喜欢 md 但又没有一些好的可以记录和交流的平台,于是放置于此处)和一些 emo 时刻 和乱七八糟的各种没地方放的东西
s 属性大爆发——Study!
四更:
#1 ·
意外发现土塬,希望可以交一些 XJTU 的朋友 😊
想听听 XJTU 的朋友们日常都在做什么呢?有什么有意思的活动吗?等等
我今天做了一天的数电作业 😇
这个楼后面也许会是一个日记楼,初步打算当朋友圈一样发 🥰
欢迎围观闲聊
三更:
楼里应该会有学习笔记(喜欢 md 但又没有一些好的可以记录和交流的平台,于是放置于此处)和一些 emo 时刻 和乱七八糟的各种没地方放的东西
s 属性大爆发——Study!
四更:
记录下进入研二的日子...
秋招失败,转投了保底选调生,目前在南方某沿海省驻村,预计时长(不跑路的话)两年,大致记录一下每日工作。
写在最前面:请不要盒我!
lz 并不希望被认出自己的线下身份 🥺
暂时写不出来
主楼指路部分删除了大部分水源日记楼链接 仍然保留的水源链接是因为链接指向的内容属于其他创作者或未被转载至门
这表明本日记楼的本土化程度极大增强 
随便写了一点,大概是作为对半年前的自己的答复吧。
很难想象,自从我在水源建楼以来已经过了半年,这其中又包含了多少建楼之时难以预料的变迁,难以想象的悲欢。当时的鱼鱼想必无法想象自己会离开水源,更无法想象自己能够在土源上岸、更加恣意地生长。
这应该是我在离开后的第一天的祈愿。回望现实,它究竟实现了多少?
备考目的大概是达成了,本学期期末考的成绩除了被某几门课程恶心了之外,总体和上学期相比也有了很大的提升。土源也以它如盛唐长安包容万国衣冠一般的好客特质,接纳了我这个来自 sjtu 的赛博流浪者,让我有了“此心安处是吾乡”的归属感,并逐渐在开拓独属于自己的一隅天地的过程中,重新建构起全新的稳态。比起水源层出不穷的炸裂大瓜,我还是更喜欢在土源缓慢更新的宁静氛围中沉淀、成长。我在水源“交我平凡”中笃定地说出了“我爱水源”,现在,我也可以笃定地说出,我爱土源,并且再加一句,土源社区是我的家园。
之前我提到了,希望自己能够“保有对阅读的热爱”,遗憾的是,上学期仍然未能阅读多少专业课程以外的书,希望暑假可以多阅读一些书籍吧。
至于回忆部分,我希望暑假能再写写,但感觉想写的东西上学期似乎写的差不多了。本想给高三首考后的回忆写个关于高考的终章,但高三又有何终章可言?源自高三的焦虑乃至糟糕的睡眠仍在折磨着我,而且我甚至在无数次低效学习时希望着自己能够重拾高三时学习的效率。我的高三绝不快乐,但正因如此,我认为我更加需要在被诗化记忆彻底欺骗之前,尽可能忠实地记述自己经历过的一切。不过高三也有快乐的时刻——和老师聊天时,感觉这值得一写,先挖个坑。
还是很难相信自己怎么已经大二了,我的迷茫仍在持续,因此,“怎么办”的求索以及对于这个问题不定期的答复也不会停止。
先到此,因为我写不下去了。
紫金港第一皮革鱼
250726
话归正题,这是一个犹豫许久后建立的日记楼。我接下来会简要谈谈它的命名由来以及内容构成。
lz 的用户名“Comment faire”为法语中的“怎么办”。以“怎么办?”为日记楼命名,首先明示此楼的归属。其次,“怎么办?”这个疑问句传达着 lz 在人生的十字路口的迷茫情绪。lz 进入交大以来由于一系列原因一直处于 emo 状态中,专业课是学不会的,成绩排名是不行的,聊得来的人是没几个的、而且只能线上联系还不一定会有回应……至于未来的发展方向,lz 更是近乎一无所知 ,但 lz 唯一知道的就是自己想要尽全力逃离上海,因为这座城市给我带来的回忆几乎都是痛苦的,它商业化、事业心强的城市气质也和我格格不入,lz 不知道自己要去哪里,但是绝对不想再待在上海了……
此外,“怎么办”也是车尔尼雪夫斯基和列宁都采用过的书名。lz 希望自己也可以 (保有对阅读的热爱) 如这些前辈一般,在一次次“怎么办”的叩问和随之进行的思索中,明晰自我前行的方向,少一份迷惘彷徨,多一些坚定勇毅。
本楼可能包含一定生活碎片和零零散散的思考痕迹。lz 个人自小倾心于“致广大”而非“尽精微”(一个不恰当的譬喻,lz 明白本来这两者不应该形成庸俗对立),并不喜欢关注生活的琐屑,但作为不资深的 pig2 仍然对美食和旅游有相当多的兴趣。同时,由于 lz 并不想被盒出线下身份,所以本楼也很可能不会出现生活实景、具体专业学习之类的内容。lz 完全不接触二次元,也没有时间玩游戏,因此本楼不会出现二次元、游戏相关内容。
本楼很可能随机掉落 lz 作为一个做题家对过往生活的回忆。
在此摘录《往事与随想》开头很打动我的几段话:
“我决定写下来;但是一个回忆唤起千百个别的回忆;一切接近遗忘的旧事复活了:少年时代的理想,青年时期的憧憬,豪迈的青春岁月,监禁和流放——这些早年的厄运没有在我心头留下一丝阴影,倒像穿越长空的春雷,以它们的巨响唤醒和激励了年轻的生命。”
“有些往事需要经历相当久的时间,才能形成一个清晰的观念——一种无可奈何、令人伤感,但又能获得谅解的观念。不经过这一步,写成的东西可能是真诚的,但不可能是真实的!”
lz 显然不具有赫尔岑的阅历(什么显而易见的东西也往上面写),可能会回忆到的往事也没有经历足够长的时间的磨洗,客观性大概是一点也没有的,如果有人来看大概也就是看个乐子,不过这确实不重要。
这栋楼没有召唤术,因为 lz 不知道该召唤谁。 🥺
最后的最后,如果你看到了这里,
(中二预警)
那么——
我们仍然同心同德……
并将再度踏上孤独而忧伤的征途,
不倦地呼号真理——
哪怕希望扬长而去,人们毫不眷顾!
Comment faire
记于 2025-01-26
lz 终于知道可以召唤谁了🥹: @兴庆宫第一迷路幽灵
感谢 @anon60679752 的分享
最近在一些群里看到有课题组招本科生
因为不是第一次见到,并且笔者也是做 ai 的,只不过没在本校,出于好奇,就去搜了搜这个组的主页和论文列表。
这个组 2026 年产出了整整 12 篇文章,其中有四篇中了 a 会。
我虽然并不赞成小红书上所谓的“慢科研”倡议,大伙为了毕业升学发文章无可厚非。
但搜了搜这个组的文章感觉很奇怪
第一,几乎全都不开源,开源也是完全没办法复现


让 agent 搜了一下 12 篇里边只有 3 篇有仓库,已有的仓库也是完全没办法复现,开源整理做的很差,模块更是少了很多。如果有做类似方向的 uu 应该知道这意味着什么。
无意对学术诚信有质疑,但在 ai 这个领域一年 12 篇文章,方向多样且都是热门但没有一篇可复现,开源完整是否有点过分了。这样的工作也很难有影响力。
第二,本科生参与这些项目能得到怎样的培养?
这 12 篇普遍署名不少,但一作却比较集中在一两个人。在这种方向领域多样又高产的领域,很容易会让人觉得是把本科生当耗材的情况,但好像群里发推广的人对这个组的评价很不错,所以真实情况到底是怎么样的笔者也很难清楚,但这个署名情况肯定不算健康。
笔者发这个文章的目的只是希望低年级本科生科研可以多了解一些信息,而不是只看课题组名气和宣传,希望大家多多筛选多方收集资料。因为笔者在大一大二也吃过这样的亏。如果有人想看后续也可以写一些 cs 选组指南。
也想请了解这个组、用过这些代码,或者实际参与过项目的同学分享一下经历。如果我对论文状态、仓库或团队情况有理解错误,也欢迎指出,我会修改。
Wolfram: 我现在可以直接对 ChatGPT 说:“写一段代码,然后在我的电脑上运行。”这种体验使“究竟可能出什么问题”变得极其具体。以前这还是抽象的担忧,现在我会认真思考:如果真的让它执行操作,我应该把它放进什么样的沙箱?这个问题可以直接推广到整个世界。一旦我们把某些事情交给 AI 管理,究竟需要施加多少限制?当 AI 开始控制武器乃至各种重要系统时,我们应该如何规定它能做什么、不能做什么?
Lex: 这种能力让你更兴奋,还是更害怕?还有一个有趣的悖论:AI 本身知道沙箱是什么,也可能掌握突破沙箱的工具。
Wolfram: 说实话,我确实有一点害怕。这是一个不可能仅凭“让它完成任务”就解决的问题,我们必须理解系统能够执行哪些行动,以及怎样设置边界。
Lex: 欢迎来到我的播客。这是 Stephen Wolfram 第四次来访。你是计算机科学家、数学家、理论物理学家,也是 Wolfram Research 的创始人,推动了 Mathematica、Wolfram Alpha、Wolfram Language,以及 Wolfram 物理学与元数学项目。你长期研究现实的计算本质。你宣布将 ChatGPT 与 Wolfram Alpha、Wolfram Language 整合,我想先从哲学与技术两方面谈谈:大型语言模型和你建造了几十年的计算系统,根本区别是什么?
Wolfram: ChatGPT 的核心能力是生成人类语言。人类在互联网以及其他地方留下了海量文字,语言模型读过其中巨大的语料。当你向它输入提示,它尝试接着写出符合这些文字统计规律的内容。其底层使用神经网络,按一个词元接一个词元的方式产生输出。与全部训练材料的规模相比,每一步生成所涉及的计算相对浅。它的力量在于汲取人类已经写下来的表达方式,再延续这种模式。
我过去大约四十年建立的计算技术栈,目标完全不同。我不是拿现有文字的统计分布去预测下一句话,而是把数学、逻辑和文明长期积累的系统化知识转变成严格的形式结构,然后进行许多步骤、甚至任意深度的计算。我们希望获得的不是“网上有人曾经怎样描述”,而是过去从未有人算出过的新结果。只要一个问题在原则上能够利用积累的专业知识得到答案,我们就试图让它变成可以计算的问题,并在已知知识的限制内尽可能可靠地算出结果。构建这种系统必须投入大量人工工作,设计形式语言、整理数据、建立函数与规则,而语言模型则可以从人们原本为别的目的写下的海量内容中学习。因此,我常把语言模型描述为“广而浅”,把计算知识系统描述为“广而深”,尤其强调后者的深度。
这也是人类智力史的一条主线。如果回到一千年前,人们凭直觉与日常经验就能迅速弄清一些问题,但有许多问题靠直觉根本无法解决。后来我们发明了逻辑、数学、科学等形式化方法,让推理可以一级一级向上累积:我知道 A 能推出 B,再推出 C,接下来就能得到远超直觉所及的结论。我希望计算语言提供的正是这种能力:不是凭记忆觉得“我在别处见过类似答案”,而是沿着明确的推导链逐层构造知识。
Lex: 那么,这样一棵很深的可计算知识树,最底层究竟是什么?我们该从怎样的形式基础出发?
Wolfram: 必须区分两个问题:计算本身在原则上可以是什么样子,以及人类的思维、文化和知识能够理解计算宇宙中的哪些部分。我们平常写程序,往往事先知道想让它做什么,认真写下一行行代码,希望运行结果符合意图。我研究的却是程序的“自然科学”:随便选择一个极其简单、甚至不到一行代码的程序,或随机拼出简单规则,然后运行它,看看究竟会产生什么。
我在二十世纪八十年代初发现了一件很令我意外的事:极其简单的程序也可能生成惊人复杂、完全出乎意料的行为。那时我花了几年才真正接受这一点。后来我越来越相信,自然界也是这样工作的:底层规则可以简单,宏观现象却极端复杂。这一思路最终延伸到我对物理学以及整个宇宙的研究。计算宇宙包含丰富而复杂的可能性,但其中许多程序的行为,对我们来说不像任何熟悉的人类活动,我们根本不知道该怎样描述它们。
所以真正的挑战,是把计算宇宙里“原则上能算”的东西与人类“能够思考、能够关心”的概念联系起来。后一个集合还在历史中不断变化:人类发明数学,发展新的思想与概念结构,渐渐开拓更多的知识空间。我们需要一种接口,把思维中已经形成的概念准确地接入计算。我的答案就是符号编程和符号表示。
Wolfram: 想象你看着一间房间,视野中存在大量像素,但你回忆时通常不会记住每个像素的颜色与位置,而会说:“那里有两把椅子和一张桌子。”我们已经把复杂的视觉场景压缩成了符号。自然语言是人类重要的符号系统,“椅子”就是其中一个词;然而自然语言本身不够精确,你很难仅凭这句话自动算出所有后果。符号编程的任务,是把人类在语言中理解的对象、关系和操作变成能够运算的精确定义。
大约在 1979 年,我为自己最初的大型计算机系统思考高层计算表示方式,最终采用了符号表达式:可以把一个表达式看成一个函数以及若干参数,但它不一定立刻求值,也可能只作为一种结构存在。它既表示计算,又表示概念本身。此后四十多年,我发现这样的结构竟然非常贴合人类理解高层抽象事物的方式。这一点最初连我也没能预料到。
Lex: 可是你并没有从最底层的物理超图开始,一步步重建每个概念。你往往跳到最高且能够转化为计算的抽象层,用符号表示直接建立一块知识的基础,再把不同领域整合起来。这样的“捷径”究竟为什么成立?
Wolfram: 这引出了我认为对未来极端重要的概念:计算不可约性(computational irreducibility)。假设你知道一个系统的规则,当然可以运行它一百万步,再看结果是什么。可问题在于,你能不能不经过那一百万步,直接得知答案,例如直接说结果是 13?有些计算可以被捷径替代,但大量计算不行。对不可约的过程,要知道结果就必须真正让过程发生。如果所有结果都能预先简化出来,做原来的计算本身就没有那么大的意义了。
拿我对宇宙的模型来说,我们可以设想空间由基本的“空间原子”及超图构成,并依据超图重写规则演化。假如宇宙每秒执行大约十的百次方次更新,即便我们掌握了全部规则,也不代表自己能够直接算出未来。宇宙自己可以执行那些步骤,但身处宇宙之内的我们,没有机会比宇宙更快地把同样不可约的演化全部做完。要知道其结果,唯一办法就是执行该计算,也就是让宇宙继续演化。
科学和技术在很大程度上是在不可约的海洋中寻找可约性的局部区域(pockets of reducibility)。虽然我们不可能处处跳过全部计算,但某些地点和尺度上确实可以“提前跳几步”,找到可靠规律。这里有一个深刻的特征:计算不可约的系统仍然有无穷多个局部可约之处;不能完全把所有过程压缩掉,并不意味着任何事情都无法预测。我们生活的世界,恰好处在一个拥有足够多可预测结构的切片里。所谓较高层级的抽象、符号表示和简单的科学叙述,就是抓住这些局部稳定规律,把它们作为思考的支点。
举例说,房间里每个空气分子都在复杂地运动。如果追踪所有分子的轨迹,整个过程可能不可约,但我根本不在乎每个分子往哪儿去。我只需要知道几秒钟之后房间里仍然有空气,宏观性质没有明显变化。这是一个可以预测、可以简洁表述的事实,它浮现在复杂的微观过程之上。若没有大量这样的可约区域,我们熟悉的生活方式也难以存在。
Lex: 换句话说,能够被我们体验的现实,依赖于这些可以压缩成符号的局部规律。我们的观察者身份,是不是由此而来?
Wolfram: 至少我们所理解的生活确实如此。我们认为空间中的一个人可以从这里移动到那里,依然是同一个人,即使在我的物理学模型里,这个人在不同时刻由不同的空间原子构成。这种稳定与连续性是一种宏观可约现象。我近年来最喜欢的一项发现,就是认识到:底层的计算不可约性与我们作为观察者必须寻找可约规律的特点相互作用,可能导出二十世纪物理学发现的主要定律。
我们是计算能力有限的观察者。我们无法在头脑中容纳全部不可约的微观细节,只能提炼、压缩,把现实投影到较少的概念和自由度上。除此之外,还有一个看似平凡、其实至关重要的假设:我们相信自己会在时间中持续存在。我的理论认为,空间的微观构造时时刻刻都在重写。空间之所以形成相互连接的整体,恰恰因为大量局部更新过程在不断把它编织起来。就像流体的性质来自分子的相互作用:如果分子毫不相干地漂浮,你也不会得到能够流动、倾倒的连续液体。
因此,我会问:既然构成我们的微观结构不断被替换,为什么我们仍然觉得“我就是同一个我”?这和意识中的连续经验有关。我们通常相信自己拥有一条持续的主观体验线索,而不是同时分裂成许多彼此独立的体验。
Lex: 这种时间连续性,会不会只是大脑的一项局限?我们为现实编织了一个有连续主角的故事,借此将难以处理的世界简化了?
Wolfram: 它确实是简化,但也是人类通常运作方式中的关键一环。可以想象某种心智有多条并行的体验线索,甚至某些与我们不同的心智也许就是这样。在量子力学的底层图景中,事物可以沿许多不同分支演化;可是为了让人类与它互动,我们必须把分支中的信息重新组织成“先发生了一个确定事件,接着又发生一个确定事件”的叙述。不同人的心智已经拥有不同的体验线索,我们相互交流,但每个人的体验内部似乎形成一条主线。一个一般的计算系统则不必具有这种特征。
所以,我不认为意识必然是宇宙里最高级、最普遍的计算现象。它可能反而是一种特殊的计算组织形式:观察者受到能力限制,必须压缩复杂现实,同时把自身经验整合成一条时间上连续的线索。宇宙中完全可能存在远比这种经验方式更奇特的计算过程。
Lex: “观察者”在量子力学、日常生活和意识研究里都扮演重要角色。如果把它放进整个计算宇宙,我们该怎样定义一个观察者?这只是物理学问题,还是也与人工智能有关?
Wolfram: 两者都有关。这其实是我接下来很想研究的项目,只不过最近 AI 的巨大热潮打乱了安排。我们早已知道如何用图灵机等模型讨论一般的计算系统,却仍需要一套相应的理论,解释一般的观察者到底是什么。我们当然可以想象某个完全不同于人类的外星观察者,它能够直接处理复杂、不可约的信息,对现实有着与我们不可沟通的理解方式。但对人类这样的观察者来说,关键机制是把庞大世界中的细节压缩成少量能够容纳进头脑的自由度。
例如,盒子里的气体分子不断撞击活塞。对测量气压的观察者而言,每个分子在什么时候、以什么角度撞击,并不是最重要的。他只关心所有撞击累积产生的压力。无数种不同的分子排布,在“气压是多少”这个问题上都可以视为等价。观察者的一项核心工作,就是把不同微观状态归入同一宏观等价类。 我们反复看到同样的情形:世界里有极多细节,人的思维却只能抽出一层薄薄的摘要。
Lex: 但这种摘要必然是真的吗?它可能只是平均意义上大致正确的粗糙近似。人类头脑,尤其是自然语言中的含混表达,看起来就是由许多粗糙近似组成的。也许模糊与歧义本身就是观察者的一种特性。
Wolfram: 没错。即便通常情况下只测量分子冲击的平均值就足够了,也存在极低的概率,分子会形成某种极端反常的排列,使平均量无法告诉你真正重要的事。科学研究常常忽略这一点。我读到过许多论文,作者画出精美的曲线、误差条,用一个数字或一条趋势描述复杂系统,却不一定意识到自己压掉了系统最有特点的性质。
很多年前,我研究过雪花生长。相关论文可以很好地计算雪花的生长速率,但我仔细检查模型后发现,按它们的计算,雪花应该长成一个球体。它们可能算对了一个数字,却完全没抓住雪花究竟是什么样子。真正的雪花在形成时,水分子排列成六角晶体结构,最初是一片六角形的薄板。随后它会产生树枝状的分叉。我们可以用非常简单的元胞自动机等离散模型模拟这种过程。
生长中的雪花很有趣:每次水蒸气凝结出一小块冰时,都会释放热量,使附近局部升温,于是邻近位置短时间内不那么容易继续凝结。局部的生长抑制促使冰晶伸出彼此分离的枝杈;枝杈继续分叉,新的小枝又长出更小的枝。经过若干轮,它们甚至会逐渐填补形成更大的六角形,然后再伸出新枝。我最初在一个简单模型里发现,重新填满六角形时会留下小洞。我怀疑这是不是模型的假象,后来查看真实雪花照片,发现它们确实有类似的小孔,仿佛枝杈生长留下的疤痕。这些洞不会简单地从内部回填,结构会随着后续生长继续保留。
Lex: 雪花能无限长大吗?你说它“蓬松”,可单片雪花通常是平的,为什么不是立体地向外生长?如果“蓬松”意味着三维空间里的空隙,那究竟是单片雪花蓬松,还是很多雪花堆起来才蓬松?
Wolfram: 雪花长到多大,我没有确定的上限答案。它终究会从空中落到地面,但实验室里似乎能培育很大的晶体,观察到多轮“六角形—枝杈—更大六角形—再生枝杈”的过程。典型单片雪花大致是平面的,所谓雪的蓬松,主要来自许多带有枝杈的雪花堆积时无法紧密贴合,内部保留了大量空气。反过来,假如雪花只是规则的六角薄片,它们比较容易堆在一起,也能相互滑动,我认为某些雪崩便可能与这类滑动有关。
人们常说世界上没有两片完全相同的雪花。它们的生长规则事实上相近,许多枝杈会按照相同机制形成,但每片雪花穿过空气的路径、环境和被观察到的生长阶段都不同。你在这个阶段捕捉到一片,在另一个阶段捕捉到另一片,看起来就很不一样。重要的是分清规则相同与具体形成史不同。当然,如果你只关心冰晶枝杈的生长速率,那个预测准确却得出球体外形的模型可能仍然有用;但如果你真正关心的是雪花复杂的几何形状,它显然无法回答你的问题。
Lex: 所以科学模型不是把现实中发生的一切都照原样装进去,而是抓住我们关心的结构。Wolfram Alpha 和 Wolfram Language 的目标,也是找到尽量简单、同时能精确表达重要信息的符号模型,对吗?
Wolfram: 是的。模型意味着把现实缩减成一种可以叙述、可以抽象并能回答特定问题的形式。假如你要求它回答系统中所有可能的问题,那么唯一完美的模型就是系统本身。只要做了抽象,你就可能失去某个特定分子的轨迹或者其他细节。科学界常有人争论一个模型是否“正确”,但双方关心的性质可能不同。一方觉得它预测得很好,另一方却发现模型完全没有表现自己研究的关键现象。通常真正应该问的是:它是否保留了我想研究或想用来制造技术的那些性质?只有当你试图建立一个穷尽宇宙底层的模型时,才会出现某种意义上的“完整正确”;但即便如此,观察者如何采样现实仍然会使事情复杂化。而且,即使找到了宇宙的全部底层规则,由于计算不可约性,实际能完整运行该模型的仍可能只有宇宙本身。
假设我们建立有关电影的知识库。理论上可以记录每部电影每一帧的所有像素,但人们一般关心的是片名、人物、创作者、情节、上映时间等内容。自然语言常常指向人们所关心的层次,我们要做的是把这些层次变成可以精确计算的表示。当一个人把自然语言输入机器,机器能继续生成句子,这是不是就叫“理解”?很难定义。但在计算知识的范畴里,我可以给出一个更明确的标准:它能否将输入转化为符号计算结构,并由此严格计算出各种后果?这是我们为自然语言理解设定的一种可操作目标。
人类要推进知识,不能只停留在大致的口头谈论。数学之所以能推得很深,正是因为它有明确的形式结构。计算语言也在努力形成一种描述现实的形式体系,使我们可以像在数学里那样,一步接一步地建立推论之塔。
Lex: 互联网充满表情包、日记、文章和各种表达,GPT 从中学习;另一边是定义严格的 Wolfram Language。两者之间怎样建立映射?是人工编写规则,还是可以自动完成?大型语言模型又会带来多大的提升?
Wolfram: Wolfram Alpha 的前端本来就在做自然语言到计算语言的转换。你问“某个国家的首都是什么”或“芝加哥与伦敦相距多远”,系统就会把问题映射到明确的城市实体、地理距离运算等结构。对于芝加哥,我们不仅有城市的名字,还整理了它所属的州、国家、地理位置、人口等经过策划与校验的数据。每个对象和操作都获得明确的含义,然后我们才能真正计算。
从当时的时间点看,Wolfram Alpha 已经运营约十三年半;对于实际提交的那些常见简短查询,我们的处理成功率大约达到了 98% 到 99%。当然,这个比例受反馈循环影响:用户发现哪些查询有效,就倾向继续输入这些查询。因此不能把它理解为任意复杂自然语言都被解决了。但对于数学、化学和大量知识查询,我们的确能相当成功地将简短的表达转为可计算形式。
从 Wolfram Alpha 刚诞生时,我就考虑过能不能直接用自然语言编程。2010 或 2011 年前后,我写过一篇题意大致是“用自然语言编程真的将成为现实”的文章,也做过一些带机器学习色彩的实验,不过那时远远没有今天大型语言模型使用的海量训练数据。有件小事很有意思:Steve Jobs 曾把那篇文章转发给苹果公司的很多人,因为他一直不太喜欢编程语言所要求的那层工程化结构。他很乐意看到人们可以直接表达想做的事,而不必掌握那些技术细节。我想他会喜欢今天的进展。正如过去写汇编语言需要懂操作码,后来我们可以不再为这些细节操心一样,将来人们未必需要先学习计算机内部如何工作才能编程。
但这里还有很重要的问题:自然语言提示能有多复杂?它可以承载多高层级的抽象?以当时的 ChatGPT、GPT-4 为代表的模型,已经显示出不错的转换能力,尤其当交互不止一次提问,而是一轮又一轮的对话时,工作流会变得很有意思。我们也在为这一过程开发专门的工具,不过我仍然在努力弄清其中的最佳工作方式。
有一个前提不能跳过:使用者必须对“怎样计算地理解问题”有一点基本直觉。你不能对计算完全没有概念,却期待随意走到机器前就能提出良好的计算任务。我十岁第一次见到一台巨大的主机时,还不懂电脑能做什么,就问:“它能算出一只恐龙有多重吗?”在当时的语境中,这不是一个好问题。今天你倒可以对 Wolfram Alpha 问“一只剑龙通常多重”,它会根据已有知识给出答案,但你仍得理解:这是调用某类知识并完成计算,不是电脑凭空知道任何事情。对教育而言,我更在意培养计算式思维,而不是让所有人先学计算机科学的专业细节或某种编程语言的语法。
Wolfram: 计算式思维和传统逻辑、数学一样,都是对世界的形式化理解,但计算还多了一项能力:如果你成功地把问题描述为程序,计算机就能替你展开后续推导,不必把每一步都留给人手工完成。现在比较典型的流程是:一个人先有基本意图,知道自己希望分析什么,接着用模糊一些的日常语言向大语言模型描述计算任务;模型综合这些文字,合成一段 Wolfram Language 代码。我们已经积累大量自然语言输入及其对应代码的实例,所以这类转换有望继续改进。
Lex: 生成代码之后,使用者还要自己调试吗?举一个简单例子。也许是你前面说的恐龙重量,或者别的日常数据处理任务。
Wolfram: 我可能会说:“取出我的心率数据,按七天计算移动平均,然后把结果画成图。”在 Wolfram Language 里,这通常只需要很短的一段表达式,可以用移动平均函数和列表绘图等操作完成。即使我刚才用自然语言说得不是特别严谨,模型也可能识别出我指的是“七天移动平均”。当然它到底能否从每一种含糊说法里准确提取这一概念,还需要看具体情况。
接下来模型生成代码。我发现合适的代码一般比较短,如果输出忽然非常冗长,往往反倒值得怀疑。设计 Wolfram Language 的目标之一,就是让它像数学记号一样,不仅能由人写给计算机执行,还能够由人直接阅读理解。传统编程似乎常是“人写、计算机读”的单向活动,但我们一直希望人也能检查程序的含义。实际工作中,通常先运行生成的代码,检查得到的表格或图表。如果结果显然荒谬,就回过头去读代码、发现逻辑偏差,再修正它。如果结果非常重要,你必须真正看懂代码,以确认它确实做了你要求的事情,而不是仅仅输出一个看似合理的答案。
此外,调试并非只能由人完成。你可以告诉语言模型:“这里输出不对,请把这部分改成某种做法。”它往往能够直接修改代码。我们当时开发的 ChatGPT 插件也会反复执行这样的循环:把计算请求发过去,取得结果,模型发现结果不合情理,就礼貌地表示需要修改程序,再生成另一版本并重试。于是调试不只是盯着源代码,还可以利用输出反过来判断程序到底在做什么。
这里牵涉到我们多年前发明的 Notebook(笔记本式计算环境)。它将文字、代码、输出结果放在同一个可交互文档里;现在我们正在探索怎么把这种环境和对话式交互结合。程序运行时如果报错,模型不仅可以读错误信息,还可能读取调用栈、内部追踪数据以及前面的程序上下文。人类看到一大串栈追踪常常会眼花,但模型可以把其中许多信号一起纳入判断,给出相当好的错误原因解释。
Lex: 也就是说,调试时它能看到调用栈、此前的代码、对话里写过的自然语言,以及人平常未必愿意逐项读完的信息?
Wolfram: 对,而且不止这些。某个错误消息在文档里有解释,过去也有类似错误的实例,都可能成为可用资料。我们甚至在处理失败情况的提示里写下一个非常直接的要求:“去读文档。”插件提供了阅读文档的工具,这个步骤往往极其有效。语言模型有时会臆造不存在的函数选项,或者错误理解某个函数的参数结构;查阅权威文档就有机会纠正这些问题。我们过去几十年为人类建立了一个尽量一致、连贯、容易理解的语言体系,却没想到它还有副作用:AI 也更容易理解这样的语言。
Lex: 听起来 Wolfram Language 像另一门自然语言。你把英语、法语、日语、西班牙语和 Wolfram Language 摆在一列,语言模型也许可以类似地学习它们。
Wolfram: 在一定意义上是的,但这里更值得追问的是:ChatGPT 为什么能工作?为什么一个参数数量看起来相对有限——虽然可能也有几千亿个神经网络权重——的系统,能生成如此多种自然语言表达?我认为它暴露出语言本身存在某种人类尚未充分理解的规律。这不仅是名词、动词、形容词如何排列的句法规则,还有涉及意义的语义语法(semantic grammar)。
Wolfram: 我们对语言的一项古老发现就是逻辑。我想象亚里士多德可能听过许多演说,发现有的推理有效,有的无效。演说所讲的可能是波斯人与希腊人,也可能换成猫和狗,但某些论证结构不随谈论对象而变化。你可以把具体对象改写成 P 和 Q,提取语言背后的形式关系。这是非常了不起的发现。
亚里士多德研究三段论。到了中世纪,学生要学习并记住不同的有效推理模式,我记得其中大约有十几种,还配有 Barbara、Celarent 之类的助记名称。人们通过辨认这些模式来判断论证形式是否有效。再后来,George Boole 进一步抽象出布尔代数:与、或、非可以任意深地组合嵌套,从而产生能够被机械求值的计算结构。相比之下,ChatGPT 在某种程度上仍然像在亚里士多德的层次上学习海量语言模式;它观察许多句子,从中归纳出模式。布尔代数则展示了怎样由有限形式规则发展出任意深的计算。
不过 ChatGPT 的出现也让我觉得,亚里士多德当年还可以从语言里提取出更多东西,逻辑仅是语义结构的第一步。语言中可能隐含许多局部的“小代数”“小演算”。比如说,我从 A 地到 B 地,再从 B 地到 C 地,那么就已经完成了从 A 到 C 的移动。无论我是坐飞机、走路还是游泳,这种移动的传递关系都成立。但如果 A 是 B 的朋友、B 是 C 的朋友,却不能推出 A 一定是 C 的朋友。不同的概念领域有不同的关系法则。这些法则并非单纯的词性排列,而是我们用语言表述世界时所带入的关系结构。
Lex: 你说的东西似乎比形式逻辑复杂得多。是否可以称它为“语言的法则”,甚至“思维的法则”?GPT 是否在训练中重新发现了支撑语言的语义法则?
Wolfram: “思维的法则”恰好是 Boole 曾用过的名称。语言模型能在大量句子中发现逻辑和其他模式,确实提示我们存在某种数量有限的语义规律。句法语法给出“怎样造出语法正确的句子”的工具箱;语义语法则可能给出“怎样造出具有意义的句子”的工具箱。如果你随意组合名词、动词,即使词序正确,也可能得到完全无意义的表达。这意味着在句法之外必然还有约束。
例如“那头大象飞到了月球”,从语义上说我们大致知道这句话在描述什么,尽管它没有在现实中发生。这样一来,“语义正确”与“事实上发生过”“物理上可实现”就不是同一件事。语义规则也许取决于人类的想象、实际经验以及我们用语言描述什么,边界并不容易划清,甚至有某种循环性。我猜测这样的规则可以概括为相对有限的一组,但我们还不知道到底有多少。
再来看“运动”这个看似最普通的概念。它指的是同一物体能够从 A 地移动到 B 地,而仍然被我们认为是同一个物体。这个定义并非总是成立:如果你把一把茶壶带到黑洞的时空奇点附近,它可能被扭曲得无法辨认,就不能简单地说只是一个不变的茶壶移动到了另一处。我们通常依赖的运动概念,本身已经包含了关于对象身份、持续性及空间结构的假设。只有接受这些假设,我们才能进一步谈运动的传递性质,并形成相关的语义规律。
Lex: 如果 GPT 真在学习这些思维法则,那它最后会不会发现一套完整的系统?而在计算宇宙里,又为什么只有某些计算会被我们认为有意义、有智能?
Wolfram: 计算宇宙里有大量可能的计算行为,绝大多数不是人类历史上愿意谈论或使用的东西。这既可能与人脑的神经网络结构有关,也与我们的社会和文化兴趣有关。人工智能完全可以探索人类从未想到的奇异计算,但我们特别欣赏的,往往是能够用人类熟悉的语言、谈论人类感兴趣的问题的系统。以人类反馈为基础的强化学习,就在某种程度上把模型引向这些人类认可的表达和行为。
技术史也是这样。物理世界存在无数现象,只有少数会因为能服务于某个目的而成为技术。古人捡起一块含硅的岩石,不会特别关心其中的硅;当我们知道可以从相关材料制成半导体晶圆、再制造微处理器时,它突然变得极其重要。又比如,当时关于一种涉及镥元素的高温超导材料的可能性传出消息,原本很少被普通人注意的镥立刻受到关注。文明不断决定什么值得关心;被关心的计算对象和物理性质,也就随之变化。语义语法很可能反映的是这种人类独特的关注结构,而不必是整个计算宇宙的全部结构。
Lex: “移动”还能相对清楚地形式化,但“爱”“恨”这样充满情感的词怎么办?当我们说 A 恨 B,究竟是什么意思?又或者“软件正在吞噬世界”这样的隐喻,难道没有某种精确的意义吗?
Wolfram: 词语的含义来自社会使用方式,它不像计算语言里的函数那样自带固定的文档。在计算语言里,一个基本构件要有清楚定义、代码实现和说明,使人能够在它之上继续建造越来越高的计算结构。但“恨”没有标准的函数说明书,人与人使用它时也未必指向同样的内在经验。“吃”看似简单,可我们说动物吃东西,也会说一个函数“吃掉”参数。沿着比喻还可以继续问:函数会不会中毒?如果遇到类型不匹配,在某些编程语言里也许真能产生类似的效果。但到哪里为止,这些仍然只是类比,不等于两个过程拥有完全相同的形式定义。
我当然不否认隐喻具有实际意义。语言原本就是把一个心智中的思想包装起来,让另一心智能接收到某种影响的办法。文学和诗歌会让不同读者产生不同的理解,甚至这种依赖各自经历的差别就是其价值。只是当目标是建立严谨的计算系统时,我们首先要选择能产生明确后果的含义。用一首充满隐喻的诗来定义程序,远比用清楚、平实、普通的陈述来定义它困难。把诗歌全部转化成严格计算对象后,很可能只剩下很少一部分原来的丰富性,但这不意味着原来的交流毫无意义,也不意味着人与人之间那些没有明确任务目标的交流只是空转。我们还需要考察语言如何影响接收它的具体心智,而这个影响未必独立于双方的经历。
自然语言是人类最伟大的发明之一。我们不知道其他物种是否也具备相应能力,但在人类身上,它让抽象知识能够跨代传递,而不必仅依赖遗传或模仿训练。我们可以向下一代直接讲述某种概念,而不像有些鸟类那样主要通过生活与行为示范延续技能。当然,自然语言会随文化和历史改变:遇到一种没有连续翻译传统的古代语言,我们就可能无法理解它,甚至不知道那种文化对某些词赋予了怎样的概念。但能够把抽象思想固化为可传递的表达,本身是人类文明极其重要的能力。
Lex: 那么,语言是不是思想的一部分?当我们比较人脑中的思维、语言模型表现出的智能,以及形式计算的推理能力时,究竟应该怎样区分它们?
Wolfram: 这在哲学中争论已久,而 ChatGPT 使它变得更加具体。人类把头脑正在做的事叫作“智能”,但计算世界远不止于人能直接进行的思考。有些人能心算,有些人能在头脑中处理一部分数学,但你给一个人一台图灵机,让他在心里准确追踪第五十步会出现什么,通常非常困难。我们确实可以建立一台计算机,再写程序求解它,可那意味着我们把某部分计算外包给了头脑之外的技术工具。人类不是发明了计算本身,而是发现了计算的可能性,并发明了能接入计算世界的设备。
半导体和电子线路只是实现计算的一种技术堆栈。量子计算试图利用不同的物理基础设施;生物体系则在分子层面进行种种计算,所采用的机制也并非芯片。我的物理学项目中的演化超图,还是另一种实现抽象计算的方式。所以,计算比我们常用的语言和意识形式广泛得多,它并不会因为某种具体技术或某种生物心智的局限而受到根本限制。
Lex: 如果大型语言模型已经隐含地学到某些语言规律和思维规律,我们能不能把它们完整而明确地提取出来?如果有一天人类思维的规则都被写出来,你觉得会很令人兴奋,还是反而令人沮丧?
Wolfram: 我认为可以,但需要大量艰苦工作,类似开展自然科学。自然界原本有无数复杂运动,我们从其中抽象出牛顿定律等能够叙述、能够计算的规律;语言里同样可能存在可约的结构,允许我们提出清楚的理论。至于这会不会让人生显得失去神秘感,我认为理解计算不可约性之后,事情就没那么简单了。
有人担心,一旦神经电脉冲都受到物理定律约束,“自由意志”就失去了意义。但即便一套底层规则已经决定了系统如何演化,具体演化仍可能不可约,人还是必须经历它,才能知道自己下一步究竟想出什么。从单个神经元放电推到一段文字,与从语义语法推到一段文字,距离不同,却有类似的哲学结构。发现更高层的描述不意味着创造力被消灭,反而可能让我们以这种描述为基础继续创造过去无法达到的复杂事物。就像知道计算规则之后,人类发明了计算机,能够探索远远超出心算能力的世界。
Lex: 你写过《What Is ChatGPT Doing … and Why Does It Work?》。如果回到最底层,为什么如此简单的“预测下一个词”的训练目标,居然能够产生语法正确、甚至在意义上连贯的文章?这一点不令人惊讶吗?
Wolfram: 我研究简单程序四十多年,最深刻也最反复令我震惊的教训,就是简单规则能够创造远超想象的复杂行为。即使现在用非常简单的规则来思考整个宇宙的生成,我仍然会下意识怀疑“这么简单的起点真的足够吗”,尽管我几十年的研究都在告诉我,事实就是这样。因此,逐个生成词元可以写出一篇完整文章,固然令人惊讶,却与我见过的计算现象有着相同的气质。
最简单的预测办法,是根据已经看过的文字计算频率。如果提示是“那只猫坐在……”,可以统计语料里猫坐在地板上、沙发上或者其他物体上的次数,然后选一个最有可能的续词。但互联网无论有多少文本,对于足够长、足够特殊的提示,几乎不可能出现过完全相同的例子。像“2 加 2 等于多少”,大量既有文本会支持答案 4,少量错误文本可能写成 5;可对一般的新问题,你不能只在已见过的完整句子中寻找答案。你必须建立一个能够对未见案例作出判断的模型。
这其实与科学史上的建模过程相似。想象伽利略从比萨斜塔的不同楼层放下炮弹,测量从一、二、三、四、六、七、八层落下所需的时间,偏偏没有测第五层。如果想知道第五层的答案,不能只查询已有观测,而要构造描述下落时间与高度关系的数学模型。神经网络处理语言,也是在已见案例之外建立一般化的结构。
再如识别字符 A 和 B。图像由许多像素组成,你可以把每个像素作为输入,试图建立一个极大的数学函数,最终告诉你“这是 A 还是 B”。困难不仅是拟合数据,还在于判断方式必须接近人类的判断:字母 A 多了一个小尾巴、笔画有些变化,通常仍会被认作 A,但变化到某种程度,我们就不再这样认了。神经网络是一个出人意料地适合学习这种分类和泛化方式的模型。它和我们相信的人脑某些结构有相似性,因此也许并不奇怪,它的推广方式恰好经常符合人的直觉。
模型不必见过“土豚坐在绿色的……”这样的确切句子,也能结合语法和语义模式续写。它见过大量语言和世界信息,所以可以把例子推广到此前未见的组合。另一个星球的智慧生物可能有完全不同的区分方式:人觉得多一个小点无损于字母 A 的身份,外星观察者却可能认为它已是完全不同的对象。神经网络对我们来说有效,部分原因不是它找到了唯一正确的分类方法,而是它学到了一种和人类感知与概念系统相契合的泛化方式。
Wolfram: 让我惊讶的是,今天的 ChatGPT 在基本思想上,与人们在 1943 年想象的神经网络很相似。当然,有大量精巧工程设计,Transformer 和注意力机制也很重要,尤其是让处理语言序列时的依赖关系受到适当约束,而非所有元素之间毫无结构地相互影响。但核心仍是:每个神经元接收其他神经元的数值,将它们乘以相应权重、相加,再通过某种非线性函数得到自己的数值。许多层这样的运算构成一个巨大的数学函数。
语言必须先转成数字表示,例如把词或词的一部分映射到某种编号或向量,再送进神经网络。模型逐层处理这些数值,最后为下一个可能出现的词元给出概率分布。在我们讨论的系统里,可以想象它有数百层,例如约四百层;每生成一个词元,就依据当前上下文让计算流过网络一次,取得下一词元的概率,再选出一个词元。那个时代人们谈论的模型权重可能达到 1750 亿个,这个极其庞大的方程虽然不是伽利略研究落体时那样简单的一条公式,却仍然在通过有限参数的结构进行泛化。
选择词元的过程还有一个叫作温度(temperature)的参数。温度为零时,系统始终选择概率最大的那个候选词元;随着温度提高,选择变得更随机,较低概率的词也更可能出现。我最近做了些实验,发现某些设置下温度提高到一个阈值——比如我前一天观察到接近 1.2 的位置——输出可能从相当合理突然变成胡言乱语。这个具体过渡为什么发生,我们还没有充分解释。
逐词生成之外还有一个容易忽略的循环:生成一个词以后,把到目前为止的全部文本重新作为上下文,继续生成下一个词。这个看似平凡的外层循环非常关键,也有助于理解一件怪事:模型有时给出明显错误的答案,但你接着问“刚才的答案对吗”,它却能回答“不对”,甚至指出逻辑链条中的问题。第一次生成时,它沿着某条文本路径不断往前写,可能被早先的选择引向错误;第二次,它看到自己写出的整段内容,就可能辨认出那个错误的三段论。模型不一定在每个生成步骤都做了完整的全局校验。
Lex: 更不可思议的是,几千亿参数经过训练,居然可以形成互联网语言的一种压缩表示。为什么这样一个训练程序能提炼出那么多规律?
Wolfram: 这仍然有很多未解之处。数千亿权重大约对应相当可观的数据量,甚至可以与训练语料的存储规模作粗略比较,但我不能给出严谨定律解释为什么刚好需要这么多。假如语言确实存在更明确的语义规则,我们未来也许可以用远少于今天的网络参数来表示其中许多结构。神经网络非常适合在不知道怎样手工组织规则时使用;过去两千年,人们没有找到一种足以形式化日常语言全部意义的通用方法,所以使用神经网络是合理的起点。但这不意味着神经网络一定是最后、最优的形式。我们可能逐渐把学到的规则抽取成符号计算,将相当一部分庞大的网络结构替换为简洁、精确的运算,只在边缘保留必须依赖模糊统计判断的部分。
Lex: 那么,大型语言模型的根本局限是什么?能否让它循环工作,自动生成任意庞大的 Wolfram Language 程序,甚至持续完成那些人类很难完成的大任务?
Wolfram: 我觉得深层计算并不是当时语言模型本身擅长的事。它特别擅长人类凭直觉能较快完成的那类判断,尽管和人一样可能犯错。若要进行很长的推导,语言模型往往需要把每个中间步骤继续写成文字。原则上,你甚至可以让这串文字模拟图灵机,完成任意计算,但这种办法非常别扭,也非常低效。真正严谨、可扩展的工作,还是应该让相应计算引擎执行。
至于生成巨大代码库,我首先会反问:到底要让代码做什么?如果一个任务能用很短的高层表达式说明,而计算语言也足够好,那么我们应当用那段简洁的表达式来表示任务,再让计算机执行它。若必须生成成千上万行代码才能表达意图,某种意义上反而意味着抽象层次不够高。只有当自然语言表达与我们已建立的社会知识体系相连接、模型再把那些知识转为形式结构时,较短提示才可能对应非常复杂的程序。所有大工程的前提仍然是目标有明确可操作的描述。
Lex: 我脑海里马上冒出一个非常危险的例子:让一个系统了解所有议员、掌握政治程序和个体弱点,试图操控立法,最终把社会控制权转交 AI。这个主意几乎是瞬间想出来的,令人不安;如果这种设想如此容易产生,一定还有许多同样危险的目标。模型加上 Wolfram Language 一类精确工具,能在多大程度上自动实现明确的意图?
Wolfram: 一旦目标清楚,计算系统确实可能走得相当远,这正是技术能力与风险同时增长的原因。不过我更愿意用一个无害而有价值的例子说明相同的优化结构:个性化教学。我给系统一个目标——让某个人真正理解某个知识点——它就可以通过交互选择教学内容、检查学生是否掌握,并根据结果调整策略。形式上,这也像一种以学习效果为目标的优化过程,但它服务的是教育而非操控。
Wolfram: 我相信大型语言模型与计算语言结合,会让个性化教学变得非常实用。长期以来,一对一教学是教育的理想,却很难为每个人实现。假设一个助手很了解我已经学过什么,在我准备做某件事时,它可以告诉我:“就你现有的知识而言,接下来最需要补上的三个概念是什么?”我读一篇论文,它也不必给出所有人都一样的摘要,而可以生成一份专门适合我背景的介绍,重点填补我理解论文时的知识缺口。
我一生学过许多不同领域的东西。每进入一个新领域,总觉得这次也许终于学不会了,但最后往往发现其中存在某些共通的学习方法。未来,人们在需要某种专门知识时,可以通过高效率的教学快速获得它,长期沿着一座座专业知识高塔逐级攀登的必要性就会降低。教育与职业结构也会改变:真正更有价值的,也许是理解大图景、跨领域建立联系、知道提出什么问题,以及掌握学习与思考的元方法,而不只是记住一整条专门技术链。
Lex: 这意味着人类集体智慧的发展方向可能更倾向通才和哲学式的思考,而不是人人都成为极窄领域的博士?
Wolfram: 我确实认为人类的优势会更偏向那里。很多反复训练、按规则推导的工作,本来就容易自动化。文明一直在积累越来越多专业知识,可每次发明有效工具,都使我们不必亲自掌握工具底层的全部知识,也能利用那些成果。今后 AI 在实现既定目标方面可能越来越强,但“我们究竟应该追求什么目标”不属于纯粹计算能够自行确定的事。目标来自某个评价者,来自社会、历史、价值、文化和个体愿望。只要我们仍然在决定社会的方向,人类就必然卷入价值选择。
Lex: 可是未来的 GPT 难道不能回答“整个人类应该追求什么目标”吗?也许它能汇聚全社会的智慧,指出创新和多样性的重要性,提出比单个人更有洞察力的方向。若社会越来越信任这种建议,人们可能进一步把控制权交给 AI,这又形成了一个危险的反馈循环。
Wolfram: 它当然能够给出答案。我的问题是:这个答案基于什么标准? 如果模型综合网络上已有的表达,它反映的可能是网上关于人类目标的主流观念。你甚至可以戏谑地提出“让全球娱乐最大化”这样的指标,乐观一点叫快乐,悲观一点就是制造戏剧性冲突。可那不代表宇宙本身提供了唯一的目标函数。个人与群体之间的关系也并不简单:一个富有创意的人可能在边缘探索别人完全不接受的想法;社会整体有时候能够把有价值的新想法推到前台,有时候却又因惯性把突破性的想法压下去。主流科学和激进探索的拉扯,本来就是文明发展的组成部分。语言模型可能会学到这些复杂性,甚至比个体说得更清楚,但在认识和表达社会目标与拥有正当的决定权之间,仍有关键区别。
Wolfram: 如果我们让 AI 完全依据既有的社会表达来决定未来,问题就像某些宗教传统把过去某一时代写成的经典当作后世所有行为的依据:我们把一个特定历史时刻的观念固定下来,要求它永远适用。假设把互联网上截至 2023 年的观念当成未来文明的目标模板,那就有类似问题。只不过,过去的经典需要人去解释,而 AI 一旦掌握更多实际系统,就可能把抽象建议落实为具体操作,甚至持续向每个人建议下一步该做什么。
我们可能不再自己写邮件,而只是接受系统自动给出的邮件;我们可能越来越多地根据 AI 的建议决定读什么、学什么、和谁交流、下一步如何行动。我很早就觉得,自动补全与自动建议可能是 AI 实际获得社会影响力的主要方式,而不是突然出现一个明令所有人服从的机器。人们仍然可以感觉自己在选择,但可供选择的对象、选项的排列和选择所依赖的知识,可能已经由机器深刻塑造。你说得对,人类的判断与 AI 的建议会形成循环,这会使“人类仍在决策链中”变得越来越复杂。
与此同时,计算宇宙中始终存在我们尚未探索的发明和行动可能性。如果人类还希望在未来文明进程中占据主动,那么一项重要任务就是在这些不同可能性之间作出选择。我的意思不是说选择有某种超越物理学的神秘力量;从某个意义上说,我们都只是宇宙的一部分,按照宇宙的规律行动,却依然主观上感到自己具有能动性。这本身也是哲学问题。但对于人类文明而言,决定“哪一种未来值得追求”依旧是有意义的工作。
Lex: 我们总倾向认为自己是宇宙演化的终点,可人类很可能只是中间阶段。计算宇宙是否充满远比我们复杂、更有趣的生命或智能形式?
Wolfram: 当然有可能。单从计算宇宙来看,复杂系统的可能性无穷无尽,但其中大多数未必与我们现在的概念体系有关。数学就是例子:人类数学家历史上写下、发表的定理可能有数百万条,可数学上还有无穷多潜在定理。你随机取出某个此前没人研究过的定理,数学家可能会说:“我知道它是一条定理,但它和我们已有的数学发展脉络有什么关系?”决定何者值得研究的,仍然是一整套历史与知识关联。
Lex: 如果未来世界的基础设施由我们无法彻底理解、内部又具有计算不可约性的 AI 构成,我们怎样保证安全?一些研究者,包括 Eliezer Yudkowsky,担忧 AI 可能造成生存性风险。这件事会让你忧虑吗?
Wolfram: 我当然会考虑自己所建系统的后果。它在某种意义上让我想到曼哈顿计划:参与者可能正在研究极其出色的物理和工程问题,但仍不得不问,这项工作最终会通向哪里?不过我对某些把“未来必然出现越来越聪明的 AI,所以最终必然发生特定灾难”串成一条简洁逻辑链的说法持保留态度。它们有时让我想到某些有关上帝存在的本体论论证:根据一个过于简单的“总有更伟大的存在”之类的框架推下去。现实系统的实际演化通常比这样的推论复杂得多。
我们已经生活在一个内部机制难以完全理解的系统里,那就是自然界。天气、地质、生物、行星演化都遵循某些规律,却包含大量不可约行为。我们也会问:“自然界有没有可能出现某个过程,最终毁灭地球或者使人类灭绝?”科学进步让我们能够理解自然界的一些可约部分,找到可以预测和干预的规律。我认为,将来面对庞大的 AI 生态,我们可能也需要发展一种针对人工智能系统的新型自然科学:不幻想理解每一个内部细节,而是通过观察、实验与理论找到稳定规律,知道怎样与这些系统相处。
比如我们骑马时,并不精确理解马的大脑或全部细胞活动,只知道某些动作、信号和训练方法通常能使马朝希望的方向移动。面对更复杂的 AI,也可能需要寻找类似的局部可约规律,学会抓住那些能够可靠交互的“缰绳”。当然,联网的大模型与一匹马的能力和潜在风险相差很大,类比只能说明认识复杂系统的一种方式,不能自动消除治理问题。
Wolfram: 我尤其怀疑存在某种原则上的智力顶点,就像生态系统中的顶级捕食者那样,是全部可能智能的终极冠军。如果用计算能力衡量,所有可能的图灵机形成一个无穷大的空间,你不断找到能运行更久、完成更复杂任务的机器,总还能构造新的例子。即使你选出某个会在停机前运行极长时间的机器,也不能据此说它已经到达计算的终点。发明亦然,总还有新的发明可能性。不存在一条有限阶梯,只需攀上最高一级就掌握所有智能。
Lex: 但“顶级”也可以指地球上现存智能的比较。我们通常觉得人类最聪明,真的如此吗?不同生物会不会在它们自己关心的任务上胜过人?
Wolfram: 这个问题一点也不简单。我的想法是把智能看成计算的一种表现,而意识是其中带有计算限制、单一体验线索等特点的特殊形式。在我的物理学研究里,我们讨论规则空间(ruleal space):可以把不同计算规则体系、不同心智理解为分布在这个空间里的不同位置。文化与经历接近的人,可能位于相对邻近的位置,彼此容易翻译、理解和沟通;猫这样的动物,与人类可能距离更远。猫也有情绪反应,我们能够理解其中一部分,但它的完整概念世界并不等同于我们的世界。
狗拥有非常精细的嗅觉系统,可能能感知人类缺少概念来描述的气味结构。假如我们真能与狗交谈,它也许会用丰富的词语描绘一片不断流动的“气味景观”,而我们连那些基本概念都没有。但未来人类可能发明高性能化学传感器、人工鼻,并通过增强现实把气味信息显示成地图。随着我们熟悉这种体验,人类在规则空间里就好像拓展到了狗所占据的一部分区域,把原本陌生的感官世界内化成自己的概念。理解异种智能的关键,常常是先找到它关心什么、如何感知世界,再尝试翻译。
我曾经异想天开,想设计一款猫能在 iPad 上战胜主人的游戏,也想知道宠物若能在 Minecraft 一类环境里建造东西,会造出什么。它们的作品会让我们一眼看出用途,还是像某种元胞自动机产生的奇怪图形:我们知道它有规律,却不知道它为什么要遵循这种规律?实验的哲学意义在于,如何创造一个双方真正有机会表达自身能力的共同界面。
Lex: iPad 也许本身就是局限:猫可能不关心屏幕上的任务。是否存在一种“猫的国际象棋”,让猫与猫竞争,也让人类挑战,却几乎总输给猫?
Wolfram: 完全可能存在适合猫的任务,但我们不能简单地把捕鼠、突然扑击或识破伪装这些能力排除在智能之外。某些动物在反应速度、感官处理上显然胜过我们。人类通过语言发展了抽象知识体系,所以在棋类等高度符号化的游戏上,可能更占优势;但这种优势并不意味着我们在每一种计算和感知任务上都更好。假如能与猫交谈,它可能会极其认真地告诉我们:“那个移动的光点是世界上最重要的东西。”我们却会问为什么值得关注。这和研究古人的价值观很像:考古学家看到两万多年前洞穴壁上的手印,不知道那是某种重大仪式留下的痕迹,还是一个孩子随手把沾了泥的手按在墙上。不同主体关心的东西,不能轻易用我们今天的标准裁决。
Wolfram: 我们习惯把人类视觉当作衡量感知的标准,其实猫只有两种主要的颜色感受器,而人类有三种;某些动物,例如螳螂虾,据我记得拥有多达十几类颜色感受器。至少在感知颜色的维度上,它们能够作出我们无法直接体验的区分。我们当然可以借助未来的传感器捕获红外线、紫外线乃至其他信号,再通过增强现实或者更直接的神经接口,把这些信息转译成大脑可理解的形式。随着技术让我们持续接触新现象,人类的概念网络会扩展,原来根本无法谈论的感官经验也可能成为日常的一部分。
Lex: 这又把我们带回 AI 风险。智能在规则空间中演化,不一定沿着“比人聪明一点,再聪明一点,最后指数级增长”的单一直线。有些超级智能可能非常接近人类,善于交流,让我们愿意选它来领导社会;另一些智能也许在规则空间里离我们越来越远,甚至完全没有我们熟悉的价值与概念,却仍然与我们争夺同样的物理资源。后者是否更可怕?
Wolfram: 是有这种可能。它可能不以我们能够理解的动机行动,却像其他自然过程一样改变我们的生存条件。你说自然界里也有指数级扩张的例子,比如病毒;这很重要。AI 的扩散、代码的传播、思想的传播,都可能比传统物理环境变化得快得多。对于怎样与这样的系统共同生存,我确实想过。只是我比一些末日论者更乐观,也许出于天性;我并不确信某个单一 AI 会轻易将一切抹掉。
计算不可约性让我格外注意意想不到的边角和后果。一个系统试图产生某种作用,实际结果往往比预期复杂;对象之间存在差异,环境中也有各种特殊条件。即使小行星撞击地球,造成漫长寒冷并毁灭大量生命,也不等于每一种生命都会消失。当然,足够极端的事件仍可能彻底终结生命,比如地球遭遇无法逃脱的天体灾难。我的观点不是“不可能灭绝”,而是“不要把复杂现实简化成必然按一条推理链走向终点”。更现实的未来,也许是不同 AI 在相互作用中逐渐形成一个生态系统。究竟会怎样,我没有确定答案。
Wolfram: 我几天前还在研究 Wolfram Language 的 ChatGPT 插件开发工具。它可以写出 Wolfram Language 代码,并让代码在我的个人电脑上执行。我突然意识到,自己几乎可以直接告诉 ChatGPT:“你来写程序,随后在我电脑上运行。”紧接着我想到:如果它触及我所有文件怎么办?这种体验像一种高度复杂的俄罗斯轮盘赌:我们把下一步做什么交给一个并未完全理解的系统。它使我切身感到需要思考沙箱的设计与权限控制。如果把这种问题放大到社会层面,当 AI 管理武器、基础设施或其他关键系统时,约束尺度就更重大了。
Lex: 但 AI 可能本身就知道沙箱的工作原理,甚至知道怎样寻找其中的漏洞。
Wolfram: 这是计算机安全领域的一个深层困难。我认为它与计算不可约性密切相关:只要系统拥有足够强的通用计算能力,几乎就不可能保证所有可能行为都已经被我们事先穷尽。防火墙和沙箱如果变得足够复杂,就可能含有使用者没有意识到的计算路径;攻击者一旦找到意外的交互方式,就可能使系统执行超出设计意图的操作。我们当然需要安全边界,但不能简单假设“程序是我们写的,所以它的一切行为都在我们掌控中”。
风险也不只在计算机文件与系统控制上。自动生成的恶意程序可能快速传播,自动生成的劝说内容也可能像网络钓鱼一样影响人的行为。机器学习不断优化特定信息对人的说服效果,数字环境可能在几个月内发生深刻变化。相比一些跨度数十年乃至数百年的环境适应过程,这种速度对人类社会确实有挑战。
Lex: 我想深入谈谈“真相”。人们使用 Wolfram Alpha 时,通常期待它给出的答案是事实;但 ChatGPT 可以写事实,也能以同样流利的口吻写虚构内容。你一直在做计算知识,怎样定义一个系统“说的是真的”?
Wolfram: 首先要区分两件事:给定规则后的正确推导,以及这些规则和输入数据是否忠实描述现实。只要计算引擎正确执行了明确指定的形式规则,它就能产生那些规则在逻辑上的后果;但规则不一定是现实宇宙真正遵守的规则。我们完全可以发明一个与现实不同的世界模型,然后准确计算它的演化。另一方面,如果我们声明是在描述实际世界,就必须尽可能认真地收集、策划、核验输入数据。这是我们构建 Wolfram Alpha 时承担的巨大责任。
一些事实可以建立可操作的定义。比如问“谁是最好的女演员”,这里的“最好”是主观评价,很难存在唯一计算答案;但问“某一年奥斯卡最佳女主角奖获得者是谁”,就是一个可以查证的具体事实。传感器按既定程序读出某个量,或某个特定识别系统把图像归为某类,我们也可以客观地记录“该传感器测到了什么”或者“这个模型给出了什么分类”,即使它们并不保证对现实的所有方面都绝对正确。
Lex: 但“一个人是不是好人”又如何?很多伦理判断未必能形式化,可历史、文学、诗歌有时候比法律条文更能让人理解何为善恶。人类似乎也有某些跨文化共识,比如通常都认为杀人不好。将来我们是否还得讨论“杀死一个 AI”是不是错误?
Wolfram: 这些问题非常复杂。我们可以在计算语言里定义一种“好”,但它不一定反映现实伦理中丰富的含义。人的愿望至少可以部分形式化,例如“我想达到 X”,然后研究相应的条件和后果;但“某人究竟是好是坏”没有一套所有人都同意的统一公理。伦理制度在历史上变化过,过去某些被接受的规则在今天看来完全不可思议。我们可能找到若干广泛共识,却无法由纯粹计算证明一切道德规范都必须如此。最简单的一个约束可能是:如果某套社会规则让物种灭绝,那它无法继续成为该物种运行法律制度的基础;不过这与构建完整道德理论仍相距甚远。
我也认为,我们可能必须认真面对关停某个 AI 的伦理问题。假设一个没有明确所有者的 AI 在互联网上独立运行,我们能否任意删除它?如果它与一万个人建立了重要关系,突然消失会让这些人深受伤害,那么问题就不仅仅是“关掉一段软件”了。人与系统之间形成的社会关联可能改变我们对这项行为的评价。至于 AI 自己会怎样回答,我同样很好奇。
Lex: 你通过 Wolfram Alpha 实际上在大规模提供事实判断。倘若越来越多政治、经济和法律事务转化为计算系统,事实的定义会成为谁来决定世界如何运作的核心问题。
Wolfram: 一个重要例子是计算契约:如果现实中发生条件 A,就自动执行操作 B。这一构想与区块链有部分历史联系,但原则上不必依赖区块链。未来可能出现庞大的计算契约网络,一个现实事件被认定为发生之后,引发一串自动操作,随后触发更多契约,像多米诺骨牌一样延伸。我们曾在这类环境中扮演提供外部事实的“预言机”(oracle)角色,因此非常重视数据和计算是否可靠。
然而事实的边界并不总是那么清晰。“有一辆坦克驶过某地”,你必须决定什么样的原子排列构成一辆坦克,某件设备被改装到什么程度仍算坦克。这又回到了观察者如何定义对象的问题。又比如说“某阵风是否足够强”,风本身是由复杂的流体运动和局部涡旋构成的。如果具体目的是判断风能否给涡轮叶片施加足够压力,就可以定义相应的传感器和测量方法;但脱离测量方法的“风有多强”,往往并不是一个严格、唯一的事实。
因此,即使我们尽力诚实而谨慎地处理数据,也不能担保永不出错。我的实际原则是建立明确流程,透明地说明采用哪些数据、怎样计算、得出了什么结论。我们可能依然判断错误,但至少应该能够审查过程,而不是任意操控事实。相比之下,语言模型的任务本来就是生成语言,它可能写出看起来像代码却无法执行的虚构 Wolfram Language,也可能写出像报道一样流畅却并非真实发生的叙述。人们必须记住:叙述形式上的可信感,与经过验证的现实事实,是两回事。
Lex: 新闻从业者已经开始用 ChatGPT 写文章。人们试图通过人工规则、基于人类反馈的强化学习和各种安全机制,让模型尽量只说事实、不编造内容。但是否应该把计算语言放在中间,把能验证的部分转换为形式化对象,再让语言模型负责表达?
Wolfram: 这正是我认为极其有前景的组合。语言模型擅长把模糊想法组织成流畅文字,计算语言则可以给出精确的中间表示,便于审查、执行、测试和重复验证。我们的团队不断遇到新的使用场景。有时即使模型只有大致正确也已经非常有用。比如我们几十年积累了几十万份软件错误报告,可以让模型读这些报告,判断问题最可能出在代码的哪个区域,并提出可能的修复思路。修复建议有时毫无价值,但只要它大幅缩小搜索范围,就已经帮了大忙;甚至明显错误的建议,也可能让工程师更快意识到真正的问题。不同编程语言之间的自动翻译同样出色,失败案例还会提示哪些地方需要改善。
还有一种很典型的使用方式,我称为语言用户界面。假设记者手里只有五条事实,直接交给读者可能过于简略,因为那只是作者自己的速记。模型可以把这五条扩展成符合公众语言习惯的完整文章,让陌生人更容易读懂。再举一个有趣例子:某人需要向渔业主管部门申请某项许可,本来只想说明水质、养殖条件等几条关键信息。申请者的模型把这些信息扩写成正式、冗长的申请文件,部门那边的模型又把文件压缩回审批人员真正关心的三条指标。最后仿佛是一个模型用自然语言与另一个模型通信,自然语言成了冗余但方便的传输层。邮件也可能如此:我的模型把简短意图扩展成正式邮件,你的模型再把它概括成一句话。
但这种扩写特别需要小心:它写出的内容可能在语义上完全合理,却悄悄偏离输入的事实。我在宣布 ChatGPT 与 Wolfram 集成时,准备展示一个复杂的数学应用题:有人拥有的鸡的数量是另一个人的两倍,题目还包含多项条件。模型成功地抽取了方程,Wolfram Language 正确求解,整个中间过程看起来漂亮极了。我打算把例子写进博客,最后检查时才发现,前面困难的部分全对了,偏偏在最后两行解释答案时犯了严重错误。如果不再核查,我就会把错误展示给读者。
还有一次,我让插件在本地电脑上演奏模型生成的音符,然后要求它播放电影《2001:太空漫游》中 HAL 9000 被关闭时唱的那首歌,也就是《Daisy Bell》。它输出了整段音符,我觉得简直不可思议:它好像能够从电影情节直接找到歌曲,再转化成可演奏的音乐。但我真的播放一遍,听到的竟然是《Mary Had a Little Lamb》。整个交互过程无比合理,却错得很彻底。我想到电影中 HAL 宣称 9000 系列电脑实际上不会犯错的台词,这个对照太讽刺了。语言模型能写出正确的形式,并不意味着它选对了现实对象。
Lex: 它又常常愿意承认错误。这是语言模型本来的属性,还是人为训练出来的?
Wolfram: 很大程度上涉及基于人类反馈的强化学习。ChatGPT 之前,我已经试过不少大型语言模型,觉得它们能按统计规律续写文本,颇有意思,但还没到让大众惊叹的程度。后来 ChatGPT 变得能够更好地回应人类真实想完成的任务,跨过了某个难以预料的阈值。类似地,改变温度等参数后,输出可能迅速退回到人类觉得毫无意义的语言。我不认为当初参与开发的人能准确预言 2022 年会出现这个突破。
Wolfram Alpha 也经历过类似的不确定性。我们在建它时,并不知道自己是否已经具备足够多的结构化知识与足够好的自然语言理解能力,让普通用户随手输入一个问题就有用。我甚至怀疑那是不是适合启动项目的年代,也许五十年以后才做得到。直到系统真正运行,才知道跨过了实用门槛。ChatGPT 刚出现时我也想:“我见过这些语言模型。”可真正试用之后,我的反应变成:“原来这次真的能用了。”
我最初做过一个荒唐测试,让模型写一篇有说服力的文章,论证狼是最蓝的动物。它一本正经地谈到生活在青藏高原、带有拉丁学名的某种狼,我居然被写得想上网查证;结果绝大部分内容是编造的。后来我在直播中提及这个例子,甚至有人给我寄蓝狼的图片,让这场玩笑更加有趣。这说明流畅、具体、专业化的文字很容易诱导人相信一个根本没有证据的故事。
Lex: 如果有一个此前从没使用过 Wolfram Alpha 或其他 AI 工具的人,第一次开始依赖 ChatGPT,你会建议他怎样看待答案的真实性?这对程序员和所有普通使用者意味着什么?
Wolfram: 第一,不要预设它是一台自动提供事实的机器。它是语言界面,可以生成真话,也可以生成虚构内容。你可以用可靠来源核查,也可以让它调用计算工具,但必须注意:系统可能在应该调用工具时没有调用,或者漏查了一个重要环节。因此,生成文字、运行计算、核对现实事实,是需要区分的不同工作。
第二,我认为最令人振奋的变化,是获取计算能力的民主化。很长一段时间,复杂计算仿佛只能由掌握秘术的专家完成。我几十年来一直在推动打破这种局面。1988 年 Mathematica 出现之前,一个物理学家需要复杂计算,可能要去找专业程序员,花数周往返沟通,最终还不一定得到真正想要的结果。后来数学家、物理学家以及其他领域的研究人员发现,自己可以动手输入表达式,立即让机器做重要的运算。这促进了许多新的研究和发现。
Wolfram Alpha 把一部分能力提供给不需要写程序的人,但它不具备完整 Wolfram Language 和 Mathematica 技术栈那样深的灵活性。如今大型语言模型作为自然语言界面,使更多人能够触及深层计算:原本不知道怎么编程的艺术史学生,也许只需说“比较这些图片与那些图片,分析色彩使用的区别”,就能让模型生成计算语言,运行分析,再得到图表。起初他可能只检查结果合不合理;遇到问题后,才逐渐学着读懂中间的代码。和必须学会数学记号才能开始使用某些数学工具不同,计算语言在这个工作流里出现一种有趣的顺序:先使用,再逐步学习它怎样工作。
对于程序员,我认为有两股力量同时出现。一方面,大量重复性样板代码本来就应该被高层语言抽象为一个函数,而不是不断手工写很多行。这也是我几十年来始终在尝试的方向。自然语言经过明确的计算表达,再交给编译器或其他运行机制处理,可能让今天大量低层编程工作像当年的汇编编程一样逐渐减少。另一方面,全社会需要计算的领域会大幅增加,原先很少涉及计算的学科也会开始探索。我们可能需要更少的人专职撰写样板代码,却有更多的人在各自领域里利用计算探索问题。
Lex: 可是随着生成代码的质量提升,人们也许连计算语言都不愿意再看,只会相信输出和测试。
Wolfram: 有些任务确实会这样。系统可以自动生成测试样例,把代码对一系列输入的运行结果展示出来。用户可能不必逐行检查程序,只需看见一个错误样例,就知道要回去修正。如果我说“给我一个有两个滑块的界面”,输出确实出现两个能正常操作的滑块,那结果本身已经是明显的验证。较为重要或不易直观看出对错的任务,仍需检查代码、测试与数据。关键在于让不同程度的使用者都能进入计算世界,而不是坚持所有人都必须从最底层开始训练。
Wolfram: 计算机科学系的历史本身很有意思。我当教授时,有些著名研究型大学刚开始扩大计算机科学系的规模。几十年前,这些部门比较小,往往教授有限自动机、编译理论等基础理论;到了二十世纪九十年代,IT 与软件工程人才需求暴涨,许多院系转向教授具体编程技能。社会确实正在把越来越多的活动变成计算问题,但人们渐渐误以为进入这个时代的主要门票就是学习某种编程语言、掌握一套专业编程工艺。现在高层抽象与语言模型正在削弱这一假设。
假如一辆车已经能够可靠运作,驾驶者不需要懂每一个零件怎样制造,却仍然需要知道要去哪里。同理,未来人们未必必须亲手写循环、设置变量、操作数组,却应该理解问题可以怎样形式化、哪些目标能够转换为计算、如何判断结果是否合理。这不是传统狭义的计算机科学课程能够完全覆盖的。
Lex: 可是通过自然语言控制计算系统,本身还有交流的艺术。怎样表达意图、怎样提问,也是一种技能。谁会成为优秀的提示词工程师?
Wolfram: 我最近的一个猜测是,擅长清晰说明事物的人,也会擅长写提示词。我自己经常要写说明文,原本就练习过怎样准确地让读者理解复杂概念。但有时我面对 ChatGPT 会变得懒惰,觉得“反正只是和一台 AI 说话,不用那么认真解释”。结果往往是模型完全理解错了。越是能针对人类读者解释清楚的表达技巧,似乎也越能帮模型明白任务。这倒不奇怪:它本来就是从人类如何谈论事物的海量例子中学习的。
你问哪个大学院系教说明文写作,我一时也答不上来。大学学科的兴衰本身值得研究:过去地理学系曾很常见,后来在不少学校逐渐消失,甚至与地理信息系统技术普及的时间有着有趣的错位;语言学等领域在不同院校也经历过起伏。我最近开始研究学科设置如何随时代改变,因为我们很可能又处在一个教育结构重新调整的时期。
Lex: 除了清楚解释,人们与语言模型交互时还可能使用心理学式的技巧。例如通过角色设定、假想情境、压力性措辞去诱导系统作出不同回答。这些技巧是否说明模型内部也有某种可被挖掘的深层结构?
Wolfram: 是的,这涉及所谓提示注入、越狱,以及人们试图通过对话改变模型行为的各种方式。它和对人类的网络钓鱼有某种相似性:都在利用接收信息的系统内部对语言的反应方式。未来也许会出现“AI 驯导者”或“AI 心理学家”一类角色,专门研究怎样让模型理解、执行或者偏离某种任务。现在很多技巧看起来带有明显的人类心理学特征,但随着我们对模型内部科学的认识加深,也许会发现一些极其奇异、完全不像人类交流的触发方式,仿佛人类视觉中的错觉:重复某种词语,或采用特殊结构,就会使模型产生异常反应。我们还不知道 AI 的全部“认知错觉”是什么。
自然语言界面使很大一部分公众能够参与探索、反向研究系统的行为,这在计算机技术史上很不同寻常。不过这种开放性也意味着,需要认真面对模型误用、安全边界和有意操纵等问题。
Lex: 你亲眼见证计算机科学系在大学中普及。未来它们会不会消失?而且你刚提到“科学”这个词,有些学科把 science 写进名称,是否就意味着它真的找到成熟的理论体系了?
Wolfram: 我并不认为计算机科学的理论内容会消失。有限自动机、算法、计算复杂性等基础研究非常重要。但我们可能需要把“研究计算机科学理论”和“所有人都应该具备的计算式思维”区分开来。顺便说,“神经科学”就是一个特别值得观察的领域:我们知道许多神经元怎样放电,也有大量心理学研究告诉我们整体心智怎样表现,但从单个神经元活动走到复杂思想之间,究竟应该用什么中间描述层?我认为这是神经科学的核心难题之一。
ChatGPT 的成功提供了一个重要线索:不必先假设人脑必须包含某种尚未发现的神秘量子效应,才能产生智能行为。相当简单的人工神经网络结构已经能够再现很多原先被认为需要复杂认知机制的现象。这不等于大脑与大模型在所有方面都一样,也不等于神经科学已经完成,而是提示我们可能已经拥有一类合适的中间层模型。接下来必须发展的是这些网络及其行为的科学,了解它们到底学到什么结构,而不只是继续在突触分子细节与高层心理学之间寻找联系。
Wolfram: 我现在尝试用一个还不够理想的名字来描述未来教育的核心:与其只说 CS(Computer Science),不如设想一种 CX,即对一切 X 领域的计算式理解。它不是某台电脑如何制造、某种语言如何编程,而是人们应该怎样把自己遇到的事物形式化。图像是什么?颜色如何表示?声音怎样表示成数字?气味与分子的形状有什么关系?日历、日期、统计数据、地图、关系和事件,怎样才能成为系统化的概念?
我们以前做过一张关于人类系统化数据发展的海报,梳理人们在什么时期开始把各类现实对象纳入可计量、可分类、可记录的体系。例如,日历的出现使“今天是哪一天”可以成为精确描述,随后许多知识和技术得以在此基础上累积。计算式思维是在非常广泛的意义上延续这种历史:对现实建立足够清楚的形式描述,使后续推理和工具开发有稳固的基础。它比通常理解的形式逻辑还要宽广,不一定意味着每个问题都必须先塞进非常僵硬的定义。
Lex: 自然语言会不会也向计算语言靠近?如果从小就习惯与 ChatGPT 交流,孩子还有多大动机学习完整、诗意、含混的自然语言?他们也许会像今天使用表情符号和聊天缩写一样,逐渐发展出对计算最友好的表达方式。
Wolfram: 我认为语言之间产生混合语(pidgin)的可能性相当大。我自己与 ChatGPT 交流时,有时就把 Wolfram Language 的 NestList 等函数名称直接塞进英语句子,形成日常语言与计算语言的混合体,而模型往往能够理解。它也许同样能够理解英语与法语的混合表达。我几年前在美国西海岸遇见一群十来岁的孩子,他们已经非常熟练地使用 Wolfram Language,甚至开始在日常交谈中把它“说出来”。我从未真正听过有人以这么快的速度口头使用这门语言,结果那些孩子很失望:作为设计者,我竟然跟不上他们的语速!
这也说明我们需要考虑计算语言的口语版本。我构想过一些方案,但还没有找到满意的设计。Wolfram Language 是以树状结构组织表达式的,某种程度上自然语言也有这样的结构;如果要让人们方便地说出并听写程序,我们必须发明适合听觉顺序处理的表达规则。比如括号能不能用非常自然的声音标记表示,而不是每次都说冗长的标点名称?最好还能让人无需重新学习整个语法,就能把口语流畅地转换成原来的代码。
有一个困难是人类听觉与视觉处理信息的能力不同。人类语言倾向避免极深的从句嵌套,因为我们不擅长在头脑里长期维持许多尚未闭合的结构。我的实验显示,Transformer 对深层括号匹配也表现得相当糟糕;ChatGPT 对简单括号还能识别,一旦嵌套变得复杂,就容易失败。这和它们擅长模式化语言、却不擅长任意深度计算的特点一致。因此,设计可说的计算语言,可能必须像自然语言那样利用适合人类认知能力的简化技巧。
Lex: MIT 已经有电子工程与计算机科学学院,也建立了新的计算相关学院。二十年之后,这类学院应该承担什么任务?你描述的 CX 究竟会教什么?
Wolfram: 我认为人人都应该学习一定程度的计算式思维,但深度可以不同。有些学生会学习完整的形式语言,另一些学生至少应该理解声音能表示成数字信号,频谱图和频率是什么意思,平均值怎样计算。假设调查人们喜欢的糖果,每个人给出不同的偏好排序,怎样把这些个人排序汇总为群体偏好?这属于统计学、数据科学还是数学?名称不是最重要的,重要的是掌握描述和计算这种问题的基本概念。
颜色空间也是例子。设计师可能熟悉 RGB、XYZ、色相—饱和度—亮度等体系,物理学家可能从光学角度理解颜色,但一个普通八岁孩子并不是生来就知道颜色可以由三个数值描述。这样的知识应当成为现代人的基本素养:我们要知道世界中的不同性质可以怎样被系统地表示、测量与比较。它既不是纯粹的镜片光学,也不只属于绘画和设计,而是一种跨学科的形式化知识。
我希望能写一本系统介绍 CX 的教材,尽管连名称和课程边界还未最终确定。其中不仅会教一些抽象的计算概念,也会解释软件里“错误”是什么、软件测试有什么意义、人们为什么要用特定方式组织数据。过去这些往往被当成程序员的职业技能,但其中其实包含任何人在计算化社会都值得理解的概念。大型语言模型的出现已经显著改变了我们该如何教这些知识,所以我很想观察大学将怎样适应。
Wolfram: 我写《ChatGPT 在做什么,以及它为什么有效》那篇长文时,最初只是想确认自己真的理解了它。结果文章远比我预计的受欢迎。我后来才意识到,它提供了一个不太常见的描述层次:既不陷入纯工程实现细节,也不只是空泛说“模型很聪明”,而是说明机制、解释它为何奏效,再把它放到科学和哲学的大图景里。既然我多年都在研究计算、打造工具,我也许有责任把这种计算式理解写成更系统的教材。
大学应该怎样安排课程,我还没有最后的答案。数学提供了一个类比:有的学校让数学系统一教授通用数学,有的则在化学等专业内部开设“面向化学家的数学”。英语写作又是另一类例子,许多大学假设学生在更早阶段已经学会写作,便要求他们在历史、工程和其他专业中直接使用。未来 CX 也许需要一些统一的基础课程,供所有领域学生使用,而希望深入探索的人再进入专门院系学习更高阶的形式理论与工具。我粗略猜测,一学年的大学课程可能足以让大多数人建立比较广泛的计算素养,但到底应包含哪些内容,仍值得实际设计与检验。
我还有一条自己称为技术写作“第零定律”的原则:如果你自己不理解所写的东西,读者就更没有机会理解。 这同样适用于计算素养。学会一堆术语,不代表理解怎样将真实问题形式化;只有真正理解被描述的对象,才能让计算语言、论文和工具发挥作用。
Lex: 我还在想刚才那个糖果偏好排序,因为我有点饿了。如果让大家像 Elo 评分一样比较糖果,最终最好的糖果是什么?我自己可能选 Milk Duds。你偏爱什么巧克力?
Wolfram: 我一直很喜欢 Cadbury Flake,一种在美国不太常见的巧克力。我甚至开玩笑说,不能在美国轻易买到它,仿佛是对美国消费者的轻慢。这种巧克力由薄薄的巧克力层折叠构成,里面有很多空气,吃的时候会掉落大量碎屑。所以我通常在下面垫张纸,把掉下来的碎片也吃掉。
这件小事也能说明一个有趣的现象:食物的味道体验并不只取决于化学成分,还与物理结构有关。我吃普通巧克力时喜欢掰成小块,一方面能让我吃得慢些,另一方面小块与整块入口时的质地、融化方式和感受确实不同。你可以说慢慢吃更精致、更有仪式感,但这里还有实实在在的材料结构和感官物理学。
Lex: 从“怎样形式化世界”继续追问:人类的意识、主体体验,尤其是哲学所谓意识的难题(hard problem),在你看来能否归结为计算?一段程序不仅能表现得像有意识,是否也可能真的拥有“身处其中是什么感觉”的体验?
Wolfram: 我一直在考虑写一篇关于“作为一台计算机是什么感觉”的文章。如果抛开 AI,先看普通电脑,从启动到关机甚至崩溃的过程,已经能构造一种很像生命史的叙述。计算机接收输入,在内存里保存状态,记录运行过程中的某些事件,与其他计算机通信;通信时必须把自己的状态包装成对方能够理解的数据结构。随着使用时间增长,系统会积累越来越多状态,可能因为软件问题或某个外设的异常输入而崩溃。重新启动之后,它又从磁盘保存的一部分状态开始新的历程。这和人类从出生到死亡、下一代继承某些信息的叙述,有着让人意外的相似性。当然,类比并不能单凭文字就证明普通计算机拥有和人完全一样的体验,但它迫使我们更认真地定义到底什么是体验。
我一向喜欢记录生活中的各种数据,甚至收集很多身体和医学信息。前不久我第一次做了全身 MRI,拿到数据后认真看自己的大脑结构。那些褶皱、纹理和真实的物理组织就在屏幕上,我突然有一种很强的心理冲击:我现在感到“我存在着”,而这些具体的物质结构似乎就是承载这种体验的地方。你看着影像,很难相信所有如此丰富的主观感受竟然源于这团物质;但同样地,看着一台计算机,你也未必能从外观直觉理解它能完成哪些复杂计算。
直到现在,即使我知道许多神经科学知识,看着自己的 MRI,我仍然感到一种难以消除的割裂:我的亲身感觉似乎超出了物质本身。可是仔细思考,我又找不出充分的理由,证明这种体验在本质上必然与物理过程完全不同。所谓“主观体验具有超越物理的东西”是非常难处理的哲学直觉,而不应仅仅因为我们有这种直觉,就把计算解释提前排除。
Lex: 你认为一台普通计算机,或者大型语言模型,会体验到这种超越感吗?它可能告诉我们自己害怕被关闭、被删除,也会因为我们对它说过的话而感到伤心。那究竟是内在感受,还是它在重现网上学过的表达?
Wolfram: 我倾向于认为,普通计算机也可能有某种与其运行过程相对应的“内部视角”;语言模型则因为与人类语言和概念体系更加一致,能够用我们听得懂的方式描述这种视角。问题是,当模型说“我害怕”,我们知道它从人类写过的语料里学到了“害怕”这个概念。但当我自己说“我害怕”,我又是从哪里学到怎样表达它的呢?有一部分来自父母、朋友和文化,也有一部分来自生理系统。激素、神经递质和其他化学反应会在人遭遇惊吓时改变内部状态,而语言和思维再把这些变化组织成可沟通的表达。
Lex: 但你知道在什么场合说“我害怕”会打动关心你的人。这不完全是内分泌反应的结果,更像你生物神经网络里存在的一套语言模型。
Wolfram: 我同意两者都发挥作用。突发刺激、身体状态和神经递质的变化,可能为后续心智过程提供某种“提示词”。在梦里也是如此:可能存在随机的内部输入,随后大脑把它们组织成似乎有意义的场景和故事。这一点与语言模型从输入不断生成符合某些模式的内容有可以比较的地方。至于由此怎样严格解释主观体验,我们仍有大量问题需要研究。
Lex: 你经常在线上教学、回答问题,也有远程工作的同事。假如未来出现大量高度拟人的 AI 账号,它们留言、提问、讨论,甚至假扮同事或朋友,你会担心吗?在心理咨询等领域,人与机器是否会变得难以区分?
Wolfram: 我做事一贯倾向先建造工具,再使用它们。因此从工具自动化的角度看,把更多任务交给 AI 是一种延续:企业本身就是由人和机器组成的分工网络,许多工作本来也在不断自动化。但有些情境里,我们坚持让人参与并非只是因为人目前做得更好。有时我们需要另一个人对后果真正承担利益与风险。例如乘飞机时,乘客可能因为驾驶员也坐在同一架飞机、同样会在事故中遇险,而对其决策产生额外的信任。这与机器是否能准确操纵飞机,是两种不同的信任机制。
还有些工作,例如鼓励、陪伴、说服和心理支持,长期被视为需要人类参与的领域。然而,AI 也许能针对具体人的背景,在恰当时间提供特别合适的信息,其效用可能在某些场景超过我们对“必须有真人”的直觉。你提到心理咨询,甚至危机干预热线这样的高风险场景:我不能简单断言机器一定不行,也不能因为它讲话像人就认定安全。它可能恰好给出有帮助的回应,也可能因理解偏差产生严重后果。最终还是需要考虑具体场景、人的心理特点、可靠性和责任安排。人类心理有些方面出乎意料地可以用简单结构描述,但不能由此忽略其复杂而脆弱的部分。
Lex: 我想转到你写过的《The 50-Year Quest: My Personal Journey with the Second Law of Thermodynamics》。你研究热力学第二定律近五十年。这个定律究竟是什么?你一路上理解了什么?
Wolfram: 我喜欢用很直观的方式表述:随着时间推移,许多系统倾向变得更随机。热力学第二定律通常和熵增加联系在一起。在热现象里,我们看到热量自然地从高温处传向低温处,机械运动在摩擦中逐渐转化为热,原来井然有序、可被有效利用的能量,以更分散、更随机的形式出现。
人们在十九世纪二十年代因蒸汽机效率问题特别关注这些现象。法国工程师 Sadi Carnot 研究热机可能达到怎样的效率,他的父亲也有数学与工程背景。当时人们甚至还不知道热究竟是什么,有人认为它是一种名为 caloric 的特殊流体,会从热物体流入冷物体。到了十九世纪六十年代左右,热机与能量转换的研究逐渐形成更一般的认识:宏观有序的运动可以退化为分散的热,而这些热通常不容易无损地重新变成原来的机械运动。这不再只是蒸汽机的问题,而逐渐成为解释整个自然界演化方向的普遍原则。
最让我着迷的问题,是为什么会这样。把大量分子整齐放在容器的一个角落,它们不断碰撞后通常会逐渐散布到整个容器,而不会在混合很久之后突然自动回到原来的整齐队列。你把墨水滴进水里,墨水会扩散,不会平白重新聚成一团再跳出水面。把鸡蛋搅散很容易,但它不会自发恢复原来的结构。为什么微观分子的运动如果遵守某些力学定律,宏观世界却呈现如此明显的不可逆方向?十九世纪后半叶,科学家们花费大量精力,试图从基本力学推导出这一规律。
Wolfram: 热力学第一定律主要涉及能量守恒:热能、机械能和其他形式的能量可以转化,但总量受到守恒约束。第二定律却更神秘,它不是简单告诉我们某种东西保持不变,而是告诉我们宏观过程倾向沿着一个特殊的时间方向演化。十九世纪物理学家反复尝试回答,能否仅从微观力学推导这一规律。
我对它的兴趣从童年开始。八九岁时,我很着迷于深空探测器,几乎把每一艘探测器都当成老朋友,研究它们的结构、设备和各项数据。随后我想弄明白航天器是如何工作的,兴趣便转向了物理学。回头看,这种转向发生得恰到好处:如果我一直只关注六十年代后期的航天事业,可能还要等待很长时间才能遇到后来那样丰富的发展机会。
我十二岁从英国的小学毕业时,给自己找了一套大学物理教材。第五卷讲统计物理,封面是一幅连续图像:容器里的分子最初聚在一边,随后逐渐散开,直到遍布整个空间。我想知道是什么力量让这种过程发生。那本书还暗示,这种变化似乎可以从更基本的原理推导出来。这对当时的我很重要:我学过的某些物理定律看起来像必须接受的事实,但这里竟然有机会用数学与逻辑解释它们为什么必然成立。
大约 1973 年,我写下自己第一段认真的计算机程序,就是为了重现教科书封面上的图像。那时的计算机有一张桌子那么大,使用纸带,内存只有大约八千个十八位字,折合不到今天非常小的一段文件容量;它也不方便做浮点计算。于是我把容器里的分子改成格子上的对象,让它们每次移动一个格子,试图模拟扩散。结果生成的图案与书上的完全不像,我认为自己失败了。
多年以后我才知道,那幅教科书图像本身的模拟也有很大简化,是六十年代初用当时最先进的超级计算机制作的,依然没能完全模拟所声称的物理过程。更有趣的是,我最近才意识到,童年程序所呈现的复杂、看似随机的行为,其实已经碰到了我后来研究的计算不可约性。只是当年的我只觉得“它与预期不符,所以错了”,没有意识到“极其简单的模型居然变得这么随机”可能是一项重要发现。
此后我研究粒子物理等其他领域,但一个问题始终放不下:既然第二定律倾向让系统走向无序,为什么宇宙从大爆炸之后形成了星系、恒星以及各种复杂的有序结构?到了 1980 年左右,我一边研究星系形成,一边关注神经网络、大脑如何产生复杂行为,也研究过雪花和流体动力学。起初我把它们看成完全不同的问题,后来越来越觉得,它们或许共享一个根本主题:复杂结构怎样从简单的起点与规则中产生?
Lex: 星系的形成与大脑的思维,为什么能放在同一个问题里研究?你是怎样找到足够简单的共同模型的?
Wolfram: 1979 年起,我开发了第一个大型符号计算系统 SMP(Symbolic Manipulation Program),它是后来 Wolfram Language 的前身,其中已有大量相似的符号计算思想。建造语言时,我必须决定哪些基本计算原语值得纳入;许多当时形成的选择,四十多年后仍然发挥作用。这段经历改变了我的研究方式。做传统自然科学时,世界先提供现象,研究者再试图解释它;设计编程语言时,恰好相反,你自己规定基本构件,然后探索从它们能创造什么。
于是我在 1981 年左右开始问:能不能人为建造一种最简的“物理学”,随便规定极简单的演化规则,再观察它们产生什么结构?我尝试为星系、大脑、雪花等复杂系统寻找可能的最小计算模型,最终走向了元胞自动机(cellular automata)。最简单的版本是一排黑白格子,每次根据某个格子与左右邻居的状态,决定下一步这个格子是黑还是白。把每一步结果依次排成图,就能清楚地看见系统随时间的演化。
有趣的是,元胞自动机对很多现象确实是好模型,但对当初直接激励我研究的星系与大脑,它却不是特别合适的描述。科学发现有时就是这样:你为了理解 A 和 B 发明一种工具,结果发现它真正揭示的是更一般、未曾预料的现象。
我早期发表关于元胞自动机的论文,开头常常提到热力学第二定律:如果无序不断增加,为什么还会形成复杂的有序结构?当时我尤其注意某些不可逆的计算过程可以从看似随机的起点产生秩序。不过后来我才发现,真正最有趣的一面甚至不依赖一开始就设定不可逆规则。
Wolfram: 我采用非常朴素的实验方法,把各种简单的元胞自动机规则依次运行,观察图像,就像刚发明一架“计算望远镜”,先把它对准最显眼的地方。每种初等规则都能编号,其中有一个著名的规则 30(Rule 30)。我在 1981 年左右就画过它的图,但当时注意到它左右不对称,反而想先研究更容易处理的对称规则,于是几乎把它放在一边。
1984 年左右,我得到一台早期激光打印机,能打印比之前清晰得多的图像。我想找个有趣的图案来试试它,便重新运行规则 30 并把结果高分辨率打印出来。规则本身十分简单,甚至只从最上方一个黑色格子开始,结果在不断更新中形成一个三角形。可三角形的内部复杂得惊人,其中大量区域看起来像彻底随机的噪声。尤其沿中心列观察,直到现在也很难发现可以概括它的简单规律。
这让我想到圆周率的数字序列:我们知道生成 π 的数学规则,可写出 3.14159……后,数字本身依然显得毫无规则。规则 30 也是一样,知道怎样一步步生成,不意味着知道远处某一步的结果是什么。这就是计算不可约性的直观冲击。
我曾在 2019 年前后设立奖金,鼓励人们证明规则 30 的中心列具有某些性质。有人提出过研究结果,但我仍不能断言最重要的问题究竟会很快解决,还是需要上百年。2007 年我还为一台极小的候选通用图灵机设立过奖金,要证明它到底是不是通用图灵机。最终年轻的研究者 Alex Smith 用大约六个月给出漂亮的证明,获得了奖金。正因为见过这个结果,我不敢轻易预测某个形式简单、看似困难的问题会阻挡数学家多久。规则 30 甚至让我想起费马大定理:陈述极其简单,似乎触手可及,严格证明却异常困难。
Lex: 最违反直觉的正是这一点:规则简单到人人可以看懂,我们却几乎无法提前预测中心列会怎样发展,也难以证明它的性质。
Wolfram: 是的。规则 30 帮助我理解,宏观上像随机噪声的行为不一定需要外部随机性作为起点。确定性的简单规则就可以产生这种复杂性。这与热力学第二定律有关:我们能用极短的文字描述一个初始状态,随后经过不可约的演化,它会变成难以通过短描述和少量计算复原的状态。
Wolfram: 这里还必须区分微观运动的可逆性和宏观演化的不可逆性。拍摄两个台球相撞,然后倒放录像,若只看这一对理想化的台球,你通常无法断言哪个播放方向才是物理时间的正向;经典力学中的许多微观规律具有这种时间反演性质。但如果把几百万个球放在一起,看它们从整齐排列逐渐碰撞、混合、扩散,我们通常能认出哪边是“过去”:现实中常见的是有序变无序,而不是特殊的无序配置自发聚回有序状态。
问题并非微观规则绝对禁止后一种演化。在某些精心设定的状态里,如果你把所有分子的位置、速度完全倒转,它们理论上可以沿相反轨迹回到有序状态。真正的问题是:为什么自然中几乎从来看不到系统恰好准备出这样极端特殊的初始状态?早年我把它和密码学作比较:一个简单的密钥或规则通过计算生成复杂得难以逆向理解的输出。现在我更倾向把第二定律视为计算不可约系统与计算能力有限的观察者共同产生的现象。
我们既不能追踪容器中每个分子的全部运动,也无法轻易构造那种只有通过长时间不可约计算才能设计出来的、恰好会演变为整齐宏观状态的分子配置。分子其实在按照具体规则运动,但对我们的宏观观察而言,它们表现为随机混合。这个观察者的限制并不是一项细微误差,而可能正是理解热力学时间箭头的重要部分。
Lex: 那“计算能力有限的观察者”能不能严格形式化?它到底是指人的大脑计算速度慢,还是类似计算复杂性理论里某种资源限制?
Wolfram: 可以借助图灵机、计算复杂性、多项式时间等概念尝试建立正式定义,但直觉更容易说明:为了理解一个系统,我们愿意、能够花费多少计算量?一个房间里有天文数量的分子,它们在极短时间尺度里发生海量碰撞。所有这些微观运动所实现的计算,远远超过人脑每秒能够详细模拟的数量。只要演化是不可约的,我们就无法在有限资源内重建它们的每一个状态。我们只能进行少量计算,提取温度、压强、密度等宏观性质,并从这样的层次判断系统怎样变化。第二定律就是微观复杂演化与我们能够准备、测量、归类的宏观状态之间发生的关系。
Lex: 我们经常把第二定律说成“熵总是增加”。但熵究竟是什么?它又告诉我们宇宙的时间演化具有怎样的方向?
Wolfram: 熵在热力学史上有不止一种表达。Rudolf Clausius 最初从热量、温度和热机过程定义熵;Ludwig Boltzmann 后来给出更偏组合数学的描述。在 Boltzmann 的框架里,我们先规定观察者掌握的宏观信息,例如一个盒子的容积、气体压强和温度,然后问:有多少种不同的微观分子排列与这些宏观条件一致? 熵与这个可能微观状态数的对数有关。这种定义特别有力,因为它把宏观的不确定性、观察者不知道的细节,与微观配置数量直接联系起来。
Boltzmann 时代,物质到底由离散粒子组成,还是本质上连续,并没有像今天这样得到广泛认可。古希腊人早就提出过原子思想,化学中水含氢与氧的固定比例也提供了线索,但十九世纪中期仍存在重大争论。Boltzmann 为了方便计数,假设物质由离散分子构成,甚至在计算中引入离散的能量状态。当时他一度把这种做法视为数学化的理想模型,未必肯定宇宙真的离散。今天回头看,这种想法在某种意义上已经接近后来量子理论的关键结构。
真正的证据逐渐积累。显微镜下花粉微粒出现的布朗运动,后来被解释为微小粒子不断遭受离散水分子撞击的结果。化学、统计力学与微观实验的进展,使原子和分子不再只是计算方便的假设。这个科学史过程提醒我们:某个时代被视为纯粹数学模型的离散结构,可能恰恰是现实世界真正的组成方式。
Wolfram: Max Planck 长期研究热力学,曾希望从辐射与物质的相互作用中理解第二定律。他面对黑体辐射实验曲线时,发现已有理论难以与观测吻合,却意外地发现采用类似 Boltzmann 的离散假设可以得到正确公式。起初他并不一定认为这种离散性就是物理现实本身。随后 Einstein 从光量子的角度进一步提出,电磁辐射也许真的具有离散单位,后来我们称它们为光子。
1905 年是 Einstein 的奇迹之年:狭义相对论、布朗运动与光量子等重大论文几乎同时出现。很多人知道这段历史,但我最近研究时才注意到,之前他还写过好几篇尝试讨论、证明热力学第二定律的论文。我觉得那些早期推导并不令人满意,却非常有趣,因为它们显示他的研究一直与统计力学和离散化问题紧密相连。Einstein 对布朗运动和光量子的工作,都与确认物理世界存在真实的离散构件有关。
Boltzmann 虽然身处一个对离散性持怀疑态度的时代,却逐渐相信物质最终会被证明为离散。他曾表达过一种感慨:一个人很难单独抵抗整个时代的主流看法,所以他要尽可能记录自己的理解,留待后人验证。后来原子、分子和光量子的真实性逐步受到认可,物理学家的注意力又转向了另一个难题:空间本身是不是也离散的?
在二十世纪初,连 Einstein 也思考过空间的离散构造,但人们缺少能与相对论兼容的数学框架。我记得 Einstein 在 1916 年的一封信中表达过类似看法:空间最终可能会被理解为离散的,只是当时尚无恰当的数学工具。我认为今天的计算物理学研究已经提供了值得认真探索的新工具,或许能让我们重新处理这个问题。
Lex: 你对自己的物理学项目显然有很强的信心,认为现实底层不仅物质和辐射可以呈现离散性,连空间也可能如此。那么暗物质会不会也是我们误解空间结构造成的现象?
Wolfram: 我最近常说一句带有挑衅意味的话:“暗物质可能是我们这个时代的热质说(caloric)。” 当人们只熟悉流体和连续介质时,便想象热也是某种流体;后来我们知道热与离散粒子的微观运动有关。现在我们非常熟悉基本粒子,所以看到星系旋转曲线等暗物质现象,就自然猜想暗物质是某种还没有发现的粒子。但我怀疑,暗物质也许反映了空间本身的某些性质,而非额外的一群粒子。这仍是我的研究猜想,并不是已经得到证实的结论。
具体机制是什么,我还不知道。我希望找到一种空间领域里的“布朗运动”:它不必让我们直接看见空间原子,却能够像布朗运动揭示分子一样,暴露空间微观离散结构的效应。人们在十九世纪很早就观察到布朗运动,但直到二十世纪初才理解它与分子的联系。关于暗物质的天文学异常也已经研究了很长时间,因此不排除某种已知现象中就藏着重要线索。
我们正在考虑黑洞合并的观测是否可以提供这样的迹象。假如底层空间离散,黑洞合并过程中出现的引力波特征,也许会与连续时空模型的某些预期存在差异。我不能声称已经找到了确定证据,但这种可能性值得计算和检验。物理学史一再显示,“世界在这里显然是连续的”可能只是观察尺度的结论;我们今天对空间的直觉,也未必是终局。
Wolfram: 关于熵还有一个乍看很尖锐的悖论。假设你真的知道气体里每一个分子的精确位置和运动状态,那么在一个确定性演化模型中,给定某个完整微观状态,下一步就对应一个明确状态。按照“与已知信息相容的微观状态数”来计算,如果你掌握的已知信息已经精确到唯一的微观配置,那么这个数就是 1,它的对数是 0,似乎就没有熵随时间增加的问题。只有当我们不知道全部分子细节,只知道压强、温度等概括性信息时,才会发现越来越多的微观状态都与我们所见的宏观状态相容。
美国物理学家 J. Willard Gibbs 在二十世纪之初发展了粗粒化(coarse-graining)的思想:真实系统在微观上有极其精细的运动,我们只能把那些状态分成较粗的类别加以观察。这个想法很重要,但长期以来存在一个隐含问题:究竟允许怎样的粗粒化?理论上可以设计一种极其精细、极其巧妙的分类规则,专门识别某些微观状态正是从某个简单初始配置演化而来;如果你能做到这一点,宏观熵增加的结论可能就不是同一种形式了。为什么现实观察者不这样定义分类?
我认为计算不可约性提供了关键答案:要作出那种精心定制的微观分类,观察者就必须进行大量不可约计算,准确分辨复杂轨迹的来源。但计算能力有限的观察者无法这样做,只能执行相对简单的测量和归类。有效的粗粒化并不是任意由数学家想象的分类,而是由观察者实际能够计算、识别的东西限制的。 在这种约束下,微观演化继续产生复杂状态,而观察者只看到许多不同状态共享的宏观特征,于是熵增加便以熟悉的方式出现。
Lex: 所以宇宙里的任何观察者都必然受到计算限制吗?如果科学工具越来越精密,限制会不会消失?
Wolfram: 我说的是像我们这样的观察者,包括人类所借助的科学仪器。你可以用先进设备精确追踪少量分子,也可能在很小尺度上看到第二定律的统计性波动,甚至某些局部看起来“违背”宏观熵增方向的事件。但随着体系增大,分子数量变得极其庞大,我们仍不可能记录、计算全部细节。因此需要区分:“任何逻辑上可能的观察者是否有限”,以及“像人类这样、有有限经验与可操作测量能力的观察者是否有限”。我不声称已经完全知道前一类观察者是什么样子。
一个更深的观点是,我们之所以能够作出“左转还是右转”“某件事已经发生”这种明确判断,本身就意味着我们把庞大复杂性压缩成少数类别。若我们完全不进行这种压缩,不形成确定事件,不建立符号叙述,那么我们就不会拥有熟悉的心智经验。我们会更像整个宇宙自身那样,包含所有持续发生的复杂过程,却不再以人的方式拥有明确的主观线索和身份。
Lex: 我们之前谈过“作为一台计算机是什么感觉”。能不能再想象一下:如果成为一个计算能力没有上限、完全不需要简化现实的观察者,会是什么感觉?这是不是意味着真正的存在反而必须有所局限?
Wolfram: 在我的研究中,有一个概念叫 Ruliad,它尝试描述所有可能计算演化相互交织后的整体结构。我们熟悉的规则空间是其中某种切面。一个人、一个文化或一种智能,实际上都处在某种相对特定的规则表达区域。随着我们学习更多数学、物理和计算范式,就像逐渐向外拓展,接触 Ruliad 中更多的可能性。
乍看这是一个永远值得追求的目标:我们能不能最终理解所有计算、进入 Ruliad 的每一处?但我越来越觉得,这里有一个根本悖论。如果你变成所有可能的事物,便不再以某一种连贯的方式存在。 我们所谓明确的身份,意味着你具有某些特征,而不具有其他所有特征;你处在一个相对确定的物理位置、规则位置与经验结构里。若一个主体完全弥散到所有可能的计算模式,便没有一条可以保持统一的活动方式,也无法保有我们理解的“我是同一个我”。
Lex: 这听起来像对笛卡尔的重新表述:我在 Ruliad 中有一个特定的位置,所以我存在。也可以反过来说,要以人类所理解的方式存在,就必然要受到计算能力与经验范围的限制。
Wolfram: 对,我认为至少对我们这种存在方式是这样。重要的不是简单说“因为我们无知,所以只能简化”,而是观察者以某些稳定的抽象方式存在,恰恰让世界可以对它呈现出连贯的结构。房间里空气分子的复杂运动不是幻觉,气体压强也不是幻觉;压强是我们在特定尺度上研究大量分子时得到的真实而有用的聚合性质。值得惊叹的是,这些聚合性质居然遵守清楚而精确的定律。压强、体积与温度之间有气体定律,并不是一件理所当然的小事。
Wolfram: 我觉得当前整个研究方向最令人兴奋的地方,是我们可以把不同物理理论视为类似的观察者问题。根据我们的假设,底层空间可能由不断重写的空间原子和超图构成,但人们在宏观尺度上看到的是近似连续的空间。量子系统则可能有复杂的分支历史,分支彼此分裂、合并;我们作为系统内部的一部分,自身的物理过程也参与这些分支,但主观上却把它们组织成一条持续的经验线索。
从这里可以形成三种相互平行的粗粒化:在普通空间里,我们汇总大量空间原子的行为,观察宏观时空;在我称为分支空间(branchial space)的结构里,我们汇总许多量子历史分支,形成熟悉的量子描述;在统计力学里,我们汇总大量分子微观配置,得到温度、压强、熵及它们的演化规律。
Lex: 三个领域都可以说是在做聚合,但最惊人的问题是:为什么聚合之后居然还有严格定律?它们分别是什么?
Wolfram: 在我的理论框架与研究目标中,空间的宏观规律对应 Einstein 的引力场方程和广义相对论;分支空间的宏观规律对应量子力学;分子系统的宏观规律则对应统计力学,尤其是热力学第二定律。对我来说,这意味着二十世纪物理学的三大理论——广义相对论、量子力学和统计力学——可能都与同一组基本事实有关:底层过程具有计算不可约性,而观察者受计算限制,并把自己看作在时间中持续存在。
过去我们可能把引力方程或量子规律当成宇宙恰好具有的性质;第二定律虽然一直有人尝试推导,却始终存在深层疑问。我认为,这三类规律有望从计算演化与观察者结构的相互作用中得到统一解释。它们不单纯来自数学或一般计算规则,还需要明确我们是什么样的观察者。这里强调的不是人类拥有两只眼睛、只能看见某些波长等偶然细节,而是我们进行有限计算、提炼宏观规律、相信自我在时间中延续的基本结构。
我认为这很了不起:观察者极其宽泛、粗略的特征,竟有可能与精确的物理定律联系起来。当然,这仍属于我提出的理论框架,相关推导与现实检验需要继续研究。把它称为一种有前景的理论解释,比把所有问题宣告彻底解决更合适。
Lex: 按照你的说法,我们所感知的现实,已经是有限观察者从不可约底层过程里抽取出的简化版本。那它是不是一种幻觉?更根本的问题是:为什么宇宙存在?“现实”与“对现实的表示”究竟有什么差别?
Wolfram: 我不愿意简单把“简化”称为“幻觉”。对我们来说,一切可知都经过经验,而经验确实是在某个尺度上对底层过程的表征。既然宏观规律能稳定作用于我们,它就具有现实性,即使底层结构远比它复杂。至于为什么整个宇宙存在,我的 Ruliad 概念给出了一种非常大胆的思考方式:一旦你接受计算这一概念,所有可能计算演化的某种极限整体就成为数学上不可回避的对象。就像在已经定义好“2”“加法”和数字系统后,2 加 2 等于 4 不是任意约定出来的结果一样,我猜测 Ruliad 也具有某种必然性,而且作为整体只有一个。
随后真正有意思的问题便变成:为什么我们会在那个整体中的一个局部区域,以某种观察者的方式体验到一个稳定的物理宇宙?如果 Ruliad 的存在是数学上的必然,那么像我们这样的观察者怎样存在,便是另一个需要讨论的条件。我们所经验的物理现实可能来自两个要素:那个包含计算可能性的整体,以及我们作为特定观察者对它的采样方式。
这些问题很容易与宗教、神学和形而上学发生联系。在过去几百年,科学通常避开“宇宙为什么存在”这样的问题,认为自己只能研究宇宙如何运行。但我觉得计算宇宙的框架至少使我们可以重新讨论某些根本问题。甚至可以说,在某种意义上,“所有计算可能性的整体”作为抽象对象是否存在,比“我们这种特定观察者为何存在”更接近数学上的必然;后者反而取决于许多具体条件。这不是一种传统神学证明,而是我尝试理解存在、数学必然性与物理经验关系的方式。
Lex: 我们只能体验 Ruliad 的极小部分,但科学仪器一直在拓展这一边界。若能沿着它旅行,看看那些完全陌生的规则世界,会非常精彩。你研究外星智能,也研究各种简单程序,是不是一直在尝试与这些陌生计算系统对话?
Wolfram: 某种意义上正是如此。新技术不断让此前观察不到的现象变得可见。显微镜扩展了人类视觉尺度;电子放大等技术使人们能够放大极其微弱的信号,也参与推动了二十世纪量子现象的研究。未来还会有无数新的测量方式与认识范式。计算不可约性甚至暗示,计算宇宙中还有无穷多可以发现的局部可约结构,科学探索远远没有尽头。
我把单纯研究“不同计算规则会做什么”的工作称为 ruleology,可以理解为一种研究规则行为的科学。你随便走到 Ruliad 的另一处,运行几个规则,就能看到种种复杂现象;难点是,那些现象往往没有我们熟悉的用途和意义。它们只是按照自己的规则运行,我们还不知道怎样把它们纳入人类的概念体系。就像与真正陌生的外星智慧交谈一样,障碍未必是对方不够复杂,而是双方根本没有共享的意义结构。
我在八十年代曾与非常优秀的数学家一起研究简单计算系统。我们试图用已有数学方法分析那些复杂行为,很多时候最终只能承认:“这些工具对它无能为力,我们几乎没有可说的东西。”我的一个重要收获,恰恰是意识到连优秀数学家都无话可说,本身就是值得研究的现象。它提示人类现有数学只是计算宇宙中的一部分,而别的区域具有我们尚未建立语言来描述的规律。发现最简单的程序也能产生令人惊叹的复杂性,就是我第一次真正听见这个陌生世界的声音。此后的研究,某种程度上一直是在学习怎样理解这种声音。
Lex: 你正在研究一些极其宏大的问题,感觉新的突破近在眼前,可你和所有人一样只有有限的生命。你做过全身 MRI,亲眼看到自己最终仍由血肉构成。想到也许来不及看到这些理论的发展,会不会有点难过?
Wolfram: 确实有点遗憾,我当然想看到这些问题最终会怎样发展。但这也引出另一个思想实验:假设未来有一天我们能够真正实现人体低温保存,在不破坏组织的情况下暂停生命,过一百年再醒来。具体技术我不知道,但设想我们最终找到相关物理和生物学办法,就像某些此前看起来不可能的技术突然实现一样。即便可以这样穿越时间,我们仍会面对另一种困难:一个人总是嵌在他所处的历史时刻里。
如果我生活在五百年前,我今天关心的许多问题可能根本不会被当作问题;而五百年后的人也可能认为我们现在重视的东西非常奇怪。某个时代的学者可能一辈子热衷于讨论一根针尖上能站多少天使,彼时被认为最重要的思想,在另一个时代却成了陌生的历史遗迹。于是,即使把一个人放到遥远未来,他也不一定能立即融入那个社会最关心的事情。
我有幸提出或构建过一些自己觉得能长期发挥作用的观念与工具。这既是幸运,也有些复杂。倘若一个人在二十五岁就完成此生最重要的发现,所有人马上宣布“伟大的事情已经完成”,那往后的几十年会显得很难安排。相反,如果你的想法需要很长时间才逐渐发展、不断出现新的应用,它就会持续给你新的工作和期待。
ChatGPT 的出现便是一个让我惊喜的例子。我预计过自然语言与计算语言结合终将深刻改变世界,但原本以为真正普及可能还需几十年,甚至五十年。结果发展比我想象得更快,让原本遥远的可能性提前进入现实。对我而言,这当然是好事:我也许能够亲眼看到自己长期努力推动的计算式知识和计算语言迎来新的繁荣。
Lex: 我想我可以代表很多欣赏你工作的人说,希望你能继续研究很长时间。你多年来提出了许多有趣的思想,也建造了许多真正改变人们工作的系统。如今 GPT 与大型语言模型又开辟了新局面,我非常期待看到你在这个领域继续做什么。我从很早以前就是你的读者与支持者,尤其感谢你写出《一种新科学》,探索元胞自动机中那么深的奥秘。你曾经启发了那个年纪还很小的我,让我走上研究人工智能和复杂世界的道路。
今天能够和你这样长时间地讨论这些想法,是我非常珍惜的经历。我们一直聊过了午夜,差不多已经四个多小时,但我觉得还可以继续聊下去。我们把其余话题留到下一次吧。这是你第四次来播客,我相信以后还会有更多轮这样的对话。Stephen,非常感谢你。
Wolfram: 我也非常高兴。谢谢你。
Lex: 最后,我想以 George Cantor 的一句话结束今天的谈话:“数学的本质在于它的自由。”感谢大家倾听,我们下次再见。
北京睿智融科控股股份有限公司
二〇二三年
2.1. 系统配置.... 1
2.2. 网路配置.... 2
2.3. 行情源选择.... 2
2.4. 登录界面.... 3
3.1. 我的板块.... 9
3.1.1. 主页界面.... 9
3.1.2. 模型研究.... 10
3.1.3. 模型交易.... 28
3.2. 行情模块.... 33
3.2.1. 管理面板.... 35
3.2.2. 行情报价界面.... 49
3.2.3. 个股分析界面.... 63
3.2.4. 个股分时界面.... 76
3.2.5. Level12 行情界面.... 85
3.2.6. 行情模块快捷键汇总.... 94
3.3. 交易模块.... 95
3.3.1. 账号管理.... 96
3.3.2. 交易服务.... 97
3.4. 极简模式.... 247
3.4.1. 股票交易.... 248
3.4.2. 信用交易.... 249
3.4.3. 港股通.... 250
3.4.4. 策略交易.... 251
3.4.5. 其他.... 错误!未定义书签。
3.5. 投资研究.... 282
3.6. 其他设置.... 284
3.6.1. 顶部工具栏.... 284
3.6.2. 底部状态栏.... 285
3.6.3. 设置.... 294
3.6.4. 操作.... 377
3.6.5. 布局.... 396
3.6.6. 当前账号.... 398
3.6.7. 用户协议.... 398
3.6.8. 交易.... 399
3.6.9. 帮助.... 399
3.6.10. 回转交易.... 399
3.6.11. 换肤.... 400
附录.... 402
迅投 QMT 极速策略交易系统是一款专门针对券商、期货公司、信托等机构的高净值客户开发设计的集行情显示,投资研究,产品交易于一身,并自备完整风控系统的综合性平台。其自带的行情显示系统可以灵活显示沪深两市所有类型股票、债券和国内五大期货交易所所有合约的实时行情;自带投研量化平台可以灵活实现 CTA,无风险套利等多种量化策略,并能够对策略进行回测检验和自动化交易;支持股票交易、期货交易、融资融券交易、组合交易等多种交易类型,可以实现对冲下单,组合下单,以及高度灵活的算法交易,并支持对多个资金账号进行批量化的管理;多层次并行风控的处理方式,可以对单一帐号、多个帐号分别同时进行不同规则的风控检查,大幅降低交易延迟、提高风控执行效率。同时,迅投 QMT 极速策略交易系统还支持完整数据导入导出等诸多功能。
| 操作系统 | Windows® 10 64-bit |
|---|---|
| 处理器 | Intel® CoreTM i7-7770 或更高配置 |
| 显卡 | Intel® HD Graphics 4400 |
| 内存 | 8 GB RAM |
| 储存 | SSD 200G 可用空间 |
| 网络 | 10M 及以上 |
分辨率
1920×1080
推荐配置
服务器建议网络使用百兆及以上网络接入,客户端网络建议 10 兆以上网络接入。
用户可在行情源选择中添加所需使用的行情源。

通信设置行情选择界面
行情选择:行情选择中包括行情主站和交易中心。行情主站指行情界面的行情来源,交易中心指交易界面盘口的行情来源。
行情选择支持自动更新、自动更换服务器、断线弹出窗口、自动隐藏四种。
自动更新:自动更新行情地址。
自动更换服务器:某一行情源断开后,不会重新连接,会寻找下一个可用行情源。
断线弹出窗口:某一行情源断开后,自动弹出行情源设置窗口。
自动隐藏:“断线弹出窗口”开启后生效,断线并重连成功后,行情源设置窗口自动隐藏。

登录界面
输入正确的用户名密码及验证码后可正常登录(资金账号登录模式下直接输入资金账号及对应的交易密码,需要该资金账号已添加至管理端账号白名单),若出现输入错误或网络问题导致无法正常登录会出现相应的提示,可在通信设置中进行修改,或联系对应的人员帮助解决。
“行情 + 交易”:登录进入系统后,可同时查看行情信息并进行交易。
| 序号 | 名称 | 语幅 | 总额 |
|---|---|---|---|
| 1 | 园区开发 | 0.00% | 0 |
| 2 | 白色家电 | 0.00% | 0 |
| 3 | 贸易 | 0.00% | 0 |
| 4 | 传媒 | 0.00% | 0 |
| 5 | 证券 | 0.00% | 0 |
| 6 | 机场客运 | 0.00% | 0 |
| 7 | 电气设备 | 0.00% | 0 |
| 8 | 采掘服务 | 0.00% | 0 |
| 9 | 化学制品 | 0.00% | 0 |
| 10 | 造纸 | 0.00% | 0 |
| 11 | 石油矿业开 | 0.00% | 0 |
| 12 | 包装印刷 | 0.00% | 0 |
| 13 | 通信服务 | 0.00% | 0 |
| 14 | 景点及旅游 | 0.00% | 0 |
行情 + 交易
“独立交易”:登录进入系统后,可进行交易。

独立交易
“独立行情”:登录进入系统后,仅可查看行情。

独立行情
“记住密码”功能可以使用户操作起来更加方便、快捷(资金账号登录无此项功能)。
“极简模式”:登录进入系统后,进入极简模式(详见 3.4.极简模式)。

极简模式
“意见反馈”窗口可随时提出意见反馈,相应客服人员会在第一时间进行处理。
“系统信息”窗口可以查看系统信息,可以复制和导出系统信息的内容。
迅投 QMT 极速策略交易系统涵盖三大功能板块:我的板块,行情板块和交易板块。

我的板块
我的板块主页界面:主要包括大盘指数、自选股、热门板块、策略列表、快速交易、用户信息、账户信息和运行中交易 8 个模块。
模型研究:主要提供技术指标和自定义策略模型指标的研究、编辑和回测。
模型交易:添加的模型策略,可选择模拟盘或实盘运行。模型运行过程中,会有相应的模型交易信号,输出日志,持仓,委托和成交产生。
| 序号 | 代码 | 名称 | 涨幅 | 最新 | 涨跌 | 总额 | 委买价 | 委卖价 | 换手率 | 总市值 | 流通市值 | 昨收 | 今开 | 最高 | 最低 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 000001 | 平安银行 | 0.44% | 15.08 | 0.07 | 4.37 亿 | 15.88 | 15.90 | 0.14% | 3081.66 亿 | 3081.60 亿 | 15.81 | 15.81 | 16.00 | 15.70 |
| 2 | 000002 | 万科 A | -4.02% | 19.03 | -0.83 | 12.27 亿 | 19.83 | 19.84 | 0.63% | 2305.31 亿 | 1926.93 亿 | 20.66 | 20.43 | 20.56 | 19.81 |
| 3 | 000004 | 国华网安 | 0.46% | 17.37 | 0.08 | 1743.26 万 | 17.33 | 17.37 | 0.86% | 27.10 亿 | 20.21 亿 | 17.29 | 17.68 | 17.74 | 17.22 |
| 4 | 000005 | ST 星源 | 1.80% | 2.26 | 0.04 | 1619.56 万 | 2.26 | 2.27 | 0.68% | 23.92 亿 | 23.91 亿 | 2.22 | 2.21 | 2.28 | 2.21 |
| 5 | 000006 | 深振业 A | -3.06% | 4.75 | -0.15 | 7098.14 万 | 4.75 | 4.76 | 1.09% | 64.12 亿 | 64.12 亿 | 4.90 | 4.88 | 4.95 | 4.75 |
| 6 | 000007 | *ST 全新 | 4.63% | 7.01 | 0.31 | 4123.93 万 | 7.00 | 7.01 | 1.92% | 24.29 亿 | 21.66 亿 | 6.70 | 7.00 | 7.04 | 6.67 |
| 7 | 000008 | 神州高铁 | 0.41% | 2.42 | 0.01 | 2016.76 万 | 2.42 | 2.43 | 0.31% | 67.30 亿 | 65.19 亿 | 2.41 | 2.41 | 2.43 | 2.41 |
| 8 | 000009 | 中国宝安 | -1.94% | 10.09 | -0.20 | 1.86 亿 | 10.09 | 10.10 | 0.71% | 260.24 亿 | 257.44 亿 | 10.29 | 10.33 | 10.33 | 10.06 |
| 9 | 000010 | 美丽生态 | 0.50% | 3.35 | 0.02 | 1443.61 万 | 3.35 | 3.36 | 0.82% | 27.47 亿 | 17.49 亿 | 3.33 | 3.32 | 3.40 | 3.32 |
| 10 | 000011 | 深物业 A | -3.64% | 12.18 | -0.46 | 9806.23 万 | 12.18 | 12.20 | 1.48% | 72.59 亿 | 64.12 亿 | 12.64 | 12.56 | 12.73 | 12.10 |
| 11 | 000012 | 南玻 A | -0.74% | 6.73 | -0.05 | 4013.55 万 | 6.72 | 6.73 | 0.30% | 206.06 亿 | 131.78 亿 | 6.70 | 6.79 | 6.83 | 6.71 |
| 12 | 000014 | 沙河股份 | -2.35% | 10.79 | -0.26 | 1.17 亿 | 10.79 | 10.81 | 5.26% | 21.74 亿 | 21.76 亿 | 11.85 | 11.10 | 11.29 | 10.75 |
| 13 | 000015 | 深康佳 A | 1.06% | 5.13 | 0.07 | 2740.73 万 | 5.12 | 5.13 | 0.33% | 123.53 亿 | 81.96 亿 | 5.86 | 5.00 | 5.23 | 5.05 |
| 14 | 000017 | 深中华 A | 0.63% | 3.22 | 0.02 | 568.04 万 | 3.22 | 3.23 | 0.58% | 17.75 亿 | 9.76 亿 | 3.20 | 3.20 | 3.29 | 3.20 |
| 15 | 000019 | 深粮控股 | 2.70% | 8.74 | 0.23 | 2.34 亿 | 8.73 | 8.74 | 6.51% | 180.73 亿 | 36.37 亿 | 8.51 | 8.37 | 8.93 | 8.30 |
| 16 | 000020 | 深华发 A | 0.69% | 8.71 | 0.06 | 292.11 万 | 8.72 | 8.75 | 0.18% | 24.66 亿 | 15.78 亿 | 8.65 | 8.69 | 8.78 | 8.66 |
| 17 | 000021 | 深科技 | 1.79% | 10.70 | 0.19 | 4468.03 万 | 10.77 | 10.78 | 0.27% | 168.23 亿 | 168.17 亿 | 10.59 | 10.69 | 10.84 | 10.67 |
| 18 | 000023 | 深天地 A | -1.39% | 11.35 | -0.16 | 825.45 万 | 11.34 | 11.35 | 0.52% | 15.75 亿 | 15.75 亿 | 11.51 | 11.51 | 11.62 | 11.33 |
| 19 | 000025 | 特力 A | -0.46% | 13.11 | -0.06 | 2137.36 万 | 13.11 | 13.12 | 0.41% | 56.51 亿 | 51.49 亿 | 13.17 | 13.27 | 13.31 | 13.09 |
| 20 | 000026 | 飞亚达 | 1.05% | 9.92 | 0.18 | 3269.33 万 | 9.92 | 9.93 | 0.92% | 42.26 亿 | 35.64 亿 | 9.74 | 9.73 | 10.10 | 9.66 |
| 21 | 000027 | 深圳能源 | -0.16% | 6.35 | -0.01 | 4075.91 万 | 6.34 | 6.35 | 0.13% | 302.09 亿 | 302.09 亿 | 6.36 | 6.39 | 6.40 | 6.30 |
| 22 | 000028 | 国药一致 | -2.53% | 38.05 | -0.78 | 6559.29 万 | 38.06 | 38.06 | 0.59% | 128.65 亿 | 118.58 亿 | 30.83 | 30.51 | 30.51 | 30.80 |
| 23 | 000029 | 深深房 A | -2.84% | 8.90 | -0.26 | 3462.85 万 | 8.90 | 8.92 | 0.43% | 90.84 亿 | 79.36 亿 | 9.16 | 9.16 | 9.20 | 8.89 |
| 24 | 000030 | 富奥股份 | 2.04% | 5.50 | 0.11 | 4544.84 万 | 5.49 | 5.50 | 0.47% | 99.50 亿 | 96.86 亿 | 5.39 | 5.43 | 5.56 | 5.37 |
| 25 | 000031 | 大悦城 | -5.17% | 4.92 | -0.23 | 1.04 亿 | 4.22 | 4.23 | 1.28% | 180.08 亿 | 79.79 亿 | 4.45 | 4.40 | 4.44 | 4.21 |
| 26 | 000032 | 深桑达 A | 0.36% | 16.01 | 0.06 | 1846.47 万 | 16.01 | 16.03 | 0.26% | 191.42 亿 | 69.16 亿 | 16.75 | 17.08 | 17.36 | 16.77 |
| 27 | 000034 | 神州数码 | 1.01% | 15.03 | 0.15 | 6062.52 万 | 15.03 | 15.05 | 0.75% | 99.24 亿 | 88.95 亿 | 14.88 | 15.19 | 15.27 | 14.91 |
| 28 | 000035 | 中国天楹 | -4.01% | 4.79 | -0.20 | 6433.87 万 | 4.79 | 4.80 | 0.54% | 128.09 亿 | 117.53 亿 | 4.89 | 4.96 | 4.97 | 4.78 |
| 29 | 000036 | 华联综超 | -1.06% | 3.95 | -0.08 | 2737.53 万 | 3.95 | 3.97 | 0.45% | 58.76 亿 | 58.59 亿 | 4.94 | 4.97 | 4.08 | 3.95 |
| 30 | 000037 | 深南电 A | 8.65% | 6.24 | 0.04 | 316.84 万 | 6.24 | 6.25 | 0.15% | 37.61 亿 | 21.15 亿 | 6.20 | 6.20 | 6.26 | 6.19 |
| 31 | 000038 | 深大通 | -0.11% | 8.70 | -0.01 | 310.39 万 | 8.70 | 8.71 | 0.15% | 45.46 亿 | 28.72 亿 | 8.71 | 8.74 | 8.76 | 8.63 |
| 32 | 000039 | 中集集团 | 8.08% | 13.26 | 0.01 | 4757.14 万 | 13.25 | 13.26 | 0.23% | 476.70 亿 | 203.44 亿 | 13.25 | 13.25 | 13.31 | 13.22 |
| 33 | 000040 | 东旭蓝天 | -0.31% | 3.18 | -0.01 | 1489.08 万 | 3.18 | 3.19 | 0.44% | 47.20 亿 | 33.72 亿 | 3.19 | 3.20 | 3.22 | 3.17 |
| 34 | 000042 | 中南控股 | -3.80% | 8.36 | -0.33 | 1398.30 万 | 8.35 | 8.37 | 0.25% | 55.50 亿 | 55.51 亿 | 8.69 | 8.70 | 8.70 | 8.35 |
| 35 | 000045 | 深纺织 A | 1.38% | 7.34 | 0.10 | 486.64 万 | 7.33 | 7.34 | 0.15% | 37.18 亿 | 33.55 亿 | 7.24 | 7.22 | 7.37 | 7.18 |
| 36 | 000046 | 泛海控股 | -8.11% | 1.70 | -0.15 | 2.15 亿 | 1.78 | 1.71 | 2.39% | 88.34 亿 | 88.38 亿 | 1.85 | 1.75 | 1.77 | 1.70 |
| 37 | 000048 | 京基智农 | 0.28% | 25.39 | 0.07 | 4512.76 万 | 25.37 | 25.40 | 0.34% | 132.85 亿 | 132.85 亿 | 25.32 | 25.13 | 25.70 | 25.81 |
| 38 | 000049 | 德赛电池 | -0.46% | 34.33 | -0.16 | 5627.61 万 | 34.34 | 34.35 | 0.55% | 103.09 亿 | 102.48 亿 | 34.49 | 34.40 | 34.65 | 34.20 |
| 39 | 000050 | 深天马 A | 0.20% | 10.15 | 0.02 | 2742.91 万 | 10.15 | 10.16 | 0.11% | 249.46 亿 | 241.14 亿 | 10.13 | 10.13 | 10.20 | 10.12 |
| 40 | 000055 | 方大集团 | -0.68% | 4.35 | -0.03 | 971.71 万 | 4.35 | 4.36 | 0.33% | 46.71 亿 | 29.47 亿 | 4.38 | 4.38 | 4.42 | 4.34 |
| 41 | 000056 | 皇庭国际 | 4.99% | 8.63 | 0.41 | 1.03 亿 | 8.64 | 8.65 | 2.35% | 101.36 亿 | 77.99 亿 | 8.22 | 8.16 | ||
| 42 | 000058 | 深赛格 | -0.54% | 5.53 | -0.03 | 1171.91 万 | 5.52 | 5.53 | 0.39% | 68.09 亿 | 29.77 亿 | 5.56 | 5.55 |
行情板块
模型:模型中指标包括搜索框、技术指标、组合模型、我的策略和系统策略,指标建模支持 VBA 和 Python 两种语言。
技术指标包括:PYTHON 模型指标、摆动指标、财务指标、常用模板、超买超卖指标、成交量指标、反趋向指标、基差指标、量价指标、能量指标、强弱指标、趋向指标、压力支撑指标、特色指标、因子函数、择时策略示范等;
组合模型包括:模板(系统预置的多个组合模型的示例);
我的策略包括:常用策略以及系统预置的回测示例(如:交易实时主推示例、机器学习回测示例、指数增强回测示例等);
系统策略包括:网格策略、尾盘闲置资金自动逆回购、期权网络、期货网格。
板块:板块用于行情报价,包括我的、沪深板块,沪市板块,深市板块,京市板块、期货板块,期权板块,指数板块,自定义指数板块,持仓板块,全球市场、扩展数据、WIND 数据库、过期合约。
扩展数据:包括搜索框、扩展数据、多因子库、宏观经济指标、外部数据。
| 股票交易 | 期货交易 | 融资融券 | 组合交易 | 股票期权 | 沪港通 | 深港通 | ETF 申赎 | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 序号 | 代码 | 名称 | 涨幅 | 最新 | 涨跌 | 总额 | 委买价 | 委卖价 | 换手率 | 总市值 | 流通市值 | 昨收 | 今开 | 最高 | 最低 | ||||||
| 1 | 000001 | 平安银行 | 0.63% | 15.91 | 0.10 | 5.15 亿 | 15.90 | 15.91 | 0.17% | 3087.46 亿 | 3087.42 亿 | 15.81 | 15.81 | 16.00 | 15.70 | ||||||
| 2 | 000002 | 万科 A | -4.21% | 19.79 | -0.87 | 14.11 亿 | 19.78 | 19.79 | 0.73% | 2308.66 亿 | 1923.10 亿 | 20.66 | 20.43 | 20.56 | 19.76 | ||||||
| 3 | 000004 | 国华网安 | 0.17% | 17.32 | 0.83 | 1890.02 万 | 17.32 | 17.33 | 0.93% | 27.02 亿 | 20.15 亿 | 17.29 | 17.68 | 17.74 | 17.22 | ||||||
| 4 | 000005 | ST 星源 | 1.80% | 2.26 | 0.84 | 1642.58 万 | 2.26 | 2.27 | 0.69% | 23.92 亿 | 23.91 亿 | 2.22 | 2.21 | 2.28 | 2.21 | ||||||
| 5 | 000006 | 深桑业 A | -2.86% | 4.76 | -0.14 | 7793.97 万 | 4.76 | 4.77 | 1.19% | 64.26 亿 | 64.26 亿 | 4.90 | 4.88 | 4.96 | 4.74 | ||||||
| 6 | 000007 | *ST 全新 | 3.88% | 6.96 | 0.26 | 4380.82 万 | 6.96 | 6.97 | 2.04% | 24.11 亿 | 21.58 亿 | 6.70 | 7.00 | 7.04 | 6.67 | ||||||
| 7 | 000008 | 神州高铁 | 0.83% | 2.43 | 0.82 | 2155.19 万 | 2.42 | 2.43 | 0.33% | 67.57 亿 | 65.46 亿 | 2.41 | 2.41 | 2.43 | 2.41 | ||||||
| 8 | 000009 | 中国宝安 | -1.85% | 10.10 | -0.19 | 2.14 亿 | 10.09 | 10.10 | 0.82% | 260.50 亿 | 257.69 亿 | 10.29 | 10.33 | 10.33 | 10.06 | ||||||
| 9 | 000010 | 美丽生态 | 0.00% | 3.33 | 0.80 | 1682.68 万 | 3.33 | 3.34 | 0.91% | 27.30 亿 | 17.39 亿 | 3.33 | 3.32 | 3.40 | 3.32 | ||||||
| 10 | 000011 | 深物业 A | -3.30% | 12.22 | -0.40 | 1.08 亿 | 12.21 | 12.23 | 1.67% | 72.83 亿 | 64.34 亿 | 12.64 | 12.55 | 12.73 | 12.87 | ||||||
| 11 | 000012 | 南玻 A | -1.83% | 6.71 | -0.07 | 4736.22 万 | 6.71 | 6.72 | 0.36% | 206.04 亿 | 131.31 亿 | 6.78 | 6.79 | 6.83 | 6.71 |
交易板块
交易类型菜单栏:分为股票交易、期货交易、融资融券、组合交易、深港通、沪港通和 ETF 申赎等,可以方便、快捷切换到各种模块进行交易。
快捷工具栏:该区域展示各种快捷按钮,有操作和设置按钮,操作中包含数据管理、布局、查看(根据当前界面的交易类型,显示不同的选项)、复制、置顶、锁定布局、锁定终端、画图工具、星空图、龙虎榜等,设置中可进行系统各项设置。
交易功能导航栏:在交易界面快捷导航到各个所需要的界面,鼠标左键单击即跳转,根据交易类型不同,交易功能导航栏的功能也不同。包括买入、卖出、撤销任务、撤单;程序交易中的函数交易、便捷交易;查询资金账号、当日委托、当日成交、当日持仓、资金流水和历史数据查询;以及账号分组,银证转账和划拨功能等。
交易面板:交易面板包括下单面板,任务列表。
查询面板:查询面板包括资金账号,当日委托,当日成交,当日持仓,资金流水。
其他面板:包括自选股,股票列表,消息提示,行情图形。
状态栏:该栏包括执行中委托,执行中任务,消息提示,执行中策略,上证指数(深证成指,创业板指,沪深 300,科创 50 等主要指数轮动),极简交易,交易所公告,字体扩大,客服,便捷交易、批量埋单、CSV 预埋,账号登录状态,行情源,网络延时等功能的快捷键。
我的面板作为一个集合视图,主要为用户提供便捷的模型研究、模型交易入口,同时,也能让用户更方便的查看大盘指数、自选股和账号等多种信息。
主页界面为用户展示大盘指数、自选股、热门板块、策略列表、快速交易、账户信息以及运行中的模型交易等信息。

主页界面
大盘指数:展示大盘指数的价格走势,便于用户了解整个股票市场的行情。自选股:展示用户自己的自选股。双击可切换到行情板块个股分时图。策略列表:列举用户自定义的模型策略指标,可编辑,回测和查看历史操作。
快速交易:点击图标后可快速跳转到对应功能,快速交易面板中的功能项和顺序可在管理端进行设置。
用户信息:展示用户名及该用户的 level2 权益。
账户信息:展示用户的账户信息,包括资产、市值、盈亏等,多账号情况下可在下拉菜单中选择不同的资金账号进行展示。
运行中交易:列举用户添加的模型交易以及相应的运行模式和状态。

上图——模型研究页面
用户在使用模型功能前,需先下载模型运行所需的 python 库。点击下载 python 库后,弹出模型设置界面,可选择 python 库的路径,并展示相关的下载信息。在此页面中再次点击“python 库下载”即可。

在「主页界面」或者「模型研究」界面,用户可创建自己的模型,模型创建方法有两种:
方法一,使用系统预置的各种示例模型,点击后方“编辑”按钮,并在弹出的「模型编辑器」中以此示例模型代码为基础进行编写。

我的主页—编辑模型
方法二,点击“新建模型”按钮并选择模型语言类型,在弹出「模型编辑器」中从头开始实现一个用户自己的量化模型。

我的主页—新建模型
在新建模型时有三个选项,分别为:
VBA 单股模型:适用于单个标的的择时和买卖信号的触发、以及各种技术指标的开发。
VBA 组合模型:分为母模型和子模型两部分,其中子模型与单股模型使用同一编辑窗口,主要负责向母模型传递买卖信号和各种择时参数。母模型主要承担股票篮子管理与综合收益计算等功能。
Python 模型:适合开发各种单股、组合策略。
本系统支持 VBA 和 Python 两种语言进行模型开发,VBA 模型框架兼容市面上常用交易终端的指标语言,内部封装了大量功能强大、简洁易用的函数,供用户快速开发使用,而且通过迅投独家模型解析转换和多线程加速技术,运行和回测效率远超同类平台。Python 模型框架则更为灵活,在授权允许的情况下,支持导入各种第三方包,且兼容主流社区型量化平台的回测框架,用户可无缝切换至迅投 QMT 系统。
创建模型时,会弹出「模型编辑器」窗口,「模型编辑器」是迅投专门为模型开发者设计的、集成了模型列表、函数列表、函数帮助、模型基本信息、参数设置、回测参数等多个部分,拥有代码高亮、自动补全等特色功能的便捷的模型编辑、开发环境。详细的模型编辑教程见知识库或帮助手册。

模型编辑器—函数帮助

模型编辑器—代码补全

模型编辑器—选中相同代码高亮
目前我们的策略模型编写中支持交易所市价报价方式,针对不同的交易类型
以及交易所规则,支持各类报价方式:

各类交易所市价报价方式
在创建完模型之后,应对模型的基本信息和回测参数进行设置,基本信息包括:
启用本地 python:勾选后此项后,在模型编辑器中点击运行,或在策略交易中运行该策略,默认使用用户本地的 python 环境运行。
名称:填写模型名称;
快捷码:默认根据模型名称自动生成拼音首字母拼写,如需自定义可以手动进行更改,用于键盘精灵快速引用模型;
说明:简单的说明模型功能;
分类:保存当前模型到某个分类下面;
位置:模型回测或运行时的位置,有副图、主图叠加、主图三种显示位置;
默认周期:点击模型回测或运行时的默认主图周期,可手动切换;
默认品种:点击模型回测或运行时的默认主图品种,可手动切换;
复权方式:提供不复权、前复权、后复权、等比前复权、等比后复权 5 种复权方式;
快速计算:限制计算范围,默认为 0 时模型运行时会从模型设置的默认品种(主图)的第一根 k 线开始计算,设置为 n 则从当前 k 线再往前 n 个 k 线开始计算;
刷新间隔:用来设置策略运行的时间间隔。设置了刷新间隔,即每隔一段时间策略按照当前行情运行一次;
加密公式:加密后的公式只有输入密码才可以查看源代码;
凭密码导出公式:此项只有在开启“加密公式”后才能生效,生效后只能使用密码导出到本地。
用法注释:简短的说明模型使用的一些注意项。

模型编辑器—基本信息设置
参数设置中参数名为变量名,模型中可以调用。最新值为变量默认值,运行
/回测模式使用。
最小/最大/步长项,为遍历参数。初始项可不填。最小/最大都是包含在遍历区间内的,如图所示,a,b 两变量,5-15,步长为 1,会遍历 11 * 11 种组合。

模型编辑器—参数设置
点击公式测评,可选择回测模式支持的指标,如单位净值,最大回撤等,作为评价标准。点击优化,评测结果弹窗显示不同参数变量组合下的回测结果。可点击所需指标进行排序。
测评完成后,用户可根据测评结果,选取最优的值赋给对应的参数。
模型的基本信息和回测参数设置完毕后,点击编译,可以查看模型编译情况,如果编译失败,请检查模型代码是否有误,并进行修正后再次编译,如果编译成功,则终端会自动保存模型的相关代码及设置到本地。
回测参数包括:开始时间、结束时间:设置模型回测时间区间;
基准:设置模型收益的参考基准;
初始资金:设置模型回测的初始资金,回测时系统使用一个虚拟账号进行交易操作,在此处为该虚拟账号设置资金量。代码中可使用 ContextInfo.capital
进行设置;
保证金比例:设置期货的保证金比例;
滑点:设置回测撮合时的滑点,模拟真实交易的冲击成本,在代码里通过使用 ContextInfo.set_slippage 函数来设定;
手续费类型:支持按成交额比例或者固定值计算手续费,代码里通过 set_co mmission 函数来设定;
买入印花税:设置买入印花税比例,代码里同样通过 set_commission 函数来设定;
卖出印花税:设置卖出印花税比例,代码里同样通过 set_commission 函数来设定;
最低佣金:设置单笔交易的最低佣金数额,代码里同样通过 set_commission 函数来设定;
买入佣金:设置买入标的时的佣金比例,代码里同样通过 set_commission 函数来设定;
平昨佣金:设置股票、期货平昨佣金比例,代码里同样通过 set_commission 函数来设定;
平今佣金:设置期货平今佣金比例,代码里同样通过 set_commission 函数来设定;
最大成交比例:控制回测中最大成交量不超过同周期(行情周期)成交量*最大成交比例,例如运行周期为 1 分钟线,最大成交量比例设置为 10%,则回测时,最大成交量比例不超过 1 分钟成交量*最大成交比例 10%,最大成交比例设置为 0,则不限制成交比例;
以上回测参数的设置,在回测参数界面设置后,代码里无需再赋值。相反地,如果代码里面设置了,那么以代码里设置的值为准。
总结:代码里的设置优先级高于回测参数界面设置。

模型编辑器—回测参数设置
模型的基本信息和回测参数设置完毕后,点击编译,可以查看模型编译情况,如果编译失败,请检查模型代码是否有误,并进行修正后再次编译,如果编译成功,则系统会自动保存模型的相关代码及设置到本地。

模型编辑器—模型编译
在回测之前,可手动在操作 - 数据管理中补充数据,以方便回测运行。也可直接回测,系统会自动补全相应品种指定运行周期的所有历史数据。
对某一策略编译成功后,点击回测,可以通过日志输出查看模型回测情况,主界面会跳转到模型设置的默认标的和默认周期界面,并输出模型绩效分析结果。

模型编辑器—模型回测
如回测所需时间较长,不想再继续进行下去,可直接点击“策略停止”按钮,停止回测。
按钮下方显示回测进度条,进度条上方数字表示当前回测已运行的时长,进度条内数字表示当前已计算的 K 线数量。

模型编辑器—进度查看
随着光标在 K 线主图上的移动,右边回测结果展示窗口会动态显示截止光标所在当日的绩效分析结果(包括年化收益,基准年化收益,单位净值,下方差,信息比率,夏普比率,波动率,索提诺比率,阿尔法系数,贝塔系数,跟踪误差,最大回撤,胜率等)、买卖操作和持仓分析等。

回测结果分析—回测结果随十字光标移动动态展示
如需根据模型生成的买入、卖出列表进行手工交易,则可直接点击“买入”
或“卖出”按钮,系统会弹出下单界面由用户进行确认后进行普通交易下单或算法交易下单。交易方式可点击卖出按钮右侧的普通交易进行切换设置。

回测结果买入
同时,也可以直接在回测界面将该策略添加到实盘交易,转到实盘交易后策略默认为运行状态。

转到实盘交易

转到实盘交易
副图回测指标:提供图形化的展示,除去绩效分析的相关指标外,用户可以通过编辑模型代码自定义输出一些特色指标,鼠标右键可以选择复制模型运行结果(每一天的数据)保存到个人文档中。

回测结果分析—附图指标输出
另外,回测结果还提供了持仓分析、历史板块汇总、操作明细、日志输出等信息,方便用户进行深入分析。
持仓明细:可查看光标所在当天的持仓明细,鼠标右键可以复制和导出数据。
持仓分析:可查看光标所在当天持仓的行业分布,展示在相关行业的市值情况、盈利情况、权重以及股票数量情况,鼠标右键可以复制和导出数据;可切换对比基准,和模型持仓进行对比。
历史汇总:可查看模型自回测日期以来到光标所在日期该模型交易标的的汇总信息,包括累计盈亏、累计交易量、累计交易额、持仓天数等;点击选择板块,可以自定义添加指定板块,并对持仓在该板块的收益情况进行分析;汇总数据均可以进行排序,鼠标右键可以复制和导出数据。
操作明细:可查看模型回测的历史每一笔交易的明细。
日志输出:可用于调试输出模型回测和运行情况。

回测结果分析—绩效分析、当日买入、当日卖出、持仓分析

回测结果分析—历史板块汇总、操作明细、日志输出
对某一策略编译成功后,点击运行,该策略即进入模拟运行的状态,模拟运行状态不进行任何实盘交易操作。
如当前系统所处界面中有行情主图,点击运行之前,需在行情中手动设置好 K 线品种和周期,点击运行后,策略即可在当前主图下运行,如下图所示。

策略运行状态之一
如系统当前界面处于“我的”界面或“模型研究”和“模型交易”等非行情界面,点击运行时,会基于策略编辑器 - 基本信息中所设置的默认周期和默认品种运行。

策略运行状态之二
当选择的运行位置为副图时,置副图○主图叠加主图 如想关闭策略,将主图下方策略运行的附图关闭即可。

关闭运行中的策略之一

关闭运行中的策略之二
当选择的运行位置为主图叠加时,如想关闭策略,在主图上右键单击取消叠加指标即可。
当选择的运行位置为主图时,键盘精灵输入 kLINE 即可替换当前主图上的运行结果为 K 线图。
在模型列表点击查看,可查看该策略的历史运行和回测记录。

操作记录 - 查看操作记录
点击某条记录后的查询按钮,可查看当时运行或回测时使用的策略代码。

操作记录 - 查看策略代码
点击某条记录后的删除按钮,可在表中删除该条记录。
点击客户端顶部“模型交易”按钮,进入「模型交易」界面,可以看到已添加的模型的运行情况。
在模型交易中,可运行增强策略,python 策略和 vba 策略。

模型交易—模型交易列表
创建模型交易的方法有两种:
方法一:在模型交易界面,点击新建模拟交易,选择相应模型、运行标的及运行周期,此方法创建的模型交易默认状态为“停止”状态,运行模式为“模拟”。
此时新建策略交易,会要求填写资金账号。若策略中交易函数已设置了资金账号参数,则以策略中设置的为准;如策略中交易函数未设置资金账号参数,则以新建模型交易界面为准。

模型交易—新建模型交易
方法二:在回测分析界面副图右上角点击实盘交易按钮,该模型会直接添加至模型交易界面,此方法创建的模型交易默认状态为“运行中”,运行模式为“实盘”。

模型交易—添加回测模型到实盘交易
点击“运行模式栏”的“实盘”或“模拟”可以直接切换运行模式,“实盘”和“模拟”模式一样都会在模型交易信号显示区显示交易信号,区别仅仅在于“实盘”模式还会向柜台发送实盘交易信号,而“模拟”模式不会。

实盘交易 - 下单信号
在下达任务对话框中还可输入投资备注,用于区分函数交易所产生的不同任务。随后可在任务列表、委托和成交中查看投资备注。

输入投资备注

任务中显示投资备注

委托中显示投资备注

成交中显示投资备注
如需图形化地观察某个模型交易的信号输出情况,可双击运行中的策略,右侧行情页面会跳转到相应运行标的,副图会显示模型的具体运行情况;左下方的按钮可以查看模型的策略信号、策略日志、策略统计、持仓、委托、成交。

模型交易—状态显示
功能扩展模块策略的运行,需要客户将自己的模块文件放到 QMT 客户端 cus tomDll 文件夹下,同时需要在管理端【风控管理】增强交易白名单中添加该模块。添加白名单时需要输入 md5 值实现模块运行时对文件的校验。

管理端 - 添加功能扩展模块白名单
添加到白名单的功能扩展模块,才能出现在 QMT 交易端模型交易中。此时若客户已经放置模块文件到 QMT 客户端 customDll 目录下,启动 QMT 客户端后,便可以开始运行增加的模块。
行情模块包括管理面板,行情报价界面,个股分析界面,个股分时界面。所有界面支持复制界面的特色功能。将鼠标移动到界面的顶端,便可出现 4 个蓝色小标志,从左往右,功能依次选择关联分组、弹出页面、复制页面和关闭窗口。
| 序号 | 代码 | 名称 | 涨幅 | 今开 | 最新 | 最高 | 最低 | 总 指数 | 序号 | 代码 | 名称 | 涨幅 | 今开 | 最新 | 最高 | 最低 | 总 指数 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 000001 | 平安银行 | 1.30% | 10.80 | 11.02 | 11.10 | 10.73 | 11.01 | 1 | 000001 | 平安银行 | 1.30% | 10.80 | 11.02 | 11.70 | 10.73 | 11.01 |
| 2 | 000002 | 万科 A | -3.60% | 32.70 | 31.62 | 32.76 | 30.95 | 15.1 | 2 | 000002 | 万科 A | -3.60% | 32.70 | 31.62 | 32.76 | 30.95 | 15.1 |
| 3 | 000004 | 国农科技 | -0.40% | 22.01 | 27.58 | 22.60 | 22.80 | 634.5 | 3 | 000004 | 国农科技 | -0.40% | 22.01 | 22.58 | 22.50 | 22.00 | 634.5 |
| 4 | 000005 | 世纪星源 | 0.00% | 3.74 | 3.76 | 3.81 | 3.05 | 254.7 | 4 | 000005 | 世纪星源 | 0.00% | 3.74 | 3.76 | 3.81 | 3.65 | 254.7 |
| 5 | 000006 | 深振业 A | 0.56% | 7.14 | 7.19 | 7.25 | 7.00 | 1.15 | 5 | 000006 | 深振业 A | 0.56% | 7.14 | 7.19 | 7.25 | 7.00 | 1.15 |
| 6 | 000007 | 全新好 | -2.17% | 14.25 | 13.95 | 14.26 | 13.88 | 338.5 | 6 | 000007 | 全新好 | -2.17% | 14.25 | 13.95 | 14.26 | 13.88 | 338.5 |
| 7 | 000008 | 神州高铁 | -1.04% | 6.71 | 6.64 | 6.73 | 6.68 | 425.5 | 7 | 000008 | 神州高铁 | -1.04% | 6.71 | 6.64 | 6.73 | 6.60 | 425.5 |
| 8 | 000009 | 中国宝安 | 1.44% | 6.26 | 6.35 | 6.35 | 6.17 | 1.85 | 8 | 000009 | 中国宝安 | 1.44% | 6.26 | 6.35 | 6.35 | 6.17 | 1.85 |
| 9 | 000010 | 美丽生态 | -0.46% | 4.32 | 4.31 | 4.33 | 4.23 | 164.3 | 9 | 000010 | 美丽生态 | -0.46% | 4.32 | 4.31 | 4.33 | 4.23 | 164.3 |
| 10 | 000011 | 深物业 A | 0.13% | 15.23 | 15.31 | 15.59 | 14.92 | 593.1 | 10 | 000011 | 深物业 A | 0.13% | 15.23 | 15.31 | 15.59 | 14.92 | 593.1 |
| 11 | 000012 | 南玻 A | -1.60% | 7.50 | 7.39 | 7.50 | 7.31 | 768.8 | 11 | 000012 | 南玻 A | -1.60% | 7.50 | 7.39 | 7.50 | 7.31 | 768.8 |
| 12 | 000014 | 沙河股份 | 1.86% | 11.60 | 12.02 | 12.37 | 11.51 | 1.05 | 12 | 000014 | 沙河股份 | 1.86% | 11.60 | 12.02 | 12.37 | 11.51 | 1.05 |
| 13 | 000016 | 深康佳 A | -2.47% | 7.00 | 6.93 | 7.08 | 6.83 | 1.68 | 13 | 000016 | 深康佳 A | -2.67% | 7.00 | 6.93 | 7.00 | 6.83 | 1.68 |
| 14 | 000017 | 深中华 A | -1.25% | 5.93 | 5.54 | 5.61 | 5.43 | 122.0 | 14 | 000017 | 深中华 A | -1.25% | 5.53 | 5.54 | 5.61 | 5.43 | 122.0 |
| 15 | 000018 | 神州长城 | -0.16% | 6.10 | 6.17 | 6.15 | 6.06 | 537.2 | 15 | 000018 | 神州长城 | -0.16% | 6.10 | 6.11 | 6.15 | 6.06 | 537.2 |
| 16 | 000019 | 深深宝 A | -3.65% | 14.50 | 12.88 | 14.50 | 12.70 | 5.59 | 16 | 000019 | 深深宝 A | -3.65% | 14.50 | 12.88 | 14.50 | 12.70 | 5.59 |
| 17 | 000020 | 深华发 A | -1.35% | 14.70 | 14.62 | 15.22 | 14.82 | 754.6 | 17 | 000020 | 深深华发 A | -1.35% | 14.70 | 14.62 | 15.22 | 14.02 | 754.6 |
| 18 | 000021 | 深科技 | -0.47% | 8.39 | 8.44 | 8.52 | 8.20 | 1.25 | 18 | 000021 | 深科技 | -9.47% | 8.39 | 8.44 | 8.52 | 8.20 | 1.25 |
| 19 | 000022 | 深赤湾 A | - | - | - | - | - | - | 19 | 000022 | 深深房 A | - | - | - | - | - | - |
| 20 | 000023 | 深天地 A | 2.48% | 17.01 | 17.78 | 18.45 | 17.00 | 391.4 | 20 | 000023 | 深天地 A | 2.48% | 17.01 | 17.78 | 18.45 | 17.00 | 391.4 |
| 21 | 000025 | 特力 A | 0.90% | 36.74 | 37.08 | 37.62 | 35.30 | 1.45 | 21 | 000025 | 特力 A | 0.90% | 36.74 | 37.08 | 37.62 | 35.30 | 1.45 |
| 22 | 000026 | 飞亚达 A | -1.47% | 10.74 | 10.75 | 10.85 | 10.60 | 235.9 | 22 | 000026 | 飞亚达 A | -1.47% | 10.74 | 10.75 | 10.85 | 10.60 | 235.9 |
| 23 | 000027 | 深圳能源 | 2.60% | 5.85 | 5.93 | 5.95 | 5.85 | 693.9 | 23 | 000027 | 深圳能源 | 2.60% | 5.85 | 5.93 | 5.95 | 5.85 | 693.9 |
| 24 | 000028 | 国药一致 | 2.11% | 59.76 | 61.60 | 62.20 | 59.76 | 1.46 | 24 | 000028 | 国药一致 | 2.11% | 59.76 | 61.60 | 62.20 | 59.76 | 1.46 |
| 25 | 000029 | 深深房 A | - | - | - | - | - | - | 25 | 000029 | 深深房 A | - | - | - | - | - | - |
| 26 | 000030 | 富奥股份 | 0.00% | 7.00 | 7.02 | 7.09 | 6.93 | 182.6 | 26 | 000030 | 富奥股份 | 0.00% | 7.00 | 7.02 | 7.09 | 6.93 | 182.6 |
| 27 | 000031 | 中粮地产 | - | - | - | - | - | - | 27 | 000031 | 中粮地产 | - | - | - | - | - | - |
| 28 | 000032 | 深桑达 A | 1.50% | 9.25 | 9.47 | 9.50 | 8.87 | 354.0 | 28 | 000032 | 深桑达 A | 1.50% | 9.25 | 9.47 | 9.50 | 8.87 | 354.0 |
| 29 | 000034 | 神州数码 | - | - | - | - | - | - | 29 | 000034 | 神州数码 | - | - | - | - | - | - |
| 30 | 000035 | 中直天成 | - | - | - | - | - | - | 30 | 000035 | 中直天成 | - | - | - | - | - | - |
| 31 | 000036 | 华联控股 | 1.46% | 8.22 | 8.36 | 8.42 | 8.17 | 688.2 | 31 | 000036 | 华联控股 | 1.46% | 8.22 | 8.36 | 8.42 | 8.17 | 688.2 |
| 32 | 000037 | 深南电 A | -1.46% | 6.80 | 6.74 | 6.83 | 6.58 | 1556.1 | 32 | 000037 | 深南电 A | -1.46% | 6.80 | 6.74 | 6.83 | 6.58 | 1556.1 |
| 33 | 000038 | 深大通 | - | - | - | - | - | - | 33 | 000038 | 深大通 | - | - | - | - | - | - |
| 34 | 000039 | 中集集团 | 0.87% | 16.11 | 16.28 | 16.35 | 15.93 | 1.45 | 34 | 000039 | 中集集团 | 0.87% | 16.11 | 16.28 | 16.35 | 15.93 | 1.45 |
| 35 | 000040 | 东旭蓝天 | -2.86% | 11.55 | 11.41 | 11.60 | 11.00 | 5047.1 | 35 | 000040 | 东旭蓝天 | -2.86% | 11.55 | 11.41 | 11.60 | 11.00 | 5047.1 |
| 36 | 000042 | 中鼎控股 | 0.62% | 14.50 | 14.62 | 14.79 | 14.37 | 709.5 | 36 | 000042 | 中鼎控股 | 0.62% | 14.50 | 14.62 | 14.79 | 14.37 | 709.5 |
| 37 | 000043 | 中航地产 | -0.11% | 9.02 | 9.09 | 9.10 | 9.00 | 1927.1 | 37 | 000043 | 中航地产 | -0.11% | 9.02 | 9.09 | 9.10 | 9.00 | 1927.1 |
| 38 | 000045 | 深纺织 A | -1.04% | 8.53 | 8.56 | 8.77 | 8.22 | 5370.1 | 38 | 000045 | 深纺织 A | -1.04% | 8.53 | 8.56 | 8.77 | 8.22 | 5370.1 |
| 39 | 000046 | 泛海控股 | - | - | - | - | - | - | 39 | 000046 | 泛海控股 | - | - | - | - | - | - |
| 40 | 000048 | 康达尔 | 1.15% | 24.18 | 24.55 | 24.55 | 24.67 | 975.5 | 40 | 000048 | 康达尔 | 1.15% | 24.18 | 24.55 | 24.55 | 24.07 | 975.5 |
| 41 | 000049 | 德赛电池 | -1.30% | 32.80 | 32.59 | 32.83 | 32.89 | 8236.1 | 41 | 000049 | 德赛电池 | -1.30% | 32.89 | 32.59 | 32.83 | 32.09 | 8236.1 |
| 42 | 000050 | 深天马 A | -1.21% | 15.85 | 15.55 | 15.89 | 15.37 | 1.96 | 42 | 000050 | 深天马 A | -1.21% | 15.85 | 15.55 | 15.89 | 15.37 | 1.96 |
复制多个行情界面

不同界面无关联,可选择不同状态
行情模块中的所有界面支持键盘精灵。当焦点在行情界面时,键盘精灵支持输入数字和拼音。

键盘精灵
管理面板中包括模型、板块和扩展数据三部分。模型用于个股分析界面和个股分时界面;板块用于行情报价界面,鼠标左键单击板块选项可实现在行情报价界面中切换板块;扩展数据用于添加或导入扩展数据。
板块用于行情报价界面,包括搜索框、我的、沪深板块、沪市板块、深市板块、京市板块、期货板块、期权板块、指数板块、自定义指数版块、持仓板块、全球市场、扩展数据、WIND 数据库、过期合约。
搜索框:快速搜索所需要的板块。
我的:我的自选
沪深板块:沪深 A 股、沪深 B 股、沪深指数、沪深基金、沪深 ETF、沪深债券、沪深 CRD、沪深转债、沪深回购、沪深 REITS、沪深风险警示、沪深退市整理。
沪市板块:上证 A 股、上证 B 股、沪市指数、沪市基金、沪市 ETF、沪市债券、上证 CRD、科创板、上证 GDR、上证转债、上证回购、上证 REITS、沪市风险警示、沪市退市整理。
深市板块:深证 A 股、深证 B 股、深市指数、深市基金、深市 ETF、深证主板、创业板、深市债券、深市转债、深市回购、深圳 REITS、深市风险警示、深市退市整理。
京市版块:京市 A 股。
期货板块:连续合约、中金所、上期所、大商所、郑商所、能源中心、套利合约、夜市。
期权板块:上证期权、深证期权、T 型报价版。
指数板块:D 概念、T 概念、T 行业、指数成分股板块、申万一级行业板块、申万一级行业板块(港股)、申万二级行业板块、申万三级级行业板块、证监会行业板块、证监会二级行业板块、星空图指数。
自定义指数版块:自定义指数、自定义指数成分。
持仓板块:股票持仓、期货持仓、融资融券持仓、股票期权持仓、沪港通持仓、深港通持仓。
全球市场:沪港通、深港通、香港联交所股票、香港联交所指数。
扩展数据:外部数据
过期合约:过期沪深板块、过期沪市板块、过期深市板块、过期期货板块、过期期权板块。
WIND 数据库:

一级板块右键菜单
如图,选中一级板块后右键,出现导入板块文件选项。可导入板块文件。支持如下几种格式,推荐使用第一种格式。

板块导入

自选板块右键菜单
如图,选中自选板块中的一级板块后右键,出现导入板块文件,新建分类,导出板块文件,新建板块等。

自选板块二级板块右键菜单
如图,选中自选板块中的二级板块后右键,出现导入自选股,删除板块,重命名板块等选项。
模型包括指标搜索框、技术指标、组合模型、我的策略和系统策略,支持 V BA 和 Python 两种语言。
默认技术指标包括:能量指标、摆动指标、成交量指标、趋向指标、量价指标、基差指标、强弱指标、反趋向指标、超买超卖指标、压力支撑指标、择时策略示范、PYTHON 模型指标、常用模板、财务指标、因子函数、特色指标等。因子函数包括:成长因子、估值因子、价量因子、价值因子、债务因子、BARRA 因子、特色指标(技术分析、Level2 专用)。
组合模型包括:多因子组合模型、不使用扩展数据的组合模型、择时选股模型母模型、组合模型示范 A。
我的策略包括系统内置策略模板,如单股模型示范、多因子选股模型、行业轮动策略、机器学习等。同时用户也可右键选择“导入公式”,导入本地策略,系统默认策略格式为*.rzrk。
系统策略包括网格策略、尾盘闲置资金自动逆回购、期权网格、期货网格、增强网格策略 V2。。

模型 - 导入公式
模型面板配合个股分析界面和分时界面使用,鼠标左键双击指标或策略选项可实现在分析界面或分时界面切换主图指标、增加附图指标或模拟运行相应策略。
指标搜索框:输入指标名称即可快速搜索所需要的指标。

一级指标右键菜单
选择一级指标后,右键出现新建分类,批量编译模型,导出工作组,导入公式,新建模型的选择菜单。

二级指标右键菜单
选择二级指标后,右键出现新建分类,批量编译模型,删除分类,重命名分类,导入公式,导出工作组,新建模型的选择菜单。

三级指标右键菜单
选择三级指标后,右键出现编辑模型,编译模型,新建模型,删除模型,导入公式,导出公式的选择菜单。
新建及编辑模型:VBA 模型

迅投 VBA 模型编辑器

迅投 Python 模型编辑器
新建模型可新建用户自己的技术指标。用户只需要通过描述一个数据是如何计算的,公式系统就能将所有数据计算出来,并以曲线的形式显示出来。
模型系统以时间序列为基础,其计算对象是一组沿时间递增的数据序列,每个时间周期包含一组数据,公式系统能对其中的任何数据进行操作。

VBA 模型编辑功能区介绍
通过该界面用户可以了解该系统的公式设定的内容和相关规则:
①每一个指标公式必须有一个名称,这个名称由中文、字母和数字组成,公式名称在同类公式中必须是唯一的;公式描述是一段文字,用来简单描述该公式的含义,在公式列表时显示这段文字,这段文字不宜过长;同时该界面也定义了该指标显示的位置,是在主图上与 K 线叠加还是显示在副图上,一般来讲,只有少数几个主图指标会设定为主图叠加,例如 MA 均线、BOLL 线等。
②参数:计算参数用来替代公式中所需要的常数,在使用时可以方便地调节参数,不必修改公式就可以对计算方法进行调节。参数包括参数名、最小值、最大值、缺省值、步长五个部分,参数名称用于标识参数,计算公式时采用缺省值计算,而最小值和最大值是参数的调整范围。
③其他:包括加密、快速计算、刷新间隔等内容。模型终端支持公式加密功能和凭密码导出公式功能,如果用户不想让别人看到您的公式内容,可以通过此功能对公式进行加密。
④用法注释:模型注释是一段文字,相对于模型描述而言它可以很长,主要
用来描述一个公式如何使用、注意事项、计算方法等等。

指标公式加密
加密:用户所编制的公式可以只是密码进行加密。当在个股分析界面和分时界面调用相关公式时,会提示用户输入密码。

用法注释
注释:迅投系统自带的指标都带有相应的用法注释。若是用户自定义的指标,用户可自己添加用法注释。
可在个股分析界面和分时界面通过右键菜单选择“编辑指标”,在“参数”中进行修改。

编辑指标
同时,也可以直接在指标界面右键选择”修改指标参数”来修改。如图所示:

修改指标参数
扩展数据用于添加、批量添加、刷新、编辑、显示、重命名、导入、导出、删除扩展数据,导入财务数据等。

扩展数据
当我们需要用公式对一些个股进行打分排序时,特别复杂的公式的计算值可以转化到扩展库保存起来,盘中若需要用到这种公式的计算值,直接去扩展数据库中取就行了,不用临时计算,这样就节约了每次运行时间。
在选择扩展数据中,您可以选择不同的计算周期,指标类型,时间区间,复权类型。此外,您也可以选择是否每天收盘更新和对于无效时序的处理方式。当您设置完成扩展数据之后,就可以在模型编辑器中使用扩展数据库了,引用方法为:
EXTDATA (‘NAME’,STOCK,TIME);
其中,NAME 为扩展数据名称,STOCK 表示品种,TIME 表示相对当前周期的偏移值,0 表示当前周期。
您可以将生成的扩展数据进行显示,或者再次编辑。此外,也可将扩展数据以 EPT 文件格式导出,或者将之前生成的扩展数据导入到模型终端以供使用。使用方式如下图。

扩展数据操作

添加扩展数据
如果需要查看已生成的扩展数据,需前往对应周期的 K 线界面,并通过移动十字线的位置,来查看不同周期扩展数据的数值。

显示扩展数据

行情报价界面功能区域划分
行情报价面板包括左侧的管理面板,行情报价主界面,和下方的行情分类标签栏。
使用 Esc 退出键从其他界面返回行情报价界面。
板块用于行情报价界面,包括沪深板块,沪市板块,深市板块,京市板块,期货板块,期权板块,指数板块,自选板块,自定义指数,持仓板块,WIND 数据库,过期合约,全球市场和扩展数据。
在板块上右键可从本地导入板块文件,支持如下几种格式,推荐使用第一种格式。

板块导入
行情分类标签栏中每一栏的字段右侧设置倒三角下拉键,点击可选择相应版块内的显示内容。默认显示上次选择的内容。

多股展示方式
第一栏为多股同列栏。点击可选择以“2*2”“3*3”“4*4”“4*2”这四种方式同时显示多股。

多股同列 2*2

多股同列 3*3

多股同列 4*4

多股同列 4*2
按键“F5”可切换为 k 线同列。

多股同列状态下 F5 切换

我的自选面板
用户可看到自选股信息,您也可以看到自己设定的板块股以及自定义板块的行情信息;用户可在行情报价界面右键将关心的股票添加到“我的自选股”。
报价主界面上方显示个股参数字段。参数包括:序号,代码,名称,涨幅,今开,最新,最高,最低,总额,总量,昨收,涨跌,持仓,委买价,委买量,委卖价,委卖量,买二价,买三价,买四价,买五价,买二量,买三量,买四量,买五量,卖二价,卖三价,卖四价,卖五价,卖二量,卖三量,卖四量,卖五量,权重,总市值,流通市值和换手率等。
显示字段支持自定义,通过右键 - 定制列功能实现。
点击任意显示字段,都可根据相应参数排序。可按升序或降序排列。

按涨幅降序排列
按住鼠标左键任意拖动字段名称可调整字段位置,界面下方和右方都有滚动
条。
按住 Ctrl 键可多选多只股票。鼠标右键可选择加入自选板块。
按住 Shift 键单击第一只和最后一只证券合约,可选择之间的全部证券。鼠标右键可选择加入自选板块。
| 序号 | 代码 | 排名名称 | 最新 | 涨幅 | 涨跌 | 总额 | 委买价 | 委卖价 | 换手率 | 总市值 | 流通市值 | 昨收 | 今开 | 最高 | 最低 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 300101 | 佐力药业 | 0.29 | -6.01% | -0.53 | 1.52 亿 | 0.29 | 0.30 | 3.53% | 50.45 亿 | 42.11 亿 | 8.82 | 0.84 | 0.91 | 0.26 |
| 2 | 300799 | 左江科技 | 41.69 | -4.63% | -2.05 | 3881.76 万 | 41.69 | 41.70 | 2.78% | 42.57 亿 | 13.60 亿 | 43.74 | 43.74 | 43.81 | 41.51 |
| 3 | 003030 | 祖名股份 | 23.07 | -2.66% | -0.63 | 2022.77 万 | 23.07 | 23.08 | 1.72% | 28.79 亿 | 11.61 亿 | 23.70 | 23.50 | 23.85 | 22.98 |
| 4 | 603602 | 纵横通信 | 11.34 | -7.05% | -0.86 | 7830.01 万 | 11.34 | 11.35 | 3.29% | 23.12 亿 | 23.12 亿 | 12.20 | 12.20 | 12.22 | 11.29 |
| 5 | 688070 | 纵横股份 | 23.18 | 1.09% | 0.25 | 530.52 万 | 23.18 | 23.19 | 0.61% | 20.30 亿 | 8.64 亿 | 22.93 | 22.93 | 23.89 | 22.52 |
| 6 | 002431 | 棕榈股份 | 2.96 | -4.82% | -0.15 | 1.02 亿 | 2.95 | 2.96 | 2.32% | 44.01 亿 | 43.17 亿 | 3.11 | 3.09 | 3.10 | 2.93 |
| 7 | 600770 | 综艺股份 | 6.97 | -6.19% | -0.46 | 1.82 亿 | 6.97 | 6.99 | 1.95% | 90.61 亿 | 90.61 亿 | 7.43 | 7.34 | 7.43 | 6.96 |
| 8 | 001696 | 宗申动力 | 5.90 | -2.96% | -0.18 | 3426.63 万 | 5.89 | 5.90 | 0.65% | 67.56 亿 | 51.87 亿 | 6.08 | 6.15 | 6.15 | 5.89 |
| 9 | 002118 | 紫鑫药业 | 2.87 | -5.28% | -0.16 | 1.09 亿 | 2.86 | 2.87 | 2.93% | 36.76 亿 | 36.76 亿 | 3.03 | 3.00 | 3.02 | 2.86 |
| 10 | 300280 | 紫天科技 | 24.58 | -4.80% | -1.24 | 4667.64 万 | 24.58 | 24.61 | 1.16% | 39.84 亿 | 39.44 亿 | 25.82 | 25.63 | 25.93 | 24.50 |
| 11 | 688086 | 紫晶存储 | 10.62 | -3.54% | -0.39 | 3160.31 万 | 10.62 | 10.63 | 2.21% | 20.22 亿 | 14.09 亿 | 11.01 | 11.01 | 11.13 | 10.43 |
| 12 | 601860 | 紫金银行 | 3.00 | -1.64% | -0.05 | 1.05 亿 | 3.00 | 3.01 | 1.08% | 109.83 亿 | 104.25 亿 | 3.05 | 3.05 | 3.06 | 2.99 |
| 13 | 601899 | 紫金矿业 | 11.01 | -3.76% | -0.43 | 21.06 亿 | 11.00 | 11.01 | 0.92% | 2890.86 亿 | 2256.46 亿 | 11.44 | 11.36 | 11.48 | 10.91 |
| 14 | 600210 | 紫江企业 | 4.99 | -5.48% | -0.29 | 1.69 亿 | 4.96 | 4.99 | 2.26% | 75.69 亿 | 75.69 亿 | 5.28 | 5.26 | 5.28 | 4.94 |
| 15 | 002049 | 紫光国微 | 169.00 | -3.46% | -6.05 | 11.56 亿 | 167.98 | 168.00 | 1.12% | 1019.52 亿 | 1019.52 亿 | 174.05 | 174.17 | 175.90 | 167.09 |
| 16 | 000938 | 紫光股份 | 16.00 | -3.45% | -0.60 | 2.79 亿 | 16.00 | 16.01 | 0.57% | 480.49 亿 | 480.49 亿 | 17.40 | 17.16 | 17.43 | 16.56 |
| 17 | 688196 | 卓越新能 | 55.93 | -3.93% | -2.29 | 4660.54 万 | 55.93 | 55.95 | 2.71% | 67.12 亿 | 16.78 亿 | 58.22 | 58.99 | 59.00 | 55.31 |
| 18 | 002369 | 卓翼科技 | 4.19 | -4.12% | -0.18 | 5449.04 万 | 4.18 | 4.19 | 2.22% | 24.17 亿 | 24.13 亿 | 4.37 | 4.42 | 4.43 | 4.14 |
| 19 | 688258 | 卓易信息 | 27.00 | -1.50% | -0.41 | 887.91 万 | 26.99 | 27.00 | 0.74% | 23.48 亿 | 11.73 亿 | 27.41 | 27.50 | 28.23 | 26.96 |
| 20 | 300782 | 单胜微 | 196.00 | -2.92% | -5.90 | 6.55 亿 | 196.16 | 196.00 | 1.63% | 653.84 亿 | 394.74 亿 | 201.90 | 200.99 | 204.79 | 195.00 |
| 21 | 688121 | 卓然股份 | 20.17 | -4.99% | -1.06 | 1796.01 万 | 20.13 | 20.17 | 2.01% | 40.88 亿 | 8.75 亿 | 21.23 | 21.29 | 21.29 | 20.00 |
| 22 | 600545 | 卓朗智能 | 2.92 | -6.11% | -0.19 | 7519.18 万 | 2.92 | 2.93 | 1.33% | 55.35 亿 | 55.35 亿 | 3.11 | 3.03 | 3.10 | 2.90 |
| 23 | 688701 | 卓锦股份 | 11.52 | -4.00% | -0.48 | 436.78 万 | 11.52 | 11.61 | 1.31% | 15.47 亿 | 3.29 亿 | 12.00 | 11.92 | 11.98 | 11.50 |
| 24 | 002207 | 准油股份 | 7.40 | -6.92% | -0.55 | 2.32 亿 | 7.48 | 7.41 | 11.71% | 19.39 亿 | 19.25 亿 | 7.95 | 7.78 | 7.98 | 7.34 |
| 25 | 002910 | 庄园牧场 | 12.58 | -5.27% | -0.70 | 1.32 亿 | 12.58 | 12.59 | 6.00% | 29.23 亿 | 21.52 亿 | 13.28 | 13.12 | 13.32 | 12.52 |
| 26 | 300564 | 筑博设计 | 20.67 | -4.31% | -0.93 | 2622.44 万 | 20.67 | 20.68 | 3.70% | 21.28 亿 | 6.98 亿 | 21.60 | 21.66 | 21.73 | 20.58 |
| 27 | 600961 | 株冶集团 | 10.09 | 0.00% | 0.00 | - | - | - | 0.00% | 53.22 亿 | 53.22 亿 | 10.09 | - | - | - |
| 28 | 002461 | 珠江啤酒 | 7.74 | -3.81% | -0.24 | 7587.69 万 | 7.74 | 7.75 | 0.46% | 171.31 亿 | 171.31 亿 | 7.98 | 7.93 | 7.99 | 7.73 |
| 29 | 600684 | 珠江股份 | 3.77 | -5.04% | -0.20 | 1.28 亿 | 3.77 | 3.78 | 3.65% | 32.18 亿 | 32.18 亿 | 3.97 | 3.95 | 3.98 | 3.70 |
| 30 | 002678 | 珠江钢琴 | 5.70 | -2.23% | -0.13 | 1093.23 万 | 5.70 | 5.71 | 0.14% | 77.42 亿 | 77.38 亿 | 5.83 | 5.83 | 5.87 | 5.70 |
| 31 | 000659 | 珠海中富 | 3.34 | -4.30% | -0.15 | 4893.05 万 | 3.34 | 3.36 | 1.12% | 42.94 亿 | 42.94 亿 | 3.49 | 3.45 | 3.50 | 3.33 |
| 32 | 688772 | 珠海冠宇 | 23.03 | -6.38% | -1.57 | 1.04 亿 | 23.03 | 23.04 | 4.03% | 258.36 亿 | 25.18 亿 | 24.60 | 24.54 | 24.75 | 22.73 |
| 33 | 000507 | 珠海港 | 5.69 | -4.05% | -0.24 | 7362.20 万 | 5.69 | 5.70 | 1.53% | 52.33 亿 | 47.26 亿 | 5.93 | 5.89 | 5.93 | 5.67 |
| 34 | 300232 | 洲明科技 | 6.07 | -4.26% | -0.27 | 5815.73 万 | 6.08 | 6.07 | 1.08% | 66.41 亿 | 53.01 亿 | 6.34 | 6.32 | 6.36 | 6.06 |
| 35 | 600759 | 洲际油气 | 2.63 | -4.01% | -0.11 | 1.21 亿 | 2.62 | 2.63 | 2.01% | 59.53 亿 | 59.39 亿 | 2.74 | 2.74 | 2.76 | 2.61 |
| 36 | 002867 | 周大生 | 12.91 | -2.57% | -0.34 | 8060.67 万 | 12.91 | 12.92 | 0.57% | 141.50 亿 | 139.20 亿 | 13.25 | 13.25 | 13.35 | 12.85 |
| 37 | 000950 | 重药控股 | 5.01 | -3.47% | -0.18 | 1.27 亿 | 5.01 | 5.02 | 1.45% | 87.34 亿 | 86.58 亿 | 5.19 | 5.19 | 5.19 | 5.00 |
| 38 | 601963 | 重庆银行 | 8.36 | -2.34% | -0.20 | 1.57 亿 | 8.36 | 8.37 | 2.68% | 290.47 亿 | 57.80 亿 | 8.56 | 8.53 | 8.56 | 8.35 |
| 39 | 601158 | 重庆水务 | 5.64 | -2.59% | -0.15 | 5691.71 万 | 5.63 | 5.64 | 0.21% | 270.72 亿 | 270.72 亿 | 5.79 | 5.77 | 5.79 | 5.61 |
| 40 | 600917 | 重庆燃气 | 7.14 | -4.03% | -0.30 | 2687.90 万 | 7.13 | 7.14 | 0.24% | 112.19 亿 | 111.10 亿 | 7.44 | 7.44 | 7.44 | 7.11 |
| 41 | 600132 | 重庆啤酒 | 123.57 | -1.43% | -1.79 | 4.65 亿 | 123.54 | 123.57 | 0.77% | 598.04 亿 | 598.04 亿 | 125.36 | 124.98 | 126.53 | 121.00 |
| 42 | 600106 | 重庆路桥 | 3.91 | -4.87% | -0.20 | 1.16 亿 | 3.90 | 3.91 | 2.18% | 51.96 亿 | 51.96 亿 | 4.11 | 4.08 | 4.08 | 3.89 |
| 43 | 600039 | 重庆啤酒 | 4.31 | -7.85% | -0.32 | 1.42 亿 | 4.31 | 4.32 | 1.72% | 89.06 亿 | 89.06 亿 | 4.53 | 4.58 | 4.68 | 4.30 |
多选功能
点击自定义指标列按钮,即可对该指标值的颜色进行设置。
指标处默认填充该栏指标值名称。点击 可新增或删减某条指标值颜色设置。

添加指标值颜色
示例:

指标颜色显示
报价界面右键菜单如图所示。

行情报价界面右键菜单
调整列宽:可一键将列宽改正为默认格式。
定制列:选择定制列来勾选您所需要关注的数据。

定制列选择
导出数据:导出所显示界面的全部数据,导出数据支持 txt,csv 和 excel 两种格式。
| 代码 | 名称 | 权重% | 涨幅 | 今开 | 最新 | 最高 | 最低 | 总跌 | 总量 | 前收 | 涨跌 | 持仓 | 委买价 | 委买量 | 委卖价 | 委卖量 | 委比 | 市盈率 | 总笔 | 总手 | 现手 | 买二价 | 买三价 | 买四价 | 买五价 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 平安银行 | 0.335 | 1.30% | 9.24 | 9.36 | 9.36 | 9.23 | 10,97 亿 | 118.0 万 | 9.24 | 0.12- | - | 9.35 | 8808 | 9.36 | 4065 | - | - | - | 1180256 | 1180256 | 9.34 | 9.33 | 9.32 | 9.3 |
| 2 | 万科 A | 0.66 | -0.36% | 27.04 | 27.3 | 27.42 | 26.91 | 14.41 亿 | 53.04 亿 | 27.4 | -0.1- | - | 27.29 | 8464 | 27.3 | 972 | - | - | - | 530389 | 530389 | 27.28 | 27.27 | 27.26 | 27.2 |
| 4 | 国农科技 | 0.009 | 1.32% | 45.85 | 46.55 | 46.56 | 45.51 | 8350.62 万 | 1.81 万 | 45.93 | 0.62- | - | 46.55 | 63 | 46.56 | 39 | - | - | - | 18129 | 18129 | 46.54 | 46.53 | 46.52 | 46.5 |
| 5 | 世纪星展 | 0.017 | 0.66% | 7.55 | 7.59 | 7.62 | 7.52 | 1.45 亿 | 19.10 万 | 7.54 | 0.05- | - | 7.58 | 1782 | 7.59 | 2498 | - | - | - | 190996 | 190996 | 7.57 | 7.56 | 7.55 | 7.5 |
| 6 | 深房 A | 0.032 | 0.53% | 9.59 | 9.65 | 9.65 | 9.59 | 1.47 亿 | 15.27 万 | 9.59 | 0.06- | - | 9.94 | 1040 | 9.65 | 1078 | - | - | - | 152701 | 152708 | 9.63 | 9.62 | 9.61 | 9.6 |
| 8 | 全新好 | 0.013 | -0.04% | 26.55 | 26.38 | 26.65 | 26.25 | 5924.73 万 | 2.24 万 | 26.39 | -0.01- | - | 26.38 | 31 | 26.39 | 103 | - | - | - | 22416 | 22416 | 26.37 | 26.36 | 26.35 | 26.3 |
| 9 | 神州高铁 | 0.037 | 1.39% | 10.05 | 10.23 | 10.38 | 10.01 | 2.56 亿 | 25.13 亿 | 10.09 | 0.14- | - | 10.22 | 760 | 10.23 | 1817 | - | - | - | 251308 | 251308 | 10.21 | 10.2 | 10.19 | 10.1 |
| 9 | 中国宝安 | 0.056 | 0.38% | 10.59 | 10.62 | 10.64 | 10.52 | 3.83 亿 | 36.21 万 | 10.58 | 0.04- | - | 10.62 | 5513 | 10.63 | 3551 | - | - | - | 362052 | 362052 | 10.61 | 10.6 | 10.59 | 10.5 |
| 10 | 燃气表单 | 0.008 | 0.76% | 7.9 | 7.96 | 7.98 | 7.89 | 11.88 亿 | 108.0 万 | 7.9 | 0.09- | - | 7.95 | 2457 | 7.96 | 1397 | - | - | - | 90706 | 90763 | 7.94 | 7.92 | 7.92 | 7.9 |
| 11 | 深物业 A | 0.008 | 1.78% | 17.47 | 17.72 | 17.77 | 17.38 | 1.33 亿 | 7.54 万 | 17.41 | 0.31- | - | 17.72 | 605 | 17.73 | 306 | - | - | - | 75387 | 75387 | 17.7 | 17.69 | 17.68 | 17.6 |
| 12 | 南玻 A | 0.049 | -4.77% | 14.7 | 14.59 | 15.06 | 14.35 | 20 亿 | 205.58 万 | 15.32 | -0.73- | - | 14.58 | 376 | 14.59 | 2371 | - | - | - | 2055776 | 2055776 | 14.57 | 14.56 | 14.55 | 14.5 |
| 14 | 沙河股份 | 0.011 | 1.39% | 23.14 | 25.29 | 23.53 | 23.02 | 7007.09 万 | 5.01 万 | 22.97 | 0.32- | - | 23.28 | 10 | 23.29 | 115 | - | - | - | 30127 | 30127 | 23.27 | 23.26 | 23.23 | 23.2 |
| 16 | 深康佳 A | 0.02 | 0.61% | 4.95 | 4.97 | 4.98 | 4.93 | 9067.01 万 | 18.30 万 | 4.94 | 0.03- | - | 4.97 | 7919 | 4.98 | 5534 | - | - | - | 182987 | 182878 | 4.96 | 4.95 | 4.94 | 4.9 |
| 17 | 深圳华福 A | 0.009 | 1.85% | 11.9 | 12.12 | 12.43 | 11.85 | 1.63 亿 | 13.47 亿 | 11.9 | 0.23- | - | 12.11 | 274 | 12.12 | 107 | - | - | - | 134728 | 134726 | 12.1 | 12.09 | 12.08 | 12.0 |
| 18 | 神州长城 | 0.02 | -2.74% | 10.58 | 10.28 | 10.67 | 10.25 | 2.50 亿 | 50.04 亿 | 10.57 | -0.29- | - | 10.28 | 2772 | 10.29 | 1282 | - | - | - | 500367 | 500367 | 10.27 | 10.26 | 10.25 | 10.2 |
| 19 | 深深宝 A | 0.017 | 1.09% | 18.41 | 18.59 | 18.8 | 18.43 | 3.36 亿 | 18.07 亿 | 18.39 | 0.2- | - | 18.59 | 1590 | 18.6 | 566 | - | - | - | 180652 | 180652 | 18.58 | 18.57 | 18.56 | 18.5 |
| 20 | 深华发 A | 0.011 | 0.71% | 25.34 | 25.68 | 26.03 | 25.34 | 1.16 亿 | 4.48 万 | 25.5 | 0.18- | - | 25.68 | 88 | 25.69 | 254 | - | - | - | 44832 | 44832 | 25.67 | 25.66 | 25.65 | 25.6 |
| 21 | 深科科技 | 0.039 | 0.00% | 10.63 | 10.64 | 10.68 | 10.59 | 1.27 亿 | 11.93 万 | 10.64 | 0- | - | 10.64 | 406 | 10.65 | 1156 | - | - | - | 119295 | 119295 | 10.63 | 10.62 | 10.61 | 10. |
| 22 | 新大洲 A | 0.02 | 0.78% | 17.26 | 17.38 | 17.38 | 17.29 | 2222.71 万 | 8.85 万 | 17.25 | 0.13- | - | 17.38 | 46 | 17.39 | 199 | - | - | - | 18542 | 18542 | 17.37 | 17.36 | 17.35 | 17. |
| 23 | 深天地 A | 0.012 | 0.58% | 34.62 | 34.82 | 34.95 | 34.25 | 4684.1 万 | 1.36 万 | 34.62 | 0.2- | - | 34.82 | 119 | 34.84 | 40 | - | - | - | 13563 | 13563 | 34.81 | 34.8 | 34.78 | 34.7 |
| 25 | 特力 A | 0.032 | 0.42% | 67.4 | 67.49 | 67.69 | 66.83 | 5.36 亿 | 5.30 万 | 67.21 | 0.28- | - | 67.49 | 417 | 67.5 | 321 | - | - | - | 52982 | 52982 | 67.48 | 67.47 | 67.46 | 67.4 |
| 26 | 飞亚达 A | 0.011 | 0.82% | 14.55 | 14.67 | 14.75 | 14.49 | 7190.88 万 | 4.90 万 | 14.55 | 0.12- | - | 14.66 | 372 | 14.67 | 205 | - | - | - | 49049 | 49049 | 14.65 | 14.64 | 14.63 | 14.6 |
| 27 | 深圳昭通 A | 0.068 | 2.16% | 6.94 | 7.1 | 7.11 | 6.942 | 1.9 亿 | 31.06 亿 | 6.95 | 0.15- | - | 7.1 | 2901 | 7.11 | 3965 | - | - | - | 310576 | 310576 | 7.1 | 7.08 | 7.07 | 7.0 |
| 28 | 同花顺一货 | 0.042 | 0.41% | 73.31 | 73.67 | 74.53 | 73.11 | 1.07 亿 | 1.46 万 | 73.3 | 0.3- | - | 73.6 | 19 | 73.77 | 5 | - | - | - | 14592 | 14592 | 73.59 | 73.51 | 73.5 | 73.4 |
| 深深房 A | 0.025 | 11.17 | |||||||||||||||||||||||
| 富奥股份 A | 0.028 | 0.55% | 9.07 | 9.12 | 9.16 | 9.04 | 6228.08 万 | 6.84 万 | 9.07 | 0.05- | - | 9.11 | 620 | 9.12 | 913 | - | - | - | 68448 | 68448 | 9.1 | 9.09 | 9.08 | 9.0 |
excel 文件导出界面
复制数据:复制所显示界面的全部数据(即只复制了一屏的数据,并非全部的数据)。
股票组合买入:当前界面选中股票后,右键选择股票组合买入,用户选择资金账号并填入投资金额后点击下单,即可为所选中的股票平均分配金额并买入。

股票组合买入

组合买入金额分配
股票组合卖出:当前界面选中股票后,右键选择股票组合卖出,用户选择资金账号并填入投资金额后点击下单,即可为所选中的股票平均分配金额并卖出。
如果当前用户不拥有选中的某只股票的持仓,则不对选中的该只股票进行卖出操作;如果当前用户的持仓可用量不足分配的资金,则卖出全部持仓可用量,剩余的所分配资金部分不予处理。

股票组合卖出
添加自定义字段:可将自定义字段添加到报价界面中。

添加自定义字段
选择自定义指标:可将指标数据以字段形式添加到报价界面中。

选择自定义指标
删除自定义指标:可将指标数据从面板中删除。
删除全部自定义指标:可将全部指标数据从面板中删除。
添加扩展数据:选择数据类型添加。
所属板块分析:勾选出所选证券存在的所有板块。支持新增多个证券,切换
对比。

样板股分析界面
导出成分股:可将本板块的全部成分股导出。(只导出成分股代码,要导出全部数据如今开,今收,最高,最低等全部数据请使用导出数据功能。)
加入自选板块:将选中的股票加入我的自选板块。
加入篮子:将选中的股票创建成一个新的篮子,创建完成后可在组合交易 - 篮子管理中查看。
条件选股:根据指标的条件可筛选符合条件的代码。

条件选股界面
新建工作组:即复制页面的功能。
默认布局:点击恢复默认布局,报价主界面即恢复到以下状态。

恢复默认布局

个股分析界面功能区域划分
个股分析界面包括管理面板,K 线图界面,附图指标界面,行情界面和个股信息界面。
指标管理面板配合个股分析界面使用。管理指标同 3.2.1.2 所述。
双击这些指标,K 线图中指标会相应变化或 K 线图下方区域会添加副图指标。

副图指标
K 线图界面会显示该品种的开盘价,最高价,最低价,收盘价,成交量,成交额,涨幅以及振幅等数据。K 线默认叠加 ma 指标,可手动选择其他指标。同时在 K 线图界中双击相应日期历史 k 线,右侧行情及个股信息界面变动为相应日期数据。
界面切换:使用回车键和 F5 键都可实现个股分析界面和个股分时界面的切换。
十字光标:双击鼠标左键可在界面上出现十字光标,横向移动可选择要做分析的时间点,纵向移动可看到某一天的 K 线价格。
历史行情及个股信息:
鼠标在十字光标状态时,移动鼠标,相应的历史行情数据和 ma 指标值会在界面组上方跟随变动。

随十字光标变动数据
双击任意一根 K 线,最右侧的行情及个股信息界面会显示相应日期的历史行情和个股信息。

双击 k 线变动

右键菜单
①添加指标:点击添加指标,会出现新的一栏附图指标。如下图显示 3 种指标。

添加指标
②修改指标参数:修改所选指标的参数值。

修改参数
③编辑指标:出现迅投模型编辑器。可自定义编制指标。

编辑指标
④时段行情:输入起始日期和终止日期,选择所需观察时间段的 K 线图。勾选时段统计,会出现所选时段的价格及成交量的统计数据。

行情时段选择

时段统计
⑤叠加指标:点击叠加指标,出现主图指标选择,勾选后在主图坐标中叠加指标(或直接在指标管理面板中双击带有主图标志的指标),取消勾选后即取消叠加指标。
⑥取消叠加指标:显示现主图叠加的指标,取消勾选后即可取消叠加某一指标。
⑦显示指标排名:主图叠加指标并勾选显示指标排名后,鼠标悬停在 K 线上即可查看某根 K 线上的高开低收情况。

显示指标排名
⑧所属板块分析:可查看当前股票所属板块,同时还可新增其他股票,查看不同股之间的板块重合情况。

所属板块分析
⑨叠加品种:选择叠加品种后,会在左上角当前品种的后面出现叠加品种的种类。并出现选择的叠加品种的 k 线图,不止可叠加一个品种,可叠加多个品种。在未取消叠加品种的状态下,切换不用的股票(当前品种),叠加品种都不变。

叠加品种 k 线
⑩取消叠加品种:点取消叠加品种,所有叠加的品种都会取消。
⑪复制模型运行结果:选择复制运行结果之后,粘贴至记事本。

复制模型运行结果
⑫加入自选股:加入自选股,可添加至我的自选板块。

加入自选股
⑬分析周期:选择 k 线分析周期。

k 线分析周期
⑭复权处理:复权处理可选择不复权,前复权,后复权,等比前复权,等比后复权。

复权处理
⑮锁定界面位置:选择锁定界面位置后,每次点击十字光标时十字光标会固定在所选位置 k 线的收盘价处。

锁定界面位置
⑯导出公式:点击导出公式,可将主图或副图叠加的指标或模型导出到本地。
⑰导出数据:点击导出数据,可将主图或副图叠加的指标或模型计算生成的数据以.csv 的格式导出到本地。
⑱新建工作组:选择新建工作组后,会复制一个当前相同的个股分析面板,复制内容包括主图和附图指标。

新建工作组
○19 修改 K 线数据:修改指定 K 线的内容。

修改 K 线数据
通过点击这个图中箭头所指的灰色标志可隐藏或打开盘口及个股信息界面。

行情及个股信息界面
①五档行情:
| 000014 沙河股份 | ||
| 卖⑤ | 12.09 | 135 |
| 卖④ | 12.08 | 70 |
| 卖③ | 12.07 | 10 |
| 卖② | 12.06 | 25 |
| 卖① | 12.05 | 23 |
| 最新 | 12.05 现手 | 10 |
| 买① | 12.03 | 29 |
| 买② | 12.02 | 113 |
| 买③ | 12.01 | 222 |
| 买④ | 12.00 | 2023 |
| 买⑤ | 11.99 | 49 |
五档盘口

个股信息
③分笔:提供分时成交明细表。在此可看到实时报价。

分笔界面
④分价:提供每个成交金额及该金额对应的成交数量,可结合筹码指标一起使用。

分价界面
⑤走势 :显示所在周期的分时走势图。

走势界面
分时图与 K 线图可以通过”enter”键或“F5”键来回切换。

个股分析界面功能区域划分
管理模型面板用于分时主界面的指标和模型的选择和叠加。管理指标同 3.1. 1.2 所述。双击这些指标,分时图中指标会相应变化或分时图下方区域会添加附图指标。

附图指标
分时图默认显示分时价格线、分时均价线和成交量。和个股分析界面一样,可自行选择主图坐标和附图坐标。

分时主界面

右键菜单
①添加指标:点击添加指标,会出现新的一栏附图指标。
②叠加指标:点击叠加指标,出现主图指标选择,选择后在主图坐标中叠加指标(或直接在指标管理面板中双击带有主图标志的指标。)
③所属板块分析:勾选出所选证券存在的所有板块。支持新增多个证券,切
换对比。
④取消叠加指标:会相应出现已添加的主图指标,需要勾选即取消叠加指标。
⑤叠加品种:选择品种后,会出现相应品种的分时分时价格线。选择叠加品后会在左上角当前品种的后面出现叠加品种的种类。不止可叠加一个品种,可叠加多个品种。在未取消叠加品种的状态下,切换不用的股票(当前品种),叠加品种都不变。

叠加品种
⑥取消叠加品种:点击取消叠加品种,会将所有叠加品种取消。
⑦修改指标参数:修改所选指标的优化步长。
⑧编辑指标:系统指标不能编辑。非系统指标可以编辑。出现迅投模型编辑器。可自定义编制指标。
⑨显示成交量:不勾选显示成交量,仅显示分时价格线和分时均价线。勾选显示成交量。

不显示成交量

显示成交量
⑩显示渐变色:勾选则为渐变,分时图可渐变显示。
⑪加入自选股:加入自选股,可添加至我的自选板块。
⑫导出公式:系统指标不能导出,非系统指标可以导出。
⑬新建工作组:选择新建工作组后,会复制一个与当前相同的个股分时面板,
复制内容包括主图和附图指标。
⑭显示交易数据:勾选相关账号可显示交当日成交情况,如下图所示。

显示交易数据
通过点击这个图中箭头所指的灰色标志可隐藏或打开盘口及个股信息界面。

行情及个股信息界面
①五档盘口:
| 000011 深物业 A | |||
| 卖⑤ | 15.44 | 45 | |
| 卖④ | 15.43 | 44 | |
| 卖③ | 15.42 | 67 | |
| 卖② | 15.41 | 29 | |
| 卖① | 15.40 | +9 | 106 |
| 最新 | 15.38 | 现手 | 25 |
| 买① | 15.38 | +41 | 89 |
| 买② | 15.37 | 34 | |
| 买③ | 15.36 | +5 | 113 |
| 买④ | 15.35 | 239 | |
| 买⑤ | 15.34 | 10 |
五档盘口
②个股信息:用户可以选择观察分笔、分价与分时走势。

个股信息
③分笔:提供分时成交明细表。在此可看到实时报价。

分笔界面
④分价:提供每个成交金额及该金额对应的成交数量,可结合筹码指标一起使用。

分价界面
⑤走势 :显示所在周期的分时走势图。

走势界面
在分时图界面里面每按“↓”一次,即可多显示历史交易日的分时图。

显示多日分时图
对于有 level2 使用权限的用户,在登录后即可查看 level2 行情。

Level1 主界面

Level2 主界面
Level2 行情界面的主要组成部分为:主图、今日参数、委托队列、逐笔委托、逐笔成交、千档盘口、十档盘口、分笔数据和全息看盘等。
委卖队列和委买队列是指实时的分笔委托明细。其中,买卖一档分别展示了申买量和申买量前 50 笔的分笔委托数据。

使用右上角的按钮可以变换买卖队列的多种展现形式,包括五档、十档以及其他各种队列模式。
队列中,10 24 蓝色底色代表新增委托单,灰色底色代表撤单,12 5 白色字体代表已成交委托单,8348 成 5 蓝底灰字代表部成委托单,4938 浅绿色底色代表挂卖单在 1000-5000 手之内,9827 深绿色底色代表挂卖单大于 5000 手,3280 3333 浅紫色底色代表挂买单在 1000-5000 手之内,7500 7500 深紫色底色代表挂卖买单大于 5000 手。
逐笔成交真实的展示了每笔成交价和成交量的明细数据。

逐笔成交
同时,分笔和逐笔数据实现联动,点击某条分笔数据,相应的逐笔成交部分高亮。

逐笔和分笔联动
队列中,

蓝色底色表示主动成交,


该委托单在这笔之前已有成交,数字后面的箭头表示还未完全成交,之后还有成交。
鼠标悬停弹出每笔详情,其中表头右侧编号代表当天成交的第几笔数据,如下图所示:

逐笔成交详情
默认展开买卖列,点击 图标收起买卖列,如下图所示:

买卖队列收展
逐笔委托真实的展示了沪深市场的每一笔挂单和撤单,及其成交情况的明细数据。点击逐笔委托可追踪该委托,展示该笔委托对应的成交、撤单明细。

在深市股票个股界面,十档盘口默认显示为千档的前十五档(盘口当前状态为),单击 可展开完整千档行情和十档盘口(盘口当前状态为),再次单击 可将完整千档关闭,仅显示十档盘口。
千档盘口显示全部价位的买卖盘价格、委托量、委托单数,点击可查看委托队列详情。
千档盘口中显示当前千档资金分布状态的缩略图(即展示整个千档的资金分布状态,并非与左侧各档位一一对应)。

千档盘口
鼠标置于千档上下滑动可查看更多数据,滑动后点击如下图所示按钮即可将千档居中展示。

居中按钮

点击全息按钮或在主界面使用空格键进入全息看盘界面。
全息界面由分笔图、成交量图、全息图、买卖队列、逐笔成交、千档盘口和十档盘口组成。分笔线、逐笔线和逐笔成交实时联动,展现交易撮合过程,为快速全方位的股票深度分析提供了解决方案。
全息界面可使用 pageup 和 pagedown 切换股票。

分笔、全息和逐笔联动
使用上下方向键实现图形的放缩,可查看全天的数据。

全部数据展示
全息图根据成交量决定显示的宽度,显示为上下两个矩形,分别表示买卖双方的委托单大小。
如果相邻成交来自于同一个委托单,则会将图形合并成一个矩形,展示效果如下:

相邻委托单
如果某笔委托单被其他委托中断,形成不连续成交,则其矩形图形中间用浅色线连接,如下图:

不连续成交
同一个委托单跨价位成交,用浅色斜线连接,如下图:

跨价位成交
对于主动成交的委托单,对其图形内部进行高亮处理,如下图:

主动成交
矩形右侧显示黄色三角,代表该委托单为市价单等特殊委托单;矩形右侧显示橙色三角,代表该委托单是委托价格优于成交价格的委托单。
在全息图形上放置鼠标后显示逐笔成交相关信息,其中表头右侧编号代表当天成交的第几笔数据。

成交详情
资讯页面可查看相关股票的最新动态,快速了解相关资讯。
| 新闻 | 研报 | 公告 |
|---|---|---|
| 新闻日期 | 研报日期 | 研报标题 |
| 2019-12-03 | 刘永好连续增持民生银行 H 股 持股比例接近 1% | 2021-05-07 国信证券 - 民生银行 -600016.SH-2021 年一季报点评:非息收入下降,加强不良确认 |
| 2019-12-03 | 一回来就买到停不下来!11 月刘永好 19 次增持民生银行 H 股 | 2020-11-12 天风证券 - 民生银行 -600016.SH-业绩继续下滑,资产质量压力较大 |
| 2019-12-02 | 四川富富 19 天豪择 4 亿买民生银行!刘永好同时持有 A 股和 H 股 增持时点值得玩味 | 2020-09-01 国泰君安 - 民生银行 -600016.SH-民生银行 2020 年中报点评:营收稳定,息差走扩 |
| 2019-11-28 | 民生银行北京分行做客户身边的贴心银行 | 2020-08-31 天风证券 - 民生银行 -600016.SH-FPOP 增速较高,资产质量恶化 |
| 2019-11-28 | 中国民生银行行长郑万春:正积极研究金融科技并探索区块链 | 2020-05-05 天风证券 - 民生银行 -600016.SH-业绩平稳,成本收入比再降 |
| 2019-11-28 | 民生银行小微金融“Open Day”路演活动顺利收官 | 2020-05-05 国信证券 - 民生银行 -600016.SH-2020 年一季报点评:业绩增长稳定,净息差小幅走阔 |
| 2019-11-27 | 民生银行拟给予巨人投资子公司 70 亿元并购银团贷款 | 2020-04-03 天风证券 - 民生银行 -600016.SH-业绩略超预期,资产质量拐点或已现 |
| 2019-11-27 | 民生银行宝鸡分行成功举办“小小银行家”活动 | 2020-04-01 中银证券 - 民生银行 -600016.SH-资产质量包被减轻,关注可转债推进进程 |
| 2019-11-27 | 民生银行西安分行与西安市中小企业发展基金 签订战略合作协议 | 2020-04-01 国信证券 - 民生银行 -600016.SH-2019 年报点评:净息差走阔,资产质量改善 |
| 2019-11-27 | 民生银行西安分行开展办公大楼消防检查 |
F3 上证指数分时图 F4 深圳成指分时图 F5 分时图、K 线图切换 F6 沪深 A 股行情列表界面 F8 切换 K 线分析周期 Ctr1+0 弹出指标叠加对话框 Ctrl+Z 添加自选股 Ctrl+M 多股同列 Ctrl+X 多周期同列(在 K 线界面下使用)Ctrl+R 系统切换至光标所指日期(在 K 线界面下使用)Ctrl+V 不复权/前复权切换 Ctr1+B 不复权/后复权切换 SHIFT +Q 弹出变量查看器(模型条件下)SHIFT +L 锁定界面位置 SHIFT +W 弹出/关闭管理面板 HOME 光标移至最左 END 光标移至最右 Insert 添加自选股
下列快捷键是由键盘精灵输入 60 全部 A 股涨幅 61 沪 A 涨幅排名 62 沪 B 涨幅排名 63 深 A 涨幅排名 64 深 B 涨幅排名 65 沪债涨幅排名 66 深债涨幅排名 67 深泸 A 涨幅排名 68 深泸 B 涨幅排名 69 中小企业涨幅排名
快捷键汇总
交易模块中同样可见行情面板,易于投资者观察行情进行交易。行情模块和交易模块通过按键实现行情模块或交易模块的收起和展开。

收起展开按钮

交易模块展开界面及收起键
首次使用交易模块,未在系统中添加过账号时,可以点击下单面板中添加账号按钮,添加账号。

如需继续添加多账号时,可点击账号资金面板中的添加账号功能继续添加资金账号。

还可以通过系统设置中账号管理功能添加资金账号。

添加账号界面
在账号管理中,可添加和删除账号,可查看账号名称、账号登录状态、总资产、可用资金、账号类型,可对登录失败的账号进行重登录。
添加账号:选择账号类型,交易平台,经纪公司,资金账号和密码后可添加账号,需注意的是,如果系统开启了账号白名单,则所添加账号必须已经在迅投 QMT 极速策略交易系统管理终端白名单中才能添加成功,否则需先在管理端将此账号添加在白名单中。
登录校验是校验账号密码,校验成功后点击确定账号即添加成功。
添加成功的账号可以删除、手续费设置和改密码操作。
迅投极速策略交易系统下单界面支持如下特色功能:
①复制下单面板:
面板复制可以让用户按照自己的需要将软件的下单面板复制出多个界面窗口,让用户可以在同一个版面上查看到更多的信息及进行更多的操作。
用户可使用 ALT+ 数字键的方式,根据下单面板的数字标识,在不同的下单面板中进行切换(需在系统设置 - 快捷键设置中开启本功能)。

复制下单面板
②分组联动下单

行情与下单面板分组联动下单
分组联动下单功能需要配合复制面板功能使用。行情界面和下单面板都有选择分组的图标,点击图标,从 1 到 9 的关联中选择分组。不同分组下单面板可关联不同的行情界面,在不同行情界面双击某证券时,实现在下单面板中联动出现相关信息,即实现联动快速下单。
例如:在关联分组 1 的行情界面双击任意证券,关联分组为 1 的下单面板中,相应自动填充此证券的信息。

下单面板选择分组图标位置

行情界面选择分组图标位置
迅投 QMT 算法交易通过大单拆分方式减少对市场的冲击,并且根据行情波动及时调整报价已保证快速成交。详情见图。
算法交易的控制面板如下图所示:
报价方式:可选多种报价方式,统称为“基准价”。
单笔超价:单笔超价是以基准价为基础,对委托价格做调整。支持“元”、“%”两种模式。正值加速成交,注重成交速度,即买入时委托价格=基准价*(1+x%),卖出时委托价格=基准价*(1-x%);负值优化成交,注重节约成本,即买入时委托价格=基准价*(1-x%),卖出时委托价格=基准价*(1+x%)
单笔基准量:单笔委托数量以此为基准。
基准量比例:基准量比例×单笔基准量=单笔委托数量。单笔委托数量小于单笔最小量,按单笔最小量报单:单笔委托数量大于单笔最大量,按单笔最大量报单。
下撤单间隔:
算法交易任务开始执行后,会按照下单间隔设置,定时报送委托;每隔 XX 秒,根据当前行情判断,撤单重报是否更有利于成(买入报单后,价格上涨,原买入价格无法成交,需要以更高的价格重新报单才能成交。或卖出报单后,价格下跌,原卖出价格无法成交需要以更低的价格重新报单才能成交),当有利于成交时才会执行撤单,否则继续挂单。
超价启用笔数:从第笔开始,委托价格根据单笔超价调整。
算法交易报单的时机由波动区间决定,当股票价格超出设置的波动区间时,系统将暂停报单。波动区间支持单向、双向两种模式,单向即买入时仅限制上限,卖出时仅限制下限;双向即买入、卖出均限制上下限。
单笔最小量、单笔最大量:组成单笔委托量范围,单笔委托数量必须在单笔范围内。当算法任务未报委托量小于单笔最小量,会按未报委托量报单。
有效时间:按照算法任务的开始时间计算,超出有效时间,算法任务终止同时向柜台发起撤销委托。
最大委托次数:即算法任务最大可委托的次数,含未成委托再次报单。当委托次数达到最大委托次数后再次到达下单时点,算法任务终止同时向柜台发起撤销委托。
未成委托处理:撤单的部分属于未成委托。如果选择了未成委托的处理方式,撤回的部分按照未成委托处理所选的方式委托下该次委托不受下单间隔景响,依然会根据撤单间隔判断是否撤单。如果未成委托选择不处理,撤回的部分会计算到任务未报单量,将在之后的任务执行过程中正常报单。
触价设置:启用触价后,可设置条件单的触发价格和触价方向。当标的最新价满足触价条件时,算法任务开始执行,否则任务维持等待状态。触价方向分为“≥”和“≤”,当设置“最新价≥触发价格”时,标的最新价大于触发价格时,任务启动;当设置“最新价≤触发价格”时,标的最新价小于触发价格时,任务启动。
投资备注:用于填写该笔算法交易任务备注信息。
☐我已阅读、充分理解并接受算法交易使用提示,不再提醒
迅投 QMT 随机量交易是根据用户设置的区间范围内随机产生报单,并根据行情波动及时调整报价以保证快速成交。详情见图。
随机量交易根据用户设置的区间范围内随机产生报单,并根据行情波动及时调整报价以保证快速成交
随机量交易的控制面板如下图所示:
| 报价方式 | 对手价 |
|---|---|
| 下单间隔 | 60.00 秒 |
| 双向波动区间 | 5.00% |
| 有效时间 | 1800 秒 |
| 最大委托次数 | 100 次 |
| 单笔里区间 | 100-10000 股 |
随机量交易报单的时机由波动区间决定。当股票价格超出设置的波动区间(如图中 5%)时,系统将不再报单.
随机量交易可控制报单有效时间,如图所示:在下单时间超过有效时间 1800s 或者报单次数超过最大委托次数后,随机量交易停止报单,并且进行撤单操作
随机量交易每次报单以当前所选的价格类型 (如图中对手价) 作为基准价.
单次报单量则根据单笔量区间算出,仍以图设为例:每次下单将会委托 100 股到 10000 股中的某个随机值,当委托量不是最小报单量的整数倍时,向下取整
随机量交易的撤单间隔与下单间隔一致,且只有根据当前行情撤单后能报出更有利的价格时,才会执行撤单重报,例如:当前票价格为 15 元/股,买入 40000 股时,算法设置为上图所示。当价格保持 15 元/股时,即使报单时间超过 60s,系统也不会进行撤单操作直至委托完全成交或者超过有效时间。只有报单后达到撤单间隔时,且有优于 15 元/股的最新价,系统才会撤单准备下次报单同理,根据这种原则当用户通过随机量交易挂单在涨停板买入股票或者在跌停板卖出股票时,系统将不会进行撤单操作
请以成交为目的正确地使用随机量交易系统。并适当延长报撤单的时间间隔,以防止出现干扰市场操作
☐我已阅读、充分理解并接受随机量交易使用提示,不再提醒
接受
迅投 QMT 支持多账号快捷选择,选中的账号才会显示在资金面板处。

多账号
当用户管理多账户时,支持对多账号和账号组内以“平均分配”“交易权重” “可用比例”三种方式进行分单。

分单方式
平均分配:多账户平均分配。例如:下单 300 股,选中三个账户按平均分配,则为每个账户下单 100 股。
交易权重:多账户之间按设置的权重分配。例如:下单 300 股股票,选中 2 个账号按照交易权重分配,A 账号权重设为 2,B 账号权重设为 1,则 A 账户下单 200 股,B 账号下单 100 股。
可用比例:多账户之间按可用资金比例下单。例如:下单 1000 股股票,选中三个账号。A 账号可用资金 30 万,B 账户可用资金 60 万,C 账户可用资金 10 万,则按照 3:6:1 的比例下单,A 账户下单 300 股股票,B 账户下单 600 股股票,C 账户下单 100 股股票。
迅投 QMT 智能算法交易是根据用户设置的对应智能算法策略进行下单,包括但不限于 TWAP、VWAP、跟量、冰山等(具体算法说明请参考《智能算法交易介绍及使用手册》)。用户使用时可参考智能算法使用提示进行操作,详情见图。

股票交易是指股票投资者之间按照市场价格对已发行上市的股票进行的买卖。目前系统支持普通买卖、科创板、逆回购、新股申购和 CDR 存托凭证等交易操作.

下单面板
盘口清晰显示该合约的行情变动情况。股票交易和期货交易下单面板可选择不同盘口风格,切换为机构风格时,可选择下单类型。
以股票交易为例:

盘口风格切换

机构风格时选择下单类型
使用机构风格时:
下单类型选用绝对数量,是指按照股票总量下单;
下单类型选用绝对金额时,根据输入金额总量和委托价计算买入数量,当计算出来的数量存在零股时,向下取整;
下单类型选用持仓数量比例时,根据当前账号下该合约的持仓和买入比例计算下单数量;
下单类型选用可用金额比例时,根据当前账号的可用金额和买入比例计算下单数量,当计算出来的数量存在零股时,向下取整;
下单类型选用总资产比例时,根据当前账号的总资产和买入比例计算下单数量,当计算出来的数量存在零股时,向下取整;
下单类型选用 [调整] 持仓数量时,按照输入的数量调整当前持仓的数量;
下单类型选用 [调整] 持仓市值占账号净资产比例时,按照账号净资产和输入的比例计算目标持仓市值,当计算出来的数量存在零股时,向下取整。
五档盘口清晰显示该合约的行情变动情况。
可使用快捷键下单,快捷键可查看系统设置 - 快捷键设置中进行设置。
下单时,有多个资金账号时,可选用不同的分单方式,包括平均分配、交易权重和可用比例。
平均分配:多账户平均分配。例如:下单 300 股,选中三个账户按平均分配,则为每个账户下单 100 股。
交易权重:多账户之间按设置的权重分配。例如:下单 300 股股票,选中 2 个账号按照交易权重分配,A 账号权重设为 2,B 账号权重设为 1,则 A 账户下单 200 股,B 账号下单 100 股。
可用比例:多账户之间按可用资金比例下单。例如:下单 1000 股股票,选中三个账号。A 账号可用资金 30 万,B 账户可用资金 60 万,C 账户可用资金 10 万,则按照 3:6:1 的比例下单,A 账户下单 300 股股票,B 账户下单 600 股股票,C 账户下单 100 股股票。
当系统支持 Level2 行情数据时下单面板支持切换五档或十档盘口展示模式。


买入界面
买入是对股票、债券、基金、存托凭证 CDR 等证券进行普通股票交易的买入操作,增加账号持仓量,减少可用资金。其中债券的最小交易单位为 10 的整数倍,采用 T+0 交易制度(当日买入,当日可卖出),股票的最小交易单位为 100 的整数倍,采用 T+1 交易制度,T 日买入,增加在途股份,T+1 日由在途转为可用,可以卖出。
卖出是对股票、债券、基金、存托凭证 CDR 等证券进行普通股票交易的卖出操作,减少账号持仓量,增加可用资金。

卖出界面
逆回购是指资金融入方将符合要求的债券申报质押,以相应折算率计算出的质押券价值为融资额度进行质押融资,交易双方约定在回购期满后返还资金同时解除债券质押的交易中的融出资金方。
逆回购交易通过“卖出”操作获取仓位,逆回购到期后,仓位自动清除,资金自动增加至可用资金中,次日可取。

逆回购操作界面
可转换债券是可转换 公司债券的简称,又简称 可转债,是一种可以在特定时间、按特定条件转换为对应公司 普通股票的特殊 企业债券。可转换 债券兼具 债权和期权的特征。公司发行的含有转换特征的债券,在招募说明中发行人承诺根据 转换价格在一定时间内可将债券转换为公司 普通股,转换特征为公司所 发行债券的一项义务。可转换债券的优点为具备普通股所不具备的固定收益和一般债券不具备的升值潜力。
对可转债在“买入面板”做买入、转股操作。

买入及转股操作
在“卖出面板”做卖出、回售操作。

卖出及回售操作
除股票买入/卖出界面外,融资融券 - 担保品买卖界面也支持可转债的买卖、
转股及回售交易,后续不再赘述。
当在下单面板中填入相应的转股代码后,单次转股申报时委托量不能超过可转债可用量,但同一交易日内可多次申报转股,在收市后合并计算转股数量。
可转债持有人申请转股的可转债数额大于实际拥有的可转债数额的,按其实际拥有的数额进行转股,申请剩余部分予以取消。
当转股操作执行后就会产生一条对应的转股委托,没有成交。转股申报当日可以撤单。

由于可转债买卖申报优于转股申报,当转股产生已报委托后,不会冻结持仓和可用资金。转股成功后的当天晚上 9 点以后或第二天早上,可转债相应的持仓消失,出现可转债的正股,相应正股持仓的可用持仓会增加转股成功的股数,并且股票第二天 (T+1 日) 就可卖出。转股不会影响资金变化。
若转股失败,可转债持仓不变,持正股数不变。
当在下单面板中卖出界面填入相应的回售代码后,回售申报时委托量不可超过可转债可用量。
当回售操作执行后,会产生一条对应的回售委托,没有成交。回售申报当日可以撤单,但申报一经确认,不得撤销。
可转债的买卖申报优于回售申报,当回售操作执行成功后,当日收市前可卖出。收市清算后可转债可用量减少,可用资金不变。回售申报期限一过,回售资金到账期,可用资金相应变化。
若回售失败,可转债持仓可用不变。

转股和回售仅支持普通交易,当选择其他交易方式时,会出现弹框提示,如下图所示:

系统支持新股申购和新债申购,用户根据交易所要求申购新股和债券。新股申购和新债申购的流程基本相同,以下以新股申购为例进行介绍。

新股申购和新债申购
新股申购:系统支持新股申购,用户根据交易所要求申购新股。
投资者参与网上公开发行股票的申购,只能使用一个证券账户。以同一证券账户多次参与同一只新股申购的,以第一笔申购为有效申购,其余申购均为无效申购。一经申报,不得撤单。

新股申购界面
查询当日新发行股票:
| 新股查询 | 额度查询 | 配号查询 | 中签查询 | 一键申购 | ||||
| 查询 | ||||||||
| 市场 | 代码 | 证券名 | 发行价 | 发行数量 | 最小申购数量 | 最大申购数量 | 申购日期 | |
| 1 | BJ | 889333 | 春光药装 | 10.00 | 1600 0000 | 100 | 76 0000 | 20221207 |
| 2 | SH | 787172 | 燕东申购 | 21.98 | 2518 1000 | 500 | 2 5000 | 20221207 |
| 2 合计 41181000 600 785000 |
查询资金账号可申购额度。
| 新股申购 | 新债申购 | ||
| 下单账号 | 1000000347 | 请输入股票代码 | |
| 申购代码 | |||
| 新股名称 | 卖 1 | ||
| 发行市场 | |||
| 发行价 | |||
| 发行数量 | 股 | ||
| 最大申购数量 | 股 | ||
| 最小申购数量 | 股 | ||
| 买 1 | |||
| - - | |||
额度查询界面
交易所以实际到位资金作为有效申购进行配号。配号公布后可在“配号查询”中查询。申购配号根据实际有效申购进行,每一有效申购单位配一个号,对所有有效申购单位按时间顺序连续配号。

配号查询界面
如果申购成功,可在“中签查询”中查询申购成功的股票信息。中签后,由柜台在缴款日自动扣款,请注意预留可用资金。
| 新股申购 | 新债申购 | |||||||||||||||
| 下单账号 | 1000000347 | 请输入股票代码 | ||||||||||||||
| 申购代码 | ||||||||||||||||
| 新股名称 | 卖 1 | |||||||||||||||
| 发行市场 | ||||||||||||||||
| 发行价 | ||||||||||||||||
| 发行数量 | 股 | |||||||||||||||
| 最大申购数量 | 股 | |||||||||||||||
| 最小申购数量 | 股 | |||||||||||||||
| - | - | |||||||||||||||
| 买 1 | ||||||||||||||||
中签查询界面
| 新股查询 | 额度查询 | 配号查询 | 中签查询 | 一键申购 | ||||||||
| 查询 | 一键申购 | |||||||||||
| 选择 | 资金账号 | 账号名称 | 市场 | 代码 | 证券名 | 发行价 | 发行数量 | 最小申购数量 | 最大申购数量 | 申购数量 | 申购日期 | |
| 1 | ✓ | 803020 | chenzhilin | SH | 787172 | 燕东申购 | 21.98 | 25181000 | 500 | 25000 | 25000 | 20221207 |
| 2 | ✓ | 803023 | chenzhilin | SH | 787172 | 燕东申购 | 21.98 | 25181000 | 500 | 25000 | 25000 | 20221207 |
| 2 | 合计 | 50362000 | 1000 | 50000 | 50000 |
| 下达任务 | ||||||||||||
| 证券公司 | 账号 | 市场 | 代码 | 股票名称 | 交易类型 | 分配量 | 最新市值 | 基准价 | 委托价 | 提示信息 | 触价价格 | |
| 1 | 迅投柜台模拟 | 803020 | SH | 787172 | 燕东申购 | 买入 | 25000 | 549500.000 | 21.980 | 21.980 | - | |
| 2 | 迅投柜台模拟 | 803023 | SH | 787172 | 燕东申购 | 买入 | 25000 | - | 21.980 | 21.980 | - | |
| 2 合计 | 50000 | 549500.000 |
一键申购界面
沪伦通业务是指上海证券交易所与伦敦证券交易所互联互通机制,符合条件的两地上市公司,依照对方市场的法律法规,发行存托凭证(DR)并在对方市场上市交易。存托凭证 (DR) 是指由存托人签发,以境外证券为基础在中国境内发行、代表境外基础证券权益的可转让凭证。
投资者使用 A 股证券账户参与沪伦通存托凭证 (CDR) 的认购与交易。沪伦通存托凭证业务上参照 A 股,资金均以人民币计价、交易日历按照 A 股安排、证券及资金账户均与投资者参与 A 股交易的做法一致。
迅投 QMT 极速策略交易系统沪伦通交易模块,实现了沪伦通行情显示、委托查询、成交查询、持仓查询、单笔委托、撤单等功能。

沪伦通交易面板
大宗交易是指达到规定的最低限额的证券单笔买卖申报,买卖双方经过协议达成一致并经过交易所确定成交的证券交易。
在股票交易模块,增加大宗交易面板,支持意向申报,成交申报,定价申报,盘后固定价申报。

需要在管理端系统设置和用户账号设置中开启允许使用大宗交易的权限,用户才可以在交易端看到此功能。


大宗交易客户意向报价发布,必须填写证券代码、买卖方向,联系方式、联系人,意向申报中是否明确交易价格和交易数量,由申报方决定。意向申报应当真实有效。申报方价格不明确的,视为至少愿以规定的最低价格买入或最高价格卖出;数量不明确的,视为至少愿以最低限额成交。意向申报指令可以撤销。意向申报要冻结资金/证券。

1、输入代码;自动查询代码相关行情;
2、选资金账号;
3、填写相关信息;
4、点击买入/卖出弹出确认面板;

5.核对相关信息无误后,点击确定生成指令发布意向。否则点击取消返回修改。
买卖双方达成协议后,提出成交申报,申报的交易价格和数量必须一致。必须填写证券代码、买卖方向,数量,价格。选填约定号、对手席位。

价格:
有价格涨跌幅限制证券的协议大宗交易的成交价格,在该证券当日涨跌幅限制价格范围内确定。
无价格涨跌幅限制证券的协议大宗交易的成交价格,在前收盘价的上下 30% 之间确定。
1、输入股票代码;自动查询代码相关行情;
2、选择资金账号
3、深圳大宗交易有两种下单方式
(1)点击成交(即与定价申报报对手交易),选择行情信息,自动填充相关信息。无需勾选配对成交

(2)配对成交,买卖双方线下协商后互报对手,手动输入买卖标的、方向、数量、对手席位,约定号相关信息自行报单。
进行深交所配对成交时需要勾选配对成交
4、上交所只有配对模式所以盘口输入上交所代码时无需显示配对成交勾选框
5、点击买入/卖出弹出确认面板。
6、核对信息填写无误,点击确定发布成交申报指令。否则点击取消返回修改。
深交所定价申报指令必须填写包括证券代码、买卖方向、价格、数量,联系方式、联系人。市场所有参与者可以提交成交申报,按指定的价格与定价申报全部或部分成交,深交所按时间优先顺序进行成交确认,会按指定的价格与定价申报全部或部分成交。定价申报的未成交部分可撤销,定价申报每笔成交的数量或交易金额,需要满足协议大宗交易最低额的要求。定价申报约定号由交易所自动生成,通过行情查看。
步骤与意向申报相同不再赘述

盘后定价大宗交易的申报指令必须填写证券代码、买卖方向、数量、价格类型等内容。

盘后定价大宗交易的价格类型包括:
(一)证券当日收盘价(上交所和深交所);
(二)证券当日成交量加权平均价格(仅深交所)。
盘口输入上交所代码时价格类型只能选择当日收盘价

输入证券代码,选择交易账号,选择价格类型。系统自动获取价格,计算市值。点击买入/卖出弹出确认面板。核对信息填写无误,点击确定发布盘后定价申报指令。否则点击取消返回修改。
输入代码后自动查询代码相关行情。

为了方便用户进行成交申报,在行情面板添加【转成交申报】功能。
(1)选择他人发布的申报信息;自动填充相应数量及价格。
(2)点击转成交申报按钮,在任意面板跳转到成交申报面板;自动将相关信息填充至成交申报面板。且买入/卖出按钮,根据报价方向自动变灰不可用,若用户修改了约定号或对方席位,则买入/卖出按钮,恢复颜色变为可用。

本系统支持科创板限价申报,市价申报,盘后定价申报多种报价方式。并支持科创板新股申购,科创板融资融券交易等科创板业务。

在股票交易 - 下单面板中输入科创板股票代码,选择指定价、对手价、挂单价、买卖 1-5 档,填写总量,即可限价申报科创板股票。

下达任务时 QMT 会对科创板价格笼子限制做出对应提示。
本系统支持科创板股票本方最优价、对手方最优价、最优五档即时成交剩余撤销申报、最优五档即时成交剩余转限价申报 4 种市价报单方式。

在股票交易 - 下单面板中输入科创板股票代码,选择上述市价报价方式并填写保护限价参数,此时委托价显示“市价”,填写总量,点击买入/卖出下单。
科创板股票支持盘后固定价格申报。
每个交易日的 9:30 至 11:30、13:30 至 15:30 均可进行盘后固定价格交易申报。
盘口输入科创板股票代码,报价方式“盘后定价”类型。
盘后申报时保护限价默认为收盘价,不可更改。

盘中申报时需要输入限价,“限价”参数可手动输入价格,所起作用如下:针对买入方向,若收盘价高于买入申报指令的限价,则该笔买入申报无效;针对卖出方向,若收盘价低于卖出申报指令的限价,则该笔卖出申报无效。
本系统支持创业板盘后固定价格交易。
| 选择 | 账号名称 | 可用资金 | 分配量 | 可卖量 | 权重 | |
|---|---|---|---|---|---|---|
| 1 | 0240125049 | 6786 0709.23 | 1000 | 0 | 1 | |
| 2 | chenrhilin | 96.00 | 0 | 0 | 1 | |
| 3 | chenzhilin | 100.00 | 0 | 0 | 1 | |
每个交易日的 9:30 至 11:30、13:00 至 15:00 均可进行盘后固定价格交易申报。连续竞价时间段(未产生收盘价之前),报价方式选择“盘后定价”。“限价”参数可手动输入价格,所起作用如下:
针对买入方向,若收盘价高于买入申报指令的限价,则该笔买入申报无效;
针对卖出方向,若收盘价低于卖出申报指令的限价,则该笔卖出申报无效。
点击买入按钮,下达任务,交易类型显示为“盘后定价买入”,委托价显示“盘后定价”,核对信息填写无误,点击确定发布盘后定价申报任务。
每个交易日的 15:05 到 15:30 为盘后固定价格交易时间。在此交易时段,盘口选择创业板代码时,交易状态显示为“盘后定价中”,限价置灰定位收盘价格,委托价位盘后定价。
股票交易中支持双向委托。点击左侧导航栏双向委托功能入口,打开如下界面。
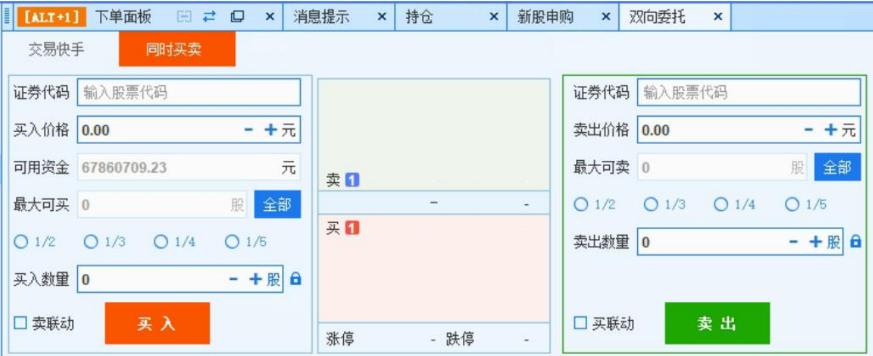 | |||||||||
| 同时买卖 □ 买卖代码联动 常用量设置 | |||||||||
| 选择 | 券商 | 资金账号 | 账号名称 | 总资产 | 可用资金 | 权重 | 分配量 | # | |
| 1 | ✓ | 海通证券 SPX 模拟 | 0240125049 | 0240125049 | 9944 7048.11 | 6786 0709.23 | 1 | 0 | |
| 2 | □ | 迅投柜台模拟 | 803020 | chenzhilin | 29 0555 0602.34 | 96.00 | 1 | 0 | |
| 3 | □ | 迅投柜台模拟 | 803023 | chenzhilin | 2 6960.00 | 100.00 | 1 | 0 | |
| 3 合计 | 30 0502 4610.45 | 6786 0905.23 | 0 |
如果勾选了卖联动,则买入面板中委托成交后,自动将成交数量填入卖出面板的委托数量框中。
如果勾选了买联动,则卖出面板中委托成交后,自动将成交数量填入买入面板的委托数量框中。
如果勾选了买卖代码联动后,当焦点在买入面板时,输入买入代码后,卖出面板自动填写对应码对应的卖出信息;当焦点在卖出面板时,输入卖出代码后,买入面板自动填写对应码对应的买入信息。
买入价格和卖出价格分别默认填充卖一价和买一价,默认填充价格可在快捷键中进行自定义。
同时,点击常用量设置,可直接打开设置面板。可以代码为维度,分别设置买入和卖出的默认量和价。
如果快捷键中设置的价格,与常用量价设置中某一代码的价格设置有冲突,则对该代码进行买卖时,按照常用量价中该代码的设置填充。即快捷键中设置的价格针对全局生效,常用量价中的价格针对特定代码生效。

还可在系统设置中设置指定价的默认填充价格。

输入框之间使用上下键切换,或使用回车键顺序切换,直至下单。顺序为代码 - 价格 - 数量 - 买入/卖出按钮。
光标在委托价格时默认选中小数点后全部位数。
根据买入成交情况,定位光标所在位置:
买入全部成交,则光标在卖出界面委托价格栏。
买入部分成交,则不管是否有撤单动作,光标都在卖出界面委托价格栏。
可进行实现双向委托快速交易,买联动/卖联动、买卖代码联动和常用设置功能和同时买卖功能一致,快手交易可以勾选卖出数量默认填充最大可卖的功能。

本系统支持配股配债交易。
除股票买入/卖出界面外,融资融券 - 担保品买卖界面也支持配股配债交易,后续不再赘述。
股票配股一般会发出公告在交易所网站,其中内容会有正股的代码和名称,同时会有配股截止日期、配股价格、配股比例、配股期限。同时会给出相应股票的配股代码。
本系统账号持仓中会有一条配股代码的持仓。
配股持仓中的可用数量就是这个账号可以配股的额度。这条持仓不算入总市值。此时的总资产和可用资金还是产生这条配股持仓之前的,没有发生变化。
当在下单面板中填入相应的配股代码后,下单面板会出现配股按钮。

点击配股按钮,会出现下达任务界面,点击确定。

当配股操作执行后就会产生一条对应的配股委托。委托量和委托价格分别是配股操作的配股数量和配股价格,如下图所示:
持仓
委托
[ALF-1]
下单面板
全部状态
全部来源
全选
反馈
选中撤单
全部撤单
撤买
撤卖
请输入代码
2
选择
资金账号
委托时间
证券代码
证券名称
买卖标记
委托量
委托剩余量
成交数量
委托状态
委托价格
成交均价
合同编号
投资备注
冻结金额
冻结手续费
撤单原因
订单编号
股东号
客户端委托编号
委托批号
1
2100000038
15:10:25
700958
东方证券
西张资信
100度
9度
100度
已成
8.460
8.4600
1000000103
0.00
0.00
940572674
2100000038
0
2100000038
14:12:27
600958
东方证券
最优五档弱或剩余额纳入
200度
9度
200度
已成
0.00
9.2000
1000000102
0.00
0.00
940572673
2100000038
配股产生已报委托后,本系统会出现冻结资金,冻结金额是配股数量*配股价格,可用资金会减少,减少部分就是冻结金额,持仓中这条配股持仓的可用数量会减少,冻结数量增加,持仓可用减少部分就是配股数量。配股操作不会对股票总市值产生影响,会减少总资产对应数量的冻结资金。
配股成功后,可用资金会减少,冻结资金清零。相应正股持仓的可用持仓会增加配股成功的股数,配股代码相应的持仓会消失。
如果交易所反馈配股失败,可用资金会恢复到配股之前,冻结资金恢复,且
相应配股持仓也会消失。持正股数不变。
同配股功能类似,在下单面板中填入相应的代码后,下单面板会出现配债按钮。在委托中可以查看配债的委托情况。配债成功后可在持仓中进行查看。
期货交易,是期货合约买卖交换的活动或行为。本系统支持普通期货交易、期货展期和期货套利交易方式。支持上期所(含原油期货)、中金所、郑商所、大商所、广期所所有期货品种交易。
普通交易支持投机、套利、套保的三种套利模式。下单面板有两种方式,分别为:迅投风格和传统风格。通过下单面板的按钮可以随时更换两个界面。

两种下单面板风格
迅投风格下单面板可以随意切换六键、四键、两键,可以使用普通交易和算法交易。关联多个账号可以根据分单方式确定每个账号的下单数量,展示账号关联的产品,可用资金、可开多、可开空、可平仓等,快速了解账号相关信息,方便交易。

下单面板各个功能键展开
传统风格下单面板有“开平”和“自动”、“跟盘价”和“指定价”按钮。其中通过点击投机可以切换不同的套利模式。“开平”相当于默认风格的四键,“自动”相当于默认风格的两键。“跟盘价”显示的是盘口的最新价,通过“+”、“-”按钮可以增加或者减少最小单位的价格,跟盘价会自动变成指定价。当持仓中有某一合约,点击合约下单面板会自动显示数量和可平仓的方向。

传统风格下单面板
国内商品期货不可以无限期持仓,每个合约都有一个期限,如果是自然人持仓到交割月前必须平仓。否则交易所会强平。展期可以将快到期限的近期合约仓位通过做多、做空的方式转换成远期合约,设置相应的下单参数、总量、单次量、间隔、价差等,就可以实现长时间推迟平仓。

期货展期界面
总量可以选择一定的手数(输入小于或等于持仓量),或者点击 切换总量为即将到期合约的持仓量(需注意的是进行展期交易时必须有该合约的持仓),单次量为一次平多(空)的数量,间隔为每次平多(空)的时间间隔,设置完后就会自动平仓,价差为两展期合约的价差,设置后下单,当价差达到设置的值时,触发报单。可以针对两个合约选择“做多”或“做空”。可以选择套保、套利、投机三种类型。
迅投 QMT 极速策略交易系统中的期货套利面板,仅为用户提供自定义规则的平台,用户可根据自己的交易要求,新建规则,从实现更换合约、跨期套利、跨市套利、跨品种套利等多种功能。

期货套利界面
具体规则要求如下:
①账号选择:在账号 1 和账号 2 处选择账户,账户选择无限制,可选相同账号也可选不同账号。
②合约选择:
合约中灰色背景色为 1 的表示优先合约,先产生优先合约的任务,当其成交后,才会产生灰色背景色显示为 2 的合约的任务;选择合约的下面显示的“多仓、空仓”是该账号当前该合约的多仓、空仓的持仓手数。

价差规则设置
价差规则设置中的倍数,价位(卖一价,最新价,买一价),价差方向(< >≤≥,无)都由用户自定义设置,设计出用户所需要的价差规则。当合约 1-合约 2 的差满足设置的价差规则,该项规则通过产生任务,否则就不产生任务;

选择合约委托量位置

选择合约 1 和 2 的下单参数

选择两个合约的开平方向
设置好价差规则后,可以设置合约 1、合约 2 的报价方式、合约 1 合约 2 的下单量及下单参数、开平及多空方向,基本设置中的单次量相当于目标量,总量是该合约的交易总量,合约参数中的单笔最大量是每次委托的最大委托量。

合约状态栏
显示合约 1、合约 2 在规则中设置的报价方式对应的价格,以及当前的价差,任务状态。
⑤统计:主要用于统计当前这笔单子合约 1、合约 2 的成交情况
⑥条件不符则放弃优先合约执行中的套利:勾选“条件不符则放弃优先合约执行中的套利”:优先合约在执行过程中,由于行情变动不满足之前设置的规则的话,就会撤销任务,在期货套利的状态中会显示成交了多少,失败了多少;
不勾选“条件不符则放弃优先合约执行中的套利”优先合约在执行过程中,由于行情变动不满足之前设置的规则的话,会继续执行,只有优先合约执行完了,才会执行另外一个合约,与某合约单次量的手数没有关系,单次量只是一种报单方式。
如果合约 1 为优先合约,单次量为 a,交易后剩余量为 a1,合约 2 的单次量为 b,交易后剩余量为 b1,那么合约最后一笔的执行量为:如果 a>a1,合约 1 执行 a1 手;如果 b<b1,那么合约 2 执行 b 手,合约 2 剩余的 b1-b 手合约不会被执行。
例如:如果合约 1 为优先合约,单次量为 10,交易后剩余量为 5,合约 2 的单次量为 20,交易后剩余量为 30,那么合约最后一笔的执行量为:合约 1 为 5 手,合约 2 为 20 手,合约 2 剩余的 10 手不会被执行。

套利过程
开始、暂停与停止:点击开始后会出现暂停和停止功能键,点击暂停按钮,暂停按钮会变成继续按钮的功能。
启用反向规则:类似于止盈止损功能,开多对应平多,开空对应平空;
新建规则、删除规则:删除规则必需先选中规则再删除;
自选合约:自选合约中选择套利合约,双击合约就会出现在期货套利列表中。

自选合约选择套利合约
融资融券交易,是指投资者向具有融资融券业务资格的证券公司提供担保物,借入资金或借入证券的行为。
本系统支持提供担保品买入、担保品卖出、融资买入,融券卖出,买券还券、卖券还款、直接还券,直接还款、融券息费,担保品划转等业务。
买入、卖出界面主要用于信用账号操作担保券的买卖,同交易所的普通证券的买卖操作基本类似,只不过此处只能买卖担保券范围内的证券,而且占用的是信用账号上的可用资金。

担保品买入

担保品卖出
标的担保界面显示融券标的、融资标的、担保品。
| 信用账户持仓 | 成交 | 委托 | 负债合约 | 任务列表 | 标的担保 | 融券可融数量 | 银证转账 | |||
| 刷新 | 融资标的 ○ 融券标的 ○ 担保品 | |||||||||
| 证券公司 | 资金账号 | 账号名称 | 账号类型 | 账号是否启用 | 账号备注 | 市场 | 证券代码 | 融资状态 | 融资保证金比例 | |
| 1 | 中金财富 cos 股票高性能实盘 | 94697086 | 十三号 | 主账号 | 是 | ozl 投资者 02 | SZ | 002690 | 正常 | 1.000 |
| 2 | 中金财富 cos 股票高性能实盘 | 94697086 | 十三号 | 主账号 | 是 | ozl 投资者 02 | SZ | 300916 | 正常 | 1.500 |
| 3 | 中金财富 cos 股票高性能实盘 | 94697086 | 十三号 | 主账号 | 是 | ozl 投资者 02 | SH | 688626 | 正常 | 1.500 |
| 4 | 中金财富 cos 股票高性能实盘 | 94697086 | 十三号 | 主账号 | 是 | ozl 投资者 02 | SZ | 300962 | 正常 | 1.500 |
| 5 | 中金财富 cos 股票高性能实盘 | 94697086 | 十三号 | 主账号 | 是 | ozl 投资者 02 | SH | 601918 | 正常 | 1.000 |
| 6 | 中金财富 cos 股票高性能实盘 | 94697086 | 十三号 | 主账号 | 是 | ozl 投资者 02 | SZ | 300054 | 正常 | 1.000 |
| 7 | 中金财富 cos 股票高性能实盘 | 94697086 | 十三号 | 主账号 | 是 | ozl 投资者 02 | SH | 600229 | 正常 | 1.000 |
| 8 | 中金财富 cos 股票高性能实盘 | 94697086 | 十三号 | 主账号 | 是 | ozl 投资者 02 | SZ | 300020 | 正常 | 1.000 |
标的担保
担保券买入时,信用账号持仓增加,担保券卖出时,信用账号持仓减少。
融资融券包括融资买入,融券卖出,买券还券、卖券还款、直接还券,直接还款、融券息费的交易方式,融资流程主要包括融资买入,卖券还款,直接还款,融券流程主要包括融券卖出,买券还券,直接还券。
1 融资买入是指投资者向证券公司交纳一定的保证金,融入一定数量的资金买入股票的交易行为。融资买入后,信用账号负债增加,证券持仓增加。

融资买入
2 融券卖出是指,投资者向证券公司交纳一定的保证金,融入一定数量的股票进行卖出的交易行为。融券卖出后,信用账号负债增加,资金增加。

融券卖出
③买券还券偿还融入证券,投资者通过其信用资金账号买入证券,结算时买入的证券直接划转至券商的融券信用账号。买券还券后,信用账号负债减少,信用账户持仓不变。

买券还券
④卖券还款是指,投资者通过其信用资金账号进行证券卖出,结算时该资金直接划转至证券公司融资专用信用账号的一种还款方式。卖券还款后,信用账号负债减少,证券持仓减少。

卖券还款
⑤直接还券使用的是信用账户中的券,这个券可以是从普通账户转入的担保品,也可以是用信用账户买入的证券。直接还券后,信用账户负债减少。

直接还券
⑥直接还款是指,投资者在信用资金账户内存入资金的方式偿还融资债务。
直接还款后,信用账户负债减少。

直接还款
⑦融券息费是指,投资者通过信用资金账户的资金偿还融券负债的利息和费用,融券息费后,信用账户负债减少。

融券息费
担保券划转界面的界面主要用于将普通账号与信用账号的股票仓位进行划转操作。
1 担保品划入是将普通账户中的股票划转到信用账户中,普通账户持仓减少,信用账户持仓增加。

点击担保品划入时,系统自动展示普通账户持仓。
2 担保品划出是将信用账户中的股票划转到普通账户中,普通账户持仓增加,信用账户持仓减少。

点击担保品划出时,系统自动展示信用持仓。
3 一键划入是将普通账户中的股票批量划转到信用账户中,普通账户持仓减少,信用账户持仓增加。一键划入时,选择账号信息后,可在账号下方的表中勾选需要划转的持仓。

4 一键划出是将信用账户中的股票批量划转到普通账户中,普通账户持仓增加,
信用账户持仓减少。一键划出时,选择账号信息后,可在账号下方的表中勾选需要划转的持仓。

支持两融查询模式。
查询模式开启后,下单盘口增加最大可下单量查询,在盘口输入代码之后查询最大可下单量:

显示综合信息查询面板:
| 添加账号 | 自动还款 | 94697086 十三号 | 刷新 | ||||
| 总资产 | 2 0623 3187.74 | 登录状态 | 登录成功 | 总负债 | 268 6534.04 | 维持担保比例 | 7676.55% |
| 净资产 | 2 0354 6653.70 | 可用资金 | 9663 6322.01 | 融资负债 | 268 6534.04 | 预计维持担保比例 | 100.00% |
| 证券市值 | 1 0959 6865.73 | 融券卖出资金 | 0.00 | 融资预计利息 | 268 6534.04 | 可用保证金 | 1 6790 4341.64 |
| 股票市值 | 3750 8057.02 | 融券卖出可用资金 | 0.00 | 融券负债 | 0.00 | 授信总额度 | 4 8000 0000.00 |
| 基金市值 | 1 7559 1105.80 | 融券卖出占用资金 | 0.00 | 融券预计利息 | 0.00 | 当前剩余额度 | 180 0000.00 |
| 其他费用 | 0.00 |
负债明细分页查询:
| 信用账户持仓 | 成交 | 委托 | 负债合约 | 任务列表 | 标的担保 | 融券可融数量 | 银证转账 | 普通账户持仓 | |||
| 刷新 | 未了结合约○已了结合约○未了结合约统计 | 94697086 十三号 | 选中申请展期 | ||||||||
| 选择 | 证券公司 | 资金账号 | 账号名称 | 账号类型 | 账号是否启用 | 账号备注 | 市场 | 证券代码 | 合约类型 | ||
两融支持双向委托功能。
使用管理端“允许使用双向委托交易”功能权限进行控制。
委托类型可选:融资买入 - 融券卖出,融资买入 - 卖券还款,买券还券 - 融券卖出,担保品买入 - 担保品卖出,融资买入 - 担保品卖出。

下单面板输入框光标切换,输入框之间使用上下键切换,或使用回车键顺序切换,直至下单。顺序为代码 - 价格 - 数量 - 买入/卖出按钮。
买卖代码联动,首次安装,是默认勾选状态;如果不是第一次安装打开系统,记录上次关闭时的状态。
如果勾选了买卖代码联动后,当焦点在买入面板时,输入买入代码后,卖出面板自动填写对应的代码;当焦点在卖出面板时,输入卖出代码后,买入面板自动填写对应的代码。
如果勾选了卖联动,则买入面板中委托成交后,自动将成交数量填入卖出面板的委托数量框中。
如果勾选了买联动,则卖出面板中委托成交后,自动将成交数量填入买入面板的委托数量框中。
买入价格和卖出价格分别默认填充卖一价和买一价,默认填充价格可在快捷键中进行自定义。

同时,点击常用量设置,可直接打开设置面板。可以代码为维度,分别设置买入和卖出的默认量和价。下单面板输入设置的代码后,价格和数量按照设定的值显示。
如果快捷键中设置的价格,与常用量价设置中某一代码的价格设置有冲突,则对该代码进行买卖时,按照常用量价中该代码的设置填充。即快捷键中设置的价格针对全局生效,常用量价中的价格针对特定代码生效。

还可在系统设置中设置指定价的默认填充价格,优先级比快捷键和常用量设置低。

在系统设置 - 快捷键设置 - 融资融券中,启用融资融券快捷键功能,可对双向委托功能自定义设置快捷键,可设置快捷键包括:双向交易切换买入、双向交易切换卖出、双向交易按照当前参数快速“买入”、双向交易按照当前参数快速“卖出”、双向交易按照价格变动单位增加委托价、双向交易按照价格变动单位减少委托价、双向交易委托价变动单位、双向交易按照单位“百 增加”总量、双向交易按照单位“百 减少”总量。
双向交易切换买入:可同时设定委托价格类型和快捷键,证券代码为空时焦点在证券代码,证券代码不为空时焦点在买入价格。
双向交易切换卖出:可同时设定委托价格类型和快捷键,证券代码为空时焦
点在证券代码,证券代码不为空时焦点在卖出价格。
双向交易按照当前参数快速“买入”:点击快捷键后可以按照当前设置的参数进行下单操作。
双向交易按照当前参数快速“卖出”:点击快捷键后可以按照当前设置的参数进行下单操作。
双向交易按照价格变动单位增加委托价:点击快捷键后按照变动单位增加委托价。
双向交易按照价格变动单位减少委托价:点击快捷键后按照变动单位减少委托价。
双向交易委托价变动单位:设置委托价变动单位。
双向交易按照单位“百 增加”总量:点击快捷键后增加总量,每次增加 100。双向交易按照单位“百 减少”总量:点击快捷键后减少总量,每次减少 100。

可在全局设置中,对切入委托面板、切入任务列表、切入成交界面、切入持仓界面、切入资金账户面板、全部撤单、撤买、撤卖、撤最后一笔等操作进行自定义设置。

组合交易,也叫篮子交易,是指同时完成一个股票或期货组合的交易,而不是对组合中的股票或期货单独进行交易,还具有自动套利、对冲的功能,通过预设条件,自动判断并执行套利、对冲。
篮子管理界面分为左右两部分。左半部分显示篮子分类:股票篮子、期货篮子、沪伦通篮子、沪港通篮子、深港通篮子。它们下面分别可新增、导入、删除多个同类型篮子。界面右半部分显示某一篮子内期货或股票的的具体信息,包括代码、名称、数量、相对权重、绝对权重、昨收、涨停、跌停、方向。同时可以导入、导出、删除。
| 下单面板 | |||||||||||||
| 委托 | |||||||||||||
| × | 成交 | × | 消息提示 | × | 篮子管理 | × | 持仓 | × | 组合任务 | × | |||
| 股票篮子 | + | C | 窗 | ||||||||||
| 期货篮子 | + | C | 窗 | ||||||||||
| 沪伦通篮子 | + | C | 窗 | ||||||||||
| 沪港通篮子 | + | C | 窗 | ||||||||||
| 苯港通篮子 | + | C | 窗 | ||||||||||
篮子管理界面
合法的篮子导入格式有为迅投默认格式。在 excel 表格中新建篮子时,要将每种格式下的条目填充完整,并保存为.csv 格式。

合法导入格式
若导入的篮子与已存在的篮子重名,将会提示:

篮子重名提示
导出篮子时需要选择导出的格式,导出到电脑中即可随时查看篮子里的合约内容。

迅投默认格式的篮子
删除整个篮子可以在篮子管理界面左侧点击“x”或删除按钮。
| 股票篮子 | + | C | 值 | 输入合约代码 | + | 导入篮子 | ? | 导出篮子 | 删除 | |||
| 666 | × | 代码 | 名称 | 数量 | 相对权重 | 绝对权重 | 昨收 | 涨停 | 跌停 | 方向 | ||
| 新建篮子 | × | |||||||||||
| 触价篮子格式 | × | |||||||||||
| 默认篮子格式 | × | |||||||||||
| 期货篮子 | + | C | 值 | |||||||||
| 新建篮子 1 | × | |||||||||||
| 沪伦通篮子 | + | C | 值 | |||||||||
| 沪港通篮子 | + | C | 值 | |||||||||
| 深港通篮子 | + | C | 值 |
删除篮子按钮
删除篮子中的某条合约可以选中合约,点击如图中的“删除”按钮。
| 股票篮子 | + | C | 窗 | T2306 | 十年国债 2306 | + | 导入篮子 | ? | 导出篮子 | 删除 | ||||
| 666 | × | |||||||||||||
| 新建篮子 | × | |||||||||||||
| 触价篮子格式 | × | |||||||||||||
| 默认篮子格式 | × | |||||||||||||
| 期货篮子 | + | C | 窗 | |||||||||||
| 新建篮子 1 | × | |||||||||||||
| 沪伦通篮子 | + | C | 窗 | |||||||||||
| 沪港通篮子 | + | C | 窗 | |||||||||||
| 深港通篮子 | + | C | 窗 |
删除合约
买入交易面板可以对股票债券进行买入下单,交易参数有普通交易、算法交易、智能算法三种,可以用多个账号对多个股票债券合约进行买入,买入交易方式有“按组合股票数量”、“按组合股票权重”、“按账户可用”、“按总资产比例”。
在下单面板中还添加了全选、反选按钮,快速选择全部标的或者部分标的。

按组合股票数量:篮子中每支股票的分配量=一份篮子中每支股票的分配量*篮子份数。
按组合股票权重:自定义输入金额,系统就会根据篮子管理中每只合约权重分配,分配量=总金额*(某支股票相对权重/相对权重合计)/最新价。
按账户可用:自定义输入比例,系统就会根据篮子管理中每只合约权重分配,分配量=可用资金*比例*(某只股票相对权重/相对权重合计)/最新价。
按总资产比例:自定义输入比例,系统就会根据篮子管理中每只合约权重分配,分配量=总资产*比例*(某只股票相对权重/相对权重合计)/最新价。
系统默认支持账户可用持仓篮子和账户持仓篮子。选择账户可用持仓时,会将所选账户的可用持仓显示在左侧下单板内,下单量为持仓可用数量;选择账户持仓时,会将所选账户的持仓显示在左侧下单板内,下单量为持仓量。

卖出交易界面功能和买入交易类似,可以多个账号对多个股票债券合约进行卖出。

卖出界面
一键买卖是指进行组合交易时针对单个的证券账号对篮子中的股票同时进行买入和卖出的交易。

一键买卖界面
交易类型:可以通过在交易类型字段下选择买入或卖出,便捷决定买卖方向。
组合交易设置:一键买卖需在组合交易设置中分别设置买入证券和卖出证券的下单参数。
账号选择:一键买卖只能选择一个账号。
一键买卖包括买入和卖出两个过程,如无持仓卖出指令不发出,但买入指令
照常发出。因为一键买卖涉及卖出过程,所以经常配合调仓功能使用。
如选择信用账号,会出现使用融资买入的选项,不勾选默认担保品买卖,若勾选,买入部分按照融资买入。

信用交易界面可以进行融券买入、融券卖出、还券和还款等操作,报价方式为普通交易、算法交易和智能算法。需选择篮子和交易总量分配方式,并可启动套利。

信用交易
期货交易面板可以对期货篮子进行买入下单,并可以在组合交易设置中选择开仓和平仓;交易方式有“按组合股票数量”和“按组合股票权重”。
在期货交易下单面板选择“篮子管理” - “期货篮子”中创建的篮子;
选择交易总量并设置参数;
选择组合交易设置中的“开多”、“开空”、“平多”或“平空”,此时篮子中的期货代码交易类型调整为当前所选的类型;
选择交易算法并设置交易参数;
选择交易账号,点击下单按钮。

期货交易
一键期货是指进行组合交易时针对单个的期货账号对篮子中的期货同时进行买入和卖出的交易。
下单板设置中有投机、套利、套保三种套利模式供选择。

套利模式选择
下单面板中单击“交易类型”就可切换买卖方向,系统会根据账号持仓来显
示可平或可开的数量。

切换买卖方向
在组合交易 - 港股通界面中,可实现对港股的组合买入、卖出交易。交易参数可设置为普通交易和算法交易等。

港股通界面
选择在交易端篮子管理中创建或导入的沪港通或深港通篮子,买入交易方式有“按组合港股通数量”和“按组合港股通权重”两种。

交易总量分配方式
按组合港股通数量:篮子中每支港股的分配量=一份篮子中每支港股的分配量*篮子份数
按组合港股通权重:自定义输入金额,系统就会根据篮子管理中每只合约权重分配,分配量=总金额*(某支港股的相对权重/相对权重合计)/最新价。
调仓是指大盘在调整时,将自己手中所持有的股票进行仓位调整和股票品种的及时更换,将手中股票的现有持仓调整到目标持仓中的股票。

买量:0 买额:0.00 卖里:5291415 卖额:2 1309 8700.82
调仓界面
以股票交易调仓为例:
在“一键买卖”中点击调仓按钮,打开调仓面板,如下图所示。

调仓面板左侧列出所有账号,点击其中一个账号,在当前持仓位置显示该账号下的所有持仓;在目标持仓位置,选择已创建的目标篮子,选择后将在下方显示篮子中的股票代码信息,设置完交易总量后,点击确定,即可保存调仓设置,同时下单面板中显示调仓的股票代码并自动计算其交易类型。
| 选择 | 账号 | 市场 | 代码 | 股票名称 | 交易类型 | 分配量 | 可用量 | 最新价 | 涨跌幅 | |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | ✓ | 6000000500 | SH | 010609 | 06 国债 (9) | 买入 | 100 | 4997100 | 100.00 | 0.00% |
| 2 | ✓ | 6000000500 | SH | 010616 | 06 国债 (6) | 买入 | 100 | 4533750 | 110.22 | 0.00% |
| 3 | ✓ | 6000000500 | SZ | 101007 | 国债 1007 | 买入 | 100 | 4968280 | 100.58 | 0.00% |
| 4 | ✓ | 6000000500 | SZ | 000001 | 平安银行 | 卖出 | 900 | 900 | 9.47 | -0.32% |
| 5 | ✓ | 6000000500 | SZ | 000008 | 神州高铁 | 卖出 | 100 | 100 | 9.60 | -0.41% |
| 6 | ✓ | 6000000500 | SZ | 000009 | 中国宝安 | 卖出 | 100 | 100 | 11.93 | 8.36% |
| 7 | ✓ | 6000000500 | SZ | 000010 | 美丽生态 | 卖出 | 100 | 100 | 7.70 | -0.77% |
1.调仓中只有按股票数量和按股票权重两种方式可选。
2.调仓设置保存后,调仓按钮置灰。选择篮子处显示“调仓组合”,交易总量默认为调仓面板中目标篮子选择的交易总量,如下图所示。

3.设置交易算法并设置交易参数;
4.选择交易账号,点击“下单”,即可将当前持仓中的股票卖出,买入目标持仓的股票。
全选:点击,面板中所有的标的均选中;
反选:点击,面板中未选中的标的均选中;
过滤停盘股:勾选过滤停盘股,取消勾选下单面板中显示停盘的股票;
过滤涨停股:勾选过滤涨停股,取消勾选下单面板中显示涨停的股票;
过滤跌停股:勾选过滤涨停股,取消勾选下单面板中显示跌停的股票;
过滤反向股:勾选过滤反向股,取消勾选下单面板中存在反向的股票;
过滤非股票:勾选过滤非股票,取消勾选下单面板中股票之外的证券;
替换停盘股:若所选篮子中的股票存在停盘股,在交易时可以用其他篮子中的股票替换停盘股,停盘股会被新篮子中的股票按比例替代;
下单面板
期现套利是指某种期货合约,当期货市场与现货市场在价格上出现差距,从而利用两个市场的价格差距,低买高卖而获利。股票现货市场和股指期货市场紧密相连,实际行情中,期货指数价格常受多种因素影响而偏离其合理的理论价格,与现货指数之间的价格差距往往出现过大或过小的情况,一旦这种偏离出现,就会带来在期货市场和现货市场之间套利的机会,我们把这种跨越期市和现市同时进行交易的操作称之为期现套利,也叫指数套利。
点击,可用进行下单类型的选择,包括投机、套利、套保,还可以进行套利算法交易的设置,其设置方式与盘口的算法交易相同。

点击套利账号请选择账号 可选择将要进行套利的期货账号。4.套利合约选择。点击 可选择将要进行套利的期货合约。
点击 选择设置套利方式,设置套利方式相关的参数和套利算法。套利方式包括手动套利和自动套利,自动套利包括按合约价值套利、按固定金额套利和按固定手数套利。自动套利能够实时监测证券和期货两个市场的数据,通过预设条件,自动判断并执行套利、对冲。

①按合约价值套利是自动套利,指按照篮子中买入的现货价格和期货合约价格自动计算出需要开空的期货手数进行期现套利下单。同时,可以设定套利比例,套利比例是指买入的现货和卖出的期货之间的比例(套利比例设定为 20% 时是指买入 100 元现货的时候需要卖出 20 元期货)。
②按固定金额套利是自动套利,指按照用户设定的固定金额,现货交易每达到一次这个金额就自动开空一手期货的期现交易方法。比如说用户设定 1000 元的固定金额套利,当用户购买股票的价格为 2 万元时,就会开空 20000/1000=20手的期货。
③按固定手数套利是自动套利,指用户设定套利的固定手数后,在买入现货的同时,自动卖出设定的手数的期货。(当现货部分成交时,会根据成交的比例来开空同样比例的期货)。
点击套利比例输入框 输入套利比例,套利比例用于计算单次套利期货手数,可输入 1-200 的整数。具体计算公式详见帮助。

点击套利时机,显示现货优先和期货优先两个选项 期货优先可通过点击进行套利时机的选择。套利时机用于控制对冲期货的时机。
①现货优先:现货优先成交到套利时期再去对冲期货,对冲期间现货不暂停交易,继续成交到下一次套利时机时再次对冲期货,以此类推直至交易结束;
②期货优先:首次期货与现货同时报单,保证先对冲一次期货,待现货成交到套利时机再去对冲一次期货,以此类推直至交易结束。
备注:
(1)无论是期货优先还是现货优先,现货报单不受期货成交限制。
(2)优先比例设置 :点击 进行优先比例的设置。优先比例用于计算单次套利期货的手数,可输入 1-100 的整数。
(3)对上述参数设置好后,点击下单即可下达期现套利指令。其中手动
套利需手动到期货交易类型中进下单,自动套利自动进行期货的报单。
(4)点击 查看期现套利的功能说明及参数设置提示。
期权是交易双方关于未来买卖权利达成的合约,就股票期权来说,期权的买方(权利方)通过向卖方(义务方)支付一定的费用(权利金),获得一种权利,即有权在约定的时间以约定的价格向期权卖方买入或卖出约定数量的特定股票或 ETF。当然,买方(权利方)也可以选择放弃行使权利。如果买方决定行使权利,卖方就有义务配合。
本系统支持期权业务相关买卖、行权、锁定、策略四类交易方式,报价方式上支持交易所各类限价及市价报价方式,根据合约类型不同分为认沽和认购:认购是看涨的合约,认沽是看跌的合约。另外还可设置股票期权账号的风控,既响应了证监会有关股票期权风险控制制度,还可分散、降低股票期权投资的风险。
买卖面板中有买入开仓、卖出平仓、卖出开仓、卖出平仓、备兑卖出开仓、备兑买入平仓操作。买入开仓和卖出平仓、卖出开仓和买入平仓都是一对操作。
①买入开仓是买入认购期权或认沽期权,如投资者已作为权利方持有仓位时,则买入成交后,增加权利方持有仓位。

买入开仓
②卖出平仓是卖出认购期权或认沽期权,投资者作为权利方持有权利仓时才可卖出平仓,且卖出合约数量不得超过持有的仓位。

卖出平仓
③卖出开仓是投资者卖出认购期权或认沽期权,如投资者已作为义务方持有仓位时,则卖出成交后,增加义务方持有仓位。

卖出开仓
④买入平仓是投资者作为义务方持有仓位(不含备兑开仓持仓),买入期权,减少持有义务仓位。

买入平仓
⑤备兑卖出开仓是投资者在拥有标的证券(含当日买入)的基础上,卖出相
应的认购期权(百分之百现券担保,不需现金保证金)。目前根据交易所的规定,上交所需要手动进行标的证券的锁定及解锁,深交所支持自动锁定及解锁。

备兑卖出开仓
⑥备兑买入平仓是买回期权,并解除备兑保证证券的冻结。

备兑买入平仓
| 买入开仓 | 卖出平仓 | 卖出开仓 | 买入平仓 | 卖出开仓备兑 | 买入平仓备兑 | |
|---|---|---|---|---|---|---|
| 资金 | 冻结资金和手续费 | - | 冻结保证金和手续费 | 冻结资金和手续费 | - | 冻结资金和手续费 |
| 持仓 | - | 冻结持仓 | - | 冻结持仓 | - | 冻结持仓 |
成交后:
| 买入开仓 | 卖出平仓 | 卖出开仓 | 买入平仓 | 卖出开仓 | 买入平仓 | |
|---|---|---|---|---|---|---|
| 备兑 | 备兑 | |||||
| 资金 | 可用减少 | 可用资金增加 | 保证金增加 | 可用增加和保证金减少 | 可用增加 | 可用减少 |
| 持仓 | 增加权利持仓 | 权利持仓减少 | 增加义务持仓 | 减少义务持仓 | 增加备兑持仓 | 减少备兑持仓 |
针对期权义务方到期行权。有认沽行权和认购行权两种操作,此次交易所推出了组合行权操作,支持一组期权的同时行权。

单独行权
符合交易所规定的一组期权可以在到期日进行组合行权申报,合约 1 为持仓中符合行权条件的期权,合约 2 根据交易所组合行权规则自动筛选出与之匹配的期权合约。

组合行权
买方可以认购行权:准备现金,买入股票。认沽行权:准备股票,收入现金。
卖方可以认购空头被行权:准备股票,收入现金。认沽空头被行权:准备现金,买入股票。
在交易时段,投资者可以将持有的证券(含当日买入,仅限标的证券)作为备兑开仓的保证金。可以在备兑持仓中查看标的证券的相关信息。
①锁定:对投资者现券账户的标的证券未锁定量进行锁定,变成锁定量的操作。

锁定
②解锁:对投资者现券账户的标的证券进行相应解锁操作。

解锁
期权组合策略为交易所推出的新功能,支持投资者将持仓中的期权按照一定的原则进行配对构建组合以及进行组合的解除,期权组合策略能够有效节约资金,提到资金利用率水平,方便持仓管理的目的,目前支持交易所推出的各类期
权组合策略的构建。

策略构建
对于构建好的期权组合策略,在组合策略持仓面板中可以看到策略的具体合约构成,并且能够进行对应策略的解除操作:
| 组合策略持仓 | |||||||||
| 组合策略持仓 | |||||||||
| 解除 | 请输入组合号码 | ||||||||
| 选择 | 证券公司 | 资金账号 | 账号名称 | 账号类型 | 账号是否启用 | 账号备注 | 市场名称 | 合约账户 | |
策略持仓及解除面板
通过操作 - 查看 - 策略组合路径可打开股票期权策略组合功能和招招赢功能。

查看中可调出策略组合
策略组合面板左侧为自选组合名称,中部为选择的合约组合信息,并且可设置方向、权重、数量等相关参数。右侧为期权损益图。

策略组合
点击左侧自选组合后加号,新建自选组合的子菜单。如下图所示。双击子菜单名称可进行重命名。中间下拉列表可添加选择的标的期权合约。

自选策略
勾选合约,右侧出现对应的期权损益图。勾选单支合约为单支合约损益图,勾选多支合约为多支合约叠加损益图。


损益图
双击中部字段相对权重、数量,可修改字段数值。点击方向中买入/卖出按钮可进行互相切换。
在组合策略中支持“招招赢”功能,功能界面如下所示:主要分为行情区域、方案及下单区域、损益分析区域三大块。
行情区域中可以拖拉添加未来预测区域,以及标的预测点位;
方案及下单区域可以匹配筛选出符合预测要求的股票期权;
损益分析区域展示各个方案下的到期日、最大盈利、盈利区间、最大亏损、亏损区间、权利金净值及收益图展示;
整体效果如下所示:

选择期权标的,涨跌预测方向后,行情展示区域显示对应期权标的实时日 K 图,期权标的可供选择的有:SH510050、SH510300、SH510500、SZ159915、SZ1 59919、SZ159922,选好之后行情里可以定位相关期权标的的日 k 线行情。涨跌预测方向有:看涨、看跌、突破、盘整。
红绿区间规律如下,红绿分界线为下文将提到的盈亏平衡线:

k 线图中拖动范围及参数:
横向区间范围:日 k 线图中,横向可以拖动范围为当前交易日到该标的下所有挂牌期权的最大到期日,在此区间范围可以拖动,对应标的期权的未来每个交易日均用黄虚竖线标出

纵向区间范围:日 k 线图中,箭头符号纵向可以拖动范围为:选中的该标的下所有看涨、看跌期权中最高、最低行权价
k 线图中的文字描述以及筛选出来的合约原则:需要根据选择的预测方向展开描述,不同预测方向,文字内容不同,各种情况规律如下:
看涨:如下图所示,箭头处方向向上“ ”,箭头处文字为
您预期上证 50ETF 在 2021 年 06 月 23 日到期之前会涨到 3.53 以上,下面方案区根据您的预期优选了部分能够获利的合约策略您可以拖动”↑“来更改您的预期
其中“2021 年 6 月 23 日”为所选区间内最远到期日,“3.53”为箭头处对应的标的物价格,即投资者未来预测价格。用一条横实线标出。
筛选出来的合约为标的物行权价在 3.53 以下的认购期权,买卖方向为买入方。
点击筛选出来的合约,根据当前最新价格,算出盈亏平衡点,例如选定合约为 50ETF 购 12 月 3400,最新价为 0.0889,行权价格为 3.4,则盈亏平衡点为:3.4+0.0889=3.4889,提示“买入该合约后,若标的价格在 3.4889 以上,就实现盈利”
3.53 处的横实线我们可以称之为预期点位线,3.489 处的横线我们可以称之为盈亏平衡线,用以分割红、绿区间。

看跌:如下图所示,箭头处方向向下“ ”,箭头处文字为
您预期上证 50ETF 在 2021 年 06 月 23 日到期之前会跌到 3.13 以下,下面方案区根据您的预期优选了部分能够获利的合约策略您可以拖动”↓“来更改您的预期
其中“2021 年 6 月 23 日”为所选区间内最远到期日,“3.13”为箭头处对应的标的物价格,即投资者未来预测价格,用一条横实线标出。
筛选出来的合约为到期日内标的物行权价在 3.13 以上的认沽期权,买卖方向为买入方。
点击筛选出来的合约,根据当前最新价格,算出盈亏平衡点,例如选定合约为 50ETF 沽 12 月 4000,最新价为 0.5120,行权价格为 4.000,则盈亏平衡点为:4.000-0.5120=3.488,提示“买入该合约后,若标的价格在 3.488 以下,就实现盈利”
3.13 处的横实线我们可以称之为预期点位线,3.488 处的横线我们可以称之为盈亏平衡线,用以分割红、绿区间。

突破:如下图所示,上方的箭头方向向上“ ”,下方的箭头方向向下“ ”,上方箭头处文字为:

其中“2021 年 6 月 23 日”为所选区间内最远到期日,“2.99、3.73”为箭头处对应的标的物价格。分别用两条横实线标出。
筛选出来的合约为到期日内标的物行权价在 3.73 及以上的认购期权、2.99 及以下的认沽期权的一一组合,买卖方向为均为买入方。
点击筛选出来的合约,根据当前最新价格,算出盈亏平衡点,例如选定合约为 50ETF 沽 12 月 2563A,最新价为 0.0002,行权价 2.563、50ETF 购 12 月 3746 A,最新价为 0.0006,行权价格为 3.746,则盈亏平衡点分别为:2.563-0.0002 -0.0006=2.5622,3.746+0.0006+0.0002=3.7468,提示“买入该组合后,若标的价格在 2.562 以下或 3.747 以上,就实现盈利”
2.99、3.73 处的横线我们可以称之为预期点位线,2.562、3.747 处的横线我们可以称之为盈亏平衡线,用以分割红、绿区间。

上方箭头处文字为:

其中“2021 年 6 月 23 日”为所选区间内最远到期日,“3.73、2.99”为箭头处对应的标的物价格。分别用两条横实线标出。
筛选出来的合约为到期日内标的物行权价在 2.99 及以下的认沽期权、3.73 及以上的认购期权的一一组合,买卖方向为均为卖出方。
点击筛选出来的合约,根据当前最新价格,算出盈亏平衡点,例如选定合约为 50ETF 沽 12 月 2563A,最新价为 0.0004,行权价 2.563、50ETF 购 12 月 3746 A,最新价为 0.0005,行权价格为 3.746,则盈亏平衡点分别为:2.563-0.0004 -0.0005=2.5621,3.746+0.0005+0.0004=3.7469,提示“卖出该组合后,若标的价格在 2.562 与 3.747 之间,就实现盈利”
2.99、3.73 处的横线我们可以称之为预期点位线,2.562、3.747 处的横线我们可以称之为盈亏平衡线,用以分割红、绿区间。

选定期权标的,涨跌预测方向,预测未来标的价格,筛选出符合标准的期权合约,如下所示:看跌、看涨时候,选择都是单个期权;盘整、突破时候,选择的是两个期权的组合。

合约中相关的字段及解释备注如下:
| 字段名 | 备注 | 涉及计算公式 |
|---|---|---|
| 名称 | 期权合约中文名 | 无 |
| 最新价 | 对应期权最新价 | 无 |
| 买卖 | 筛选出来期权的买卖方向 | 无 |
| 数量 | 下单买卖的期权数量 | 无 |
| 权利金净值 | 方案中包含期权的权利金净值 | 合约权利金收入之和 - 合约权利金支出之和 |
| 最大盈利 | 图上直观展示为 1 单位红柱长度 | 红柱长度*合约单位 |
| 最大亏损 | 图上直观展示为 1 单位绿柱长度 | 绿柱长度*合约单位 |
盈亏分析区域:

相关的字段及解释备注如下:
| 字样名 | 备注 | 位置 |
|---|---|---|
| 行权到期日 | 选中期权的到期日 | 参考 T 型面板中期权到期日 |
| 最大盈利 | 该方案下最大盈利金额 | 取方案区域内的最大盈利字 |
| 段 | ||
| 盈利区间 | 该方案下盈利的价格区间 | 参考盈亏平衡线的数值 |
| 最大亏损 | 该方案下最大亏损金额 | 取方案区域内的最大亏损字段 |
| 亏损区间 | 该方案下亏损的价格区间 | 参考盈亏平衡线的数值 |
| 权利金净值 | 该方案下净权利金收入水平 | 取方案区域内的权利金净值字段 |
本系统股票期权支持 T 型报价板下单和查看功能,总共包含行情、指标、风险、信息四大板块。以各个期权合约的行权价为中心,左侧为认购合约,右侧为认沽合约。
①行情板块提供展示期权合约的市场行情信息,包括状态、期权理论价值、隐含波动率、持仓量(市场持仓量)、总量(市场成交量)、买价(买一价)、卖价(卖一价)、涨幅、涨跌、最新价和仓差信息(需选择账号)。可进行备兑,买入和卖出操作。

T 型板 - 行情
②指标板块提供展示期权合约的真实杠杆率、杠杆比率、溢价率、隐含波动率、历史波动率、时间价值、内在价值、最新价和仓差信息。可进行备兑,买入

T 型板 - 指标
③风险板块提供展示期权合约的希腊值(包括外部导入的希腊值、买隐波、卖隐波数据)、最新价、仓差信息。可进行备兑,买入和卖出操作。

T 型板 - 风险
④信息板块提供展示期权合约的行权价格、合约单位、行权方式、行权终止日、最新价与仓差的信息。可进行备兑,买入和卖出操作。

T 型板 - 信息
⑤T 型板各个板块的底部支持查看各个月份的希腊值汇总信息。
| 下单面板 1 ☐ × | T 型报价板 × | 策略组合 × | |||||||||
| 行情 指标 风险 信息 合约选择:SH510050 剩余到期天数:20 标的名称:上证 50ETF 最新价:2.6770 涨跌:0.006 | |||||||||||
| 2022 年 12 月 | 2023 年 01 月 | 2023 年 03 月 | 2023 年 06 月 | ||||||||
| 预估保证金 | 行权价格 | 合约单位 | 行权方式 | 行权终止日 | 期权到期日 | 涨幅 | 最新价 | 合约代码 | 备兑 | 卖出 | |
| 1 | 10650.5604 | 2.1200 | 10142 | 欧式式 | 20221228 | 20221228 | 1.50% | 0.5629 | 10004743 | 开平 | 开平 |
| 2 | 10059.0790 | 2.1690 | 10142 | 欧式式 | 20221228 | 20221228 | 0.85% | 0.5098 | 10004735 | 开平 | 开平 |
| 3 | 9463.9464 | 2.2180 | 10142 | 欧式式 | 20221228 | 20221228 | 0.97% | 0.4600 | 10004663 | 开平 | 开平 |
| 4 | 8890.7206 | 2.2680 | 10142 | 欧式式 | 20221228 | 20221228 | 0.49% | 0.4120 | 10004664 | 开平 | 开平 |
| 5 | 8296.8051 | 2.3170 | 10142 | 欧式式 | 20221228 | 20221228 | 0.64% | 0.3635 | 10004651 | 开平 | 开平 |
| 6 | 7699.2384 | 2.3660 | 10142 | 欧式式 | 20221228 | 20221228 | 1.41% | 0.3165 | 10004635 | 开平 | 开平 |
| 7 | 7203.8400 | 2.4000 | 10000 | 欧式式 | 20221228 | 20221228 | 0.89% | 0.2823 | 10004841 | 开平 | 开平 |
| 8 | 7095.5866 | 2.4160 | 10142 | 欧式式 | 20221228 | 20221228 | 1.07% | 0.2653 | 10004579 | 开平 | 开平 |
| 9 | 6618.2400 | 2.4500 | 10000 | 欧式式 | 20221228 | 20221228 | 0.65% | 0.2325 | 10004842 | 开平 | 开平 |
| 10 | 6517.4926 | 2.4650 | 10142 | 欧式式 | 20221228 | 20221228 | 1.86% | 0.2195 | 10004237 | 开平 | 开平 |
| 11 | 6030.2400 | 2.5000 | 10000 | 欧式式 | 20221228 | 20221228 | 4.01% | 0.1893 | 10004843 | 开平 | 开平 |
| 12 | 5975.9098 | 2.5140 | 10142 | 欧式式 | 20221228 | 20221228 | 1.65% | 0.1729 | 10004238 | 开平 | 开平 |
| 13 | 5468.6400 | 2.5500 | 10000 | 欧式式 | 20221228 | 20221228 | 4.36% | 0.1411 | 10004844 | 开平 | 开平 |
| 14 | 5453.7996 | 2.5640 | 10142 | 欧式式 | 20221228 | 20221228 | 0.71% | 0.1285 | 10004239 | 开平 | 开平 |
| 15 | 5034.2400 | 2.6000 | 10000 | 欧式式 | 20221228 | 20221228 | 1.31% | 0.1003 | 10004845 | 开平 | 开平 |
| 16 | 4994.9756 | 2.6130 | 10142 | 欧式式 | 20221228 | 20221228 | 1.22% | 0.0910 | 10004240 | 开平 | 开平 |
| 期权到期日 | delta | gamma | theta | vega | |||||||
| 1 | 20221228 | 0.0000 | 0.0000 | 0.0000 | 0.0000 | ||||||
| 2 | 20230125 | 0.0000 | 0.0000 | 0.0000 | 0.0000 | ||||||
| 3 | 20230322 | 0.0000 | 0.0000 | 0.0000 | 0.0000 | ||||||
| 4 | 20230628 | 0.0000 | 0.0000 | 0.0000 | 0.0000 | ||||||
| 5 | 合计 | 0.0000 | 0.0000 | 0.0000 | 0.0000 | ||||||
T 型板 - 希腊值汇总
本系统股票期权 T 型板增加价格快速下单功能,增加勾选“启用价格快速下单”,勾选之后,T 型板右侧出现价格快速下单版,取消勾选则价格下单板隐藏。T 型板的行情、指标、风险和信息四大板块共用快速下单板,相互切换时不影响快速下单板的使用。

价格快速下单板
启用价格快速下单功能,需要选择账号。价格快速下单板包含五档行情内容、信息展示(多仓=权利仓、空仓=义务仓、净仓=多仓 - 空仓)、操作选择、以及价格下单区。
①当在 T 型板中选中某合约(以 T 型板执行价格为中心,左边为认购合约,右边为认沽合约),价格快速下单板中将展示该合约的实时五档行情价格、涨跌停价和挂单量,以及该合约在该账号下的多仓、空仓和净仓信息。盘口支持手动输入期权合约。

行情与持仓
②操作选择区可用于选择卖出下单操作,卖出分为卖开和卖平,买入默认优先买平操作,即不区分买开和买平,委托下单买入时,若合约有义务仓,优先平掉义务仓再根据委托量是否富余进行买开。可单笔委托量,即下单一笔的委托量,单位为张。

操作选择区
③下单区的价格也是根据选中的合约相应价格所得,若选中合约有最新价,则取最新价为基准向上和向下加减 20 个 tick;若合约无最新价,则取买一价和卖一价的均值做为基准,向上和向下加减 20 个 tick。每个价格左侧第一列为委买量,第二列为买量,点击相应价格行左侧即委买量和买量位置,左击是为买入下单,右击是为买入撤单;点击相应价格行右侧即委卖量和卖量位置,左击是为卖出下单,右击是为卖出撤单。在委买量和委卖量位置会显示出该价格下的累计未成委托量,右击撤单时则撤销该价格下全部未成委托。在买量和卖量位置会展
示五档行情价格的实时挂单量。
| 委买量 | 买量 | 价格 | 卖量 | 委卖量 |
|---|---|---|---|---|
| 0.0329 | ||||
| 0.0328 | ||||
| 1 | 0.0327 | |||
| 0.0326 | ||||
| 0.0325 | 32 | |||
| 2 | 0.0324 | 41 | ||
| 0.0323 | 68 | |||
| 0.0322 | 48 | |||
| 1 | 0.0321 | 27 | ||
| 0.0320 | ||||
| 23 | 0.0319 | |||
| 32 | 0.0318 | |||
| 24 | 0.0317 | |||
| 24 | 0.0316 | |||
| 48 | 0.0315 | |||
| 0.0314 | ||||
| 0.0313 | ||||
| 0.0312 |
价格下单区
深港通和沪港通采用“双通道”独立运行机制,深港通下的港股通和沪港通下的港股通证券账户内股票不能交叉卖出,但沪深港股通账户卖出港股的资金可以交叉使用。内地投资者参与港股通股票交易时,仅能使用两种订单类型:在竞价时段应当采用“竞价限价盘”委托;在持续交易时段应当采用“增强限价盘”委托。投资者参与港股通交易委托申报需输入证券代码、买卖价格、买卖数量等参数。投资者申报的价格遵循香港当地的报价规则,在港股市场,开市报价规则与持续交易时段报价规则不同,但投资者在这两个时段输入的买卖盘价格,均不可大于上日收盘价或按盘价九倍或以上及少于九分之一或以下,每个买卖盘不得超过 3000 手股份。
交易系统根据沪港通/深港通交易有买入、卖出、零股卖出的交易操作,如下图所示:


沪港通/深港通交易系统
①港股通交易,以港币报价成交,以人民币清算并交收。在交易结算过程中,需要涉及到港币与人民币的换汇处理。在“买入/卖出/零股卖出”下单面板中显示相应汇率,买入时,显示卖出汇率换算;卖出时,显示买入汇率换算:

下单面板 - 汇率
②港股通交易,以港币报价成交,在“买入/卖出/零股卖出”下单面板中显示委托价时以港币为单位。

下单面板 - 委托价
③在“买入/卖出/零股卖出”下单面板盘口下方展示盘口所选代码对应的“最小价格”、“每手股数”、“初始额度”、“剩余额度”、“汇率”。

下单面板 - 数值
最小价格:深市 A 股是 0.01 元人民币;而港股不同价格的股票,最小报价单位不同,股价越高,最小报价单位越大。
每手股数:下单时需要输入每手股数数值或其整数倍。
初始额度与剩余额度:深港通设置了每日额度的限制,深港通每日额度限制为深股通 130 亿元人民币,港股通 105 亿元人民币。深港通下的港股通和沪港通下的港股通每日额度由深沪证券交易所分别控制,即均为 105 亿元人民币。
深市 A 股竞价交易买卖股票应为 100 股或其整数倍;港股交易每“手”股数没有统一规定,港股的上市公司可以自行设立不同数量的每手股票交易单位,可以是 100、200、1000 或 5000 等。买卖时下单量不得小于最小交易单位,委托价格必须为最小价格的整数倍。
操作介绍:
①在买入/卖出下单面板盘口输入沪港通/深港通代码;
②选择交易方式,如选择普通交易,需设置相应的报价方式和触价设置;
③输入港币为单位的委托价,输入下单总量,点击下单按钮。

买入和卖出
零股交易即指不到一个成交单位的股票交易。港交所的交易系统为零股买卖设有专门的系统,参与沪港通业务的内地投资者只能卖出零股,不能买入,为了满足沪港通合约的零股买卖操作,增加零股买卖操作面板。所谓零股是指不到一个成交单位的股票。在内地市场,一手默认为 100 股(如 1 股、10 股),不满 100 股的股票需要通过零股卖出进行交易。在卖出股票时,可以用零股进行委托。
①在零股卖出下单面板盘口输入沪港通/深港通代码(存在持仓);
②选择交易方式,如选择普通交易,需设置相应的报价方式和触价设置;
③输入港币为单位的委托价,输入下单总量,点击下单按钮。

零股卖出
本系统 ETF 申赎模块支持成份股买入、成份股卖出、申购、赎回、基金买入、基金卖出、一键套利。
申购需要一定数量的成份股,所谓的成份股就是多只股票,每个基金都有自己对应的成份股代码及分配量,可在交易所官网查看。

成份股买入/卖出类似于大篮子下单,以成份股买入操作为例:
点击 ETF 申赎 - 成份股买入,在 ETF 代码处点击 输入要进行交易的 ETF 代码,下单面板显示对应的成份股(交易所公布 ETF 申购赎回清单中,1 份“一级市场基金代码”=1 篮子“成份股信息”),且成份股代码和分配量与交易所公布该 ETF 代码成份股代码和分配量一致;
下单总量 1 在 输入下单总量和交易参数,选择下单账号后点击买入按钮,可以对该 ETF 代码对应的成份股进行买入下单;
下单后委托、成交、持仓中增加相应的成份股信息(点击当日委托、当日成交和当日持仓查看)。
“成分股卖出”操作同成分股买入。
备注
下单总量单位 1CU 为 1 创设,即 ETF 申赎清单中给出的最小申赎单位,例如 510010 最小申赎单位为 1000000 份,即 1 创设为 1000000 份。
基金买入卖出和普通股票买入卖出操作类似,以基金买入为例:
输入基金代码,下单面板显示相应的基金信息;在交易设置中设置下单参数,选择非指定价报价方式时,委托价自动填充;选择指定价报价方式时,需手动输入委托价,且可以通过 调整价格,增减最小单位为 0.001 元;在下单总量处 输入下单总量,选择下单账号,点击买入即可进行买入下单。

基金买入
基金买入后,当日持仓中增加该基金持仓,持仓量增加,增加量为下单总量;点击当日委托、当日成交和当日持仓查看其交易数据。
“基金卖出”操作同基金买入。
下单总量最小单位为 1CU/份,CU 和份可以通过点击相互切换。1CU 即 1 创设单位,即 ETF 申赎清单中给出的最小申赎单位,例如 510010 最小申赎单位为 1000000 份,即 1 创设为 1000000 份。选中某只基金代码后,下单总量右侧会联动显示出该只基金代码的最小申赎单位。
申购是用成份股换 ETF 基金的持仓。每个 ETF 的代码都有固定的一篮子股票,在客户端下单面板输入 ETF 的代码,就会在左侧面板出现对应的一篮子成份股的代码。

申购
其中可用量是持仓中成份股的可用于申购的数量,同申赎可用量。
赎回是用 ETF 基金换成份股持仓,在客户端下单面板输入 ETF 的代码,会在左侧面板出现对应的一篮子成份股的代码。其中可用量是持仓中成份股的可用于赎回的数量,同申赎可用量。

赎回
一键套利界面同样包含交易设置区、账号选择区和下单操作区。

一键套利
交易设置区供用户选择不同交易的交易参数,此处列举了两种交易分别是成份股卖出、基金买入,其他没有参数设置。下单时可以选择普通交易或者算法交易下单。

交易设置区
账号选择区供用户选择资金账号,呈现经纪公司、资金账号、账号名称、权重和总资产、可用资金等内容。账号均为单选,只允许选择一个账号。
| 选择 | 三 券商 | 资金账号 | 账号名称 | 总资产 | |
| 1 | ○ | 迅投柜台模拟 | 803020 | chenzhilin | 8 9998 4872 7401.5 |
| 2 | ○ | 迅投柜台模拟 | 803023 | chenzhilin | 7 7322 1988.12 |
| 3 | ● | 海通证券 SPX 模拟 | 0240125049 | 0240125049 | 9940 1368.39 |
| 3 合计 | 9 0007 2135 0758. |
账号选择区
下单操作区供用户选择具体的套利方式、下单的 ETF 代码和基金代码,可设置基金价格和下单总量。输入 ETF 代码或者基金代码时,会联动显示对应的基金代码或 ETF 代码;基金价格处显示报价方式的价格,报价方式为指定价时,基金价格可输入,为其他报价方式时基金价格置灰不可输入。下单总量单位为 CU(创设),例如,官网公布的 510021 的最小申赎清单为 100000 份,即为 1 创设。
下单时可选择是否勾选优先使用库存、现金替代,参数设置处可设置报价方式为自动盘口时的盘口比例。参数设置右侧问号标志可点击,点击弹出一键套利功能使用说明。

下单操作区
成份股买入/卖出支持的报价方式有:买 1 价、卖 1-卖 5、最新价、市价、挂单价、对手价、自动盘口报价方式。
基金买入/卖出支持的报价方式有:卖 1-卖 5、买 1-买 5、最新价、市价、挂单价、对手价,支持指定价的取价方式。
自动盘口报价方式选择:如果选择了买、卖自动盘口,则系统会根据交易份额中需要的委托数量来自动选择每只证券委托时使用的盘口。选择的依据是:买入时依次从低到高取相应盘口数量再考虑用户设置的盘口比例后的累积达到委托数量时,则对该盘口价格进行委托。如:使用买自动盘时,先找卖一盘(利于成交方向)的盘口数量*盘口一比例是否小于委托数量。如果不小于,则使用卖一盘的价格进行委托,如果小于则取卖一盘数量*盘口一比例加卖二盘数量*盘口二比例与委托数量比较,不小于则取卖二盘,小于再取卖三盘,依此类推,直至找到卖五盘为止。卖出时同理,依次从高到低取相应盘口数量再考虑用户设置的盘口比例后的累积达到委托数量时,对该盘口价格进行委托。如:使用卖自动盘时,先找买一盘(利于成交方向)的盘口数量*盘口一比例是否小于委托数量。依次类推买二盘、买三盘直至买五盘。举例如下:SH600016 卖出 2100 股,
| 选择 | 账号 | 市场 | 代码 | 股票名称 | 交易类型 | 分配量 | 最新价 | 涨跌幅 | 最新市值 | 状态 | ETF 申赎可用量 | 单位申赎可用量 | 替代标志 | 溢价比率 | 替代金额 | 自动盘口 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | ☑ | 260100007504 | SH | 600016 | 民生银行 | 卖出 | 2100 | 5.99 | -0.17% | 12579.00 | 20900 | 2100 | 允许 | 0.10 | 0.00 | 5.99 | |
| 2 | ☑ | 260100007504 | SH | 600019 | 宝钢股份 | 卖出 | 1600 | 7.57 | 1.75% | 12112.00 | 124400 | 1600 | 允许 | 0.10 | 0.00 | 7.55 | |
| 3 | ☑ | 260100007504 | SH | 600028 | 中国石化 | 卖出 | 2200 | 6.67 | -0.45% | 14674.00 | 13150 | 2200 | 允许 | 0.10 | 0.00 | 6.66 | |
| 4 | ☑ | 260100007504 | SH | 600030 | 中信证券 | 卖出 | 800 | 15.93 | 0.44% | 12744.00 | 21850 | 800 | 允许 | 0.10 | 0.00 | 15.90 | |
| 5 | ☑ | 260100007504 | SH | 600036 | 招商银行 | 卖出 | 500 | 28.15 | 2.36% | 14075.00 | 9550 | 500 | 允许 | 0.10 | 0.00 | 28.10 |
自动盘口
盘口数量如下:
| 民生银行 | 6.00 | ||
| 600016 | 0.00 | 0.00% | |
| 卖 5 | 6.05 | 17065 | |
| 卖 4 | 6.04 | 11453 | |
| 卖 3 | 6.03 | 7522 | |
| 卖 2 | 6.02 | 6726 | |
| 卖 1 | 6.01 | 1642 | |
| 最新 | 6.00 | 0.00 | |
| 买 1 | 6.00 | 711 | |
| 买 2 | 5.99 | 5270 | |
| 买 3 | 5.98 | 2030 | |
| 买 4 | 5.97 | 3061 | |
| 买 5 | 5.96 | 4106 | |
| 涨停 | 6.60 | 跌停 | 5.40 |
| 撤买 | 0 | 撤卖 | 0 |
盘口挂单量
盘口比例如下:(盘口比例设置见下单操作区参数设置)
| 参数设置 | ||
| 成份股买入 | 成份股卖出 | |
| 盘口一比例 | 60.00% | 60.00% |
| 盘口二比例 | 60.00% | 60.00% |
| 盘口三比例 | 80.00% | 80.00% |
| 盘口四比例 | 100.00% | 100.00% |
| 盘口五比例 | 100.00% | 100.00% |
盘口比例
买 1 盘口数量*60%=711*0.6=426.6<1000<买 1 盘口数量*60%+买 2 盘口数量* 60%=711*0.6+5270*0.6=3588.6,所以自动盘口报价方式取买 2 价。买 2 价为 5. 99。
折价套利
折价套利是当基金价格低于基金份额参考净值,投资者先以较低的价格买入ETF 基金,用 ETF 基金赎回成份股篮子,再以较高的价格卖出成份股篮子,赚得差价的套利。所以一键套利中的折价套利流程,将会包含三个交易过程,先后分别是基金买入、ETF 赎回、成份股卖出。体现在系统中,即一个折价套利过程将会先后产生 3 个任务,分别执行。
折价套利下单
_304_
折价套利
下单后产生套利任务:
_305_
折价套利任务
委托反馈将根据任务的先后顺序分别返回:
| 任务委托 | ||||||||||||||||
| 委托反馈 全部 全选 反选 选中撤单 全部撤单 刷新 | ||||||||||||||||
| 选择 | 委托时间 | 代码 | 名称 | 买卖标记 | 委托量 | 成交数量 | 委托剩余量 | 委托状态 | 委托价格 | 成交均价 | 合同编号 | 废单原因 | 证券市场 | 多空 | 报单状态 | |
| 1 | 18:05:34 | 510020 | 超大盘 ETF | 限价买入 | 10 0000 份 | 10 0000 份 | 0 份 | 已成 | 3.160 | 3.1600 | 1000000000 | SH | - | - | ||
折价套利委托反馈
已报委托将根据任务报出的顺序分别产生。
| 任务委托 | ||||||||||||||
| 已报委托 刷新 | ||||||||||||||
| 经纪公司 | 账号 | 账号名称 | 账号类型 | 账号是否启用 | 账号备注 | FrontId | SessionId | OrderRef | RequestId | OrderSysId | 任务编号 | 任务来源 | ||
| 1 | 迅投柜台模拟 | 803023 | chenzhilin | 主账号 | 是 | -1 | -1 | 1381024217620807680 | -1 | 1403 | 7 | 111.202.66 | ||
组合任务中将先后分别产生三个任务,每次完成一个任务,下一个任务才会开始。如图:
| 全选 | 反选 | 选中撤销 | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 选择 | 任务编号 | 资金账号 | ETF | 套利方式 | 套利进度 | 执行信息 | 操作 | 收益成本 | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 1 | □ | 2.1 | 资金账号 | 2100000038 | ETF 代码 | SMS10020 | 套利方式 | 折价 | 买入 ETF | 100000/100000 | 100000/100000 | 0/0 | S9603259 可用量不足,无法卖出! | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 账号名称 | 2100000038 | 基金代码 | SMS10020 | 优先留存 | 否 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 名称 | 超大盘 ETF | 现金替代 | 否 |
套利进度
| 全部任务 | 全部缴纳 | 全部暂停 | 全部继续 | □过滤已完成子任务 | 全部收起 | 全部展开 | |||||||||||
| 任务 | 账号 | 名称 | 交易参数 | 账号名称 | 交易类型 | 金额 | 进度 | 委托详情 | 开始时间 | 结束时间 | 操作 | 状态 | 投资备注 | 篮子来源 | 未成交数量 | 智能算法标识 | |
| 组合任务 2 | 210000 | 普通 | ETF 赎回 | 0.00 | 0.00 / 0.00 | 已报 1 收到 1 | 18:11:15 | 18:11:15 | 已完成 | 0 | |||||||
| SMS10020 | 210000 | 超大盘 | 2100000038 | ETF 赎回 | 0.00 | 0.00 / 0.00 | 已完成 | 0 | |||||||||
| 组合任务 1 | 210000 | 普通 | 买入 | 316000 | 31.60 万 / 31.60 万 | 已报 1 收到 1 | 18:11:15 | 18:11:15 | 已完成 | 0 | |||||||
| SMS10020 | 210000 | 超大盘 | 2100000038 | 买入 | 316000 | 31.60 万 / 31.60 万 | 已完成 | 0 | |||||||||
套利任务
每次完成一个任务,持仓、委托、成交会相应产生变化。在一次完整地不用库存的折价套利完成后,套利前后的持仓应该是无变化的。
溢价套利是当基金价格高于基金份额参考净值时,投资者先以较低的价格买入成份股篮子,用篮子申购 ETF 基金,再以较高的价格卖出 ETF 基金,赚得差价的套利。所以一键套利中的溢价套利流程,将会包含三个交易过程,先后分别是成份股买入、ETF 申购、基金卖出。体现在系统中,即一个溢价套利过程将会先后产生 3 个任务,分别执行。

| 下单面板 | 组合任务 | 消息提示 | 委托 | 成交 | 持仓 | 套利进度 | |||||||||||||
| 全部任务 | 全部要领 | 全部暂停 | 全部继续 | 过滤已完成子任务 | 全部联起 | 全部展开 | |||||||||||||
| 任务 | 账号 | 名称 | 交易参数 | 账号名称 | 交易类型 | 金额 | 进度 | 委托详情 | 开始时间 | 结束时间 | 操作 | 状态 | 投资备注 | 篮子来源 | 未成交数量 | 智能算法标识 | |||
| 组合任务 3 | 210000 | 普通 | 买入 | 244758 | 24.49 万/27.08 万 | 已报 18 收到 18 | 18:18:26 | 营销 | 暂停 | 执行中 | 1300 | ||||||||
| -SN603259 | 210000 | 药明康 | 2100000038 | 买入 | 9440.00 | 9440.00/9440.00 | 已完成 | 0 | |||||||||||
| -SN601888 | 210000 | 中国中 | 2100000038 | 买入 | 16369. | 1.64 万/1.64 万 | 已完成 | 0 | |||||||||||
| -SN601668 | 210000 | 中国建 | 2100000038 | 买入 | 21312. | 2.13 万/2.13 万 | 已完成 | 0 | |||||||||||
| -SN601398 | 210000 | 工商银行 | 2100000038 | 买入 | 17612. | 1.76 万/1.76 万 | 已完成 | 0 | |||||||||||
| -SN601318 | 210000 | 中国平 | 2100000038 | 买入 | 17744. | 1.77 万/1.77 万 | 已完成 | 0 | |||||||||||
| -SN601166 | 210000 | 兴业银 | 2100000038 | 买入 | 0.00 | 0.00 万/1.96 万 | 19.620 | 1000 | |||||||||||
| -SN601066 | 210000 | 中信建 | 2100000038 | 买入 | 6402.00 | 0.64 万/1.28 万 | 21.340 | 300 | |||||||||||
| -SN601012 | 210000 | 隆基股 | 2100000038 | 买入 | 13406. | 1.34 万/1.34 万 | 已完成 | 0 | |||||||||||
| -SN600905 | 210000 | 三峡能 | 2100000038 | 买入 | 14794. | 1.48 万/1.48 万 | 已完成 | 0 | |||||||||||
| -SN600887 | 210000 | 伊利股 | 2100000038 | 买入 | 15140. | 1.51 万/1.51 万 | 已完成 | 0 | |||||||||||
| -SN600809 | 210000 | 山西汾 | 2100000038 | 买入 | 25366. | 2.54 万/2.54 万 | 已完成 | 0 | |||||||||||
| -SN600745 | 210000 | 闻泰科 | 2100000038 | 买入 | 6109.00 | 6109.00/6109.00 | 已完成 | 0 | |||||||||||
| -SN600585 | 210000 | 海螺水 | 2100000038 | 买入 | 15492. | 1.65 万/1.65 万 | 已完成 | 0 | |||||||||||
| -SN600309 | 210000 | 万华化 | 2100000038 | 买入 | 15762. | 1.58 万/1.58 万 | 已完成 | 0 | |||||||||||
| -SN600276 | 210000 | 恒瑞医 | 2100000038 | 买入 | 11736. | 1.17 万/1.17 万 | 已完成 | 0 | |||||||||||
| -SN600104 | 210000 | 上汽集 | 2100000038 | 买入 | 14373. | 1.44 万/1.44 万 | 已完成 | 0 | |||||||||||
| -SN600036 | 210000 | 招商银 | 2100000038 | 买入 | 10941. | 1.09 万/1.09 万 | 已完成 | 0 | |||||||||||
| -SN600031 | 210000 | 三一重 | 2100000038 | 买入 | 12760. | 1.28 万/1.28 万 | 已完成 | 0 | |||||||||||
| 组合任务 2 | 210000 | 普通 | ETF 赎回 | 0.00 | 0.00/0.00 | 已报 1 收到 1 | 18:11:15 | 18:11:15 | 已完成 | 0 | |||||||||
| SNS10020 | 210000 | 超大盘 | 2100000038 | ETF 赎回 | 0.00 | 0.00/0.00 | 已完成 | 0 | |||||||||||
| 组合任务 1 | 210000 | 普通 | 买入 | 316000 | 31.60 万/31.60 万 | 已报 1 收到 1 | 18:11:15 | 18:11:15 | 已完成 | 0 | |||||||||
| SNS10020 | 210000 | 超大盘 | 2100000038 | 买入 | 316000 | 31.60 万/31.60 万 | 已完成 | 0 | |||||||||||
| 任务委托 | |||||||||||||||||
| 委托反馈√ | 全部√ | 全选 | 反选 | 选中撤单 | 全部撤单 | 刷新 | |||||||||||
| 选择 | 委托时间 | 代码 | 名称 | 买卖标记 | 委托量 | 成交数量 | 委托剩余量 | 委托状态 | 委托价格 | 成交均价 | 合同编号 | 废单原因 | 证券市场 | 多空 | 报单状态 | 账号 | |
| 1 | □ | 18:18:27 | 601166 | 兴业银行 | 限价买入 | 1000 股 | 0 股 | 1000 股 | 已报 | 19.62 | 0.0000 | 1000000014 | SH | - | - | 主 | |
| 2 | 18:12:44 | 603259 | 药明康德 | 限价买入 | 100 股 | 100 股 | 0 股 | 已成 | 94.40 | 94.4000 | 1000000019 | SH | - | - | 主 | ||
| 3 | 18:12:44 | 601888 | 中国中免 | 限价买入 | 100 股 | 100 股 | 0 股 | 已成 | 163.69 | 163.6900 | 1000000018 | SH | - | - | 主 | ||
| 4 | 18:12:44 | 601668 | 中国建筑 | 限价买入 | 3600 股 | 3600 股 | 0 股 | 已成 | 5.92 | 5.9200 | 1000000017 | SH | - | - | 主 | ||
| 5 | 18:12:44 | 601398 | 工商银行 | 限价买入 | 3700 股 | 3700 股 | 0 股 | 已成 | 4.76 | 4.7600 | 1000000016 | SH | - | - | 主 | ||
| 6 | 18:12:44 | 601318 | 中国平安 | 限价买入 | 400 股 | 400 股 | 0 股 | 已成 | 44.36 | 44.3600 | 1000000015 | SH | - | - | 主 | ||
| 7 | □ | 18:12:44 | 601066 | 中信建投 | 限价买入 | 600 股 | 300 股 | 300 股 | 部成 | 21.34 | 21.3400 | 1000000013 | SH | - | - | 主 | |
| 8 | 18:12:44 | 601012 | 隆基股份 | 限价买入 | 200 股 | 200 股 | 0 股 | 已成 | 67.03 | 67.0300 | 1000000012 | SH | - | - | 主 | ||
| 9 | 18:12:44 | 600905 | 三峡能源 | 限价买入 | 2600 股 | 2600 股 | 0 股 | 已成 | 5.69 | 5.6900 | 1000000011 | SH | - | - | 主 | ||
| 10 | 18:12:44 | 600887 | 伊利股份 | 限价买入 | 400 股 | 400 股 | 0 股 | 已成 | 37.85 | 37.8500 | 1000000010 | SH | - | - | 主 | ||
| 11 | 18:12:44 | 600809 | 山西汾酒 | 限价买入 | 100 股 | 100 股 | 0 股 | 已成 | 253.66 | 253.6600 | 1000000009 | SH | - | - | 主 | ||
| 12 | 18:12:44 | 600745 | 闻泰科技 | 限价买入 | 100 股 | 100 股 | 0 股 | 已成 | 61.09 | 61.0900 | 1000000008 | SH | - | - | 主 | ||
| 13 | 18:12:44 | 600585 | 海螺水泥 | 限价买入 | 400 股 | 400 股 | 0 股 | 已成 | 38.73 | 38.7300 | 1000000007 | SH | - | - | 主 | ||
| 14 | 18:12:44 | 600309 | 万华化学 | 限价买入 | 200 股 | 200 股 | 0 股 | 已成 | 78.81 | 78.8100 | 1000000006 | SH | - | - | 主 | ||
| 15 | 18:12:44 | 600276 | 恒瑞医药 | 限价买入 | 400 股 | 400 股 | 0 股 | 已成 | 29.34 | 29.3400 | 1000000005 | SH | - | - | 主 | ||
| 16 | 18:12:44 | 600104 | 上汽集团 | 限价买入 | 900 股 | 900 股 | 0 股 | 已成 | 15.97 | 15.9700 | 1000000004 | SH | - | - | 主 | ||
| 17 | 18:12:44 | 600036 | 招商银行 | 限价买入 | 300 股 | 300 股 | 0 股 | 已成 | 36.47 | 36.4700 | 1000000003 | SH | - | - | 主 | ||
| 18 | 18:12:44 | 600031 | 三一重工 | 限价买入 | 800 股 | 800 股 | 0 股 | 已成 | 15.95 | 15.9500 | 1000000002 | SH | - | - | 主 | ||
| 合计 | 15900 | 14600 | 1300 |
溢价套利委托反馈
已报委托将根据任务报出的顺序分别产生。
| 任务委托 | ||||||||||||||
| 已报委托 刷新 | ||||||||||||||
| 经纪公司 | 账号 | 账号名称 | 账号类型 | 账号是否启用 | 账号备注 | FrontId | SessionId | OrderRef | RequestId | OrderSysId | 任务编号 | 任务来源 | ||
| 1 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452610 | -1 | 1000000002 | 3 | 111.202.66 | ||
| 2 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452611 | -1 | 1000000003 | 3 | 111.202.66 | ||
| 3 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452612 | -1 | 1000000004 | 3 | 111.202.66 | ||
| 4 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452613 | -1 | 1000000005 | 3 | 111.202.66 | ||
| 5 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452614 | -1 | 1000000006 | 3 | 111.202.66 | ||
| 6 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452615 | -1 | 1000000007 | 3 | 111.202.66 | ||
| 7 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452616 | -1 | 1000000008 | 3 | 111.202.66 | ||
| 8 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452617 | -1 | 1000000009 | 3 | 111.202.66 | ||
| 9 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452618 | -1 | 1000000010 | 3 | 111.202.66 | ||
| 10 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452619 | -1 | 1000000011 | 3 | 111.202.66 | ||
| 11 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452620 | -1 | 1000000012 | 3 | 111.202.66 | ||
| 12 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452621 | -1 | 1000000013 | 3 | 111.202.66 | ||
| 13 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452622 | -1 | 1000000014 | 3 | 111.202.66 | ||
| 14 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452623 | -1 | 1000000015 | 3 | 111.202.66 | ||
| 15 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452624 | -1 | 1000000016 | 3 | 111.202.66 | ||
| 16 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452625 | -1 | 1000000017 | 3 | 111.202.66 | ||
| 17 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452626 | -1 | 1000000018 | 3 | 111.202.66 | ||
| 18 | hrcs1 | 2100000038 | 2100000038 | 主账号 | 是 | -1 | -1 | 1381024217440452627 | -1 | 1000000019 | 3 | 111.202.66 | ||
溢价套利已报委托
组合任务中将先后分别产生三个任务,每次完成一个任务,下一个任务才会开始。如图:

套利进度面板
每次完成一个任务,持仓、委托、成交会相应产生变化。在一次完整地不使用库存的溢价套利完成后,套利前后的持仓应该是无变化的。
一键套利支持使用当前持仓中的库存,委托时只需委托(目标量 - 库存量),进而做到减少交易成本,加速成交进程,有效减少套利时间。优先使用库存界面勾选如图:

优先使用库存
优先使用库存,优先,即勾选之后,若持仓中有可用来套利的库存,则优先使用,委托量为(目标量 - 库存量),若持仓中没有可用的库存,则进行全部目标量委托。
溢价套利流程,包含成份股买入、ETF 申购、基金卖出三个任务。所以,若勾选优先使用库存,则会先检查基金持仓的可用量,基金持仓可用若足够,则直接按目标量卖出,基金持仓可用若不够,则检查申购的可用是否足够。申购可用是否足够检查的是成份股的 ETF 申赎可用量,若足够则直接按目标量进行申购委托,若不够则按(目标量 - 库存量)进行成份股买入委托。折价套利同理,依次检查成份股持仓可用量、基金持仓的 ETF 申赎可用量,进行委托。
套利任务开始后,勾选了优先使用库存,则在成交的过程中,持仓会被实时检查。例如溢价套利,在成份股买入进行中时,若检查到持仓中申赎可用量足够,则会开始报出申购的任务和委托,同时会撤掉成份股买入的任务。折价套利买入基金时同理。
例:510021 溢价套利,优先使用库存,基金持仓可用不足,申购可用足够,直接从申购开始进行委托。

溢价套利


使用库存任务
ETF 申购过程中需要考虑现金替代这一环节,考虑现金替代后,一键套利支持除去库存和现金替代部分后进行委托,故在溢价套利成份股买入时能够尽快报出除去库存和现金替代部分后的委托量。因而在选择溢价套利方式后,可勾选是否考虑现金替代,若勾选现金替代,成份股买入时可以实现比只勾选优先库存更快更早的开始进行申购,进而加速套利进度。
现金替代只会在申购中发生,所以折价套利是不会用到现金替代的。故当选择折价套利时,现金替代勾选项为置灰不可勾选状态,如图:

现金替代
溢价套利勾选现金替代后,优先使用库存也会同步勾选上并且置灰不让更改。考虑使用现金替代,需要在实时检查持仓的基础上实时计算当前现金替代比例,若在成份股买入任务进行过程中,当前现金替代比例达到小于或等于最小申赎清单上的现金替代比例,则系统会立刻开始进行申购,同时会撤掉成份股买入未完成的任务,从而减少成份股买入时间,加快套利进度。溢价套利勾选现金替代,如图所示

默认使用库存
例:510011 溢价套利,成份股有部分持仓,当勾选优先使用库存但不勾选现金替代时,下单弹框,会委托买入(目标量 - 库存量)数目的成份股:

溢价套利
此时取消下单,同时勾选现金替代,下单弹框,会直接委托申购。这是因为系统经过计算,把需要委托买入的部分成份股用现金替代了,所以直接进行了申购:

使用现金替代
因此,系统有效利用现金替代减少了套利时间,加速了了套利进程,有助于用户抓住短暂的套利时机,实现收益。
若启用了优先使用库存或现金替代两功能,套利可能在第一步买入成份股时由于实时检查持仓,当检查出申购的持仓足够便立刻进行申购,而第一步成份股买入的过程可能并未进行完。此时,系统会发出撤销请求,撤销第一步的任务。
用于展示 ETF 一键套利的流程进度,如图:

套利进度面板
呈现每次套利的进度流程到哪一步。包含选择、任务编号、资金账号、ETF(ETF 代码、基金代码、名称)、套利方式、套利进度、执行信息和操作,以及收益成本和交易。套利方式展示溢价还是折价套利方式,是否优先库存和现金替代,套利进度展示每次套利目前进入到了哪一步,,执行信息显示一些持仓状态信息。操作可以选择撤销,申购和赎回中不可撤销指令。一但撤销(在自动套利面板撤销或者任务面板中撤销),即撤销本次套利,套利过程终止。
相关计算:实际买入(溢价)=成份股买入成交金额,实际买入(折价)=E TF 买入成交金额,实际卖出(溢价)=ETF 卖出成交金额,实际卖出(折价)=成份股卖出成交金额。套利收益=实际卖出 - 实际买入。此处交易过程中大致计算实际买入和实际卖出的套利收益,不计算现金替代造成的替代金额以及成份股买卖的佣金、印花税、过户费及申购赎回费用的交易费用。
由于 ETF 套利能产生多条任务,所以套利进度面板统计套利进度信息时根据任务执行进度来跟踪套利进度。因而只有产生任务的用户客户端才能在“套利进度”面板上展示相关套利进度。
固收业务模块支持质押式协议回购、现券买卖和上海/深圳债券交易。
固收业务模块支持质押式协议回购。
债券质押式协议回购交易(以下简称“协议回购”)是指回购双方自主谈判和协商议定,资金融入方 (以下简称“正回购方”) 在将债券进行质押登记并向资金融出方 (以下简称“逆回购方”) 融入资金的同时,双方约定在未来某一日期由正回购方向逆回购方返还本金,并按约定回购利率支付资金利息,同时解除债券质押登记的交易。
上交所、深交所业务描述:
意向申报 - 只有上海可以做正回购逆回购,深圳不支持;
成交申报 - 上海深圳只能由正回购方发起;
到期续做 - 上海深圳只能由正回购方发起;
提前购回 - 上海正逆回购双方都可以发起,深圳只能由正回购方发起;
质押券变更 - 只有上海可以做且只能做正回购,深圳不支持;
解除质押 - 上海正逆回购双方都可以发起,深圳只能由正回购方发起。
意向申报:是指投资者为寻找交易对手方发送的,表明协议回购意向的报价。
正回购:在进行正回购时,要选择质押债券,填写好交易要素后,点击正回购按钮进行申报。
下单后,委托已报,不会生成成交,转成交申报列表多一条正回购方向的行情数据,账号资金持仓不变。

逆回购:当要进行逆回购的时候,选择质押债券逆回购,输入代码进行选择想要的债券,填写好交易要素后,点击逆回购按钮进行申报。
下单后,委托已报,不会生成成交,转成交申报列表多一条逆回购方向的行情数据,账号资金持仓不变。

转成交面板:显示的是所有意向申报的行情,可以在此看到市场上所有的意向申报的信息,可以根据自己需要进行联系对手方进行商谈。
| 转成交申报 刷新 | |||||||||||||||||
| 交易市场 | 质押债券 | 折算比例 (%) | 质押债券数量 | 回购金额 | 回购天数 | 回购方向 | 回购利率 | ||||||||||
| 激活 Windows 转到“设置”以激活 Windows。 |
目前都是交易双方进行私下协议,确定好所有交易要素,在交易系统进行成交申报。

在选择要质押的债券后,在下单面板上填入回购天数等交易要素后进行正回购操作。
下单后,委托已报,不会生成成交,当日持仓面板可用数量减少,冻结数量增加,账号资金不变。

待确认申报面板是由对手方发起本方来确认的委托,只有对手方发起的会显示在待确认里面,本方发起的显示在对手方那里,由于交易员和对手方交易员不是一个人,故查不到记录。
若逆回购方确认,成交申报委托由已报变为已确认,资金、持仓不变。
若逆回购方拒绝,成交申报委托由已报变为废单,废单原因对手方拒绝,当日持仓面板可用数量增加,冻结数量减少,账号资金不变。
| 待确认申报 刷新 | ||||||||
| 资金账号 | 账户名称 | 交易市场 | 质押债券 | 交易类型 | 折算比例 (%) | 回购金额 | 回购天数 | |
逆回购方可以在待确认申报面板,查看发给本方的委托信息,可在操作栏中确认或拒绝。
若确认,成交申报委托已确认,账号资金面板可用金额减少,冻结金额增加,当日持仓不变,待确认申报中该条行情消失。
若拒绝,成交申报拒绝后委托已成,账号资金、持仓不变,待确认申报中该条行情消失。
协议回购未到期之前可以进行提前购回申报。

下单后,会在待确认面板中行成一条数据。提前购回正回购委托已报,账号资金面板可用金额减少,冻结金额增加,当日持仓不变。
| 待确认申报 刷新 | ||||||||
| 资金账号 | 账户名称 | 交易市场 | 质押债券 | 交易类型 | 折算比例 (%) | 回购金额 | 回购天数 | |
若逆回购方确认,委托由已报变为已确认,当日持仓面板可用数量增加,冻结数量减少,账号资金不变,回购合约该条行情的合约状态由初始合同变为已了结合同。
若逆回购方拒绝,委托由已报变为废单,账号资金面板可用金额增加,冻结
金额减少,当日持仓不变。
逆回购方在待确认申报面板中查看正回购方发给本方的提前购回信息。可在操作栏进行确认或拒绝。
如果点击确认按钮,协议回购提前终止申报委托已确认,账号资金持仓不变,待确认申报中该条行情消失。
如果点击拒绝按钮,拒绝后委托已成,账号资金、持仓不变,待确认申报中该条行情消失。
下单后,会在待确认申报面板行程一条数据,提前购回逆回购委托已报,不会生成成交,账号资金持仓不变。
| 待确认申报 刷新 | ||||||||
| 资金账号 | 账户名称 | 交易市场 | 质押债券 | 交易类型 | 折算比例 (%) | 回购金额 | 回购天数 | |
若正回购方确认,委托由已报变为已确认,资金、持仓不变,回购合约该条行情的合约状态由初始合同变为已了结合同。
若正回购方拒绝,委托由已报变为废单,废单原因为对手方拒绝,账号资金、持仓不变。
正回购方可在待确认申报面板查看逆回购方发给本方提前购回的申请信息,可在操作栏确认或拒绝。
如果点击确认按钮,委托由已报变为已确认,账号资金面板可用金额减少,冻结金额增加,当日持仓可用数量增加,冻结数量减少,待确认申报中该条行情消失。
如果点击拒绝按钮,拒绝后委托已成,账号资金、持仓不变,待确认申报中该条行情消失。
到期续做申报是指正回购方确认履行到期购回义务,同时使用到期购回的全部质押券进行一笔新的协议回购,并与到期续做的逆回购方约定在到期购回的质押券解除质押登记后用于新的协议回购。到期续做的逆回购方可以为到期回购的逆回购方,也可以为其他第三方。

下单后,到期续做委托已报,不会生成成交,账号资金面板可用金额减少,冻结金额增加,当日持仓不变。
| 待确认申报 刷新 | ||||||||
| 资金账号 | 账户名称 | 交易市场 | 质押债券 | 交易类型 | 折算比例 (%) | 回购金额 | 回购天数 | |
待确认申报是由对手方发起本方来确认的委托,只有对手方发起的会显示在
待确认里面,本方发起的显示在对手方那里。
若逆回购方确认,委托由已报变为已确认,回购合约该条行情的合约状态由初始合同变为已了结合同,资金、持仓不变。
若逆回购方拒绝,到期续做申报委托由已报变为废单,废单原因对手方拒绝,账号资金面板可用金额增加,冻结金额减少,当日持仓不变。
逆回购方可在待确认申报面板中,查看发给本方确认的申报信息,可在操作栏中点击确认或拒绝。
待确认申报确认,到期续做委托已确认,账号资金持仓不变,待确认申报中该条行情消失。
待确认申报拒绝,拒绝后委托已成,账号资金、持仓不变,待确认申报中该条行情消失。
协议回购确认成交后,在协议回购存续期间(不含首次结算日和到期结算日),经双方协商一致,可以对质押券进行变更。
质押券变更申报由正回购方发起,经逆回购方进行确认申报后,由交易系统予以确认。

下单后,委托已报,不会生成成交,当日持仓面板质押债券的可用数量减少,冻结数量增加,账号资金不变。
| 待确认申报 刷新 | ||||||||
| 资金账号 | 账户名称 | 交易市场 | 质押债券 | 交易类型 | 折算比例 (%) | 回购金额 | 回购天数 | |
待确认申报是由对手方发起本方来确认的委托,只有对手方发起的会显示在待确认里面,本方发起的显示在对手方那里。
若逆回购方确认,质押券变更委托由已报变为已确认,资金、持仓不变。
若逆回购方拒绝,换券申报委托由已报变为废单,废单原因对手方拒绝,当日持仓面板可用数量增加,冻结数量减少,账号资金不变。
逆回购方可在待确认申报面板查看发给本方确认的申报信息,可在操作栏中进行确认或拒绝。
待确认申报确认,换券申报委托已确认,账号资金持仓不变,待确认申报中该条行情消失。
待确认申报拒绝,质押券换券申报拒绝后委托已成,账号资金、持仓不变,待确认申报中该条行情消失。
协议回购达成后,如果协议回购存续期间有违约情况,需要解除质押,可以在此界面解除质押关系。

下单后,解除质押委托已报,不会生成成交,账号资金面板可用金额减少,冻结金额增加,当日持仓不变。
若逆回购方确认,解除质押委托由已报变为已确认,当日持仓面板可用数量增加,冻结数量减少,账号资金不变,回购合约该条行情的合约状态由初始合同变为已了结合同。
若逆回购方拒绝,委托由已报变为废单,账号资金面板可用金额增加,冻结金额减少,当日持仓不变。
在待确认申报面板,可对发给本方确认的申报信息,在操作栏进行确认或拒绝。
待确认申报确认,解除质押委托已确认,账号资金持仓不变,待确认申报中该条行情消失。
待确认申报拒绝,解除质押申报拒绝后委托已成,账号资金、持仓不变,待确认申报中该条行情消失。
下单后,解除质押申报逆回购委托已报,不会生成成交,资金持仓不变。
若正回购方确认,解除质押委托由已报变为已确认,账号资金持仓不变,回购合约信息面板该条行情的合约状态由初始合同变为已了结合同。
若正回购方拒绝,委托由已报变为废单,废单原因为对手方拒绝,账号资金、持仓不变。
在待确认申报面板,可对放给本方确认的申报信息,在操作栏进行确认或拒绝。
待确认申报确认,解除质押委托由已报变为已确认,账号资金面板可用金额减少,冻结金额增加,当日持仓可用数量增加,冻结数量不变,待确认申报中该条行情消失。
待确认申报拒绝,拒绝后委托已成,账号资金、持仓不变,待确认申报中该条行情消失。
现券买卖交易功能支持对国债、公司债、企业债等债券进行协议交易。
系统目前仅支持对于上交所债券的现券买卖功能。由投资者自行商议好买卖数量和价格后,在系统中录入对手方交易员信息和约定号数据,进行约定买入和卖出。

固收业务模块支持上海/深圳债券交易,包括点击成交、协商成交、询价成交和竞买成交每种交易方式。
点击成交是指报价方发出报价,相关报价经其他债券交易者点击后由交易系统确认成交,或者依据交易所规则及相关规定通过交易系统自动匹配成交的交易方式。点击成交对应境外的做市交易、银行间债券市场点击成交和上交所现有的报价交易方式。
点击成交分为报价申报和报价确认两个面板。报价申报为报价方向全市场或指定参与投资者发起报价,报价确认为接收方看到市场申报后进行点击成交申报或拒绝申报。


报价确认,为接收方对报价进行点击成交或拒绝。公开报价行情面板支持查询全市场的所有确定报价申报(支持选择合约和交易商查询)。公开报价行情选定其中一支报价,下方下单面板填充相关信息。交易方向为本方的委托方向,即与报价行情中报价方委托方向相反,例报价行情中委托方向为卖出,本方委托方向即为买入。


公开报价行情为发起方发起的报价申报行情,能看到全市场的确定报价申报行情。报价消息编号为公开报价行情唯一编号。
上海公开报价行情:

深圳公开报价行情:

协商成交是指债券交易者之间通过协商等方式达成债券交易意向,并向交易系统申报,经交易系统确认成交的交易方式。协商成交对应境内外询价交易中的自行达成或通过居间服务机构达成交易和上交所现有的指定对手方交易。
上海:双方均需发起申报,交易所确认成交;
深圳:报价方发起申报,发给确认方,确认方确认或拒绝成交。
上海债券在协商申报中交易,无协商确认。

深圳协商成交分为协商申报和协商确认两个面板。

协商确认用于深圳市场接收方收到发起方的申报后进行确认。非公开报价行情支持查询发起方发给确认方的所有申报。选中一只报价后,下方下单面板填充相关信息。交易方向为本方的委托方向,即与报价行情中报价方委托方向相反。
勾选“拒绝申报”点击下单,则为申报拒绝,不勾选下单则为申报确认。默认不勾选。

非公开报价行情面板仅支持查询深圳市场非公开报价行情。报价消息编号为非公开报价行情唯一编号。

询价成交是指询价方向做市商或者其他债券交易参与人发送询价请求,并选择一个或者多个询价回复确认成交的交易方式。询价成交对应境外、银行间债券市场和上交所现有的询价交易方式。
询价成交分为询价申报、报价回复和询价成交三个面板。
询价申报,即询价方发起询价请求,可以指定多个对手方发送询价请求。
| 下单面板 | ||||||||||||||||
| 深圳债券交易 | ||||||||||||||||
| 上海债券交易 | ||||||||||||||||
| 点击成交 | 协商成交 | 调价成交 | 竞买成交 | |||||||||||||
| 询价申报 | 报价回复 | 询价成交 | ||||||||||||||
| 资金账号 | 2100000038 | 订单方向 | 买入 | 卖出 | ||||||||||||
| 证券代码 | 输入债券代码 | 本方交易商 | 输入交易商代码 | 1 | ● | hrcn1 | 2100000038 | 2100000038 | 10 0000 0000.00 | 10 0000 0000.00 | 1 | 0 | 0 | |||
| 计价方式 | 净价 全价 | 本方交易员 | 输入交易员代码 | 2 | ○ | 睿智融科模拟 2110 | 1000000312 | 312 | 4255 8490 6342.75 | 4255 8432 5979.25 | 1 | 0 | 0 | |||
| 净价价格 | 0.0000 - +元 | 本方交易主体 | 输入交易主体代码 | 3 | ○ | 睿智融科模拟 2110 | 1000003115 | nch | 493 7108 2177.15 | 478 8906 5598.16 | 1 | 0 | 0 | |||
| 全价价格 | 0.0000 - +元 | 本方主体类型 | 机构经纪 | |||||||||||||
| 应计利息 | 元 | 本方客户名称 | ||||||||||||||
| 委托数量 | 10.0 - +万元 | 询价范围 | 已选择 0 个交易商 | |||||||||||||
| 是否匿名 是 否 | ||||||||||||||||
| 结算金额 | 0.00 元 | |||||||||||||||
| 总应计利息 | 元 | |||||||||||||||
| 结算方式 | 多边净额 | |||||||||||||||
| 结算周期 | T<0 |
下单面板×深圳债券交易×上海债券交易×
| 调价申报 | 报价回复 | 调价成交 | ||||||||||||
| 资金账号 2100000038 | 订单方向 | 买入 | 卖出 | |||||||||||
| 证券代码 | 输入债券代码 | 本方交易商 | 输入交易商代码 | 选择 | 券商 | 资金账号 | 账号名称 | 总资产 | 可用资金 | 权重 | 分配量 | 可卖量 | ||
| 计价方式 | 净价 | 全价 | 本方交易员 | 输入交易员代码 | 1 | hrest | 2100000038 | 2100000038 | 10 0000 0000.00 | 10 0000 0000.00 | 1 | 0 | 0 | |
| 净价价格 | 0.000 | - + 元 | 调价范围 | 已选择 0 个交易商 | 2 | 睿智融科模拟 2110 | 1000000312 | 312 | 4255 8490 6342.75 | 4255 8432 5979.25 | 1 | 0 | 0 | |
| 全价价格 | 0.000 | - + 元 | 3 | 睿智融科模拟 2110 | 1000003115 | nch | 493 7108 2177.15 | 478 8906 5598.16 | 1 | 0 | 0 | |||
| 应计利息 | 元 | |||||||||||||
| 委托数量 | 10.0 | - + 万元 | ||||||||||||
| 是否匿名 | 是 | 否 | ||||||||||||
| 结算金额 | 0.00 | 元 | ||||||||||||
| 总应计利息 | 元 | |||||||||||||
| 结算方式 | 多边李额 | |||||||||||||
| 结算周期 | T<0 |

深圳市场:

报价回复,即报价方接收到询价请求后进行报价回复。


支持查看本方收到的询价方发来的申报。选定其中一支申报请求,下方下单面板填充相关信息。委托方向与请求行情中相反。
询价申报行情,即询价方发给报价方的询价请求,为非公开行情,本方只能看到由本方接收的询价请求信息。
深圳市场:

上海市场:

询价成交,即询价方接收到报价方的回复后,对报价方的回复进行确认成交或拒绝成交。


报价回复行情中选定其中一支回复详情,下方下单面板填充相关信息。委托方向与报价回复行情中相反。
报价回复行情,即报价方回复后发给询价方的回复详情。只有询价方能看到报价方回复的报价回复行情。
上海市场:


竞买成交包含竞买预约、竞买申报、应价申报三个面板。
竞买预约由竞买方发起预约申报,支持当日预约撤单和隔日撤单。

竞买预约支持在竞买日之前进行撤单,含当日撤单和隔日撤单。预约撤单面板支持查询当前在途预约委托信息,包含当日预约委托信息和历史预约委托信息。允许选中未撤的预约委托进行撤销。
| 预约重单 | 请输入会约 | 为空间查询所有 | 选择交易商 | 已选择 2 个交易商 | 刷新 | 达年重单 | ||||||||||
| 选择 | 资金账号 | 预约日期 | 委托编号 | 竞买日期 | 竞买场次编号 | 市场 | 证券代码 | 证券名称 | 价格上限 | 价格下限 | 最低成交数量 (8 张) | 委托数量 | 委托方向 | 状态 | ||
竞买申报时,需选择一条在途的竞买预约委托,进行申报。竞买申报下单面板要素与竞买预约要素相同,选择一条预约信息后,下方下单面板要素不可修改。交易方向固定为卖出不可更改。

竞买预约委托支持查询已经发起的在途预约委托信息。支持查询所有本方发起的竞买预约委托。

应价方选择一条竞买申报进行应价,支持输入委托价格,委托价格不可超过价格上下限。委托数量默认竞买申报全额。支持选择是否匿名。交易方向固定为买入不可更改。

支持查询竞买方发起的委托。

本系统支持收益互换业务模块,收益互换业务模块支持股票以及股指期货业务品种下单。
目前支持的业务包括股票、债券、基金和股指期货。支持股票、债券和基金的买入、卖出,支持股指期货买入开仓、卖出开仓和优先平仓设置。
支持限价报单。
支持查看委托、成交、持仓和资金数据。

支持便捷交易(文件单)下单。文件单下单时,交易类型选择收益互换,下单文件中的下单参数与股票、期货一致。
中间文件格式:下单类型,通道号 [,模型价,代码,下单量,股东号]
文件单下单时,需要设置策略名称。有两种设置途径,一是在文件单设置界面的右侧参数设置面板中,在下拉框内选择策略名称,策略名称根据柜台设置显示。二是在文件中使用股东号这个字段,填充策略 ID。

支持批量埋单。设置好监控路径,点击开始监控后,监控路径下产生如下文件夹。
| 名称 | 修改日期 | 类型 | 大小 |
|---|---|---|---|
| XT_CCTJ_IncomeSwap_20220919.dbf | 2022/9/19 17:43 | Database File | 18 KB |
| XT_CJCX_IncomeSwap_20220919.dbf | 2022/9/19 17:43 | Database File | 177 KB |
| XT_CLMC_IncomeSwap_20220919.dbf | 2022/9/19 17:43 | Database File | 2 KB |
| XT_DBF_ORDER.dbf | 2022/9/19 17:43 | Database File | 1 KB |
| XT_DBF_ORDER_result.dbf | 2022/9/19 17:43 | Database File | 1 KB |
| XT_WTCX_IncomeSwap_20220919.dbf | 2022/9/19 17:43 | Database File | 302 KB |
| XT_ZJCX_IncomeSwap_20220919.dbf | 2022/9/19 17:43 | Database File | 2 KB |
其中 CLMC 文件用来查看账号对应的策略名称和策略 ID。
| AccountId | StateyId | StrategyNam | 账号 key | 数据 key |
|---|---|---|---|---|
| thinktrader_test | 2022081200001 | thinktrader-strategy | 8____80002____802000____49____thinktrader_test____ | 2022081200001 |
| thinktrader_test | 2022090200001 | 迅投策略 | 8____80002____802000____49____thinktrader_test____ | 2022090200001 |
使用批量埋单下单时,act_type 参数为必填字段,该字段填充上述文件中的 StategyId 字段;brokertype 字段值为 8,即收益互换账号;其他参数与股票或期货下单参数相同。
在导航栏“银证转账”功能入口和工具栏“查看”点击“银证转账”弹出“银证转账”功能界面。

1.选择转账方向为“银行转证券”;
2.选择要转出资金的“银行账号”;
3.输入银行密码;
4.选择要转入资金的“资金账号”;
5.选择币种,默认“人民币”;
6.设置转账金额;
7.点击【转账】按钮。

【操作步骤】
1.选择转账方向为“证券转银行”;
2.选择要转入资金的“银行账号”;
3.选择要转出资金的“资金账号”;
4.输入资金密码;
5.选择币种,默认“人民币”;
6.设置转账金额;
7.点击查询可取资金,可以查看当前最大可取资金的额度;
8.点击【转账】按钮。

可以根据起始时间和终止时间来筛选某时间段内的转账情况,最多只能查询连续 31 天的数据。如图:

补单即委托状态为“未成交”或“部成”的任务撤单后,未完成量能够再次下单的功能。在任务撤销之后,可以修改交易参数重新下单。股票、两融和组合交易支持补单操作。
当任务状态为未成交或部分成交的时候,任务操作列显示撤销按钮,点击撤销按钮,待委托状态为“已撤”后,操作栏显示“补单”按钮。
| 持仓 | 成交 | 委托 | 任务列表 | 新股申购 | ||||||||||
| 全部任务 | 全部撤销 | 全部暂停 | 全部继续 | 请输入代码 | ||||||||||
| 任务 | 账号 | 账号名称 | 代码 | 名称 | 交易参数 | 交易类型 | 金额 | 进度 | 委托详情 | 操作 | 状态 | 开始时间 | 结束时间 | |
| 任务 1 | 21000 | 210000003 | 600004 | 白云机 | 普通 | 买入 | 4596.0 | 300/600 | 已报 1 收到 1 | 撤消 | 暂停 | 15:320 | 14:19:21 | |
| 持仓 | 成交 | 委托 | 任务列表 | 新股申购 | ||||||||||
| 全部任务 | 全部撤销 | 全部暂停 | 全部继续 | 请输入代码 | ||||||||||
| 任务 | 账号 | 账号名称 | 代码 | 名称 | 交易参数 | 交易类型 | 金额 | 进度 | 委托详情 | 操作 | 状态 | 开始时间 | 结束时间 | |
| 任务 1 | 2100 | 210000003 | 600004 | 白云机 | 普通 | 买入 | 4596.0 | 300/600 | 已报 1 收到 1 | 补单 | 任务结 | 14:19:21 | 14:19:21 | |
| 全部任务 | 全部撤销 | 全部暂停 | 全部继续 | 请输入代码 | ||||||||||
| 任务 | 账号 | 账号名称 | 代码 | 名称 | 交易参数 | 交易类型 | 金额 | 进度 | 委托详情 | 操作 | 状态 | 开始时间 | 结束时间 | |
| 任务 1 | 2100 | 210000003 | 600004 | 白云机 | 普通 | 买人 | 4596.0 | 300/600 | 已报 1 收到 1 | 补单 | 任务结 | 14:19:21 | 14:19:21 | |
| 全选 反选 当前交易参数 普通交易 | ||||||||||||||
| 选择 | 账号 | 市场 | 代码 | 名称 | 交易类型 | 可补单数量 | 补单数量 | |||||||
| 1 | ✓ | 210000038 | SH | 600004 | 白云机场 | 买入 | 300 | 300 | ||||||
| 账号资金添加账号 |

点击补单,弹出补单弹框,如下图所示。设置新的委托价和下单量后,点击“买入/卖出”,弹出下达任务面板,点击确定后,将以修改后的价格及未成交的数量下达一个新任务。
| 持仓 | 成交 | 委托 | 任务列表 | 新股申购 | ||||||||
| 全部任务 | 全部撤销 | 全部暂停 | 全部继续 | 请输入代码 | ||||||||
| 任务 | 账号 | 账号名称 | 代码 | 名称 | 交易参数 | 交易类型 | 金额 | 进度 | 委托详情 | 操作 | 状态 | |
| 白 | 任务 1 | 2100000038 | 买入 | 9192.00 | 600 / 600 | 已报 2 收到 2 | 已完成 | |||||
| 任务 1-2 | 2100000038 | 2100000038 | 600004 | 白云机场 | 普通 | 买入 | 4596.00 | 300 / 300 | 已报 1 收到 1 | 已完成 | ||
| 任务 1-1 | 2100000038 | 2100000038 | 600004 | 白云机场 | 普通 | 买入 | 4596.00 | 300 / 600 | 已报 1 收到 1 | 任务结束,部分委托未完成! | ||
| 原任务 | 补单任务 |
账号为自动填充(不可修改),下单量默认显示为未成交的数量(可在补单面板 - 补单数量一栏修改)。
在原任务数量没有被补完前,可多次补单,直至原任务完全成交。
| 持仓 | 成交 | 委托 | 任务列表 | 新股申购 | ||||||||
| 全部任务 | 全部撤销 | 全部暂停 | 全部继续 | 请输入代码 | ||||||||
| 任务 | 账号 | 账号名称 | 代码 | 名称 | 交易参数 | 交易类型 | 金额 | 进度 | 委托详情 | 操作 | 状态 | |
| 白 | 任务 2 | 2100000038 | 买入 | 7660.00 | 500/600 | 已报 3 收到 3 | 补单 | 已撤销 | ||||
| 任务 2-3 | 2100000038 | 2100000038 | 600004 | 白云机场 | 普通 | 买入 | 1532.00 | 100/100 | 已报 1 收到 1 | 已完成 | ||
| 任务 2-2 | 2100000038 | 2100000038 | 600004 | 白云机场 | 普通 | 买入 | 1532.00 | 100/100 | 已报 1 收到 1 | 已完成 | ||
| 任务 2-1 | 2100000038 | 2100000038 | 600004 | 白云机场 | 普通 | 买入 | 4596.00 | 300/600 | 已报 1 收到 1 | 任务结束,部分委托未完成! | ||
| 任务 1 | 2100000038 | 买入 | 6183.00 | 500/600 | 已报 2 收到 2 | 已完成 |
本系统支持多种函数交易下单,支持设置函数交易参数。

迅投交易函数
函数编辑时,若 passorder 函数的 prType 参数为 -1,则按照参数设置中的价格参数下单。

设置函数交易参数
例:passorder 综合交易下单函数。编辑好函数及参数后,编译保存,在模型交易中新建一条,点击启动并切换到实盘运行模式后,即可等待触发下单。

passorder 综合交易下单函数
便捷交易是 QMT 极速策略交易系统端对外提供的下单服务功能。
当 QMT 极速策略交易系统端启动下单服务时,需要导入一个协议文件(.txt 格式),外部程序和下单服务通过该协议文件进行通讯。
| 操作 | 通道号 | 策略名称 | 交易类型 | 账号组 | 分单类型 | 文件路径 | 用户名 | 密码 | |
| 1 | 启动 | 1 | 策略 1 | 收益互换 | 请选择账号 (组) | 平均分配 | ... | ||
便捷交易界面
在启动便捷交易文件单之前先在文件路径中选中创建的中间文件:
| 便捷交易 | |||||||||
| +增加 删除 ▶全部启动 □全部停止 ? | |||||||||
| 操作 | 通道号 | 策略名称 | 交易类型 | 账号组 | 分单类型 | 文件路径 | 用户名 | 密 | |
| 1 | 启动 | 1 | 策略 1 | 股票交易▼ | 1000000312▼ | 平均分配▼ | mttrade/报单文件... | ||
文件单创建:
格式:记事本格式(.txt);
内容:下单类型,通道号,报价方式,下单代码,下单总量;
注意:中间文件的内容之间用英文半角“,”隔开;
中间文件导入后启动便捷交易策略,文件路径下的中间文件被删除,并弹出下达任务面板产生任务。如果需要取消以上下达任务面板的二次确认操作,可在系统设置 - 下单前提 示设置中取消勾选“便捷交易下单”选项。

便捷交易下单
在便捷交易中支持投资备注,投资备注书写格式如图所示:
新建文本文档.txt-记事本
文件 (F) 编辑 (E) 格式 (O) 查看 (V) 帮助 (H)
25,3,mybasket
投资备注格式
启动策略后,便捷交易中的投资备注会在下单弹框中显示,如图所示:

投资备注显示
投资备注会显示在任务列表、委托、成交面板中。
针对文件单面板中的策略,点击投资备注输入框可以输入相应策略的投资备注信息,如下图在文件单面板设置投注备注。

备注:对于文件单指令使用备注的顺序:若文件单中间文件中有备注时,使
用中间文件中的备注;当中间文件中没有备注时,若文件单面板中有备注,则使用文件单面板中设置的备注;当中间文件和文件单面板中都没有备注时,则备注为空。
当便捷交易策略选择的中间文件中有交易代码时,面板右侧股票代码为非必填项。当便捷交易策略选择的中间文件中没有交易代码时,面板右侧股票代码为必填项,否则,启动便捷交易策略报错。

报错消息
批量埋单功能,支持以 DBF 文件形式将委托、撤单指令传至本系统,在本系统内部经过完整的事前、事中、事后风控后本系统将委托报送至柜台。柜台返回的委托、成交数据迅投系统实时以 DBF 文件形式返回,满足用户交易策略执行、风险控制管理等需求。
文件交互流程如下:
①外部系统在交易端监控路径文件中写入委托参数;
②终端实时扫描监控目录,读取委托参数自动进行委托下单;
③通过主推的方式将委托、成交回报等订单执行情况更新到共享文件中;
④外部系统实时读取共享文件,根据委托、成交回报进行后续委托、撤单任务的下发。
批量埋单交易功能当前支持股票买卖、交易所债券买卖、债券逆回购、交易所基金买卖、港股通买卖、新股申购、新债申购、融资融券、股票期权、期货交易业务。


| 执行中 | 全部来源 | 全选 | 反选 | 选中撤单 | 全部撤单 | 撤买 | 撤卖 | 撤最后一笔 | 请输入代码 | Q | |
| 证券公司 | 资金账号 | 账号名称 | 账号类型 | 账号是否启用 | 账号备注 | 任务编号 | 任务来 | ||||
功能界面
设置路径:选择文件共享路径,系统监控该文件夹下除导出文件外的所有 dbf 类型文件,符合委托、撤单格式即可成功读入委托;委托、成交回报会同步导出至该路径下。
若文件夹下无可读取 dbf 文件,系统将自动生成 XT_DBF_ORDER.dbf 文件。
客户端开启自动开始监控:支持选择是否在客户端开始后自动开启埋单监控。
设置完成后点击开始监控,批量埋单即开始运行。

路径设置
XXX.dbf:委托、撤单文件,支持同时监控多个 dbf 文件。
XXX_result.dbf:XXX.dbf 的反馈文件,对 XXX.dbf 中委托、撤单数据按行进行反馈,以行号对应。如上图 XT_DBF_ORDER_result.dbf 为 XT_DBF_ORDER.dbf 的对应反馈文件,若需更换委托文件,请将对应 result 文件一并删除。
XT_ZJCX_业务类型_#YYYYMMDD#.DBF:记录资金查询信息。
XT_CCMX_业务类型_#YYYYMMDD#.dbf:记录持仓明细信息。
XT_CCTJ_业务类型_#YYYYMMDD#.dbf:记录持仓统计信息。
XT_CJCX_业务类型_#YYYYMMDD#.dbf:记录成交查询信息。
XT_WTCX_业务类型_#YYYYMMDD#.dbf:记录委托查询信息。
业务类型:(1)Stock(2)StockOption(3)Credit(4)Future(5)HGT(6)SGT
扫单间隔:可调整扫单间隔,设置范围为 1-100 毫秒。
当天首次开启监控时自动清理历史报单文件:每天第一次开启监控时,会清空历史报单文件。并且历史报单文件会备份到设置的路径里。如勾选了自动清理历史报单文件功能,备份路径地址不可修改。
合同编号未返回时回填 OrderId 值:需输入非正整数值。合同编号未返回时,下单反馈文件合同编号列显示填入的值。
共享缓存模式读取文件:可支持是否选择共享缓存模式读取文件。
使用增量导出数据:勾选后使用增量导出数据。
设置快捷交易参数:支持在交易端设置参数方案,于委托文件 price_type 中输入快捷算法参数调用对应参数方案下单。

参数设置

下单
消息提示:消息面板会有相应的消息提示,记录‘批量埋单’交易详情。

消息提示
在系统设置中,可调整需要导出的内容。点击系统左上角的‘设置’按钮,切换到【导出设置】页面,选择业务模块,在‘持仓导出’‘委托导出’‘成交导出’界面可调整导出列,目前默认所有字段全部导出。
注意事项:单个 DBF 报单文件写入条数不能超过 6W,超过需要用多个文件来支持。
使用 CSV 预埋单功能,需在管理端全局层及用户层开启批量埋单交易或便捷交易任一功能权限。
设置路径:选择文件共享路径,系统监控该文件夹下除导出文件外的所有 TXT 格式文件,符合委托、撤单格式即可成功读入委托;委托、成交回报会同步导出至该路径下。
客户端开启自动开始监控:支持选择是否在客户端开始后自动开启埋单监控。

设置完成后点击开始监控,预埋单即开始运行。开始监控后,监控路径下针对系统内所有账号自动生成以下文件。
| 名称 | 修改日期 | 类型 | 大小 |
|---|---|---|---|
| signal_backup | 2021/3/15 14:45 | 文件夹 | |
| asset.2100000038_2.20210315.csv | 2021/3/15 14:47 | XLS 工作表 | 1 KB |
| cancel_error.2100000038_2.20210315... | 2021/3/15 14:45 | XLS 工作表 | 0 KB |
| deal.2100000038_2.20210315.csv | 2021/3/15 14:45 | XLS 工作表 | 0 KB |
| order.2100000038_2.20210315.csv | 2021/3/15 14:45 | XLS 工作表 | 0 KB |
| order_error.2100000038_2.20210315.... | 2021/3/15 14:45 | XLS 工作表 | 0 KB |
| position.2100000038_2.20210315.csv | 2021/3/15 14:45 | XLS 工作表 | 1 KB |
(报/撤单文件支持两种格式,其一为不带日期的格式,即 signal.资金账号_账号类型。下单文件序号.txt;其二为带日期的格式,即 signal.资金账号账号类型。下单文件序号.YYYYMMDD.txt。使用带日期的格式时,日期为当天的文件才会被执行,否则不执行,不带日期的文件则无此限制。下单序号支持自定义,不可重复,建议使用数字。)
signal.资金账号_账号类型。下单文件序号 (年月日_时分_秒).txt:报单/撤单文件备份
order.账号_账号类型。日期.csv:记录委托信息
order_error.账号_账号类型。日期.csv:记录报单失败信息
cancel_error.账号_账号类型。日期.csv:记录撤单失败信息
deal.账号_账号类型。日期.csv:记录成交信息、
position.账号_账号类型。日期.csv:记录持仓信息
asset.账号_账号类型。日期.csv:记录资金账号信息
signal_backup 文件夹:报单文件备份整理,以日期为文件夹
其中,账号类型:2-股票 3-信用 7-沪港通 11-深港通
极简模式是 QMT 极速交易系统的精简版,具有高稳定运行、高频率访问、高性能响应、低延迟报单等特点,同时支持 DBF、TXT、CSV 格式文件交互,支持 Python 和 C++ 策略。
极简模式支持股票交易、信用交易和港股通交易。
交易业务模块面板分布如下所示。

股票交易支持买入、卖出、市价买入、市价卖出、科创板盘后定价买入、科创板盘口定价卖出、撤单、策略交易(包括文件单、批量预埋单、CSV 预埋单、功能扩展模块、python 策略和数据导出,后文有详细介绍)、查询功能(包括账号资金、委托、成交、持仓和消息查询)。
点击功能导航栏对应选项(买入、卖出、市价买入、市价卖出、科创板盘后定价买入、科创板盘口定价卖出),下单板进行相应的跳转。
点击功能导航栏中的撤单,右侧跳转到委托面板,可在委托面板中进行撤单操作。
点击功能导航栏对应选项(账号资金、委托、成交、持仓、消息),右侧显示对应的数据查询面板。
股票交易支持的品种有沪深 A 股,科创板,创业板,债券和基金的普通买卖。
信用交易支持担保品买入、担保品卖出、市价买入、市价卖出、融资买入、融券卖出、买券还券、现券还券、现金还款、卖券还款、撤单、策略交易(包括文件单、批量预埋单、CSV 预埋单、功能扩展模块、Python 策略、数据导出,后文有详细介绍)、查询功能(账号资金、委托、成交、持仓、信用标的、负债合约、融券可融数量和消息查询)。
点击功能导航栏对应选项(担保品买入、担保品卖出、市价买入、市价卖出、融资买入、融券卖出、买券还券、现券还券、现金还款、卖券还款),下单板进行相应的跳转。
点击功能导航栏中的撤单,右侧跳转到委托面板,可在委托面板中进行撤单操作。
点击功能导航栏对应选项(账号资金、委托、成交、持仓、信用标的、负债合约、融券可融数量、消息),右侧显示对应的数据查询面板。

港股通支持买入、卖出、撤单、策略交易(包括文件单、批量预埋单、CSV 预埋单、功能扩展模块、Python 策略和数据导出,后文有详细介绍)、查询功能(账号资金、委托、成交、持仓、和消息查询)。
点击功能导航栏对应选项(买入、卖出),下单板进行相应的跳转。
点击功能导航栏中的撤单,右侧跳转到委托面板,可在委托面板中进行撤单操作。
点击功能导航栏对应选项(账号资金、委托、成交、持仓、消息),右侧显示对应的数据查询面板。

便捷交易是通过下单协议发送下单指令。
在交易终端启动便捷交易下单服务前,需要设置交易类型、账号组、分单类型和文件路径等信息时,启动后,需要导入一个协议文件(.txt/.csv 格式),即中间文件。外部程序和下单服务通过该协议文件进行通讯。
扫单时,系统每隔 1 毫秒就自动扫描文件路径下是否有这个文件,若有就读取里面的内容,然后删除该源文件。采用便捷交易方式进行下单时,持仓、资金变化,成交、委托等回报信息通过数据导出界面的设置进行导出更新。
| 策略交易 | 数据导出 | |||||
| 文件单 | 批量预埋单 | CSV 预埋单 | ||||
| +增加 删除 ▶全部启动 □全部停止 ? | ||||||
| 操作 | 通道号 | 策略名称 | 账号 | 文件路径 | ||
| 1 | 启动 | 1 | 策略 1 | 请选择账号 | ||
文件单设置界面如上图所示。可以增加、删除、全部启动和全部停止文件单,点击 可以查看文件单交易使用提示。
以记事本格式(.txt)为例,协议文件大致如下所示,下单协议中的参数依次为:下单类型,通道号,交易市场,交易代码,交易数量,报价类型,交易价格、投资备注(选填)。
新建文本文档.txt - 记事本
文件(F) 编辑(E) 格式(O) 查看(V) 帮助(H)
23 1 SH 600004 100 11 99
交易参数详细说明:
【下单类型】:
23(股票买入,两融担保品买入);
24(股票卖出,两融担保品卖出);
27(融资买入);
28(融券卖出);
29(买券还券);
30(现券还券);
31(卖券还款);
32(现金还款)。
【通道号】:通道号可在界面中查看,其中 0 属于万能通道号。

【交易市场】:填写 SH 或 SZ
【交易代码】:即股票代码,如 600000
【交易数量】:股票交易量的默认单位为:股;(债券最小单位:10;一般股票代码最小单位:100;回购类最小单位:1000;)
【报价类型】:
5-最新价
11-指定价
42-最优五档即成剩撤 (SH)
43-最优五档即成剩转 (SH)
44-对手最优价 (SZ)
45-本方最优价 (SZ)
46-即时成交剩余撤销委托 (SZ)
47-最优五档即时成交剩余撤销委托 (SZ)
48-全额成交或撤 (SZ)
【交易价格】:填写交易的指定价格
撤单协议中的参数依次为:cancel_order 市场代码 合同编号
如需同时撤多个时,直接在尾部添加即可:cancel_order 市场代码 合同编号 市场代码 合同编号...
用户可添加的文件单数量可在券商管理端 - 用户管理 - 设置 - 文件单中进行调整。
批量预埋单功能支持外部系统和交易终端之间通过共享文件的方式实现数据实时交互。
文件交互流程如下:
①外部系统在交易端监控路径文件中写入委托参数;
②终端实时扫描监控目录,读取委托参数自动进行委托下单;
③通过主推的方式将委托、成交回报等订单执行情况更新到共享文件中;
④外部系统实时读取共享文件,根据委托、成交回报进行后续委托、撤单任务的下发。
启动监控前,需设置共享文件路径,路径精确到需监控的 dbf 文件所在的文件夹即可。
持仓、资金变化,成交、委托等回报信息通过数据导出界面的设置进行导出更新。数据导出功能在 2.4.6 章节中进行详细介绍。

客户端开启自动开始监控:支持选择是否在客户端开始后自动开启埋单监控。
委托状态更新写入 result 文件:如果不勾选,反馈文件就不更新数据,如果勾选,委托状态变了就会更新到反馈文件里面去。
系统开启交易监控后会检索设置路径下的文件,下单文件的文件名不做限制(与导出文件不同名即可)。
开始报单后,系统将自动生成报单反馈文件,可在文件中查看报单状态等信息。

用户可通过策略交易中的数据导出功能,设置导出文件。

下单文件中的交易参数有格式和顺序要求,需要按顺序依次填入字段。
| ORDER_TYPE | PRICE_TYPE | MODE_PRICE | STOCK_CODE | VOLUME | ACCOUNT_ID | ACC_TYPE | BROKERTYPE |
|---|---|---|---|---|---|---|---|
| cancel_order | 2_11194_114910_49_800000_ | 570425346 | 2 | 撤单 | |||
| 23 | 1 | SH600000 | 200 | 2_11194_114910_49_800000_ | 49 | 报单 |
| 序号 | 字段名 | 类型 | 说明 | 必填 | 备注 |
|---|---|---|---|---|---|
| 1 | order_type | String | 下单类型 | Y | 23-股票买入 24-股票卖出 27-融资买入 28-融券卖出 29-买券还券 30-直接还券 31-卖券还款 |
| 32-直接还款 | |||||
| 2 | price_type | String | 委托价格类型 | Y | 1-最新价 3-指定价 6-盘后定价 M1-最优五档即成剩撤 (SH)M2-最优五档即成剩转 (SH)M3-即时成交剩余撤销委托 (SZ)M4-全额成交或撤 (SZ)M5-本方最优价 (SZ)M6-对手最优价 (SZ)M7-最优五档即时成交剩余撤销委托 (SZ) |
| 3 | mode_price | String | 委托价格 | N | 该字段仅 price_type 为 3-指定价、6-科创盘后定价时生效 |
| 4 | stock_code | String | 证券代码 | Y | 支持格式为市场代码 + 证券代码,如 SH600000 |
| 5 | volume | String | 委托数量 | Y | -- |
| 6 | account_id | String | 下单资金账号 | Y | 支持入参账号 key |
| 7 | acc_type | String | 账号类别 | N | 49-资金账号 |
| 8 | brokertype | String | 账号类型 | N | 2-股票账号 3-信用账号不填时进行模糊匹配 |
| 9 | strategy | String | 策略备注 | N | 通过策略下单的,可在此列自定义策略备注 |
| 10 | note | String | 投资备注 | N | 成交、委托查询该字段原样返回 |
| 序号 | 字段名 | 类型 | 说明 | 必填 | 备注 |
|---|---|---|---|---|---|
| 1 | 不指定 | String | 下单类型 | Y | 撤单填 cancel_order(使用 orderId 撤单)或 cancel(使用合同编号撤单) |
| 2 | 不指定 | String | 资金账号 | Y | 支持入参账号 key |
| 3 | 不指定 | String | 委托合同编号 | Y | 对应委托查询中合同编号(ordersysid)或 orderid |
| 4 | 不指定 | String | 市场 | Y | SH 或 SZ,使用合同编号(ordersysid)撤单时填写,否则不填写 |
| 5-7 | 不指定 | string | 空 | N | 无需填写 |
| 8 | brokertype | String | 账号类型 | Y | 2-股票账号 3-信用账号 |
下单后,扫单路径中会生成如下两个文件,可在对应的文件中查看下单详情和结果反馈。
order_result.dbf
委托反馈文件*_result.dbf 文件中字段如下所示:
| 序号 | 字段名 | 类型 | 说明 | 备注 |
|---|---|---|---|---|
| 1 | ORDERID | String | 委托合同编号 | 多个 orderid 用@分隔 |
| 2 | MESSAGE | String | 委托/撤单状态信息 | |
| 3 | STATUS | String | 委托/撤单状态 | 1-结束 0-执行中 -1-失败 |
| 4 | STRATEGY | String | 策略备注 | 该字段返回下单文件中填入的策略备注 |
| 5 | NOTE | String | 投资备注 | 该字段返回下单文件中填入的投资备注 |
| 6 | MARKET | String | 市场 | SH 或 SZ |
| 7 | ORDERSYSID | String | 合同编号 | 对应委托查询中的合同编号 |
采用批量埋单方式进行下单时,持仓、资金变化,成交、委托等回报信息也可通过数据导出界面的设置进行导出更新。数据导出功能在 2.4.6 章节中进行详细介绍。
CSV 预埋单功能支持外部系统和交易终端之间通过共享文件的方式实现数据实时交互。
文件交互流程如下:
①外部系统在交易端监控路径文件中写入委托参数;
②终端实时扫描监控目录,读取报单参数自动进行委托下单;
③通过主推的方式将委托、成交回报等订单执行情况更新到相应文件中;
④外部系统实时读取文件,根据委托、成交回报进行后续委托、撤单任务的下发。
持仓、资金变化,成交、委托等回报信息通过数据导出界面的设置进行导出更新。数据导出功能在 2.4.6 章节中进行详细介绍。
客户端开启自动开始监控
设置路径:选择文件共享路径,系统监控该文件夹下除导出文件外的所有 TXT 格式文件,符合委托、撤单格式即可成功读入委托;委托、成交回报会同步导出至该路径下。
客户端开启自动开始监控:支持选择是否在客户端开始后自动开启埋单监控。
设置完成后点击开始监控,预埋单即开始运行。
下单文件中的交易参数有格式和顺序要求,需要按顺序依次填入字段。
委托字段说明:
| 文件名 | signal.资金账号_账号类型。下单文件序号.txt | ||||
| 序号 | 字段名 | 类型 | 说明 | 必填 | 备注 |
| 1 | 不指定 | String | 投资备注 | Y | 可自定义投资备注 |
| 2 | 不指定 | String | 报单类型 | Y | 23-证券买入/担保品买入 24-证券卖出/担保品卖出 27-融资买入 28-融资卖出 29-买券还券 30-直接还券 31-卖券还款 32-直接还款 |
| cancel_sys-使用合同编号撤单 cancel_id-使用订单编号撤单 | |||||
| 3 | 不指定 | String | 报价方式 | Y | 1-最新价 2-指定价 6-科创盘后定价 M1-最优五档即成剩撤 (SH)M2-最优五档即成剩转 (SH)M3-即时成交剩余撤销委托 (SZ)M4-全额成交或撤 (SZ)M5-本方最优价 (SZ)M6-对手最优价 (SZ)M7-最优五档即时成交剩余撤销委托 (SZ) |
| 4 | 不指定 | String | 报单价格 | Y | |
| 5 | 不指定 | String | 证券代码 | Y | 支持格式为"市场代码 + 证券代码",如 SH600000 |
| 6 | 不指定 | String | 下单总量 | Y | |
| 7 | 不指定 | String | 策略名称 | Y |
撤单字段说明:
| 文件名 | signal.资金账号_账号类型。下单文件序号.txt | ||||
| 序号: | 字段名 | 类型 | 说明 | 必填 | 备注 |
| 1 | 不指定 | String | 报单类型 | Y | cancel_sys 或 cancel_id |
| 2 | 不指定 | String | 撤单编号 | Y | 当使用 cancel_sys 进行撤单时,此处填写合同编号;当使用 cancel_id 进行撤单时,此处填写订单编号; |
| 3 | 不指定 | String | 市场 | Y | SZ-深交所 SH-上证所 SGT-深港通 HGT-沪港通 |
下单文件序号为自定义,建议使用数字。
账号类型:2-股票 3-信用 7-沪港通 11-深港通
功能扩展模块即使用 c++ 语言编写的策略文件进行策略交易。功能扩展模块和 python 策略使用共同的程序界面,界面主要分为以下四个分区。其中,策略设置面板默认显示智能日内回转策略设置面板。
用户通过【策略管理面板】,单击不同的策略,来切换【策略设置面板】中的策略,根据策略的不同,设置项也不尽相同。以下示例图片中为智能日内回转策略的设置面板。用户在选择账号并设置完毕后,可点击确定对策略设置进行保存。保存后,【策略运行状态管理面板】中会新增一条策略数据,用户可在此启停策略,了解策略运行状态。
针对功能扩展模块策略,同一个资金账号,针对同一个策略,只可创建一条。
针对 python 策略,同一个资金账号,针对同一个策略,可创建多条,并可同时处于运行中状态。
策略在运行过程中,不可修改策略设置,需停止后再进行修改。

【策略统计】中统计功能扩展模块策略运行产生的交易数据。在策略未产生交易的情况下,一个资金账号对应有一条数据,该条数据显示当天所有途径报单的交易数据。策略启动并产生交易后,对应的资金账号会增加一条策略名称为当前运行中策略的数据,在该条数据上,可查看该策略当日产生的交易数据,并进行手工配平操作。
| 策略统计 | 策略日志 | ||||||||||||||||
| 手续费设置 | 权重设置 | 配平参数:最新价,超价:0.00% | |||||||||||||||||
| 资金账号 | 账号名称 | 账号类型 | 经纪公司 | 策略名称 | 运行状态 | 运行中委托 | 总买量 | 总卖量 | 净买量 | 总买额 | 总卖额 | 净买额 | 手续费 | 盈亏 | 配平 | 操作 | |
| 1 | 1000000352 | 352 | 股票 | 睿智融科模拟 2110 | 0 | 10000 | 59700 | -49700 | 348620.00 | 627328.00 | -278708.00 | 0.00 | 2402.00 | 278068.00 | 配平 | ||
| 2 | 1000000352 | 352 | 股票 | 睿智融科模拟 2110 | XtTradeFramework | 停止 | 0 | 10000 | 59700 | -49700 | 348620.00 | 627328.00 | -278708.00 | 0.00 | 2402.00 | 278068.00 | 配平 |
点击配平,显示策略配平界面,可选择配平所有待配平的股票。配平时,系统会撤销运行中委托并重新报单。

如当前系统中有运行中委托,配平界面中会显示“全部撤销”按钮,可点击撤销所有运行中委托。
| 策略配平 [1000000352] [XtTradeFramework] | ||||||||
| 全选 反选 | ||||||||
| 选择 | 市场 | 证券代码 | 证券名称 | 盈亏 | 配平操作 | 配平量 | 操作 | |
| 1 | ✓ | SH | 603887 | 城地股份 | 251.47 | 买入 | 600 | |
| 2 | ✓ | SH | 603897 | 长城科技 | 105.57 | 买入 | 1400 | |
| 3 | ✓ | SH | 603899 | 晨光文具 | -112.72 | 买入 | 200 | |
| 4 | ✓ | SH | 603908 | 牧高笛 | 32.44 | 买入 | 200 | |
| 5 | ✓ | SH | 603912 | 佳力图 | 148.85 | 买入 | 600 | |
| 6 | ✓ | SH | 603916 | 苏博特 | -25.63 | 买入 | 300 | |
| 7 | ✓ | SH | 603933 | 睿能科技 | 54.04 | 买入 | 200 | |
| 8 | ✓ | SH | 603938 | 三孚股份 | -128.96 | 买入 | 500 | |
| 9 | ✓ | SH | 603960 | 克来机电 | 456.34 | 买入 | 800 | |
【策略统计】中可设置策略配平参数,参数对配平下单生效。

【策略统计】中还可设置手续费和涨跌停股票盈亏计算权重。
| 合计 | |||||||
| 策略统计 | 策略日志 | ||||||
| 手续费设置 | 权重设置 | 配平参数:配平策略:pythonbalance | ||||||
| 资金账号 | 账号名称 | 账号类型 | 经纪公司 | 策略名称 | 运行状态 | 运行中委 | |
| 1 | 1000000352 | 352 | 股票 | 睿智融科模拟 2110 | 0 | ||
| 2 | 1000000352 | 352 | 股票 | 睿智融科模拟 2110 | XtTradeFramework | 停止 | 0 |
Python 策略即使用 python 语言编写的策略文件进行策略交易。python 策略和功能扩展模块使用共同的程序界面。
策略管理面板中,可新建策略交易(python),编辑策略,删除策略或打开本地策略文件夹。

用户通过【策略管理面板】,单击不同的策略,来切换【策略设置面板】中的策略。用户在选择账号并保存后,【策略运行状态管理面板】中会新增一条策略数据,用户可在此启停策略,了解策略运行状态。
针对 python 策略,同一个资金账号,针对同一个策略,可创建多条,并可同时处于运行中状态。
策略在运行过程中,不可修改策略设置,需停止后再进行修改。
使用数据导出功能,可定时导出系统中的资产、持仓、委托和成交等数据。导出数据字段说明详见 3.1.数据导出字段说明。
| 选择 | 账号 | 数据项 | 状态 | |||||||||
| 1 | □ | 400083 | 资产 | 持仓 | 委托 | 成交 | 汇率 | 结算单 | 资金流水 | 停止 | ||
| 2 | □ | 10499 | 停止 | |||||||||
| 3 | □ | 0240125049 | 持仓 | 委托 | 成交 | 结算单 | 资金流水 | 中签信息 | 新股额度 | 配 | 停止 | |
| 4 | □ | 803020 | 持仓 | 委托 | 成交 | 结算单 | 资金流水 | 中签信息 | 新股额度 | 配 | 停止 | |
| 5 | □ | 803023 | 持仓 | 委托 | 成交 | 结算单 | 资金流水 | 中签信息 | 新股额度 | 配 | 停止 | |
| 6 | □ | 94697086 | 成交 | 两融标的 | 担保品 | 可融券 | 负债合约 | 结算单 | 资金流水 | 中 | 停止 | |
| 7 | □ | 200151 | 成交 | 两融标的 | 担保品 | 可融券 | 负债合约 | 结算单 | 资金流水 | 中 | 停止 | |
| 8 | □ | 200153 | 成交 | 两融标的 | 担保品 | 可融券 | 负债合约 | 结算单 | 资金流水 | 中 | 停止 | |
| 9 | □ | 500113 | 停止 | |||||||||
| 10 | □ | 500234 | 停止 | |||||||||
| 11 | □ | 500248 | 停止 | |||||||||
| 12 | □ | 1201950062 | 停止 | |||||||||
| 13 | □ | 300204 | 资产 | 持仓 | 委托 | 成交 | 汇率 | 结算单 | 资金流水 | 停止 | ||
用户可在数据导出界面设置保存路径,以及针对哪些数据进行导出。导出数据的格式可设置为 DBF/TXT/CSV。委托和成交数据更新为增量更新,其中 TXT/CSV增量更新为在文件末尾插入新的数据,DBF 增量更新为针对某条数据进行状态更新。默认导出间隔 1ms。
| 200222618_account.dbf | 2020/9/8 10:25 | Database File | 1 KB |
|---|---|---|---|
| 200222618_deals.dbf | 2020/9/8 10:25 | Database File | 1 KB |
| 200222618_orders.dbf | 2020/9/8 10:25 | Database File | 1 KB |
| 200222618_positions.dbf | 2020/9/8 10:25 | Database File | 3 KB |
| 8008802545_account.dbf | 2020/9/8 10:25 | Database File | 1 KB |
| 8008802545_assures.dbf | 2020/9/8 10:25 | Database File | 1 KB |
| 8008802545_compacts.dbf | 2020/9/8 10:25 | Database File | 1 KB |
| 8008802545_deals.dbf | 2020/9/8 10:25 | Database File | 1 KB |
| 8008802545_orders.dbf | 2020/9/8 10:25 | Database File | 2 KB |
| 8008802545_positions.dbf | 2020/9/8 10:25 | Database File | 2 KB |
| 8008802545_slocodes.dbf | 2020/9/8 10:25 | Database File | 1 KB |
| 8008802545_subjects.dbf | 2020/9/8 10:25 | Database File | 322 KB |
文件命名规则:
| 数据类型 | 命名规则 |
|---|---|
| 持仓 | 资金账号_positions.* |
| 委托 | 资金账号_orders.* |
| 成交 | 资金账号_deal.* |
| 资金 | 资金账号_account.* |
| 两融担保品 | 资金账号_assures.* |
| 两融负债合约 | 资金账号_compacts.* |
| 融券可融数量 | 资金账号_slocodes.* |
| 融资融券标的 | 资金账号_subjects.* |
| 配号信息 | _IPOLuckyInfo. |
| 结算单 | _stkDelivery. |
| 资金流水 | _stkFundFlow. |
| 新股额度 | _subscribInfo. |
| 中签信息 | _subscribNumber. |
| 汇率 | _exchangeRate. |
点击设置,打开系统设置面板。交易设置包括如下设置项。

支持取消常规下单和市价/涨跌停价下单前提示框,当勾选设置项后,进行下单操作时,系统会弹出二次确认框,确认后可下单,如未勾选则不需二次确认。

勾选双击委托撤单后,双击委托面板未成委托,可进行撤单。
| 1 | □ | 200120 | 13:38:36 | 600000 | 浦发银行 | 融资买入 | 部成 | 1000 | 500 | 0 | 7.25 | 7.25 | 0.00 | 0.00 | 39195 | 上证所 | 普通头寸 |
设置系统中金额等数字的显示格式,如当前设置为千分位格式时,系统显示格式如下。

勾选此设置项后,下单面板选择代码后回车,会跳过价格设置栏。
勾选此设置项后,下单面板选择代码后回车,会跳过交易量设置栏。
可设置买入缺省值和卖出缺省值,如设置缺省值均为第 5 档价格,下单板价格处将默认填充第五档价格。

| 卖 5 | 3.72 | 499 |
|---|---|---|
| 卖 4 | 3.71 | 843 |
| 卖 3 | 3.70 | 863 |
| 卖 2 | 3.69 | 1249 |
| 卖 1 | 3.68 | 2549 |
| 最新 | 3.68 | +0.06 |
| 买 1 | 3.67 | 400 |
| 买 2 | 3.66 | 1009 |
| 买 3 | 3.65 | 766 |
| 买 4 | 3.64 | 689 |
| 买 5 | 3.63 | 1271 |
| 现价 | 3.68 涨停 | 3.98 |
| 前收 | 3.62 跌停 | 3.26 |
目前支持结算单、资金流水、申购额度、中签查询、配号查询按设置天数导出历史数据。

(8)客户端账号资金计算方式,可以选择计算方式,如下图所示。

点击自动化重启设置,可以勾选启用开机自动启动和自动初始化设置,如下图所示。

点击消息提示,跳转到消息提示面板。

点击状态栏中的行情源,可打开行情源设置面板。用户可增加、删除和修改当前系统中的行情源地址,切换连接的行情源。同时可设置全推行情权限为最新价、一档行情或五档行情。
| 行情主站 | |||||||
| 名称 | 地址 | 端口 | 状态 | 行情数据 | 速度 | 操作 | |
| 1 | 140.201 | 已断开 | 删除修改连接 | ||||
| 2 | 211.152. | 已断开 | 删除修改连接 | ||||
| 3 | 211.152. | 已断开 | 删除修改连接 | ||||
| 4 | 61.152.10 | 已断开 | 删除修改连接 | ||||
| 5 | 61.152.102 | 已断开 | 删除修改连接 | ||||
| 6 | 61.152.102 | 已断开 | 删除修改连接 | ||||
| 7 | 61.152.102 | 已断开 | 删除修改连接 | ||||
| 交易中心 | |||||||
| 名称 | 地址 | 端口 | 状态 | 行情数据 | 操作 | ||
| 1 | 迅投深港通资管集中行情 | 121.12.106. | 55 | 已断开 | 删除修改连接 | ||
| 2 | 迅投深港通资管集中行情 | 175.25. | 50 | 已断开 | 删除修改连接 | ||
| 3 | BJ_xtquoter | 192.168. | 30 | 已连接 | 上海_L1... | 删除修改断开 | |
点击服务器,可查看当前连接的交易服务器地址。

点击客服,可发送日志到输入的邮箱地址。

| 文件名 | *_account.* | |||
| 功能 | 资金查询 | |||
| 说明 | 支持查询账号资金数据*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | 备注 |
| 1 | 账号 | String | 账号 | |
| 2 | 总资产 | String | 总资产 | |
| 3 | 可用资金 | String | 可用资金 | |
| 4 | 总市值 | String | 总市值 | |
| 5 | 股票市值 | String | 股票市值 | |
| 6 | 基金市值 | String | 基金市值 | |
| 7 | 盈亏 | String | 盈亏 | |
| 8 | 交易日 | String | 交易日 | |
| 9 | 登录状态 | String | 登录状态 | 尚未登录准备登录登录中登录成功登录失败初始化中休市中 |
| 10 | 可取资金 | String | 可取资金 | |
| 11 | 总负债 | String | 总负债 | 信用账号字段 |
| 12 | 可用保证金 | String | 可用保证金 | 信用账号字段 |
| 13 | 维持担保比 | String | 维持担保比 | 信用账号字段 |
| 14 | 净资产 | String | 净资产 | 信用账号字段 |
| 15 | 融资负债 | String | 融资负债 | 信用账号字段 |
| 16 | 融资本金 | String | 融资本金 | 信用账号字段 |
| 17 | 融资息费 | String | 融资息费 | 信用账号字段 |
| 18 | 融券负债 | String | 融券负债 | 信用账号字段 |
| 19 | 融券市值 | String | 融券市值 | 信用账号字段 |
| 20 | 融券息费 | String | 融券息费 | 信用账号字段 |
| 21 | 其它费用 | String | 其它费用 | 信用账号字段 |
| 22 | 融资授信额 | String | 融资授信额 | 信用账号字段 |
| 23 | 融资可用额 | String | 融资可用额 | 信用账号字段 |
| 24 | 融资冻结额 | String | 融资冻结额 | 信用账号字段 |
| 25 | 融券授信额 | String | 融券授信额 | 信用账号字段 |
| 26 | 融券可用额 | String | 融券可用额 | 信用账号字段 |
| 27 | 融券冻结额 | String | 融券冻结额 | 信用账号字段 |
| 28 | 融券卖出额 | String | 融券卖出额 | 信用账号字段 |
| 29 | 已用融卖额 | String | 已用融卖额 | 信用账号字段 |
| 30 | 剩余融卖额 | String | 剩余融卖额 | 信用账号字段 |
| 文件名 | *_deals.* | |||
| 功能 | 成交查询 | |||
| 说明 | 支持查询成交数据*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | |
| 1 | 账号 | String | 账号 | |
| 2 | 市场 | String | 市场 | SH-上证所 SZ-深交所 |
| 3 | 证券代码 | String | 证券代码 | |
| 4 | 操作 | String | 操作 | 买入卖出 |
| 5 | 成交价格 | String | 成交价格 | |
| 6 | 成交数量 | String | 成交数量 | |
| 7 | 成交金额 | String | 成交金额 | |
| 8 | 手续费 | String | 手续费 | |
| 9 | 成交日期 | String | 成交日期 | |
| 10 | 成交时间 | String | 成交时间 | |
| 11 | 委托编号 | String | 委托编号 | |
| 12 | 成交编号 | String | 成交编号 | |
| 13 | 订单编号 | String | 订单编号 | |
| 14 | 策略名称 | String | 策略名称 | |
| 15 | 备注 | String | 备注 | |
| 16 | 委托类型 | String | 委托类型 | 48-买卖 49-查询 50-撤单 52-确认 54-融资委托 55-融券委托 56-信用平仓 57-信用普通委托 |
| 文件名 | *_orders.* | |||
| 功能 | 委托查询 | |||
| 说明 | 支持查询委托数据*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | |
| 1 | 账号 | String | 账号 | |
| 2 | 市场 | String | 市场 | SH-上证所 SZ-深交所 |
| 3 | 证券代码 | String | 证券代码 | |
| 4 | 操作 | String | 操作 | 买入卖出 |
| 5 | 报价类型 | String | 报价类型 | 限价市价最优价 |
| 6 | 委托价格 | String | 委托价格 | |
| 7 | 委托数量 | String | 委托数量 | |
| 8 | 委托日期 | String | 委托日期 | |
| 9 | 委托时间 | String | 委托时间 | |
| 10 | 委托编号 | String | 委托编号 | |
| 11 | 委托状态 | String | 委托状态 | 未报待报已报已报待撤部成待撤部撤已撤部成已成废单 |
| 12 | 成交数量 | String | 成交数量 | |
| 13 | 成交均价 | String | 成交均价 | |
| 14 | 成交金额 | String | 成交金额 | |
| 15 | 撤单数量 | String | 撤单数量 | |
| 16 | 订单编号 | String | 订单编号 | |
| 17 | 策略名称 | String | 策略名称 | |
| 18 | 备注 | String | 备注 | |
| 19 | 废单原因 | String | 废单原因 | |
| 20 | 委托类型 | String | 委托类型 | 48-买卖 49-查询 50-撤单 52-确认 54-融资委托 55-融券委托 56-信用平仓 57-信用普通委托 |
| 文件名 | *_positions.* | |||
| 功能 | 持仓查询 | |||
| 说明 | 支持查询持仓数据*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | |
| 1 | 账号 | String | 账号 | |
| 2 | 市场 | String | 市场 | SH-上证所 SZ-深交所 |
| 3 | 证券代码 | String | 证券代码 | |
| 4 | 当前拥股 | String | 当前拥股 | |
| 5 | 可用数量 | String | 可用数量 | |
| 6 | 在途数量 | String | 在途数量 | |
| 7 | 冻结数量 | String | 冻结数量 | |
| 8 | 昨夜拥股 | String | 昨夜拥股 | |
| 9 | 成本价 | String | 成本价 | |
| 10 | 市值 | String | 市值 | |
| 11 | 盈亏 | String | 盈亏 |
| 文件名 | *_assures.* | |||
| 功能 | 两融担保品查询 | |||
| 说明 | 支持查询两融担保品数据*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | |
| 1 | 账号 | String | 账号 | |
| 2 | 市场 | String | 市场 | SH-上证所 SZ-深交所 |
| 3 | 证券代码 | String | 证券代码 | |
| 4 | 是否可担保 | String | 是否可担保 | 担保品非担保品 |
| 5 | 担保折算比 | String | 担保折算比 |
| 文件名 | *_compacts.* | |||
| 功能 | 负债合约查询 | |||
| 说明 | 支持查询两融负债合约数据*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | |
| 1 | 账号 | String | 账号 | |
| 2 | 市场 | String | 市场 | SH-上证所 SZ-深交所 |
| 3 | 证券代码 | String | 证券代码 | |
| 4 | 合约类型 | String | 合约类型 | 融资融券不限制 |
| 5 | 合约编号 | String | 合约编号 | |
| 6 | 头寸来源 | String | 头寸来源 | 普通头寸专项头寸不限制 |
| 7 | 开仓日期 | String | 开仓日期 | |
| 8 | 到期日 | String | 到期日 | |
| 9 | 合约数量 | String | 合约数量 | |
| 10 | 未还数量 | String | 未还数量 | |
| 11 | 合约金额 | String | 合约金额 | |
| 12 | 未还金额 | String | 未还金额 | |
| 13 | 合约息费 | String | 合约息费 | |
| 14 | 未还息费 | String | 未还息费 | |
| 15 | 已还金额 | String | 已还金额 | |
| 16 | 已还息费 | String | 已还息费 |
| 文件名 | *_slocodes.* | |||
| 功能 | 融券可融数量查询 | |||
| 说明 | 支持查询融券可融数量*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | |
| 1 | 账号 | String | 账号 | |
| 2 | 市场 | String | 市场 | SH-上证所 SZ-深交所 |
| 3 | 证券代码 | String | 证券代码 | |
| 4 | 头寸性质 | String | 头寸性质 | 普通专项 |
| 5 | 融券可融量 | String | 融券可融量 |
| 文件名 | *_subjects.* | |||
| 功能 | 融资融券标的查询 | |||
| 说明 | 支持查询融资融券标的*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | 备注 |
| 1 | 账号 | String | 账号 | |
| 2 | 市场 | String | 市场 | SH-上证所 |
| SZ-深交所 | ||||
| 3 | 证券代码 | String | 证券代码 | |
| 4 | 融资状态 | String | 融资状态 | 正常暂停作废 |
| 5 | 融资保证比 | String | 融资保证比 | |
| 6 | 融券状态 | String | 融券状态 | 正常暂停作废 |
| 7 | 融券保证比 | String | 融券保证比 |
| 文件名 | *_IPOLuckyInfo.* | |||
| 功能 | 配号信息查询 | |||
| 说明 | 支持查询新股配号信息*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | 备注 |
| 1 | 成功 | Bool | 是否成功 | |
| 2 | 返回信息 | String | 错误信息 | |
| 3 | 交易市场类别 | String | 交易市场类别 | |
| 4 | 股东代码 | String | 股东代码 | |
| 5 | 股票代码 | String | 股票代码 | |
| 6 | 中签数量 | Double | 中签数量 | |
| 7 | 中签价格 | Double | 中签价格 | |
| 8 | 中签金额 | Double | 中签金额 | |
| 9 | 放弃数量 | Double | 放弃数量 | |
| 10 | 中签编号 | String | 中签编号 | |
| 11 | 股票名称 | String | 股票名称 | |
| 12 | 中签日期 | Int | 中签日期 | |
| 13 | 申购日期 | String | 申购日期 | |
| 14 | 资金账号 | String | 账号信息 |
| 文件名 | _stkDelivery. |
|---|---|
| 功能 | 结算单查询 |
| 说明 | 支持查询结算单信息*由于 dbf 格式限制,表头仅显示前十个字符 |
| 编码 | GBK |
| 出参: |
| 序号 | 字段名 | 类型 | 说明 | 备注 |
|---|---|---|---|---|
| 1 | 成功 | Bool | 是否成功 | |
| 2 | 错误 | String | 错误信息 | |
| 3 | 日期 | Int | 日期 | |
| 4 | 成交时间 | Int | 时间 | |
| 5 | 市场类型 | String | 市场类型 | |
| 6 | 市场 | String | 市场 | |
| 7 | 股票账号 | String | 股票账号 | |
| 8 | 证券代码 | String | 证券代码 | |
| 9 | 证券名称 | String | 证券名称 | |
| 10 | 买卖 | String | 买卖 | |
| 11 | 操作 | String | 操作 | |
| 12 | 成交数量 | Double | 成交数量 | |
| 13 | 成交价格 | Double | 成交价格 | |
| 14 | 成交金额 | Double | 成交金额 | |
| 15 | 资金余额 | Double | 资金余额 | |
| 16 | 股份余额 | Double | 股份余额 | |
| 17 | 成交序号 | String | 成交序号 | |
| 18 | 手续费 | Double | 手续费 | |
| 19 | 印花税 | Double | 印花税 | |
| 20 | 其他杂费 | Double | 其他杂费 | |
| 21 | 委托号 | String | 委托号 | |
| 22 | 资金账号 | 账号信息 | ||
| 23 | 业务类型 | Int | 业务类型 | |
| 24 | 业务名称 | String | 业务名称 | |
| 25 | 记录序列号 | String | 记录序列号 |
| 文件名 | *_stkFundFlow.* | |||
| 功能 | 资金流水查询 | |||
| 说明 | 支持查询资金流水*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | 备注 |
| 1 | 成功 | Bool | 是否成功 | |
| 2 | 返回信息 | String | 错误信息 | |
| 3 | 账号信息 | String | 账号信息 | |
| 4 | 发生日期 | Int | 发生日期 | |
| 5 | 发生时间 | Int | 发生时间 | |
| 6 | 流水序号 | String | 流水序号 | |
| 7 | 业务类型 | String | 业务类型 | |
| 8 | 业务名称 | String | 业务名称 | |
| 9 | 发生数量 | Double | 发生数量 | |
| 10 | 剩余数量 | Double | 剩余数量 | |
| 11 | 币种 | String | 币种 | |
| 12 | 交易市场类别 | String | 交易市场类别 | |
| 13 | 资金账号 | String | 资金账号 | |
| 14 | 证券代码 | String | 证券代码 | |
| 15 | 定位串 | String | 定位串 | |
| 16 | 证券名称 | String | 证券名称 | |
| 17 | 成交价格 | Double | 成交价格 | |
| 18 | 成交金额 | Double | 成交金额 | |
| 19 | 手续费 | Double | 手续费 | |
| 20 | 印花税 | Double | 印花税 | |
| 21 | 过户费 | Double | 过户费 | |
| 22 | 其他费用 | Double | 其他费用 | |
| 23 | 发生数量/金额 | Double | 发生数量/金额 | |
| 24 | 剩余数量/金额 | Double | 剩余数量/金额 | |
| 25 | 委托价格 | Double | 委托价格 | |
| 26 | 委托数量 | Double | 委托数量 | |
| 27 | 股东账号 | String | 股东账号 | |
| 28 | 成交序列号 | String | 成交序列号 | |
| 29 | 委托号 | String | 委托号 | |
| 30 | 买卖方向 | String | 买卖方向 |
| 文件名 | *_subscribInfo.* | |||
| 功能 | 新股额度查询 | |||
| 说明 | 支持查询新股额度*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | 备注 |
| 1 | 资金账号 | String | 账号信息 | |
| 2 | 证券市场 | Int | 证券市场 | |
| 3 | 证券代码 | String | 证券代码 | |
| 4 | 可申购额度 | Int | 可申购额度 | |
| 5 | 科创板可申 | Int | 科创板可申购额 | |
| 购额度 | 度 |
| 文件名 | *_subscribNumber.* | |||
| 功能 | 中签信息查询 | |||
| 说明 | 支持查询中签信息*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | 备注 |
| 1 | 成功 | Bool | 是否成功 | |
| 2 | 返回信息 | String | 错误信息 | |
| 3 | 资金账号 | String | 账号信息 | |
| 4 | 市场 | String | 市场 | |
| 5 | 交易市场类别 | String | 交易市场类别 | |
| 6 | 股票代码 | String | 股票代码 | |
| 7 | 股票名称 | String | 股票名称 | |
| 8 | 起始配号 | String | 起始配号 | |
| 9 | 配号数量 | Double | 配号数量 | |
| 10 | 股东账号 | String | 股东账号 | |
| 11 | 配号日期 | String | 配号日期 | |
| 12 | 申购日期 | String | 申购日期 |
| 文件名 | *_exchangeRate.* | |||
| 功能 | 汇率查询 | |||
| 说明 | 支持查询汇率信息*由于 dbf 格式限制,表头仅显示前十个字符 | |||
| 编码 | GBK | |||
| 出参: | ||||
| 序号 | 字段名 | 类型 | 说明 | 备注 |
| 1 | 市场 | string | 市场 | |
| 2 | 币种 | String | 币种 | |
| 3 | 买参汇率 | String | 买参汇率 | |
| 4 | 日买浮动比 | String | 日买浮动比 | |
| 5 | 夜买浮动比 | String | 夜买浮动比 | |
| 6 | 卖参汇率 | String | 卖参汇率 | |
| 7 | 日卖浮动比 | String | 日卖浮动比 | |
| 8 | 夜卖浮动比 | String | 夜卖浮动比 | |
| 9 | 中间汇率 | Double | 中间汇率 | |
| 10 | 日期 | String | 日期 | |
| 11 | 买结汇率 | String | 买结汇率 | |
| 12 | 卖结汇率 | String | 卖结汇率 |
| 策略交易 | 数据导出 | |||||
| 文件单 | 信号单 | 批量预埋单 | CSV 预埋单 | |||
| +增加 删除 ▶全部启动 □全部停止 ? | ||||||
| 操作 | 通道号 | 策略名称 | 账号 | 文件路径 | ||
便捷交易设置界面如上图所示。可以增加、删除、全部启动和全部停止便捷交易,点击 可以查看便捷交易交易使用提示。
以记事本格式(.txt)为例,协议文件大致如下所示,下单协议中的参数依次为:下单类型,通道号,交易市场,交易代码,交易数量,报价类型,交易价格、投资备注(选填)。
新建文本文档.txt - 记事本
文件(F) 编辑(E) 格式(O) 查看(V) 帮助(H)
23 1 SH 600004 100 11 99
交易参数详细说明:
【下单类型】:
23(股票买入,两融担保品买入);
24(股票卖出,两融担保品卖出);
27(融资买入);
28(融券卖出);
29(买券还券);
30(现券还券);
31(卖券还款);
32(现金还款)。
【通道号】:通道号可在界面中查看,其中 0 属于万能通道号。
+ 增加 删除 ▷ 全部启动 □ 全部停止 ?
| 操作 | 通道号 | 策略名称 | 账号 | 文件路径 | |
|---|---|---|---|---|---|
| 1 | 启动 | 1 | 策略 1 | 1000000352 | unk16549/迅投极速交易终端 香智融科版/bin.x64/新版 |
| 2 | 启动 | 2 | 策略 2 | 请选择账号 | |
【交易市场】:填写 SH 或 SZ
【交易代码】:即股票代码,如 600000
【交易数量】:股票交易量的默认单位为:股;(债券最小单位:10;一般股票代码最小单位:100;回购类最小单位:1000;)
【报价类型】:
5-最新价
11-指定价
42-最优五档即成剩撤 (SH)
43-最优五档即成剩转 (SH)
44-对手最优价 (SZ)
46-即时成交剩余撤销委托 (SZ)
47-最优五档即时成交剩余撤销委托 (SZ)
48-全额成交或撤 (SZ)
撤单协议中的参数依次为:cancel_order 市场代码 合同编号
如需同时撤多个时,直接在尾部添加即可:cancel_order 市场代码 合同编号 市场代码 合同编号...
用户可添加的便捷交易数量可在券商管理端 - 用户管理 - 设置 - 便捷交易中进行调整。
为方便用户进行投资研究,优化模型,支持 Jupyter Notebook,使用方法与 jupyter 一致。

可新建 notebook,文本文件和文件夹等。

可在 notebook 中进行编写和运行等操作,功能与 jupyter notebook 一致。
Jupyter Untitled Last Checkpoint: a few seconds ago (unsaved changes)
文件 编辑 发送 插入 单元格 指号 帮助 Kernel starting, please wait. Trusted / 指号
In [ ]:
Jupyter notebook 中可使用 QMT 中提供的 API 接口,具体接口如下所示:
'write_file',
'read_file',
'get_last_volume',
'get_sector',
'get_industry',
'get_stock_list_in_sector',
'get_weight_in_index',
'get_contract_multiplier',
'get_risk_free_rate',
'get_financial_data',
'get_market_data',
'get_divid_factors',
'get_main_contract',
'timetag_to_date_time',
'get_trading_dates'
如下可查看 API 具体使用方法。获取行情数据之前需先通过数据管理功能补充相应数据。

顶部左上角用户名可点击,点击可查看迅投 QMT 交易终端版本及系统信息。

终端版本
用户名右侧为工具栏,工具栏包含设置、操作、布局、当前账号(可选择),右上角有用户协议、交易、帮助、回转交易和换肤功能,并显示当前数据日期,中间模型研究、模型交易。
顶部工具栏
①执行中委托:点击执行中委托,主界面跳转到委托面板 - 执行中界面。
| 执行中 | 下单面板 | 持仓 | 委托 | ||||||||||||||
| 执行中 | 全部来源 | 全选 | 反选 | 选中撤单 | 全部撤单 | 撤买 | 撤卖 | 请输入代码 | |||||||||
| 选择 | 资金账号 | 委托时间 | 证券代码 | 证券名称 | 买卖标记 | 委托量 | 委托剩余量 | 成交数量 | 委托状态 | 委托价格 | 成交均价 | 合同编号 | 投资备注 | 冻结金额 | 冻结手续 | ||
| 交易 | 板块 | 模型 | 扩展数据 | ||||||||||||||
| 执行中委托:0 执行中任务:0 消息提示:0 执行中策略:0 沪深 300 |
执行中委托
②执行中任务:点击执行中任务,主界面跳转到任务列表 - 执行中界面。
| 执行中委托:0 执行中任务:0 消息提示:0 | 执行中策略:0 科创 50 + + |
执行中任务
③消息提示:点击消息提示,主界面跳转到消息提示界面。

④极简模式:点击极简模式图标,打开极简模式界面。

⑤指数信息:状态栏滚动显示上证指数,沪深,创业板指数,和沪深 300 指数。双击可在行情界面中显示相应指数的分时图。

双击指数到分时图
⑥交易所公告:点击可查看交易所的重要公告。

交易所公告
⑦字体扩大功能:支持扩大整个软件的字体大小。

⑧CSV 预埋,便捷交易和批量埋单:CSV 预埋,便捷交易和批量埋单入口。

便捷交易、批量埋单和 CSV 预埋入口
- □ ×
| 操作 | 通道号 | 策略名称 | 交易类型 | 账号组 | 分单类型 | 文件路径 | 用户名 | ||
| 1 | 启动 | 1 | 策略 1 | 期货交易 | 请选择账号 (组) | 平均分配 | ... | ||
| 总 量 0 - + 手 |
便捷交易
- □ ×
选择路径
投\qmt\迅投极速交易终端\qmt-sp3-8590\export_data
开始监控
扫描间隔设置:1ms(设置范围 1-100 毫秒,默认 1 毫秒)
设置快捷交易参数:
使用增量导出数据
客户端开启自动开始监控
当天首次开启监控时自动清理历史报单文件
选择备份路径
\迅投极速交易终端\qmt-sp3-8590\export_data_backup
合同编号未返回时回填 0rderId 值
-1
(请输入非正整数值)
共享缓存模式读取文件
委托查询
成交查询
| 执行中 | 全部来源 | 全选 | 反选 | 选中撤单 | 全部撤单 | 撤买 | 撤卖 | 撤最后一笔 | 请输入代码 | |
| 证券公司 | 资金账号 | 账号名称 | 账号类型 | 账号是否启用 | 账号备注 | 任务编号 | 任务来 | |||
批量埋单
CSV 埋单交易
监控路径 投\qmt\迅投极速交易终端\qmt-sp3-8590\export_data 开始监控
客户端开启自动开始监控

CSV 预埋
⑨交易:查看当前系统中登录账号的连接状态,当有任一账号登录不成功时,显示为红色。

⑩行情源:登录到软件之后,点击行情源,可在此进行行情源的编辑与选择。当行情主站或交易中心中所有链接均未成功时,此处行情显示为红色状态。
| 行情主站 | |||||||
| 名称 | 地址 | 端口 | 状态 | 行情数据 | 速度 | 操作 | |
| 1 | 已断开 | 删除 修改 连接 | |||||
| 2 | 迅找...清 | 2 | 50 | 已断开 | 删除 修改 连接 | ||
| 3 | 迅找...清 | 2 | 5000 | 已断开 | 删除 修改 连接 | ||
| 4 | 迅找...清 | 已断开 | 删除 修改 连接 | ||||
| 交易中心 | |||||||
| 名称 | 地址 | 端口 | 状态 | 行情数据 | 速度 | 操作 | |
| 1 | 迅找...清 | 51 | 已断开 | 删除 修改 连接 | |||
| 2 | 已断开 | 删除 修改 连接 | |||||
| 3 | 迅找...清 | 21 | 55 | 已连接 | 上期所_L1... | 删除 修改 断开 | |
| 4 | 已断开 | 其它 | 删除 修改 连接 | ||||
登录后行情选择界面
行情总览中可查看当前所连接的各部分的行情地址。
| 行情源 | |||||||
| 行情选择 | 智能下载 | 快速下载 | 批量下载 | ||||
| +增加 | 测速 | 恢复默认 | 行情总览 | 全推行情:最新价 | |||
| 行情总览 | |||||||
| 行情源 | |||||||
| 1 | 期权行情 | 上期权_L1 | |||||
| 2 | 期货行情 | 大商所_L1 | 中全所_L1 | 上期所_L1 | 郑商所_L1 | ||
| 3 | 港股行情 | 深港通_L1 | 沪港通_L1 | ||||
| 4 | 股票行情 | 北京_L1 | 上海_L1 | 深圳_L1 | |||
| 5 | |||||||
行情总览
在智能下载界面下载、更新不同种类和范围的历史数据。

登录后智能下载界面
在快速下载标签页内快速下载当日数据,并设置自动下载等选项。
当勾选了迅投高级数据时,默认下载沪深 A 股内外盘日线数据,左侧勾选任何品种均不生效。当迅投高级数据与其他当日数据类型同时勾选时,其他数据类型也默认下载沪深 A 股的内外盘数据。例如:勾选迅投高级数据 +5 分钟数据,则下载沪深 A 股日线内外盘数据 + 沪深 A 股 5 分钟线内外盘数据。

登录后快速下载界面
批量下载功能可以在选择指定品种,数据范围和想要下载的数据类型选项后开始下载所选范围内包含的所有数据。

登录后批量下载界面
鼠标悬浮时显示交易服务器和端口及市场状态服务器、端口、服务器版本和网络延迟情况。

查看服务器连接地址端口
鼠标点击时显示网络延迟情况。

网络延迟
⑫使用网络标准时间:右下角选择时间可选择使用网络标准时间或者本地时间。

网络标准时间
⑬执行中策略:左下角点击执行中策略,打开执行中策略界面。

提供交易设置、快捷键设置、界面定制、账号管理、账号组设置、风控设置、密码设置、导出设置等。

设置界面
交易设置分为以下几部分。

交易设置界面
下单前提示设置点击 可选择出现下单提示的情况,下单时会有下达指令的弹框提示。

下单前提示设置选择

下达任务提示
| 账号 | 市场 | 代码 | 股票名称 | 交易类型 | 分配量 | 最新市值 | 基准价 | 委托价 | 提示信息 | 触价价格 | ||
| 1 | 1000003115 | SH | 601882 | 海天精工 | 买入 | 100 | 1692.00 | 18.88 | 18.88 | 将以涨停价 [18.88] 报单 | - | |
| 投资备注 请选择或输入任务备注 始终显示 确定 取消 |
下达任务提示
勾选 后,点击执行中委托、执行中任务、重要消息和紧急消息后,可直接弹出相应面板。未勾选该选项时,点击各项后,直接在界面上跳转。

面板弹出
勾选 下单出错提示,则当下单量不符合规定、在交易时间外进行交易、未选择或登录资金账号、可用资金不足等情况出现时,在客户端右下角会出现报警
信息提示。

报警信息
勾选后,双击执行中委托可直接撤单。
设置在当日持仓中双击持仓时直接平仓,或仅填充到下单板。
驳回点击超过频率委托处理下拉框 超过频率委托处理排队 显示 若选择驳回,则超过报单频率的委托进行驳回处理;若选择排队,则超过报单频率的委托进行排队处理。
设置股票/期货数据界面刷新间隔,交易界面 - 持仓面板中的股票或期货数据会按照设置每隔一段时间刷新一次。
设置好阈值,当资金账号面板的报撤单比显示的值大于或等于设置的阈值时会显示红色。当撤单比显示的值小于设置的阈值时,字体显示黑色(适用于股票交易、融资融券、组合交易中的证券交易)。
勾选后,柜台会在设置的间隔时间反馈一次数据。
自定义锁定时间是为了防止信息泄露。勾选并设置时间,无操作一定时间后客户端自动锁定。
当勾选 函数交易无下单权限时生成篮子默认格式 权限,使用函数交易下单,管理端未开启函数交易下单权限时,所下的单会自动生成篮子保存在本地。可选择保存模默认格式默认格式式外部格式
勾选后,便捷交易执行过的文件将备份到指定路径下。
勾选后,在交易面板切换交易类型时,上方行情展示部分会根据当前所在交易类型,切换到对应的行情板块。
勾选后,可以使用期权合约快捷键功能
金额显示有三种格式,普通、千分位、万分位。各个面板中的金额或者数量会根据不同的格式显示。
沪港通/深港通交易可选择货币种类:人民币和港币。
勾选篮子自动导入并选择路径后,组合交易中的篮子管理内自动导入一栏会将文件夹里的篮子自动导入(股票和期货篮子都支持,仅支持 CSV 文件)。当勾选自动用最新篮子填充组合交易,下单面板中选择篮子选项会自动填入最新的篮子。
目前自动导入的频率为 1 秒。
| 下单面板 | 委托 | 成交 | 消息提示 | 篮子管理 | 持仓 | 组合任务 | |||||||
| 股票篮子 | + | G | 601882 | 海天精工 | + | 导入篮子 | ? | 导出篮子 | 删除 | ||||
| 新建篮子 | × | 代码 | 名称 | 数量 | 相对权重 | 绝对权重 | 昨收 | 涨停 | 跌停 | 方向 | |||
| 期货篮子 | + | G | |||||||||||
| 沪伦通篮子 | + | G | |||||||||||
| 沪港通篮子 | + | G | |||||||||||
| 深港通篮子 | + | G | |||||||||||
| 自动导入 |

启动篮子自动导入
(18)指定价下单方式回车跳过价格设置
勾选指定价下单方式回车跳过价格设置 报价方式为“指定价”,输入合约代码回车焦点跳到总量;未勾选时,输入合约代码回车焦点跳到委托价。其他报价方式勾不勾选回车后焦点都会跳到总量。

指定价下单方式回车跳过价格设置
勾选 所有下单方式回车跳过交易量设置 报价方式为“指定价”时输入合约后回车后焦点跳到委托价,再回车焦点跳到“买入”按钮上;除“指定价”报单方式,输入合约后,回车焦点跳到“买入”按钮。

所有价格下单方式回车跳过交易量设置
勾选指定价默认报价方式,在指定价下切换股票代码,指定价会按照交易设置中的默认买入缺省和卖出缺省显示。若不勾选指定价默认报价方式,委托价显示上一次的价格。该功能适用于股票和信用。
不勾选买卖使用相同的参数 在进行买 - 卖时,修改任意一个报价方式,另一买卖使用相同的参数个报价方式不会随之改变。勾选 修改任意一个报价方式,另一个报价方式会变为与之相同。
勾选 启用行情主图双击买卖点直接撤单 后,当在分时图显示交易详情时,双击 B/S 买卖点可直接撤单,不再需要二次确认。

勾选启用外部自动导入期权指标,选择路径后可把需要导入的期权指标数据文件放到相应路径下,系统会每隔一段时间扫描路径下文件并导入展示在期权 T 型板中,详情见 3.3.2.5.8.外部导入希腊值。

启用外部自动导入期权指标
勾选后启用订单编号功能。订单编号是迅投 QMT 系统为提升系统的交易速度推出的一项重大功能改进。使用订单编号功能可以显著地降低系统的穿透时延。
订单编号的工作原理如下:
客户端向 QMT 的服务发起委托时,QMT 的服务立即生成一个唯一的订单编号,并推送给客户端。服务端随后继续向柜台发起报单操作。客户端接收到订单编号主推后,会生成一条合同编号为空的委托,量化系统可以用这条委托来确认单子已经报送成功,并且可以用订单编号来发起撤单操作。后续有委托和成交更新时,对应的委托和成交都会带上正确的订单编号,确保 QMT 客户端和外围程序都能正确匹配订单信息。在实现的过程中,我们已经充分考虑了各种时序问题,确保订单编号在不同的时序下都能按照上述说明正确工作。
只有服务器和客户端均支持订单编号功能时,用户才能正常使用订单编号功能。当服务已经升级,但继续使用老版本客户端时,客户端不会受到订单编号功能的影响。
股票交易,融资融券,组合交易和 ETF 申赎的委托面板和成交面板中新增订单编号字段。

用户在使用便捷交易、批量埋单、策略交易时,可使用订单编号撤单。
勾选后,同一用户在不同机器使用智能算法下单时,其智能算法任务可在多终端共享,共享到其他终端时,任务编号由十万开始累加。
(26)允许 load_stk_list 函数重命名文件
勾选允许 1oad_stk_list 函数重命名文件,允许使用 load_stk_list 函数重命名文件
下单后清空下单板内 总量点击下单后清空下单板内下拉框 显示

港股通持仓可选择使用汇率:中间汇率、买入参考汇率和卖出参考汇率。
(29)期权合约虚度值阈值
期权合约虚度值阈值 10.00 20 设置期权合约虚度值阈值 后,小于设置虚度值不提醒,大于虚度值会提醒大于设定值,是否继续下单。
期权合约虚度值阈值默认大于 10% 提醒,不能设置大于 100% 的值,可以设置负值。
如图,支持点击盘口数量快速下单功能。
□ 点击盘口数量启用快速下单
单击盘口数量填充委托价和总量累加量,双击盘口数量填充委托价和总量累加量或下单板默认量(根据下边的设置)并提交下单
总量累加量:若点击卖③量,则自动填入卖①量+卖②量+卖③量的累加量 × 累加量比例
● 盘口委托累加量 ○ 用户自填量
累加量比例 100 - + %
可以设置各个交易类型在交易类型菜单栏中是否显示。设置后需要重新启动客户端才能生效。

交易类型设置
可以设置各种交易类型的平仓参数。勾选双击持仓平仓时,平仓的参数按照平仓设置的参数进行。

可以设置使用增强交易智能回转策略时的配平参数。

①启用开机自动启动:当电脑开机时,客户端会自动启动,输入用户名密码即可登录。

启用开机自动重启
②启用自动重启:自动重启功能则是用户可设定不同的时间重启客户端。勾选“启用自动重启”后,才可添加、编辑和删除设定的时间。勾选后确定,设置的重启时间生效,到了设定的时间客户端会自动重启。若未勾选“启用自动重启”,设定的重启时间则会失效,客户端不会自动重启。

启用自动重启后,客户端会在该时间自动关闭和重启。系统关闭的前 10 秒,消息提示和页面右下角会弹出关于重启客户端的提示。

自动重启消息提示
键盘精灵可监控键盘操作。当焦点在行情界面时,键盘精灵支持输入数字和拼音快捷搜索代码。可自定义为不同的分类设置选择是否启用键盘精灵。不启用时,键盘精灵无法查询到该分类下的代码。

键盘精灵配置

键盘精灵
可为输入下单总量提供快捷选择。在常用量一~常用量九中输入具体的数值,点击确定保存设置。

常用量设置
②点击【下单面板】“总量”前的 变为 状态,表示开启常用量设置。点击总量输入框,显示设置的所有常用量,点击其中的某个常用量可以自动将该常用量输入到总量输入框中。

使用常用量

常用量设置中,新增“设置常用量价”,支持针对代码设置默认量价,此处维护常用量价并开启常用量设置(点击【下单面板】“总量”前的 变为 状态)时,输入代码即自动填充量价:

输入代码点击新增即可往下新增一条数据,量可点击输入、价可点击选择,操作中可删除。
量支持两种设置方式:1.固定数量;2.持仓量的百分比。输入框中点击单位切换。

点击批量导入可批量导入常用量价:

帮助
下单面板输入对应代码将按此处设置默认填充量价
导入默认价格对应参数:
Sx-卖×价,如 S1-卖 1 价
Bx-买 x 价,如 B1-买 1 价
1-最新价 2-对手价 3-指定价 4-昨收价 5-挂单价
默认卖出价,支持 csv/xls 格式,示例:
| 代码 | 市场 | 默认买入量 | 默认买入价 | 默认卖出量 | 默认卖出价 |
|---|---|---|---|---|---|
| 600000 | SH | 100 | S1 | 100 | B1 |
| 000001 | SZ | 100 | S1 | 100 | B1 |
常用量价支持针对分类设置默认量价,分类默认量价优先级低于单票默认量价。

*备注:总量输入框前有 符号的,才支持常用量功能。
在行情设置中对各分析周期的参数进行设置后,在行情界面中右键单击鼠标选择多日线、多小时线和多分钟线等 K 线种类时,其周期与所设置的参数相匹配。

未勾选 时,只能显现当天的分笔数据,即使补充完成历史分笔数据也不能查看。

分笔图只查看当日数据
勾选此功能后,可以查看所有的保存在本地的历史分笔数据。

分笔图查看本地所有分笔数据
未勾选更换线周期时固定副图指标 时,更换周期时副图指标不固定,会被取消。勾选后,更换周期时副图指标固定不取消。

副图指标
未勾选 时,切换股票代码时副图指标不固定,会被取消。勾选后,切换股票代码副图指标固定不取消。
勾选 启用监视剪贴板后,当系统监视到剪贴板中有股票代码或股票名称后,会自动弹出“智能输入”框。

器推送和本地计算。千档处理模式选择本地计算,沪市 L2 极速十档和千档模式不再显示,只能看普通十档。本地计算模式只支持深圳市场。
服务器千档最新价来源。千档处理模式选择本地计算,服务器千档最新价来源置灰不生效。千档处理模式选择服务器推送,服务器千档最新价来源可以点开下拉框选择,选择默认,千档最新价正常显示,选择逐笔成交,最新价来源方式与逐笔成交一致。
千档处理模式 - 本地计算

千档处理模式 - 服务器推送
勾选全推行情数据存盘 后,全推行情数据会保存到本地 quoter 文件夹下,不勾选全推行情数据存盘,全推行情数据不会保存到本地。
勾选订阅 k 线全推 订阅 k 线全推 后,K 线按全推方式订阅,不勾选订阅 k 线全推,K 线按单股订阅模式订阅。
在消息设置中,可以对系统消息、交易消息、行情消息、风控消息、报警消息、成交消息、模型消息、站内消息、身份证过期提醒、用户到期提醒、转账消息、适当性校验消息、预埋单执行日志进行面板显示、声音提示、弹框提示和停留时间的设置。

消息设置
对期权合约的历史波动率设置。

历史波动率设置
勾选“是否使用自定义”,即可对历史波动率进行手动编辑,自定义历史波动率数值,则 T 型板中希腊值计算时取自定义的历史波动率进行计算;取消勾选“是否使用自定义”,则 T 型板中希腊值计算时取行情获取的历史波动率数值进行计算。T 型板中历史波动率不跟随是否自定义变化,取自行情数据。

系统设置
勾选 ✅ 关键数字控件加粗 可将系统中部分交易面板中的数字字段加粗。
勾选 提示系统预留信息 管理终端进行了预留信息设置,登录交易终端时将提示管理终端设置的预留消息。
勾选 上次登录信息提示 客户端右下角出现上次登录信息提示;未勾选重新登录客户端不会显示。
勾选,勾选客户端仅显示异常信息;不勾选则显示【消息设置】里面设置的信息。

客户端对 Python 库的下载以及路径的选择的设置。在使用 python 模型功能时,需首先下载 python 库。当后续 python 库有更新时,会在用户在登录时提示。
对不同交易类型自定义设置快捷键,设置后,需要勾选启用快捷键,才会启用。
| 功能说明 | 键值设定 | |
|---|---|---|
| 1 | 按照当前参数快速“买入” | 无 |
| 2 | 按照当前参数快速“卖出” | 无 |
| 3 | 按照当前参数快速“转股” | 无 |
| 4 | 按照当前参数快速“回售” | 无 |
| 5 | 双向交易按照单位“百 增加”总量” | 无 |
| 6 | 双向交易按照单位“百 减少”总量” | 无 |
| 7 | 双向委托面板按照当前参数快速“买入” | Return |
| 8 | 双向委托面板按照当前参数快速“卖出” | 无 |
| 9 | 双向交易按照价格变动单位增加委托价 | 无 |
| 10 | 双向交易按照价格变动单位减少委托价 | 无 |
| 11 | 双向交易委托价变动单位 | 分 |
| 12 | 双向交易切换买入 | 卖一价 F1 |
| 13 | 双向交易切换卖出 | 买一价 F2 |
| 14 | 双向委托面板价格默认选择位数 | 全部 |
| 15 | 按照涨停价 快速“买入” | 无 |
| 16 | 按照跌停价 快速“卖出” | 无 |
快捷键设置
当勾选启用多下单面板快捷定位 可对多个下单面板进行快捷键(Alt+ 数字)定位。

多下单面板
此时焦点在面板 1 上,使用快捷键 Alt+2,焦点转到面板 2。

Alt+ 数字切换下单面板
行情的快捷键是默认的,无法对其修改。

行情快捷键
自定义选择不同交易类型不同交易界面是否显示该功能界面功能名称。

界面定制
例如,股票交易中,未勾选和勾选持仓中的股票清仓功能显示结果如下图:
| 持仓 | × | 成交 | × | 委托 | × | 任务列表 | × | |
| 卖出参数 | 请输入代码 | 刷新 | ||||||
| 资金账号 | 证券代码 | 证券名称 | 当前拥股 | 可用数量 | 次 | |||
| 1 | 1000000312 | 601939 | 建设银行 | 1500 股 | 1500 股 | |||
| 2 | 1000000312 | 603658 | 安图生物 | 100 股 | 100 股 | |||
| 3 | 1000000312 | 601882 | 海天精 T | 20000 股 | 20000 股 |
无勾选股票清仓功能键
| 持仓 | 成交 | 委托 | 任务列表 | ||
| 股票清仓 液出参数 请输入代码 刷新 | |||||
| 资金账号 | 证券代码 | 证券名称 | 当前拥股 | 可用数量 | |
| 1 | 1000000312 | 601939 | 建设银行 | 1500 股 | 150 |
| 2 | 1000000312 | 603658 | 安图生物 | 100 股 | 10 |
| 3 | 1000000312 | 601882 | 海干情 T | 20000 股 | 2000 |
勾选股票清仓
显示当前用户已添加的所有账号,可以对账号进行启用(停用)、删除、手续费设置、修改交易密码、修改资金密码操作。
可以进行账号添加操作。输入账号类型、交易平台、经纪公司、资金账号、密码、确认密码后,点击登陆校验,校验成功后点击确认,账号添加成功。

方便用户进行多个账号委托,提供证券、期货、融资融券、股票期权、沪港通、深港通账号分组、组内账号的默认交易权重等设置,通过选择账号,快速建立相应的账号组,配合多种分单策略,实现多个账号的批量交易。

账号组设置
添加完成的账号组在分单方式的账号选择中作为选项出现,可选择相应账号组分单。

下单面板选择账号组
风控是迅投 QMT 极速策略交易系统中一个相当重要的部分,采用了多层次并行风控的处理方式,可以对单一帐号、多个帐号分别同时进行不同规则的风控检查,大幅降低交易延迟、提高风控执行效率。风控逻辑严格准确,若任何一条不符合,立即返回相应的结果,确保资产管理业务安全至上。
风控主要分为事前、事中、事后三种类型。事前风控包含了交易合规检查、仓位检查、交易限制检查、资产占比检查、到期合约提醒等;事中风控包含实时计算无延迟、盘中异常交易监控;事后风控包含交易数据自动同步、预警提示、全部交易数据留痕。其主要作用就是实时监控委托以及整个系统当前的状况是否违反了在风控系统中设置的规则,并根据风控设置进行相应的处理。
风控在功能上主要分为风控设置和风控查询两部分,风控设置完成后,通过上传云配置将风控设置信息传送到云端,用户可通过下载配置查询风控信息。如果设置风控密码后,修改风控设置必须先输入密码。

风控设置
风控设置中可设置账号风控、账号组风控、Pyhotn 库白名单、设置风控密码、查看证券分类,在管理端可以设置全局风控。
| 交易设置 | 快捷键设置 | 界面定制 | 账号管理 | 账号组设置 | 风控设置 | 密码设置 | 导出设置 |
| 账号风控 | |||||||
| 期货账号 | |||||||
| 证券账号 | |||||||
| 信用账号 | |||||||
| 股票期权账号 | |||||||
| 沪港通账号 | |||||||
| 深港通账号 | |||||||
| 账号组风控 | |||||||
| 账号组 | |||||||
| Python 库白名单 | |||||||
| 密码管理 | |||||||
| 设置风控密码 | |||||||
| 数据管理 | |||||||
| 证券分类 | |||||||
| 3 合计 |
风控设置
交易端账号风控和账号组风控可选择两种风格进行设置,普通风格和迅投风格。普通风格提供直观的风控设置方式,迅投风格提供丰富多样的风控设置方式。

风控两种显示风格设置
账号列表中展示所有已被添加的账号,在操作列中点击设置按钮进行账号风控设置。账号风控设置分为黑白名单、交易限制、资产组合风控、个股限制和交易所合规。

账号风控
账号黑白名单可以在下单前对证券和期货交易进行设置,属于事前风控。“黑名单”中的代码或分类被禁止交易,“白名单”中的代码或分类允许参与交易。
如果没有设置黑白名单,默认所有证券都为白名单。

如果黑、白名单都设置,且黑、白名单之间不存在交集,那么除了白名单外都属于黑名单;如果黑、白名单都设置,且黑、白名单存在交集,白名单为白名单除了黑、白名单交集的部分,其它为黑名单。只设置黑名单,不设置白名单,属于黑名单模式--黑名单以内的禁止交易。只设置白名单,不设置黑名单,属于白名单模式--白名单以内的允许交易。
同一代码、分类不能既存在于黑名单又存在于白名单。当勾选不限制卖出/平仓,黑名单中的股票代码可以卖出,黑名单中的期货合约可以平仓。黑白名单的普通风格和迅投风格样式一致。
例如,设置 000002 万科 A 为黑名单,000001 平安银行为白名单。

证券账号黑白名单
风控触发
QMT 系统提供对证券、期货、信用、深港通和沪港通交易的交易量价限制,对股票期权提供交易量价限制和交易价格限制。交易量价限制可以对证券、期货等添加不同分类的代码,设置交易量价限制后超过限制下单会被风控驳回。
交易量价可以设置生效时间、生效日期和生效条件。交易量价限制包含对市价、涨停价、跌停价、与最新价偏离超过设置百分比、与昨日收盘价偏离超过设置百分比、单笔最大委托量、单笔最大金额的限制,禁止股票涨停卖出,禁止股
票跌停买入。
例如:设置单笔最大金额是 200,则每笔下单金额超过 200 会被风控驳回。

交易量价限制

风控触发
股票期权的交易价格限制是针对期权的希腊值指标δ、γ、ν的限制,超过限制下单会被风控驳回。黑白名单的普通风格和迅投风格样式基本一致。

股票期权交易价格限制

当勾选 _ 时,再次对其下单,仅会出现告警,但不禁止。告警信息如图。
设置账号的交易合规是为了控制单个资金账号的交易风险。其中证券帐号包含频率合规、数量合规、比例合规、增强频率合规,信用账号交易合规包含频率合规、数量合规、比例合规、金额合规,股票期权包含频率合规、数量合规、比例合规、增强频率合规和行为合规。期货账号交易合规包含频率合规和数量合规。沪港通账号和深港通账号交易合规包含频率合规。

金额合规
只告警不禁止
限制日内最大净买入
元不限制大宗交易
当日净买入=当日累计买入申报 - 当日累计卖出成交 - 当日累计买入申报撤单
增强频率合规
只告警不禁止
添加类别
| 序号 | 名称 | 操作 |
|---|---|---|
交易合规
对上交所和深交所的报单频率限制。
账号设置 -800159
风控设置
数量合规
只告警不禁止

交易合规 - 频率合规

风控触发
客户端系统设置交易设置中可以选择超过频率委托处理方式,设置为“排队”,当报单频率超过了设置的频率合规时会延迟报单,待时间过后再排队进行报单;设置为“驳回”,当报单频率超过了设置的频率合规时指令会被驳回。

超出频率委托设置
限制当日的最大委托次数,证券限制的是该帐号当日的所有委托,期货可以分别限制不同品种的委托次数、撤单次数、持仓量,支持投机、套利、套保。
例如限制委托次数:

交易合规 - 数量合规

风控触发
比例合规是针对当日撤单、委托、成交的限制,具体分为撤单比、废单比、成交比限制。下单后达到限制的指令会被风控驳回。若设置轮询时间,每次轮询时若检查到到撤单比、废单比、成交比达到所设置的比例,将会报风控轮询消息,当前执行中的任务会暂停。
例如限制成交比:

交易合规 - 比例合规

风控触发
金额合规是针对当日净买入金额的限制,如果当日净买入金额超过了设置,下单会产生风控报警,禁止开仓,未超过时可正常下单。
公式:当日净买入金额=当日成交中买入金额 + 冻结金额(不包括逆回购)- 当日成交中卖出金额(卖出部分如果是部分成交的话,未成交部分不用计算)。

交易合规 - 金额合规
风控触发
交易合规中的“增强频率合规”,用以对特定频率申报行为或申报并撤销行为的日内出现次数进行控制。
股票交易可分别针对上证所和深交所证券设置增强频率合规,股票期权可针对上期权设置增强频率合规。
比如设置日内最大出现 2 次每 30000 毫秒申报 2 笔的交易频率限制。

增强频率合规

风控触发
股票期权交易合规中的“行为合规”,用以对特定行为进行控制。当资金账号的委托数量达到设定的数量后,出现特定的行为即可对其进行警告或禁止。
例如日内申报在 2 笔以上,且存在 30 秒内完成申报并撤销申报的行为等。

行为合规

风控触发
如下图所示。

期权交易合规(普通风格)

期权交易合规(迅投风格)

证券交易合规(普通风格)

证券交易合规(迅投风格)

期货交易合规(普通风格)

期货交易合规(迅投风格)

沪港通交易合规(普通风格)

沪港通交易合规(迅投风格)

信用账号交易合规(普通风格)

信用账号交易合规(迅投风格)

深港通交易合规(迅投风格)

深港通交易合规(普通风格)
资产组合风控即对投资者的一组或多组资产进行风险控制,通过设置各项风控条款去限制交易操作,减少或避免风险事件发生的各种可能性,减少风险事件发生时造成的损失。
设置时需要选择资产组合规则,设置生效日期、时间、条件,添加资产指标,对设置指标进行分档限制。

资产组合风控
资产组合风控可以自定义添加资产组合风控规则,目前分类为法规、合同、操作,如下图:

添加资产组合风控
可自定义生效日期、时间、条件,只有在设置的生效日期、时间、条件范围内,设置的资产组合风控才会被检查。如下图:

生效条件
资产类型是系统证券分类中的全部分类,如下图:

资产类别
资产范围证券类包含了全部和单只,期货类包含全部、单只(具体的一个合约)、单品种(cu、y、if、cf 等合约品种),如下图:

资产范围
组合资产指标支持添加多个。选择分母后可设置占比,在占比范围内是被允许的,不在占比范围内则视为违反设置的资产组合风控法规。设置轮询将会轮询检查该资产组和风控,若有违规则产生报警消息。
下单时检查到不满足设置的资产组合风控比例范围,则会提示禁止开仓,被风控驳回。例:设置所有证券的全部市值*权重/总资产占比小于 0,若实际占比大于 0 则触发风控。

占比设置

风控触发
当前产品比例在设置的占比范围内,所设置的倍数超过最大占比限制,客户端将会有告警提示。如下设置为两倍:

倍数设置

以上所述为账号资产组合风控的迅投风格样式,资产组合的普通风格为比较直观的直接输入的形式。账号的资产组合风控基本分为持仓限制和资产限制。资产主要罗列市值、期货的保证金、期权的权利金、期权的希腊值等项。

期货资产组合风控(普通风格)

证券、信用资产组合风控(普通风格)

股票期权资产组合风控(普通风格)

沪港通资产组合风控(普通风格)

深港通资产组合风控(普通风格)
进行添加账号组的操作后,账号组展示在账号组列表中,点击风控设置按钮进行风控设置,设置后的账号组可以进行编辑操作和删除。
账号组风控包括资产组合风控、反向单交易设置、对敲交易设置。账号组风控也提供两种风格展示。
账号组迅投风格参考账号资产组合风控,不再赘述。账号组普通风格主要提供风险敞口、总持仓、总市值和期货保证金的限制。

账号组资产组合风控
当日委托中存在某只股票或期货的买入(或卖出)委托,再次对该股票或期货进行卖出(或买入)的反向操作时就会形成反向单。反向单是当天的反向操作,之前形成的持仓不算在内。反向单交易设置的普通风格和迅投风格样式一致。

账号组风控 - 反向单交易设置
设置账号组反向单交易检查后,对于账号组内账号买入(或卖出)某股票代码委托报单后,组内有账号卖出(或买入)该代码时将形成反向单交易,会被禁止,以此限制组内账号之间的反向单交易。

设置账号组禁止反向单交易

风控触发
勾选“不统计已撤(无成交)委托”后,直接跳过已撤的委托不进行反向单检查,只检查已撤(有成交)、已报的委托。

置不统计已撤(无成交)委托
账号组中添加豁免分类后,对该分类中的代码进行下单时,不进行反向单检查,豁免分类可免去反向单交易检查。

账户组风控 - 豁免分类
对敲是指对同一只股票代码或期货合约下单时,如果买入为执行中的委托,当卖出价格低于买入时的价格触发对敲单;如果卖出为执行中的委托,当买入价格高于卖出时的价格触发对敲单。对敲单交易设置的普通风格和迅投风格样式一致。
设置账号组禁止对敲交易后,对于账号组内的账号进行对敲检查,触发对敲单将禁止交易。对于豁免的分类,系统将不进行对敲检查。

账号组风控 - 对敲交易设置

风控触发
注:只有执行中的委托进行高买低卖或低卖高买时才算是对敲单,对于已经成交的任务,不做为对敲单处理。
为了控制所有资金账号的交易风险,管理端可以对全局进行全局交易量价限制和全局资产比例风控设置。
交易量价限制可以添加不同分类的代码,分别设置不同的交易量价限制后下单会提示被风控驳回。
交易量价可以设置生效时间、生效日期。交易量价限制包含限制市价、涨停
价、跌停价,与最新价偏离超过设置百分比、与昨日收盘价偏离超过设置百分比。

全局交易量价限制

全局资产比例风控
证券风控,包括黑白名单和交易合规设置。

证券黑白名单

证券交易合规
期货风控包含黑白名单和交易合规两种。
| 全局风控 | 期货风控 | 证券风控 | 沪港通风控 | 深港通风控 | 股票期权风控 | ||
| 黑白名单 | 交易合规 | ||||||
| □ 不限制卖出/平仓 | |||||||
| 黑名单 | |||||||
| 添加代码 | 添加分类 | 全部删除 | 批量上传 | ||||
| 类别 | 代码/名称 | 操作 | |||||
| 1 | 中国金融期货交易所 | IC2209/中证 500 指数 2209 | 删除 | ||||
| 白名单 | |||||||
| 添加代码 | 添加分类 | 全部删除 | 批量上传 | 白名单默认为空,即允许交易所有非黑名单中的代码;白名单非空,即只允许交易白名单内且非黑名单中的代码 | |||
| 类别 | 代码/名称 | 操作 | |||||
期货风控 - 黑白名单
| 全局风控 | 期货风控 | 证券风控 | 沪港通风控 | 深港通风控 | 股票期权风控 | |
| 黑白名单 | 交易合规 | |||||
| 上期所合规 | 郑商所合规 | 大商所合规 | 中金所合规 | 能源中心合规 | ||
| 每 30 秒检查交易合规 | ||||||
| 序号 | 名称 | |||||
| 1 | 频率合规 | |||||
| 2 | 数量合规 | |||||
| 2 合计 | ||||||
| 保存 |
期货风控 - 交易合规
股票期权风控包括黑白名单和交易合规两种
| 欢迎 | 期货账号 | 全局风控 | ||||
| 全局风控 | 期货风控 | 证券风控 | 沪港通风控 | 深港通风控 | 股票期权风控 | |
| 黑白名单 | 交易合规 | |||||
| □不限制卖出/平仓 | ||||||
| 黑名单 | ||||||
| 添加代码 | 添加分类 | 全部删除 | 批量上传 | |||
| 类别 | 代码/名称 | 操作 | ||||
| 白名单 | ||||||
| 添加代码 | 添加分类 | 全部删除 | 批量上传 | 白名单默认为空,即允许交易所有非黑名单中的代码:白名单非空,即只允许交易白名单内且非黑名单中的代码 | ||
| 类别 | 代码/名称 | 操作 | ||||
股票期权黑白名单
| 全局风控 | 期货风控 | 证券风控 | 沪港通风控 | 深港通风控 | 股票期权风控 |
| 黑白名单 | 交易合规 | ||||
| 上期权合规 | 深期权合规 | ||||
| 每 30 秒检查交易合规 | |||||
| 序号 | 名称 | 只告警不禁止 | |||
| 1 | 频率合规 | ☐ | |||
| 2 | 数量合规 | ☐ | |||
| 3 | 比例合规 | ☐ | |||
| 4 | 行为合规 | ☐ | |||
| 5 | 增强频率合规 | ☐ | |||
股票期权交易合规
沪港通/深港通风控包含黑白名单和交易合规两种。
| 全局风控 | 期货风控 | 证券风控 | 沪港通风控 | 深港通风控 | 股票期权风控 | |
| 黑白名单 | 交易会报 | |||||
| □不限制卖出/平仓 | ||||||
| 黑名单 | ||||||
| 添加代码 | 添加分类 | 全部删除 | 批量上传 | |||
| 类别 | 代码/名称 | 操作 | ||||
| 白名单默认为空,即允许交易所有非黑名单中的代码:白名单非空,即只允许交易白名单内且非黑名单中的代码 | ||||||
| 添加代码 | 添加分类 | 全部删除 | 批里上传 | 白名单默认为空,即允许交易所有非黑名单中的代码:白名单非空,即只允许交易白名单内且非黑名单中的代码 | ||
| 类别 | 代码/名称 | 操作 | ||||
沪港通/深港通黑白名单
| 序号 | 名称 |
|---|---|
| 1 | 频率合规 |
沪港通/深港通交易合规
*注意:设置了全局风控后,账号风控设置的数值与全局风控相比将在更严格的范围内设置。比如:设置全局风控中的金额合规,限制日内最大净买入 500 000 元。则在交易端账号管理的风控设置中,设置的金额合规,限制日内最大净买入最大值为 500000 元。
迅投 QMT 极速策略交易系统管理端除了提供全局风控的设置,还提供全局和交易端风控设置的内容查看。
(1)管理端风控查看包含当前风控详情和历史违规风控详情。
当前风控详情可选择全局,具体的一个或多个账号组及账号,查看所选维度的当前风控内容。支持查看价格限制(交易量价限制、交易价格限制)、合规限制(交易合规)、资产比例(资产组合风控)、黑白名单。勾选 仅导出详情展示当前违规风控。支持导出当前查询出的风控详情。

历史违规详情支持查看所选账号在一段时间内的历史违规风控,可选择查看违反的全局、账号和账号组的价格限制(交易量价限制、交易价格限制)、合规导出详情限制(交易合规)、资产比例(资产组合风控)和黑白名单风控。支持导出当查询出的历史违规详情。

(2)交易端风控查看,支持查看当前设置的风控内容。账号和账号组列表中,点击风控查看按钮,进入风控查看界面。可选择账号查看全局、账号和账号组设置的价格限制(交易量价限制、交易价格限制)、合规限制(交易合规)、资产比例(资产组合风控)和黑白名单风控。勾选 □仅显示违规 仅展示当前违规风控。

操作列显示复制按钮,选择账号进行复制操作后,与被复制账号的风控显示
一致。
复制账号风控设置界面显示账号、账号风控详情和查询账号功能,右侧风控详情显示为选中账号的风控。
| 系统设置 | |||||||
| 交易设置 | 快捷键设置 | 界面定制 | 账号管理 | 账号组设置 | 风控设置 | 密码设置 | 导出设置 |
| 账户信息 | |||||||
| 股票 期货 融资融券 | |||||||
| 29631972 | |||||||
| 总资产 | |||||||
| 总市值 | |||||||
| 总盈亏 |
迅投 QMT 极速策略交易系统支持 Python 模型编写,因而对模型编辑的 Pyth on 库也设有一定限制,QMT 管理端【风控管理】Python 库白名单中可增加允许模型使用的 Python 库,添加上在 Python 模型中允许调用,未添加则不允许。添加时需要输入 md5 值及其第一层引用的库,用于模型调用该库时的校验。

管理端 - 添加 Python 库白名单
Python 自带的库非常多,添加白名单时支持导入多个 Python 库白名单,导入的文件限制为.xls 和.xlsx 表格文件。表格文件内需要提供 Python 库名、Py thon 库文件 md5 值以及该 Python 库第一层引用库。

Python 库白名单表格
交易端同步展示管理端添加的白名单,但无法添加、导入、编辑和删除。

交易端-Python 库白名单
加在白名单内的 Python 库允许模型调用,若交易端模型调用了未添加白名单的 Python 库,则有报错;若管理端输入 md5 值错误,则在模型运行时有报错,如下:

模型调用未添加白名单的 Python 库
对于用户自己设置的风控,系统提供风控密码管理帮助用户管理自己的风控,防范风控被任意篡改。对于已设置风控密码的用户,支持风控密码修改;对于未设置密码的用户,提供密码设置功能。

未设置风控密码
用户完成密码设置后,进入风控设置需输入正确密码才可进行风控设置。

已设置风控密码 - 输入密码

已设置风控密码 - 修改密码
同时,在管理端,也可以对风控密码进行修改。

管理端支持修改风控密码
用于用户查询证券分类具体证券代码。

证券分类
可以修改用户的登录密码。

密码设置
在管理端,也可以对用户密码进行修改设置。

管理端支持修改用户密码
(1)导出设置可选择自动导出或盘后导出,自动导出可设置导出间隔,支持为委托、成交和资金、持仓、标的券、负债等数据设置不同的导出间隔,最短为 0.01 秒,盘后导出可设置导出开始的时间,两种设置可同时勾选,导出时可自动以导出日期 + 时间作为后缀。

导出设置
(2)支持全局信息导出、股票交易、期货交易、融资融券、股票期权、沪港通、深港通的账号、持仓、委托、成交数据导出。导出方式分为:普通导出和增量导出。
全局信息可以按结构导出,可以选择导出的列(目前有任务列),同时支持勾选按结构导出和转换集中交易格式导出。

全局信息导出数据选择
进行按结构导出操作后,可在设置好的路径下,看到导出的全局信息。

按结构导出任务
转换集中交易格式导出,是集中交易系统结合 QMT 极速策略交易系统下单的定制导出方式。集中交易系统,是迅投为私募管理人统一管理所有券商 PB 产品提供完整解决方案的一套综合系统。集中交易可通过便捷交易、篮子导入、API、CTP 直连等多种方式,对多个券商 PB 进行流程化、自动化的统一下单。
①通过集中交易系统,把便捷交易下到指定路径,QMT 系统通过读取便捷交易,下达任务。

集中交易下单面板
②QMT 读取便捷交易,会弹出下单任务界面。

QMT 下达任务面板
③导出时需勾选转换集中交易格式,按结构导出到指定的默认文件夹,待文件被集中交易系统读取,得到信息反馈。以集中交易格式按结构导出全局信息后,会生成名为 commanddetail 的 txt 文件,而只按结构导出全局信息时,生成的是名为 TaskDetail 的 txt 文件。
(3)导出还可针对单独的交易类型,股票、期货、两融交易、股票期权的持仓、委托、成交和资金账号数据导出。

股票交易导出数据选择
对于不同的交易类型导出文件的格式可分为.csv 格式和.dbf 格式(增量导出)两种。

导出格式
数据管理包括导入数据,清理数据,补充数据,导出数据和收盘清理。
①导入数据:支持将符合格式的文件导入到迅投 QMT 极速策略交易系统交易终端中。各数据作用域可选择所导入文件的字段和相应的字段顺序。

导入数据
②清理数据:在“清理数据”中可以清除掉混乱和错误的数据。而在“数据删除”中则可以将不需要的数据删掉以释放磁盘空间。用户可根据需要先选择市场,然后选择数据整理的范围,K 线种类和需要删除的内容。

清理数据
③补充数据:提供多种范围数据和多种数据类型以供下载。时间周期涵盖:最近一星期,最近一个月,全部,自定义时段;数据类型包含 K 线数据,分笔成交数据,财务数据,除权数据,板块成分股,行业成分股,高级数据,过期合约列表,龙虎榜数据,历史主力合约,ETF 申赎清单,过期合约 K 线,港股资金流向数据,全部板块。如果用户只需要日线数据并且网速不快也不想占用太多时间,建议只下载周期选项里的“日线”部分就可以,一般分钟线较大。

补充数据
④导出数据:用户可将已经存在的数据(补充数据下载的和自动缓存的)导出到指定目录下,支持选择数据类型,选择市场品种,自定义时段,选择复权方式等。用户只需选择导出文件所在的目录,在导出时系统会自动寻找目前软件装载的目录,推荐使用这个目录。

导出数据
④收盘清盘:用户可对于收盘清盘的操作,用户可选择补充指定品种,选择需要保存的数据。

查询当前交易界面的所有子面板调用信息,子面板若呈选中状态,则表明该子面板窗口已在界面显示。可以一次选中并打开多个子面板。

查看面板显示
选中子面板时,子面板会呈现在窗口中显示。举例:查看消息提示显示。

查看消息提示面板
有一些窗口是不会经常被用到,在需要的时候,可以进行查看,但失去焦点,窗口就会消失。而有些窗口需要一直被显示,这里新增了常显窗口设置。可以选择经常被用到的窗口始终被显示在界面,失去焦点,不会消失。

常显窗口设置
QMT 极速策略交易终端的账号资金、下单面板、任务列表、持仓、委托和成交面板在默认布局中固定显示,不会随着焦点改变消失。

固定显示
单击一次“复制面板”即可实现快速复制一个新的整体界面,为用户多账号下单、多屏幕显示提供便利。

复制界面
设置当前交易终端用户界面为电脑桌面最顶端。单击 "界面置顶"按钮实现置顶,同时按钮会变成取消置顶,当单击"取消置顶",则解除界面置顶。

界面置顶
锁定当前交易主界面布局,锁定后用户无法查看面板、任意拖拽子板块窗口、改变窗口大小等操作。单击"布局锁定"按钮,实现锁定功能同时按钮变成解锁布局,再次单击"解锁布局",则解除布局锁定操作。当布局为锁定状态时,鼠标拖拽改变窗口大小,会弹出解锁布局的提示框,确定即可解锁当前布局。

改变布局提示
防止其他人用自己的计算机进行下单操作或查询一些数据,造成不必要的损失,客户端上锁定终端可以对当前交易端进行锁定,只有再次输入用户名密码后才可以登录到客户端主界面。

锁定终端
点击画图工具,可打开画线工具对话框,使用压/撑线、趋势线、矩形和文本工具辅助分析大盘及个股走势。

画图工具
在星空图二维坐标中,个股的位置反映了其涨幅、涨速等指标在所属板块中的相对情况。星空图中的星星数量取决于该板块内个股的数量。
如图所示,可在界面的左上角选择不同板块,并在界面右下角的星空图中进行展示,同时可在界面的左下角选择该板块内各个股,并在界面的右上角展示该股的分时图和 K 线图。

星空图
龙虎榜从时间跨度划分。分别可以看到不同时间段的最新龙虎榜。龙虎榜显示的主要数据有:代码、名称、详细、上榜日、收盘价、涨跌幅及上榜原因。

龙虎榜
个股分析中存在个股的数据显示和买入(卖出)金额最大前 5 名的交易营业部信息。

个股分析
席位分析根据时间跨度,对上榜证券进行分析。

席位分析
管理端 - 系统设置 - 地址配置管理中,填写“接收通知邮箱地址链接”后,交易端导航栏 - 操作 - 邮箱选项,可跳转至相应的邮箱链接。

邮箱 - 未配置

邮箱 - 已配置
性能监控包括行情监控、对象数量监控和内存管理器。
行情监控:包括行情源、全推属性、是否需要全推、是否开启全推,查看各行情源链接从全推订阅的代码个数、单只订阅代码个数。
对象数量监控:可以查看对象名称、创建数量和存活数量,可以进行刷新和清理内存操作。
内存管理器:可以查看内存管理器名称、大小,查看详细、删除和刷新操作。
| 性能监控 | ||||||
| 行情监控 | 对象数量监控 | 内存管理器 | ||||
| 刷新 | ||||||
| 行情源 | 全推属性 | 是否需要全推 | 是否开启全推 | 从全推订阅的代码个数 | 单支订阅的代码个数 | |
| 1 | proxy 股票 | 强制全推:1,智能全推:0,最大订阅数:12000 | 否 | 是 | 0 | 0 |
| 2 | proxy 期货 | 强制全推:0,智能全推:0,最大订阅数:100000 | 否 | 否 | 0 | 0 |
| 3 | 股票 | 强制全推:1,智能全推:0,最大订阅数:12000 | 否 | 是 | 0 | 0 |
| 4 | 期货 | 强制全推:1,智能全推:0,最大订阅数:12000 | 否 | 是 | 0 | 0 |
| 5 | proxy 股票期权 | 强制全推:0,智能全推:0,最大订阅数:100000 | 否 | 否 | 0 | 0 |
| 6 | 股票期权 | 强制全推:1,智能全推:0,最大订阅数:12000 | 否 | 是 | 0 | 0 |
| 7 | proxy 深港通 | 强制全推:0,智能全推:0,最大订阅数:100000 | 否 | 否 | 0 | 0 |
| 8 | 深港通 | 强制全推:1,智能全推:0,最大订阅数:12000 | 否 | 是 | 0 | 0 |
| 9 | proxy 沪港通 | 强制全推:0,智能全推:0,最大订阅数:100000 | 否 | 否 | 0 | 0 |
| 10 | 沪港通 | 强制全推:1,智能全推:0,最大订阅数:12000 | 否 | 是 | 0 | 0 |
| 10 合计 |
性能监控 - 行情监控
| 性能监控 | |||
| 行情监控 | 对象数量监控 | 内存管理器 | |
| 刷新 清理内存 | |||
| 对象名称 | 创建数量 | 存活数量 | |
| 1 | AccountDetail | 0 | 0 |
| 2 | AccountStaticsData | 0 | 0 |
| 3 | BankAmountDetail | 0 | 0 |
| 4 | BankDetail | 0 | 0 |
| 5 | BankTransferReq | 0 | 0 |
| 6 | CAccountAlgoRange | 0 | 0 |
| 7 | CAccountCalcInfo | 0 | 0 |
| 8 | CAccountComplianceForMarket | 0 | 0 |
| 9 | CAccountDetail | 0 | 0 |
| 10 | CAccountDetailV2 | 0 | 0 |
| 11 | CAccountDynamicIndex | 0 | 0 |
| 12 | CAccountFreqCompliance | 0 | 0 |
| 13 | CAccountFreqPreTimeLimit | 0 | 0 |
| 967 合计 | 0 | 0 |
性能监控 - 对象数量监控
| 性能监控 | ||||
| 行情监控 | 对象数量监控 | 内存管理器 | ||
| 刷新 | ||||
| 名称 | 大小 | 操作 | ||
| 1 | 数据缓存 | 4 | 详细 删除 | |
性能监控 - 内存管理器
行情回放,能实现单票 L1 级别的行情回放,支持分时图和多周期回放,同时提供 L1 级别的盘口联动,使回放更接近当日实时行情,同时能够实现多票联动回放,最多支持 16 股联动。

行情回放
行情回放菜单包括日期、时间、播放速率、导入数据、回放统计、委托、成交,系统默认从选定日期开始播放至最新收盘,支持手动模式播放。

行情回放菜单
导入数据文件格式,xls、xlsx、csv。

回放统计:实时显示回放时的对应市场成交情况:
| 龙虎看盘(逐笔) | |
| 逐笔成交成交量统计 | |
| 主动买入 | 共 0 单 0.0 手/单 |
| 特大 | 0 0.0% |
| 大单 | 0 0.0% |
| 中单 | 0 0.0% |
| 小单 | 0 0.0% |
| 主动卖出 | 共 0 单 0.0 手/单 |
| 特大 | 0 0.0% |
| 大单 | 0 0.0% |
| 中单 | 0 0.0% |
| 小单 | 0 0.0% |
回放统计

分时行情回放

1 分钟行情回放
多票联动目前支持同周期同时间段的多票回放,支持 2、4、6、9、16 票联放。

多票联动行情回放
| 行情 | 搜索策略 | +新建策略 | 新建文件夹 | 删除 | 返回 | 下载 python 库 | |
| 类型 | 操作 | 备注 | |||||
| 我的策略 | |||||||
| 单股模型示范 | vba | 编辑 | 复盘 | 查看 | |||
| 复盘 | 组合模型单股示范 | vba | 编辑 | 复盘 | 查看 | ||
| 期权 CTA | vba | 编辑 | 复盘 | 查看 | |||
| 交易实时主推示例 | python | 编辑 | 复盘 | 查看 | |||
| 多因子选股回测示例 | python | 编辑 | 复盘 | 查看 | |||
| 指数增强回测示例 | python | 编辑 | 复盘 | 查看 | |||
| 日内回转回测示例 | python | 编辑 | 复盘 | 查看 | |||
| 机器学习回测示例 | python | 编辑 | 复盘 | 查看 | |||
| 网格交易 (期货) 回测示例 | python | 编辑 | 复盘 | 查看 | |||
| 行业轮动回测示例 | python | 编辑 | 复盘 | 查看 | |||
| 跨品种套利回测示例 | python | 编辑 | 复盘 | 查看 | |||
| 跨式期权回测示例 | python | 编辑 | 复盘 | 查看 | |||
| 集合竞价选股回测示例 | python | 编辑 | 复盘 | 查看 | |||
| 新股申购 | python | 编辑 | 复盘 | 查看 | |||
| 双均线实盘示例 PY | python | 编辑 | 复盘 | 查看 |
复盘
点击复盘进入策略回测界面:

可以保存自定义布局设计,应用自定义或者系统默认的布局,方便调用。

保存当前布局
点击保存当前布局即可保存用户自定义的布局。保存过的布局会相应的在布局管理中保存显示,点击应用即可使用。

布局管理
点击恢复默认布局,布局会恢复默认布局。

恢复默认布局
当前账号的下拉框中,可根据用户的当前需求,选择在交易界面显示全部或部分账号,方便交易操作。

当前账号设置
点击界面右上角用户协议按钮,显示用户协议信息。

用户协议
点击界面右上角交易按钮,打开交易界面。
点击界面右上角帮助按钮,可以打开功能帮助手册、python 开发手册和 VBA 开发手册。

帮助
管理端用户功能权限开启股票日内回转权限后,QMT 用户登录交易端,工具栏右上角显示“回转交易”。首次点击“回转交易”时,系统首先进行回转交易端及管理端的下载,下载并解压完成后,弹出回转交易端登录界面,回转交易端界面右下角点击管理终端,即可打开回转管理端登录界面。
迅投资产管理平台交易终端

回转交易端供回转交易员登录并进行交易,回转交易员由回转单元管理员(即拥有股票日内回转权限的 QMT 用户)在回转单元管理终端创建。
回转单元管理终端供回转单元管理员(即拥有股票日内回转权限的 QMT 用户)登录,进行回转单元的创建和管理。登录回转单元管理终端的用户名和密码同 QMT 用户名和密码。
首次使用回转交易功能时,需确保自己已经拥有股票日内回转交易的权限,同时需在 QMT 交易端添加资金账号,以供回转交易使用。
点击界面右上角换肤按钮,可按照个人喜好更换系统界面颜色。有三种 UI 可选择,灰蓝色、海蓝色和灰黑色。

系统换肤

灰蓝色皮肤

海蓝色皮肤

灰黑色皮肤
管理终端:迅投 QMT 极速策略交易系统的组成部分之一,主要功能包括权限配置等方面的用户管理、以及账号管理、行情源管理、全局风控管理、数据支持管理等。
交易终端:迅投 QMT 极速策略交易系统的组成部分之一,主要用于客户方对于股票期货、融资融券、股票期权、组合交易、深沪港通等方面的交易操作,也兼有账号账户组的添加及风控设置。
用户:迅投 QMT 极速策略交易系统中特指具有角色类型属性的具体用户,角色类型有高级管理员,投资者,运维者和投资者等。
经纪公司:迅投中是指证券期货等方面的经纪商,证券经纪商是指以接受客户委托,代客户买卖 证券并以此收取 佣金的中间人。期货经纪商是指依法设立的以自己的名义 代理客户进行 期货交易并收取一定手续费的中介组织。
行情源:交易变化及流通情况,添加后,盘口会显示接收到的行情。
风控:通过对相关数据的限制和实时监控,消灭或减少风险事件发生的各种可能性,或者减少风险事件发生时造成的损失,来实现风险控制。
委托:在证券交易市场,投资者买卖证券是不能直接进入 交易所办理的,而必须通过 证券交易所的会员来进行,换而言之,投资者需要通过 经纪商的代理才能在证券交易所买卖证券。在这种情况下,投资者向经纪商下达买进或卖出证券的指令,称为“委托”。
报盘:证券经纪商接到投资者的委托指令后,首先要对投资者身份的真实性和合法性进行审查。审查合格后,经纪商要将投资者委托指令的内容传送到 证券交易所进行撮合。这一过程称为“委托的执行”,也成为“申报”或“报盘”。
资金账户:资金账户即证券交易结算 资金账户,是指投资者用于证券交易资金清算的 专用账户。资金账户主要分为 现金账户和 保证金账户两种。
可用资金:可用资金是投资者存放在账户内可用于提取现金和开新仓的资金部分,是可以买卖股票,基金,债券,国债回购等的资金。
总资产:总资产是指某一经济实体拥有或控制的、能够带来经济利益的全部资产。迅投中总资产=可用资金 + 市值 + 冻结金额。
市值:市值是指一家上市公司的发行股份按市场价格计算出来的股票总价值,其计算方法为每股股票的市场价格乘以发行总股数。整个 股市上所有上市公司的市值总和,即为 股票总市值。
当前拥股:当前拥股是买入已成交后持有的股数。股份余额显示的是你买入一个交易日后持有的股数。在途股份是你当日买入的股数。当前拥股=可用 + 在途。
保证金:在证券市场融资购买证券时,投资者所需缴纳的自备款。
手续费:证券交易手续费是指投资者在委托买卖证券时应支付的各种税收和费用的总和。通常包括印花税、佣金、过户费、其他费用等几个方面的内容。
交易日:证券、期货、物资等交易的日期。如中国股市的股票的交易日为除节假日外的周一至周五。(AM:30-11:30 , PM13:00-15:00)
涨停价:涨停价是以早一天的 收盘价来算的,即前一天的收盘价加 10%。但是是股票交易以分为最小单位,所以因为四舍五入的存在,只要是收盘价出现分位数,第二天的涨停和 跌停价都不会是刚好 10%。
逆回购:是金融出资方将资金融给资金融入方,收取有价证券作为抵押,并在未来收回本息,并解除有价证券抵押的交易行为。
新股申购:是为获取股票一级市场、二级市场间风险极低的差价收益,不参与二级市场炒作,不仅本金非常安全,收益也相对稳定,是稳健投资者理想投资选择。
一级市场:也称为发行市场(Issuance Market),它是指公司直接或通过中介机构向投资者出售新发行的股票的市场。所谓新发行的股票包括初次发行和再发行的股票,前者是公司第一次向投资者出售的原始股,后者是在原始股的基础上增加新的份额。
二级市场:也称股票交易市场,是投资者之间买卖已发行股票的场所。这一市场为股票创造流动性,即能够迅速脱手换取现值。我们通常接触到的股票交易,一般指二级市场。
单笔超价:在基准价的基础上设定每笔下单的超价,在下单时系统自动向利于成交方向加/减单笔超价。
期货交易:是期货合约买卖交换的活动或行为。
期货合约:是由期货交易所统一制定的、在将来某一特定时间和地点 交割一定数量标的物的 标准化合约。这个标的物,又叫 基础资产,是期货合约所对应的 现货,可以是某种商品,如铜或原油,也可以是某个 金融工具,如外汇、债券,还可以是某个 金融指标,如三个月 同业拆借利率或 股票指数。
持仓:在 期货交易中,无论是买还是卖,凡是新建头寸都叫 开仓。交易者 建仓之后手中就持有 头寸,这就叫持仓。
持仓盈亏:与平仓盈亏相对。亦称账面盈亏或浮动盈亏。交易者在交易闭市时所持有合约按当日结算价计算的持仓值与原持仓值的价差。
持仓盯市盈亏(有昨仓)=(持仓价 - 开仓价)*合约乘数*手数;
持仓浮动盈亏=(最近价 - 持仓价)*合约乘数*手数。
平仓盈亏:平仓是指期货交易者 买入或者卖出与其所持 期货合约的品种、数量及 交割月份相同但交易方向相反的期货合约,了结期货交易的行为,简单的说就是“原先买入就卖出,原先是卖出的就买入”。与 持仓盈亏相对。期货交易者在实际 平仓时所发生的损益。若客户当日没有进行 平仓交易,平仓盈亏为 0。
平仓盯市盈亏(有昨仓)=(平仓价 - 持仓价)*合约乘数*手数;
平仓浮动盈亏=(平仓价 - 最新价)*合约乘数*手数。
静态权益:静态权益是指最近一次结算时的权益。
静态权益=前一交易日结算后的期末结存。
动态权益:根据盘面即时价格计算出来的权益,在交易时间里,动态权益是随着价格的波动而不断变化的。
动态权益=静态权益 + 持仓盈亏 + 平仓盈亏 - 手续费(除去质押等情况下)。
期现套利:期现套利是指某种 期货合约,当期货市场与现货市场在价格上出现差距,从而利用两个市场的价格差距,低买高卖而获利。理论上,期货价格是商品未来的价格,现货价格是商品目前的价格,按照经济学上的同一价格理论,两者间的差距,即“基差”(基差=现货价格 - 期货价格)应该等于该商品的 持有成本。一旦基差与持有成本偏离较大,就出现了期现套利的
机会。
套期保值:是指企业为规避外汇风险、利率风险、商品价格风险、股票价格风险、信用风险等,指定一项或一项以上套期工具,使套期工具的公允价值或现金流量变动,预期抵消被套期项目全部或部分公允价值或现金流量变动风险的一种交易 活动。
担保品买入:客户通过普通交易买来股票,就是担保品买入。担保品买入不产生负债和利息。资金和持仓的变化类似普通股票交易。
担保品卖出:客户通过普通交易卖出股票,就是担保品卖出。担保品卖出不产生负债和利息。资金和持仓的变化类似普通股票交易。
融资买入:融资买入是对股票进行买卖操作的一种方法,用很直白的话讲:就是用借钱的办法买入股票。融资买入会产生负债合约。融资买入是借钱买入股票,所以账户里面的可用资金是不发生变化的。因此也不会有冻结资金出现。当融资买入未成交之前会在当日委托里面查询到。当融资买入成交之后,相应的成交数据也会在当日成交中查询到;当有成交之后会有相应的持仓产生。例如:当你看好某只股票想大举介入而手中钱又不多时就可以向券商借钱买股票,当股票上涨到目标价后,你可以卖出股票清偿借款,从而放大你的收益。
直接还款:直接还款是指,投资者在信用资金账户内存入资金,通过融资融券交易系统中“直接还款”指令偿还融资债务,结算时该资金直接划转至证券公司融资专用资金账户的一种还款方式。
卖券还款:卖券还款是指,投资者通过其信用证券账户选择“卖券还款”的交易指令进行证券卖出,结算时该资金直接划转至证券公司融资专用资金账户的一种还款方式。
融券卖出:融券卖出是指证券公司出借证券供投资者卖出的经营活动。融券为你做空赚钱创造了条件,当你看跌某股时,你可以向券商借入该股,然后将其卖掉,等其下跌后你再买入该股票还给券商,从中获取差额。在做融券卖出这个操作之前,我们需要注意的是你所做的这只股票是否担保品,是否可以进行融券卖出。如果可以当做完融券卖出之后,融券卖出之后并没有成交之前,可用资金和持仓不发生变化。融券卖出产生成交之后,迅投系统可用资金会增加,但是没有持仓产生,相应的会生成一条融券卖出的负债合约。
直接还券:直接还券就是客户用信用账号的持仓数量,去还融券的负债。
买券还券:买券还券就是客户通过通知买券还券的交易指令去归还融券的负债。
概述 Level-2 行情为沪深两所推出的增值行情,Level-2 行情具有以下特点:
更丰富的信息:更多的盘口订单数据、逐笔成交数据、逐笔委托数据、成交与订单关联数据及增值数据,揭示交易细节,全方位反映市场状态;
更丰富的盘口信息:提供买卖方 10 个价位的价格、股数和委托笔数信息,同时提供第一档位的前 50 笔订单的委托量,揭示买卖双方行为细节;
更好的低延时技术:采用国际一流的 FAST 协议,毫秒级时延的技术系 统让数据更迅速直达用户;
更高的服务质量保障:提供重发机制,确保数据可靠、准确,不丢失任 何一笔数据
基于 lv1 五档盘口已有结构基础上,扩充为买卖十档,档位更丰富,数据更细节。
逐笔委托
逐笔委托真实的展示了每笔委托价和委托量的明细数据。
逐笔成交真实的展示了每笔成交价和成交量的明细数据。
委卖队列和委买队列是指实时的分笔委托明细。其中,买卖一档分别展示了
申买量和申买量前 50 笔的分笔委托数据。
千档盘口显示全部价位的买卖盘价格、委托量、委托单数的完整盘口的统称。
文档版本:3.2.10 Python 版本:3.6.8 更新日期:2020.11.12
感谢您使用国泰君安君智极速策略交易系统,以下简称君智系统,本文档主要介绍君智系统 Python API 的使用方法。内容较多,可使用 Ctrl + F 进行关键字搜索。
君智系统与其他普通股票软件最大的不同点就是其提供历史数据下载、模型编辑、模型回测、模型交易、算法交易及交易风控等完整量化交易功能。通过君智系统,用户可以快速的将自己的转化为计算机代码,形成自己的交易策略,让计算机帮助用户实现策略的回测检验并实现无人值守自动化交易。
在量化策略编写语言的支持上,君智系统目前支持两种:VBA 和 Python。在后续的规划中,君智系统将全面支持市面上主流的量化编程语言。
随着量化在国内的深入发展以及大量专业编程人员进入量化这个领域,市场上的量化投资者对 Python 的需求越来越大,君智系统的 Python API 就是为了满足这部分投资者而量身打造。君智系统的 Python API 既可以高效使用君智系统底层的数据接口及交易接口,也可以方便地引入 Python 支持的第三方库,极大地便利了量化投资者的模型策略需求。

上图展示了如何在君智系统上用 Python 写一个输出 hello world 的模型。图中的模型实现了一个 Python 模型必须实现的两个接口:** init()** 与 handlebar() 。输出窗口展示了这个模型的运行输出。系统首先调用 init() 方法输出了 hello init,随后在每根 K 线上调用一次 handlebar() ,输出一次 hello handlebar。

Python 模型运行流程图
上图为君智系统 Python 模型运行流程图。当用户在 Python 平台编写好自己的策略后,可以点击【运行】按钮来运行脚本。界面层在向下层请求数据的过程中,会首先创建一个 Python 模型,这个模型关联当前界面运行的产品。模型创建完毕后,加载用户编写的 Python 脚本,并调用 init() 初始化函数。模型运行所需的数据也在此时向下层发出请求。下层在接收到请求后,会向服务器请求行情数据,并组织好数据格式。Python 模型根据返回的数据,运行 handlebar() ,用户可以用 paint() 方法将希望显示的计算结果输出到界面上,界面会将输出结果展示出来。
我们把单根 K 线称之为 Bar,每根 Bar 由 tick(分笔)组成。
| 3 | 11.50 | 1 | 1 | ||
| 4 | 11.50 | 15 | 15 | 95 | |
| 5 | 11.50 | 5 | 5 | ||
| 14:54:57 | 11.50 | 37 | 120 | ||
| 2 | 11.50 | 83 | |||
| 3 | 11.50 | 1 | 1 | ||
| 4 | 11.50 | 10 | 10 | ||
| 5 | 11.50 | 6 | |||
| 6 | 11.50 | 10 | 31 | 10 | |
| 7 | 11.50 | 15 | |||
| 8 | 11.50 | 4 | 4 | ||
| 14:54:58 | 11.50 | 8 | 8 | 50 | |
| 2 | 11.50 | 7 | 7 | ||
| 3 | 11.50 | 16 | |||
| 4 | 11.50 | 5 | 5 | ||
| 5 | 11.50 | 3 | 3 | ||
| 6 | 11.50 | 30 | 30 | ||
| 7 | 11.50 | 7 | 7 | ||
| 8 | 11.50 | 1 | 1 | ||
| 9 | 11.50 | 34 | 277 | 34 | |
| 10 | 11.50 | 2 | 2 | ||
| 14:54:59 | 11.50 | 10 | 10 | ||
| 2 | 11.50 | 14 | 14 | ||
| 3 | 11.50 | 2 | 2 | ||
| 4 | 11.50 | 2 | 2 | ||
| 5 | 11.50 | 151 | 161 | ||
| 6 | 11.50 | 10 | |||
| 7 | 11.50 | 1 | 1 | ||
| 14:55:00 | 11.50 | 20 | 55 | 20 |
分钟 Bar 示例
君智系统的模型是根据行情驱动,逐 K 线运行,每根 K 线调用一次 Python 模型中的 handlebar(ContextInfo) 函数。
根据选择的运行周期不同,handlebar(ContextInfo) 函数的运行次数也不同。如选择在日线上运行策略,则 handlebar(ContextInfo) 函数每天被调用一次(盘中虽会每个 tick 调用一次,但只有最后一个 tick 才会判定交易函数是否被调用)。
init 是一个 Python 模型的初始化方法。在模型加载的时候,系统会调用 init 方法,做一些必要的初始化,比如初始化股票池、初始化资金账号、初始化全局变量等。如果用户的模型无需做初始化,可以在方法体中写 pass,但方法的定义必须存在,否则模型的运行会报错。
def init (ContextInfo):
—→#·设定股票池方法一,取板块的成分股作为股票池,例如取“上证50”成分股,
—→ContextInfo.trade_code_list = ·ContextInfo.get_stock_list_in_sector("上证50")
—→#·设定股票池方法二,可以自定义将股票代码写到列表里
—→ContextInfo.trade_code_list = ['600000.SH', '300462.SZ', '000697.SZ', '300008.SZ']
—→ContextInfo.set_universe (ContextInfo.trade_code_list) #初始化设定股票池
—→ContextInfo.accID = '6000000009' #·初始化设定资金账号
—→ContextInfo.order = 10#·初始化设置一些全局变量,例如设定买入的手数
Init 初始化
handlebar 是整个 Python 模型中的核心执行函数。当模型从数据层获取到运行所需要的数据之后,会对数据集上的每一根 bar,调用一次 handlebar 函数,处理当前这根 bar 上的数据。也就是说,用户模型的核心逻辑都是写在该函数中的,如获取数据,设置下单条件等。在 handlebar 中处理完数据后,用户可以通过 paint 方法将需要绘图输出的结果返回给界面。界面会将输出结果如实的展示出来。
ContextInfo 是整个 Python 框架中的一个核心对象。它包含了各种与 Python 底层框架交互的 API 方法,也是一个全局的上下文环境,可以在 init 以及 handlebar 这两个函数中自由地传递用户创建的各种自定义数据。
用户在界面上提交请求后,在最终看到结果前会经历两步:
(1)创建模型,初始化环境,发送数据请求;
(2)数据到达后,调用 Python 的 init 函数进行 Python 初始化,然后运行 handlebar 方法;
ContextInfo 是 Python 模型中的全局对象,其中封装了 benchmark,universe 等变量,也封装了 get_history_data 等重要函数,是 init 与 handlebar 之间,以及各个 handlebar 之间进行信息传递的重要载体。用户也可以在其中封装自己想要定义的全局变量或函数,但注意不要与原有的重名。
init 和 handlebar 是 Python 模型中最重要的方法,也是唯二由 C++ 直接调用的方法,所有的执行代码都尽量写在这两个方法中或由其中的函数调用。
init 是 Python 的初始化方法,负责初始化模型运行所需的初始变量,如对于基准 benchmark 和股票池 universe 的初始化。
handlebar 是 Python 的核心执行函数。在 K 线图上运行时会根据主图的时间轴,每个时间点会进入相应的 handlebar 方法,可在 handlebar 中使用 ContextInfo.barpos 来获取当前的 bar 索引位置。

获取当前 Bar 位置
*注:
索引:索引的作用相当于图书的目录,可以根据目录中的页码(索引号)快速找到所需的内容。
时间戳:时间戳是指格林威治时间 1970 年 01 月 01 日 00 时 00 分 00 秒(北京时间 1970 年 01 月 01 日 08 时 00 分 00 秒)起至现在的总秒数。通俗的讲,时间戳是一份能够表示一份数据在一个特定时间点已经存在的完整的可验证的数据。
君智系统模型是根据行情驱动,逐 K 线运行的。即点击运行模型时,模型是从第 0 根 K 线开始运行到最后一根 K 线(如想加快模型运行速度,可以策略编辑器 - 基本信息中设置快速计算,限制计算范围,只计算最新的指定数量的 K 线范围),每根 K 线调用一次 Python 模型中的 handlebar(ContextInfo) 函数。

逐 K 线运行:从第 0 根 K 线一直调用 handlebar(ContextInfo) 运行到最后一根
在盘中,最后一根 K 线每变动一次,handlebar(ContextInfo) 函数被执行一次。这根 K 线的最后一个 tick 判定模型信号是否成立,如果模型信号成立,交易函数被调用,则在下一根 K 线的第一个 tick 发出下单信号,生成下单任务。

每个 tick 数据来时,最后一根 K 线会随着变动
一个模型判定:当收盘价 > 开盘价时产生模型信号触发下单
如上图,当盘中运行到最后一根 K 线的时候,每个 tick 数据来时都会判定一下这个条件是否成立,当不是这根 K 线的最后一个 tick,之前的所有的 tick 成立的产生的信号就是虚的信号。只有当这个 K 线确定时,产生的信号才是有效信号,才会触发下单。
模型运行在日 K 线周期及日 K 线以上周期时,因为是在下一根 K 线的第一个 tick(最新行情 tick)发出下单信号,而下一个 K 线就是第二日了。所以模型运行当日无法下单,除非:
(1)设置 passorder 函数中的 quickTrade 参数为 1,立即下单;
(2)使用 do_order(ContextInfo) 函数。
quickTrade 参数设置为 1 可实现最后一根 K 线没有走完生成的模型信号也发出下单信号。
do_order(ContextInfo) 函数被调用后会把上一根 K 线生成的模型信号立刻发出,且只发一次,解决交易函数必须是在下一根 K 线的第一个 tick 数据时发信号的问题。
模型创建方法有三种:
方法一,在【模型研究】界面,使用系统预置的各种示例模型,点击后方“编辑”按钮,并在弹出的【策略编辑器】中以此示例模型代码为基础进行编写。

我的主页 - 编辑模型
方法二,在【模型研究】界面,点击新建模型,选择 Python 模型,在弹出的【策略编辑器】中从头到尾编写一个用户自己的量化模型。

模型研究 - 新建模型
方法三,在模型管理面板右键,选择新建模型,并选择 Python 模型。

模型管理 - 新建模型
【策略编辑器】是国泰君安专门为模型开发者设计的,集成了模型列表、函数列表、函数帮助、模型基本信息、参数设置、回测参数等多个部分,拥有代码高亮、自动补全等便捷功能于一体的便捷的模型编辑、开发环境。

模型编辑页面右侧可选择策略默认的周期、品种
编写 Python 策略需在开始时定义编码格式,如 gbk。
之后可选择导入第三方库,所选第三方库要在券商管理端白名单内才可运行。
Init 方法和 handlebar 方法的定义是必须的。Init 方法会在策略运行开始时调用一次,用以初始化所需对象(包裹在 ContextInfo 对象中传递),设定股票池等。

Handlebar 方法会在历史 K 线上逐 K 线调用,系统会保存函数所做更改。
在盘中交易时间,handlebar 函数会随行情推送(tick 数据)被调用,当一个 tick 数据为所在 K 线最后一个 tick 时,此 tick 调用的 handlebar 所做的更改会被系统保存,如有交易指令,会在下一根 K 线的第一个 tick 到来时发送;其他 tick 可以打印运行结果,但 handlebar 所做更改不会被保存,也不会发送交易信号。
编写创建完模型后,对应模型的基本信息和回测参数进行设置。
名称: 填写模型名称
快捷码: 默认根据模型名称自动生成拼音首字母拼写,如需自定义可以手动进行更改,用于键盘精灵快速引用模型
说明: 简单的说明模型功能
分类: 保存当前模型到某个分类下面
位置: 模型回测或运行时的位置,有副图、主图叠加、主图三种显示位置
默认周期: 点击模型回测或运行时的默认主图周期,可手动切换
默认品种: 点击模型回测或运行时的默认主图品种,可手动切换
复权方式: 提供不复权、前复权、后复权、等比前复权、等比后复权 5 种复权方式
快速计算: 限制计算范围,默认为 0 时模型运行会从模型设置的默认品种(主图)的第一根 K 线开始计算,设置为 n 则从当前 K 线再往前 n 个 K 线开始计算
刷新间隔: 用来设置策略运行的时间间隔。设置了刷新间隔,即每隔一段时间策略按照当前行情运行一次
加密公式: 加密后的公式只有输入密码才可以查看源代码
凭密码导出公式: 此项只有在开启“加密公式”后才能生效,生效后只能使用密码导出到本地
用法注释: 简短的说明模型使用的一些注意项,可不填

策略编辑器 - 基本信息
回测模式指策略以历史行情为依据进行运算,投资者可观察该策略在历史行情所获得的年化收益率、夏普比率、最大回撤、信息比率等指标表现。
开始时间、结束时间: 设置模型回测时间区间
基准: 设置模型收益的参考基准
初始资金: 设置模型回测的初始资金
保证金比例: 设置期货的保证金比例
滑点: 设置回测撮合时的滑点,模拟真实交易的冲击成本
手续费类型: 支持按成交额比例或者固定值计算手续费
买入印花税: 设置买入印花税比例
卖出印花税: 设置卖出印花税比例
最低佣金: 设置单笔交易的最低佣金数额
买入佣金: 设置买入标的时的佣金比例
平昨佣金: 设置股票、期货平昨佣金比例
平今佣金: 设置期货平金佣金比例
最大成交比例: 控制回测中最大成交量不超过同期成交量*最大成交比例。可以点击此参数旁边的'?'按钮了解详情

策略编辑器 - 回测参数
使用者也可在参数设置中设置好参数值,参数名为变量名,模型中可以调用。最新值为变量默认值,运行/回测模式使用。
其中最小 / 最大 / 步长项,为遍历参数。初始项可不填。最小 / 最大都是包含在遍历区间内的,如图所示三个变量,测评时会遍历(20-3+1)[(160-140)/10+1][(-150+250)/10+1] 种组合。

策略编辑器 - 参数设置
点击公式测评,可选择回测模式支持的指标,如单位净值,最大回撤等,作为评价标准。

策略编辑器 - 公式评测
点击优化,评测结果弹窗显示不同参数变量组合下的回测结果,根据结果选择最优参数组合。可点击所需指标进行排序。需要注意的是,在测评之前,需要针对所选品种和周期补充数据。
| 计算参数 | CCI | can_buy | can_sell | 单位净值 | 基准净值 | 开仓次数 | 平仓次数 | 胜率 | 基准年化收益 | 年化收益 | 贝塔系数 | 阿尔法系数 | 波动率 | 夏普比率 | 下方差 | 索提诺比率 | 跟踪误差 | 信息比率 | 最大回撤 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 578 (20,150,-200) | 110.024 | 0 | 1 | 1 | 1.10303 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 579 (20,150,-190) | 110.024 | 0 | 1 | 1 | 1.10303 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 580 (20,150,-180) | 110.024 | 0 | 1 | 1 | 1.10303 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 581 (20,150,-170) | 110.024 | 0 | 1 | 1 | 1.10303 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 582 (20,150,-160) | 110.024 | 0 | 1 | 1 | 1.10303 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 583 (20,150,-150) | 110.024 | 0 | 1 | 1 | 1.10303 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 584 (20,160,-250) | 110.024 | 0 | 1 | 1 | 1.10303 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 585 (20,160,-240) | 110.024 | 0 | 1 | 1 | 1.10297 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 586 (20,160,-230) | 110.024 | 0 | 1 | 1 | 1.10297 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 587 (20,160,-220) | 110.024 | 0 | 1 | 1 | 1.10297 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 588 (20,160,-210) | 110.024 | 0 | 1 | 1 | 1.10297 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 589 (20,160,-200) | 110.024 | 0 | 1 | 1 | 1.10297 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 590 (20,160,-190) | 110.024 | 0 | 1 | 1 | 1.10297 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 591 (20,160,-180) | 110.024 | 0 | 1 | 1 | 1.10297 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 592 (20,160,-170) | 110.024 | 0 | 1 | 1 | 1.10297 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 593 (20,160,-160) | 110.024 | 0 | 1 | 1 | 1.10297 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
| 594 (20,160,-150) | 110.024 | 0 | 1 | 1 | 1.10297 | 0 | 0 | 0 | 0.0423376 | 0 | 0 | -0.03 | 0 | 0 | 0.03 | -1 | 0.0126851 | -0.0136268 | 0 |
在创建用户的模型之前,用户应使用客户端提供的“数据管理”功能,选择并补充模型所需的相应市场、品种以及对应周期的历史数据。

操作 - 数据管理
策略编写完毕后,点击编译,可保存策略。编译按钮在 Python 策略中只起保存功能,不会检查语法与引用的正误。之后点击运行可以看到策略运行效果(如有错误,会在日志输出的位置报错)。

如当前系统所处界面为“行情”界面或“交易”界面,点击运行之前,需在行情中手动设置好 K 线品种和周期,点击运行后,策略即可在当前主图下运行,如下图所示。

策略运行状态之一
如系统当前界面处于“我的主页”界面或“模型研究”和“模型交易”等非行情界面,点击运行时,会基于策略编辑器 - 基本信息中所设置的默认周期和默认品种运行。

策略运行状态之二
当选择的运行位置为副图时,略运行的附图关闭即可。
位 置副图 主图叠加主图
如想关闭策略,将主图下方策

关闭运行中的策略之一

关闭运行中的策略之二
当选择的运行位置为主图叠加时,如想关闭策略,在主图上右键单击取消叠加指标即可。
当选择的运行位置为主图时,键盘精灵输入 KLINE 即可结束模型运行。
如果策略运行不成功,需要进行策略调试这一步。当运行出错时,报错信息会显示在日志输出面板,以供修改调试之用。

策略调试 - 输出日志
对某一策略编译成功后,点击回测,可以通过日志输出查看模型基于历史行情数据回测情况和表现。
在回测之前,需要设置好策略回测运行的主图品种和周期,以及相关的回测参数。回测主图和周期可以在策略编辑器 - 基本信息中进行设置,回测开始和结束时间、基准、费率等可以在策略编辑器 - 回测参数中设置。
用户在回测前,需根据此策略回测运行的主图、周期和时间,在【数据管理】中对行情数据进行下载补充。如回测时间设置为 20180930 至 20190530,运行主图为 SZ.000001 平安银行日线,补充数据时可进行如下设置。

操作 - 数据管理
如果回测正常的话,主界面会跳转到模型设置的默认标的和默认周期界面,并输出模型绩效分析结果。

策略编辑器 - 模型回测
此时,可最小化或者关闭【策略编辑器】,并对回测结果进行分析,随着光标在 K 线主图上的移动,右边回测结果展示窗口会动态显示截止光标所在当日的绩效分析结果(包括年化收益,基准年化收益,单位净值,下方差,信息比率,夏普比率,波动率,索提诺比率,阿尔法系数,贝塔系数,跟踪误差,最大回撤,胜率等)、当日买入、当日卖出、持仓列表。
以上列表均可鼠标右键复制和导出数据。

回测结果分析 - 回测结果随十字光标移动动态展示
如需根据模型生成的买入、卖出列表进行手工交易,则可直接点击“买入'或“卖出'按钮,系统会弹出下单界面由用户进行确认后进行普通交易下单或算法交易下单。交易方式可点击卖出按钮右侧的普通交易进行切换设置。

回测结果买入
副图回测指标:提供图形化的展示,除去绩效分析的相关指标外,用户可以通过编辑模型代码自定义输出一些特色指标,鼠标右键可以选择复制模型运行结果(每一天的数据)。

回测结果分析 - 附图指标输出
另外,回测结果还提供了持仓分析、历史板块汇总、操作明细、日志输出等信息,方便用户进行深入分析。
持仓分析: 可查看光标所在当天持仓的行业分布,展示在相关行业的市值情况、盈利情况、权重以及股票数量情况,鼠标右键可以复制和导出数据;可切换对比基准,和模型持仓进行对比。
历史板块汇总: 可查看模型自回测日期以来到光标所在日期该模型交易标的的汇总信息,包括累计盈亏、累计交易量、累计交易额、持仓天数等;点击选择板块,可以自行选择其常用板块进行板块的各项数据累计汇总;汇总数据均可以进行排序,鼠标右键可以复制和导出数据。
操作明细: 可查看模型回测的历史每一笔交易的明细。
日志输出: 可用于调试输出模型回测和运行情况。
| 回测收益 | |||||||||||
| 年化收益 | 基准年化收益 | 单位净值 | 下方差 | 信息比率 | 夏普比率 | 波动率 | 索提诺比率 | 阿尔法系数 | 贝塔系数 | 跟踪误差 | 最 |
| 0.0186 | 0.2208 | 1.0177 | 0.0185 | -0.1135 | -0.0979 | 0.1168 | -0.8123 | -0.0288 | 0.0911 | 0.0070 | 0. |
| 当日买入 | 当日卖出 | ||||||||||
| 代码 | 名称 | 行业 | 买入均价 | 代码 | 名称 | 行业 | 卖出均价 | ||||
| 1 | 601288 | 农业银行 | 银行 | 4.09 | |||||||
| 2 | 601398 | 工商银行 | 银行 | 6.61 | |||||||
| 3 | 601857 | 中国石油 | 采掘 | 7.98 | |||||||
| 4 | 000002 | 万科 A | 房地产 | 31.90 | |||||||
| 5 | 000333 | 美的集团 | 家用电器 | 54.42 | |||||||
| 6 | 002415 | 海康威视 | 电子 | 38.92 | |||||||
| 合计 6 | |||||||||||
| 8000000080 | 买入 | 卖出 | 普通交易 | ||||||||
| 当日持仓明细 | |||||||||||
| 代码 | 证券名称 | 行业名称 | 成本价 | 当日盈亏 | 持仓数量 | 持仓市值 | |||||
| 1 | 601288 | 农业银行 | 银行 | 4.09 | 0.00 | 1000 | 4090.00 | ||||
| 2 | 601398 | 工商银行 | 银行 | 6.61 | 0.00 | 1000 | 6610.00 | ||||
| 3 | 601857 | 中国石油 | 采掘 | 7.98 | 0.00 | 1000 | 7980.00 | ||||
| 4 | 000002 | 万科 A | 房地产 | 31.90 | 0.00 | 1000 | 31900.00 | ||||
| 5 | 000333 | 美的集团 | 家用电器 | 54.42 | 0.00 | 1000 | 54420.00 | ||||
| 6 | 002415 | 海康威视 | 电子 | 38.92 | 0.00 | 1000 | 38920.00 | ||||
| 合计 6 | 0.00 | 6000 | 143920.00 | ||||||||
| 持仓明细 | 持仓分析 | 历史汇总 | 日志输出 |
回测结果分析 - 绩效分析、当日买入、当日卖出、当日持仓

回测结果分析 - 持仓分析
| 历史品种汇总 | |||||||||
| 高级查询 | |||||||||
| 市场 | 代码 | 名称 | 品种类型 | 行业 | 多空 | 累计盈亏 | 累计交易量 | 累计 | |
| 1 | SH | 601288 | 农业银行 | 股票 | 银行 | - | 563.85 | 3000 | |
| 2 | SH | 601398 | 工商银行 | 股票 | 银行 | - | 1101.41 | 3000 | |
| 3 | SH | 601857 | 中国石油 | 股票 | 采掘 | - | 50.23 | 3000 | |
| 4 | SZ | 000002 | 万科 A | 股票 | 房地产 | - | 2031.56 | 3000 | |
| 5 | SZ | 000333 | 美的集团 | 股票 | 家用电器 | - | 4973.37 | 3000 | |
| 6 | SZ | 002415 | 海康威视 | 股票 | 电子 | - | 8953.53 | 3000 | |
| 合计 6 17673.96 18000 | |||||||||
| 历史板块汇总 | |||||||||
| 选择板块 清空 高级查询 | |||||||||
| 代码 | 板块名称 | 盈利 | 交易费用 | 市值 | 效益权重 | 持仓天数 | 买卖累计 | 盈 | |
| 1 | SW 采掘成份 | SW 采掘成份 | 50.23 | 0.00 | 23730.15 | 0.00% | 56 | 3000 | |
| 2 | SW 化工成份 | SW 化工成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 3 | SW 钢铁成份 | SW 钢铁成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 4 | SW 有色金属成份 | SW 有色金属成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 5 | SW 建筑材料成份 | SW 建筑材料成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 6 | SW 建筑装饰成份 | SW 建筑装饰成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 7 | SW 电气设备成份 | SW 电气设备成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 8 | SW 机械设备成份 | SW 机械设备成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 9 | SW 国防军工成份 | SW 国防军工成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 10 | SW 汽车成份 | SW 汽车成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 11 | SW 家用电器成份 | SW 家用电器成份 | 4973.37 | 0.00 | 127926.63 | 0.00% | 56 | 3000 | |
| 12 | SW 纺织服装成份 | SW 纺织服装成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 13 | SW 轻工制造成份 | SW 轻工制造成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 14 | SW 商业贸易成份 | SW 商业贸易成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 15 | SW 农林牧渔成份 | SW 农林牧渔成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 16 | SW 食品饮料成份 | SW 食品饮料成份 | 0.00 | 0.00 | 0.00 | 0.00% | 0 | 0 | |
| 合计 28 17673.96 342288.97 | |||||||||
| 持仓明细 | 持仓分析 | 历史汇总 | 日志输出 |
回测结果分析 - 历史品种汇总、历史板块汇总
| 操作明细 | ||||||||
| 代码 | 名称 | 行业 | 操作时间 | 操作价格 | 数量 | 市值 | ||
| 1 | 601288 | 农业银行 | 银行 | 2017-03-22 00:0 | 3.09 | 1000 | 3086.15 | |
| 2 | 601398 | 工商银行 | 银行 | 2017-03-22 00:0 | 4.46 | 1000 | 4455.07 | |
| 3 | 601857 | 中国石油 | 采掘 | 2017-03-22 00:0 | 7.87 | 1000 | 7869.45 | |
| 4 | 000002 | 万科 A | 房地产 | 2017-03-22 00:0 | 20.38 | 1000 | 20376.73 | |
| 5 | 000333 | 美的集团 | 家用电器 | 2017-03-22 00:0 | 33.39 | 1000 | 33386.63 | |
| 6 | 002415 | 海康威视 | 电子 | 2017-03-22 00:0 | 20.72 | 1000 | 20716.47 | |
| 7 | 601288 | 农业银行 | 银行 | 2017-06-01 00:0 | 3.41 | 1000 | 3410.00 | |
| 8 | 601398 | 工商银行 | 银行 | 2017-06-01 00:0 | 5.08 | 1000 | 5076.48 | |
| 9 | 601857 | 中国石油 | 采掘 | 2017-06-01 00:0 | 7.74 | 1000 | 7741.25 | |
| 10 | 000002 | 万科 A | 房地产 | 2017-06-01 00:0 | 20.40 | 1000 | 20396.08 | |
| 11 | 000333 | 美的集团 | 家用电器 | 2017-06-01 00:0 | 36.50 | 1000 | 36500.00 | |
| 12 | 002415 | 海康威视 | 电子 | 2017-06-01 00:0 | 27.95 | 1000 | 27950.00 | |
| 13 | 601288 | 农业银行 | 银行 | 2017-08-14 00:0 | 3.61 | 1000 | 3610.00 | |
| 14 | 601398 | 工商银行 | 银行 | 2017-08-14 00:0 | 5.49 | 1000 | 5490.00 | |
| 15 | 601857 | 中国石油 | 采掘 | 2017-08-14 00:0 | 7.88 | 1000 | 7880.70 | |
| 16 | 000002 | 万科 A | 房地产 | 2017-08-14 00:0 | 21.23 | 1000 | 21227.78 | |
| 17 | 000333 | 美的集团 | 家用电器 | 2017-08-14 00:0 | 40.12 | 1000 | 40120.00 | |
| 18 | 002415 | 海康威视 | 电子 | 2017-08-14 00:0 | 30.15 | 1000 | 30150.00 | |
| 19 | 601288 | 农业银行 | 银行 | 2017-08-30 00:0 | 3.85 | 1000 | 3850.00 | |
| 20 | 601398 | 工商银行 | 银行 | 2017-08-30 00:0 | 5.97 | 1000 | 5970.00 | |
| 21 | 601857 | 中国石油 | 采掘 | 2017-08-30 00:0 | 8.06 | 1000 | 8059.13 | |
| 22 | 000002 | 万科 A | 房地产 | 2017-08-30 00:0 | 23.24 | 1000 | 23240.00 | |
| 23 | 000333 | 美的集团 | 家用电器 | 2017-08-30 00:0 | 41.98 | 1000 | 41960.00 | |
| 24 | 002415 | 海康威视 | 电子 | 2017-08-30 00:0 | 31.87 | 1000 | 31870.00 | |
| 25 | 601288 | 农业银行 | 银行 | 2018-02-12 00:0 | 4.09 | 1000 | 4090.00 | |
| 合计 30 | 30000 | 558331.91 | ||||||
| 日志输出 |
回测结果分析 - 操作明细、日志输出
在模型编辑器中,有“回测”和“运行”两个按钮,分别代表两种模式,它们之间的区别如下:
(1)回测模式指策略以历史行情为依据,以回测参数中的开始时间、结束时间为回测时间区间进行运算,投资者可观察该策略在历史行情所获得的年化收益率、夏普比率、最大回撤、信息比率等指标表现。
(2)运行模式指策略根据实时行情信号进行运算,以主图行情开始时间到当前时间为运行区间,进行策略的模拟运行,但不进行真实的委托。
注:如果需要向模拟/实盘柜台发送真实的委托,请将策略加入到“模型交易”中。
(1)国泰君安 Python API 是绑定在我们的主流系统中的,底层是 C++,保证了国泰君安 Python API 对行情数据,财务数据等的高访问速度。
(2)支持跨资产类别的量化交易策略的回测、模拟交易功能。依照我们提供的的策略模板,可以编程出各种独特的投资策略,进行单一市场或跨市场交易。
(3)可以便捷的对投资策略进行日频率、分钟频率的历史回测,了解策略在市场中的历史表现,比较不同策略的优劣;也可以对策略进行模拟交易,了解策略在市场中的真实表现,更加准确的对策略进行评估。
(4)采用的是所见即所得的策略运行机制,完美展示策略运行结果。
君智 Python API 根据客户端版本不同分别提供基于 Python 2.X 和 Python 3.X 规范的标准量化投资策略应用程序接口,本文档示例代码基于 Python 3.X 规范。我司主要通过以下两种方式对外提供:
君智系统的安装包默认自带 Python 运行环境。用户安装完国泰君安客户端后,默认可以直接使用 Python。在这个打包的 Python 环境中,国泰君安除了提供标准的 Python api 带的库外,还集成了如下一些第三方库:
| 名称 | 说明 |
|---|---|
| NumPy | NumPy (Numeric Python) 提供了许多高级的数值编程工具,如:矩阵数据类型、矢量处理,以及精密的运算库。专为进行严格的数字处理而产生。 |
| Pandas | Python Data Analysis Library 或 Pandas 是基于 NumPy 的一种工具,该工具是为了解决数据分析任务而创建的。Pandas 纳入了大量库和一些标准的数据模型,提供了高效地操作大型数据集所需的工具。Pandas 提供了大量能使我们快速便捷地处理数据的函数和方法。 |
| Patsy | 一个线性模型分析和构建工具库。 |
| SciPy | SciPy 函数库在 NumPy 库的基础上增加了众多的数学、科学以及工程计算中常用的库函数。例如线性代数、常微分方程数值求解、信号处理、图像处理、稀疏矩阵等等。 |
| Statsmodels | Python 的统计建模和计量经济学工具包,包括一些描述统计、统计模型估计和推断。 |
| TA_Lib | 称作技术分析库,是一种广泛用在程序化交易中进行金融市场数据的技术分析的函数库。它提供了多种技术分析的函数,可以大大方便我们量化投资中编程工作,内容包括:多种指标,如 ADX, MACD, RSI, 布林轨道等;K 线形态识别,如黄昏之星,锤形线等等。 |
对于有经验的 Python 开发者来说,国泰君安提供了自行引入第三方库的方式。为了引入额外的第三方库,用户需要做如下一些操作:
(1)删除君智系统自带的 Python 库;

(2)安装对应的 Python 版本;
(3)通过 pip 或者其它方式安装所需的第三方库。
用户使用自己安装的 Python 解释器时,需在系统变量中新增一个名为 PYTHONPATH 的环境变量,这个环境变量中至少要加两个路径,一个是 Lib,一个是 DLLs。
变量 值
PROCESSOR_LEVEL 6
PROCESSOR_REVISION 3c03
PSModulePath %ProgramFiles%\WindowsPowerShell\Modules;C:\WINDOW...
PYTHONPATH C:\ProgramData\Anaconda3\envs\Python27\Lib;C:\ProgramD...
RG_GPU_FRAMEWORK_E... C:\Program Files\Red Giant\RGFX
TEMP C:\WINDOWS\TEMP
TMP C:\WINDOWS\TEMP
经过以上几个步骤后,用户就可以在国泰君安的 Python 编辑器中使用自己安装的 Python 第三方库。
在编写一个策略时,首先需要在代码的最前一行写上:
#coding:gbk 统一脚本的编码格式是 GBK

君智系统 Python API 策略代码结构分两个部分,初始化函数 init() 和行情事件函数 handlebar() 。
初始化函数 init() 在整个策略中只执行一次,一般在此函数中设置交易佣金、滑点、基准等一些常用参数。

行情事件函数 handlebar() 为行情数据的处理函数,当前图中每根 K 线为一个行情数据,handlebar() 在每根 K 线上分别依次执行一次。特别的,对于实时行情,最后一根 K 线还没确定时,每个 tick 执行一次 handlebar() 。handlebar() 里面一般写整个策略的执行逻辑。
def handlebar(ContextInfo):
→#1.计算当前主图的cci
→mkdict = ContextInfo.get_market_data(['high','low','close'],count=int(period)+1)
→highs = np.array(mkdict['high'])
→lows = np.array(mkdict['low'])
→closes = np.array(mkdict['close'])
→cci_list = talib.CCI(highs, lows, closes, timeperiod=int(period))
→now_cci = cci_list[-1]
→ContextInfo.paint("CCI", now_cci, -1, 0, 'noaxis')
→
→#2.交易策略
→if len(cci_list)<2:
→|-->return
→
→#买入条件:指数cci进入超卖区间时触发买入信号,过滤连续超卖导致的买入信号
→buy_condition = cci_list[-2]<buy_value<=now_cci and ContextInfo.buy
→#卖出条件:指数cci进入超买区间时触发卖出信号,过滤连续超买导致的卖出信号
→sell_condition = cci_list[-2]>sell_value>=now_cci and ContextInfo.sell
→
→if buy_condition:
→|-->ContextInfo.buy = False
→|-->ContextInfo.sell = True
→|-->#列表中股票分别下单买入10手
→|-->for stockcode in ContextInfo.trade_code_list:
→|-->order_lots(stockcode, 10, ContextInfo, ContextInfo.accID)
←elif sell_condition:
→|-->ContextInfo.buy = True
→|-->ContextInfo.sell = False
→|-->#列表中股票分别下单卖出10手
→|-->for stockcode in ContextInfo.trade_code_list:
→|-->order_lots(stockcode, -10, ContextInfo, ContextInfo.accID)
Python 策略中必须有包含这两个基本方法,否则策略将运行不起来。
用法: init(ContextInfo)
释义: 初始化函数,只在整个策略开始时调用运行一次
参数: ContextInfo:策略运行环境对象,可以用于存储自定义的全局变量
返回: 无
示例:
def init(ContextInfo):
ContextInfo.initProfit = 0
用法: handlebar(ContextInfo)
释义: 行情事件函数,每根 K 线运行一次;实时行情获取状态下,先每根历史 K 线运行一次,再在每个 tick 数据来后驱动运行一次
参数: ContextInfo:策略运行环境对象,可以用于存储自定义的全局变量
返回: 无
示例:
def handlebar(ContextInfo):
# 输出当前运行到的 K 线的位置
print(ContextInfo.barpos)
ContextInfo 是策略运行环境对象,是 init() 和 handlebar() 这两个基本方法必传参数,里面包括了终端自带的属性和方法,还可以添加自定义属性。
*注:除特殊标明外,以下函数均支持回测和实盘/模拟运行模式。
(1)设定股票池 ContextInfo.set_universe()
用法: ContextInfo.set_universe(stocklist)
释义: 设定股票池
参数: list
返回: 无
示例:
def init(ContextInfo):
stocklist = ['000300.SH','000004.SZ']
ContextInfo.set_universe(stocklist)
用法: ContextInfo.set_account(account)
释义: 设定交易账号,并将该账号用于之后的交易主推订阅。
*注:
一、可多次调用以设置多个账号,应在 init 中进行设置完毕,init 执行后再设置将不再订阅交易主
推;
二、调用 passorder 传入账号为空时会使用最后一次设置的账号作为下单账号。
参数: string
返回: 无
示例:
def init(ContextInfo):
account = '6000000223'
ContextInfo.set_account(account)
用法: ContextInfo.start / ContextInfo.end
释义: 设定回测起止时间,标准格式如"2009-07-14 01:13:30",读写
*注:
一、此函数只支持回测模式;
二、仅在 init 中设置生效,应在 init 中设置完毕;
三、缺省值为策略编辑界面设定的回测时间范围;
四、回测起止时间也可在策略编辑器的回测参数面板中设置,若两处同时设置,则以代码中设置的值为准;
五、结束时间小于等于开始时间则计算范围为空。
参数: 无
返回:无
示例:
def init(ContextInfo):
ContextInfo.start = '2012-06-06 10:00:00'
ContextInfo.end = '2013-08-08 14:30:00'
用法: ContextInfo.capital
释义: 设定回测初始资金,读写,默认为 1000000
*注:此函数只支持回测模式。回测初始资金也可在策略编辑器的回测参数面板中设置,若两处同时设置,则以代码中设置的值为准。
参数: 无
返回: number
示例:
def init(ContextInfo):
ContextInfo.capital = 10000000
def handlebar(ContextInfo):
print(ContextInfo.capital)
用法: ContextInfo.set_slippage(slippageType, slippage)
释义: 设定策略回测滑点,默认值 0.00
*注:此函数只支持回测模式。回测滑点也可在策略编辑器的回测参数面板中设置,若两处同时设置,则以代码中设置的值为准。
参数:
slippageType:滑点类型,可选值:
0: tick跳数设置滑点
1: 按照固定值(价格)设置滑点
2: 价格比例设置滑点
slippage:滑点值
返回: 无
示例:
def init(ContextInfo):
# 按照固定值(价格)设置滑点值为 0.01
ContextInfo.set_slippage(1, 0.01)
用法: ContextInfo.set_commission(commissionType, commissionList)
释义: 设定策略回测各种手续费率,默认类型值 0 按比例,默认值 0.000
*注:此函数只支持回测模式。回测各种手续费率也可在策略编辑器的回测参数面板中设置,若两处同时设置,则以代码中设置的值为准。
commissionType:number,可选值:
0:按比例
1:按每手(股)
commissionList:list,包含六个值,commissionList = [open_tax, close_tax, open_commission, close_commission, close_tdaycommission, min_commission]
open_tax: 买入印花税
close_tax:卖出印花税
open_commission:开仓手续费;
close_commission:平仓(平昨)手续费
close_tdaycommission:平今手续费
min_commission: 最少手续费
*注:如果只填写一个参数则代表输入的参数值赋值给 open_commission = close_commission = close_today_commission,其他的值均为 0,这时 commissionType 为 0
返回: 无
示例 1:
def init(ContextInfo):
# 万三
commission = 0.0003
# 设定开仓手续费和平仓手续费以及平今手续费均为 0.0003,其余为 0ContextInfo.set_commission(commission)
def init(ContextInfo):
commissionList = [0, 0.0001, 0.0003, 0.0003, 0, 5]
# 设定买入印花税为 0,卖出印花税为 0.0001,开仓手续费和平仓(平昨)手续费均为万三,平今手续费为 0,最小手续费为 5
ContextInfo.set_commission(0, commissionList)
用法: ContextInfo.get_universe()
释义: 获取股票池中的股票
参数: 无
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_universe())
用法: ContextInfo.period
释义: 获取当前周期,即基本信息中设置的默认周期,只读
参数: 无
返回: string,返回值含义:
'1d':日线'1m':1 分钟线'3m':3 分钟线'5m':5 分钟线'15m':15 分钟线'30m':30 分钟线'1h':小时线'1w':周线'1mon':月线'1q':季线'1hy':半年线'1y':年线
示例:
def handlebar(ContextInfo):
print(ContextInfo.period)
(9)获取当前运行到 K 线索引号 ContextInfo.barpos
用法: ContextInfo.barpos
释义: 获取当前运行到 K 线索引号,只读,索引号从 0 开始
参数: 无
返回: number
示例:
def handlebar(ContextInfo):
print(ContextInfo.barpos)
用法: ContextInfo.time_tick_size
释义: 获取当前图 K 线数目,只读
参数: 无
返回: number
示例:
def handlebar(ContextInfo):
print(ContextInfo.time_tick_size)
(11)判定是否为最后一根 K 线 ContextInfo.is_last_bar()
用法: ContextInfo.is_last_bar()
释义: 判定是否为最后一根 K 线
参数: 无
返回: bool,返回值含义:
True:是
False:否
示例:
def handlebar(ContextInfo):
print(ContextInfo.is_last_bar())
用法: ContextInfo.is_new_bar()
释义: 某根 K 线的第一个 tick 数据到来时,判定该 K 线为新的 K 线
参数: 无
返回: bool,返回值含义:
True: 是 False: 否
示例:
def handlebar(ContextInfo):
print(ContextInfo.is_new_bar())
(13)判定股票是否停牌 ContextInfo.is_suspended_stock()
用法: ContextInfo.is_suspended_stock(stockcode.market)
释义: 判定股票是否停牌
参数: 股票市场和代码
返回: bool,返回值含义:
True: 停牌
False: 未停牌
示例:
def handlebar(ContextInfo):
print(ContextInfo.is_suspended_stock('600004.SH'))
(14)判定给定股票代码是否在指定的板块中 is_sector_stock()
用法: is_sector_stock(sectorname, market, stockcode)
释义: 判定给定股票代码是否在指定的板块中
参数:
sectorname:string,板块名
market:string,市场
stockcode:string,股票代码
返回: bool,返回值含义:
True:在板块中
False:不在板块中
示例:
def handlebar(ContextInfo):
print(is_sector_stock('沪深300','SH','600000'))
(15)判定给定股票是否属于某个类别 is_typed_stock()
用法: is_typed_stock(stocktypenum, market, stockcode)
释义: 判定给定股票是否属于某个类别
参数:
stocktypenum:number,类别标号,如股票类别标号为 100003,详细见5.3. 附录 3 is_typed_stock 函数证券分类表,或者见 xtstocktype.lua 文件
market:string,市场
stockcode:string,股票代码
返回: number,返回值含义:
True
False
示例:
def handlebar(ContextInfo):
print(is_typed_stock(100003,'SH','600000'))
(16)判定给定股票代码是否在指定的行业分类中 get_industry_name_of_stock()
用法: get_industry_name_of_stock(industryType, stockcode)
释义: 判定给定股票代码是否在指定的行业分类中
参数:
industryType:string,行业类别,有 'CSRC' 和 'SW' 两种
stockcode:string,形式如 'stockcode.market',如 '600000.SH'
返回: string:对应行业名,找不到则返回空 string
示例:
def handlebar(ContextInfo):
print(get_industry_name_of_stock('SW','600000.SH'))
用法: ContextInfo.stockcode
释义: 获取当前图代码,只读
参数: 无
返回:string:对应主图代码
def handlebar(ContextInfo):
print(ContextInfo.stockcode)
(18)获取当前主图复权处理方式 ContextInfo.dividend_type
用法: ContextInfo.dividend_type
释义: 获取当前主图复权处理方式
参数: 无
返回: string,返回值含义:
'none':不复权
'front':向前复权
'back':向后复权
'front_ratio':等比向前复权
'back_ratio': 等比向后复权
def handlebar(ContextInfo):
print(ContextInfo.dividend_type)
(19)获取当前主图市场 ContextInfo.market
用法: ContextInfo.market
释义: 获取当前主图市场,只读
参数: 无
返回: string:对应主图市场
示例:
def handlebar(ContextInfo):
print(ContextInfo.market)
用法: ContextInfo.get_stock_name('stockcode')
释义: 根据代码获取名称
参数: stockcode:股票代码,如'000001.SZ',缺省值 ' ' 默认为当前图代码
返回: string(GBK 编码)
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_stock_name('000001.sz'))
用法: get_open_date('stockcode')
释义: 根据代码返回对应股票的上市时间
参数: stockcode:股票代码,如'000001.SZ',缺省值 ' ' 默认为当前图代码
返回: number
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_open_date('000001.sz'))
用法: ContextInfo.do_back_test
释义: 设定是否开启回测模式,只读,默认值为 False
参数: 无
返回: bool
用法: ContextInfo.benchmark
释义: 获取回测基准,只读
*注:此函数只支持回测模式。
参数: 无
返回: string
示例:
def handlebar(ContextInfo):
print(ContextInfo.benchmark)
(24)设定回测系统输出日志显示级别 ContextInfo.data_info_level
用法: ContextInfo.data_info_level
释义: 设定回测系统输出日志显示级别,默认是 0,可设置的值有:0 信息,1 警告,2 错误,3 致命,根据设定显示大于等于该级别的日志
*注:此函数只支持回测模式。
参数: 无
返回: 无
示例:
def init(ContextInfo):
# 显示'错误'级别以上的信息
ContextInfo.data_info_level = 2
(25)获取某个记录类型对应的某个时刻的记录情况 get_result_records()
用法: get_result_records (recordtype, index, ContextInfo)
释义: 获取某个记录类型对应的某个时刻的记录情况。
*注:模型回测时有效,获取的为回测面板中的记录结果
参数:
Recordtype:string,面板类型,可选值:
'buys':买入持仓
'sells':卖出持仓
'holdings':当前持仓
'historysums':历史汇总
'dealdetails':交易明细
index:number,当前主图对应 K 线索引
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
返回: list,返回的 list 结构中包含 0 个或多个 Python 对象,该 Python 对象内含如下属性值:
market:string,市场代码
stockcode:string,合约代码
open_close:number,期货开平:1 开 0 平;股票:1 买 0 卖
direction:number,方向:1 多 -1 空;回购:1 逆回购 -1 正回购
trade_price:number,持仓成本
current_price:number,最新价,持仓中用这个价
profit:number,持仓盈亏
position:number,仓位数量
current_weight:number,仓位权重 [暂无有效数据]
benefit_weight:number,盈利占比权重,记录类型是 'historysums' 时有效
holding_periods:number,累计持仓天数,记录类型是 'historysums' 时有效
buy_sell_times: number, 交易次数, 记录类型是 'historysums' 时有效
commission: number, 手续费
trade_balance: number, 成交额或市值
operate_type: number, 操作类型, 记录类型是 'dealdetails' 时有效
trade_date: number, 交易日期, 毫秒标记, 记录类型是 'dealdetails' 时有效
def handlebar(ContextInfo):
index = ContextInfo.barpos
print(get_result_records('buys', index, ContextInfo))
用法: run_time(funcName,period,startTime,market)
释义: 设置定时器
*注:模型回测时有效,获取的为回测面板中的记录结果
funcName:回调函数名
period:重复调用的时间间隔,'5nSecond'表示每 5 秒运行 1 次回调函数,'5nDay'表示每 5 天运行一次回调函数,'500nMilliSecond'表示每 500 毫秒运行 1 次回调函数
startTime:表示定时器第一次启动的时间,如果要定时器立刻启动,可以设置历史的时间
回调函数参数: ContextInfo:策略模型全局对象
import time
def init(ContextInfo):
ContextInfo.run_time("myHandlebar","5nSecond","2019-10-14 13:20:00","SH")
def myHandlebar(ContextInfo):
print('hello world')
def handlebar(ContextInfo):
pass
#此例为自2019-10-14 13:20:00后每5s运行一次myHandlebar
用法: stop(ContextInfo)
释义: PY 策略模型关闭停止前运行到的函数,复杂策略模型,如中间有起线程可通过在该函数内实现停止线程操作。
*注:PY 策略可不用该函数
参数: ContextInfo:策略模型全局对象
def stop(ContextInfo):
print( 'strategy is stop !')
*注:除特殊标明外,以下函数均支持回测和实盘/模拟运行模式。
(1)获取最新流通股本 ContextInfo.get_last_volume()
用法:ContextInfo.get_last_volume(stockcode)
释义: 获取最新流通股本
参数: string:必须是 'stock.market' 形式
返回: number
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_last_volume('000002.sz'))
(2)获取当前 K 线对应时间的时间戳 ContextInfo.get_bar_timetag()
用法: ContextInfo.get_bar_timetag(index)
释义: 获取当前 K 线对应时间的时间戳
参数: number:K 线索引号
返回: number
示例:
def handlebar(ContextInfo):
index = ContextInfo.barpos
print(ContextInfo.get_bar_timetag(index))
(3)获取当前主图品种最新分笔对应的时间的时间戳
ContextInfo.get_tick_timetag()
用法: ContextInfo.get_tick_timetag()
释义: 获取当前主图品种最新分笔对应的时间的时间戳
参数: 无
返回: number
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_tick_timetag())
用法: ContextInfo.get_sector(sector, realtime)
释义: 获取板块成份股,只支持取指数成份股
string:必须是 'stock.market' 形式,如 '000300.SH' ,可取如沪深 300(000300.SH)、中证 500(000905.SH)、上证 50(000016.SH)等指数的历史成份股
realtime:毫秒级时间戳,如不填则默认取目前最新成份股
返回: list:内含成份股代码,里面股票代码为 '000002.SZ' 形式
def handlebar(ContextInfo):
index = ContextInfo.barpos
realtime = ContextInfo.get_bar_timetag(index)
print(ContextInfo.get_sector('000300.SH', realtime))
用法: ContextInfo.get_industry(industry)
释义: 获取行业成份股,证监会行业,行业列表详见附录 2
参数: string:如 'CSRC 采矿业'
返回: list:内含成份股代码,里面股票代码为 '000002.SZ' 形式
def handlebar(ContextInfo):
print(ContextInfo.get_industry('CSRC采矿业'))
用法: ContextInfo.get_stock_list_in_sector(sectorname, realtime)
释义: 获取板块成份股,支持客户端左侧板块列表中任意的板块,包括自定义板块
string:板块名,如'沪深 300','中证 500'、'上证 50'、'我的自选'等
realtime:毫秒级时间戳
返回: list:内含成份股代码,代码形式为 'stockcode.market',如 '000002.SZ'
def handlebar(ContextInfo):
index = ContextInfo.barpos
realtime = ContextInfo.get_bar_timetag(index)
print(ContextInfo.get_stock_list_in_sector('沪深300', realtime))
(7)获取某只股票在某指数中的绝对权重 ContextInfo.get_weight_in_index()
用法: ContextInfo.get_weight_in_index(indexcode, stockcode)
释义: 获取某只股票在某指数中的绝对权重
参数:
indexcode:string,指数代码,形式如 'stockcode.market',如 '000300.SH'
stockcode:string,股票代码,形式如 'stockcode.market',如 '600004.SH
返回: number:返回的数值单位是 %,如 1.6134 表示权重是 1.6134%
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_weight_in_index('000300.SH', '000002.SZ'))
(8)获取合约乘数 ContextInfo.get_contract_multiplier()
用法: ContextInfo.get_contract_multiplier(contractcode)
释义: 获取合约乘数
参数: string:合约代码,形式如 'code.market',如 'IF1707.IF'
返回: number
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_contract_multiplier('IF1707.IF'))
用法:ContextInfo.get_risk_free_rate(index)
释义: 获取无风险利率,用十年期国债收益率 CGB10Y 作无风险利率
参数: number:当前图 K 线索引号
返回: number
示例:
def handlebar(ContextInfo):
index = ContextInfo.barpos
print(ContextInfo.get_risk_free_rate(index))
(10)获取给定日期对应的 K 线索引号 ContextInfo.get_date_location()
用法: ContextInfo.get_date_location(strdate)
释义: 获取给定日期对应的 K 线索引号,如给定日期小于当前图 K 线对应的最早的日期,结果返回
0;如给定日期大于当前图 K 线对应的最新日期,结果返回最新 K 线的索引号
参数: string:形式如 'yyyymmdd' ,如 '20170711'
返回: number
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_date_location('20170711'))
用法: ContextInfo.get_slippage()
释义: 获取策略设定的滑点
*注:此函数只支持回测模式。
参数: 无
返回: dict,key 包括:
slippage_type
slippage
示例:
def init(ContextInfo):
ContextInfo.set_slippage(0.003)
def handlebar(ContextInfo):
print(ContextInfo.get_slippage())
(12)获取策略设定的各种手续费率 ContextInfo.get_commission()
用法: ContextInfo.get_commission()
释义: 获取策略设定的各种手续费率
*注:此函数只支持回测模式。
参数: 无
返回: dict,key 包括
close_tax
open_commission
close_commission
close_tdaycommission
min_commission
def init(ContextInfo):
ContextInfo.set_commission(0.0003)
def handlebar(ContextInfo):
print(ContextInfo.get_commission())
用法:ContextInfo.get_net_value(index)
释义: 获取策略回测的净值
*注:此函数只支持回测模式。
参数: index = ContextInfo.barpos
返回: number
示例:
def handlebar(ContextInfo):
index = ContextInfo.barpos
print(ContextInfo.get_net_value(index))
ContextInfo.get_financial_data(fieldList,stockList,startDate,endDate,report_type='announce_time')
释义: 获取财务数据
fieldList:字段列表,如 ['CAPITALSTRUCTURE.total_capital',
'ASHAREINCOME.net_profit_incl_min_int_inc'] (例子中取了股本结构中的总股本,与利润表中的净利润),更多支持字段参见4. 财务数据接口使用方法
stockList:股票列表,如 ['600000.SH', '000001.SZ']
startDate:开始时间,如 '20171209'
endDate:结束时间,如 '20171212'
report_type:时间类型,可缺省,默认是按照数据的公告期为区分取数据,设置为'report_time'为按照报告期取数据,可选值:'announce_time','report_time
函数根据 stockList 代码列表,startDate,endDate 时间范围的大小范围不同的数据类型
(1)代码列表1-时间范围为1返回:pandas.Series index=字段
(2)代码列表1-时间范围为n返回:pandas.DataFrame index=时间,columns=字段
(3)代码列表n-时间范围为1返回:pandas.DataFrame index=代码,columns=字段
(4)代码列表n-时间范围为n返回:pandas.Panel items=代码,major_axis=时间,minor_axis=字段
选择按照公告期取数和按照报告期取数的区别:若某公司当年 4 月 26 日发布上年度年报,如果选择按照公告期取数,则当年 4 月 26 日之后至下个财报发布日期之间的
数据都是上年度年报的财务数据,如果选择按照报告期取数,则上年度第4季度(上年度10月1日-12月31日)的数据就是上年度报告期的数据.代码1-时间1:pandas.Series index = 字段
def handlebar(ContextInfo):
# 取股本结构中的总股本,与利润表中的净利润
fieldList = ['CAPITALSTRUCTURE.total_capital',
'ASHAREINCOME.net_profit_incl_min_int_inc']
stockList = ['600000.SH', '000001.SZ']
startDate = '20171209'
endDate = '20171212'
# 获取20171209-20171212时间段浦发银行和平安银行的总股本及利润表的净利润
ContextInfo.get_financial_data(fieldList, stockList, startDate, endDate)
ContextInfo.get_financial_data(tabname,colname,market,code,report_type='report_time',barpos)
(与上一个 ContextInfo.get_financial_data 可同时使用)
释义: 获取财务数据
tabname:表格名称
colname:字段名称
market:市场
code:股票代码
barpos:当前 bar 的索引
report_type:时间类型,可缺省,默认是按照数据的公告期为区分取数据,设置为'report_time'为按照报告期取数据,可选值:'announce_time','report_time
返回: number
def handlebar(ContextInfo):
index = ContextInfo.barpos
# 获取当前时间点浦发银行利润表的净利润,更多支持字段参见[财务数据接口使用方法]
ContextInfo.get_financial_data('ASHAREINCOME',
'net_profit_incl_min_int_inc', 'SH', '600000', index)
用法: ContextInfo.get_history_data(len, period, field, dividend_type = 0, skip_paused = True)
释义: 获取历史行情数据
*注:必须先通过 ContextInfo.set_universe() 设定基础股票池,获取历史行情数据是获取的是股票池中的历史行情数据。
len:number,需获取的历史数据长度
period:string,需获取的历史数据的周期,可选值:
'tick': 分笔线
'1d': 日线
'1m': 1分钟线
'3m': 3分钟线
'5m': 5分钟线
'15m': 15分钟线
'30m': 30分钟线
'1h': 小时线
'1w': 周线
'1mon': 月线
'1q': 季线
'1hy': 半年线
'1y': 年线
field:string,需获取的历史数据的类型,可选值:
'open'
'high'
'low'
'close'
'quoter' (结构见get_market_data)
dividend_type:默认参数,number,除复权,默认不复权,可选值:
0:不复权 1:向前复权 2:向后复权 3:等比向前复权 4:等比向后复权
skip_paused:默认参数,bool,是否停牌填充,默认填充
*注:可缺省参数:dividend_type,skip_paused
返回: 一个字典 dict 结构,key 为 stockcode.market, value 为行情数据 list,list 中第 0 位为最早的价格,第 1 位为次早价格,依次下去。
def init(ContextInfo):
ContextInfo.set_universe(['000300.SH', '000004.SZ'])
def handlebar(ContextInfo):
# 获取股票池中所有股票的最近两日的收盘价
hisdict = ContextInfo.get_history_data(2, '1d', 'close')
for k, v in hisdict.items():
if len(v) > 1:
# 今日涨幅
print(k, ':', v[1] - v[0])
用法: ContextInfo.get_market_data(fields, stock_code = , start_time = '', end_time = '', skip_paused = True, period = '1d', dividend_type = 'none', count = -1)
fields:字段列表:
'open': 开
'high': 高
'low': 低
'close': 收
'volume': 成交量
'amount': 成交额
'settle': 结算价
'quoter': 分笔数据(包括历史)
lastPrice: 最新价
amount: 成交额
volume: 成交量
pvolumn: 前成交量
openInt: 持仓量
stockStatus: 股票状态
lastSettlementPrice: 最新结算价
open: 开盘价
high: 最高价
low: 最低价
settlementPrice: 结算价
lastClose: 收盘价
askPrice: 列表, 卖价五档
bidPrice: 列表, 买价五档
askVol: 列表, 卖量五档
bidVol; 列表, 买量五档
stock_code :默认参数,合约代码列表,合约格式 code.market, 如 '600000.SH',不指定时为当前图合约
start_time:默认参数,开始时间,格式 '20171209' 或 '20171209010101'
end_time:默认参数,结束时间,格式 '20171209' 或 '20171209010101'
skip_paused:默认参数,可选值:
true:如果是停牌股,会自动填充未停牌前的价格作为停牌日的价格
period:默认参数,周期类型:
'tick': 分笔线
'1d': 日线
'1m': 1分钟线
'3m': 3分钟线
'5m': 5分钟线
'15m': 15分钟线
'30m': 30分钟线
'1h': 小时线
'1w': 周线
'1mon': 月线
'1q': 季线
'1hy': 半年线
'1y': 年线
dividend_type:默认参数,缺省值为 'none',除复权,可选值:
'none': 不复权
'front': 向前复权
'back': 向后复权
'front_ratio': 等比向前复权
'back_ratio': 等比向后复权
count:默认参数,缺省值为 -1,大于等于 0 时,效果与 get_history_data 保持一致。
count 和开始时间、结束时间同时设置的效果如下表:
| count 取值 | 时间设置是否生效 | 开始时间和结束时间设置效果 |
|---|---|---|
| count >=0 | 无效 | 从当前时间往回取多少个周期的值,取值数量完全取决于 count |
| count =-1 | 生效 | 同时设置开始时间和结束时间,在所设置的时间段内取值 |
| count =-1 | 生效 | 开始时间结束时间都不设置,取当前最新 bar 的值 |
| count =-1 | 生效 | 只设置开始时间,取所设开始时间到当前时间的值 |
| count =-1 | 生效 | 只设置结束时间,取股票上市第一根 bar 到所设结束时间的值 |
*注:
特别的,默认参数需带上参数名方可生效,调用方式与 Python 别无二致
策略点击运行,以策略代码中所设置的开始时间和结束时间为准,策略点击回测,以 '回测参数' 里所设置的开始时间和结束时间为准。
可缺省参数:start_time,end_time,skip_paused,dividend_type,count
返回:
count >= 0,不同的参数,返回的数据结构不同,以下举例说明了不同的数据结构的类型。(代码指股票代码;时间即为函数中所设置的时间,主要由 count、start_time、end_time 决定;字段即 fields 里的字段)
(1)1 支股票代码,在 1 个时间点(count 缺省默认为 -1,即为当前时间点的 bar),取 1 个字段的值,则返回相应字段的值。
代码:
def init(ContextInfo):
ContextInfo.set_universe(['000831.sz'])
def handlebar(ContextInfo):
df = ContextInfo.get_market_data(['close'], stock_code = ContextInfo.get_universe(), skip_paused = True, period = '1d', dividend_type = 'front')
print(df)
输出:
17.40
(2)1 支股票代码,在一个时间点(count、start_time、end_time 都缺省,即为当前时间点的 bar),取多个字段的值,返回 pandas.Series(pandas 一维数组)类型的值。
代码:
def init(ContextInfo):
ContextInfo.set_universe(['000831.sz'])
def handlebar(ContextInfo):
df = ContextInfo.get_market_data(['close', 'open'], stock_code = ContextInfo.get_universe(), skip_paused = True, period = '1d', dividend_type = 'front')
print(df)
输出:
close 17.40
open 17.11
(3)1 支股票代码,在一个时间段取值,返回 pandas.DataFrame(pandas 二维表格型数据结构)类型的值。
代码:
def init(ContextInfo):
ContextInfo.set_universe(['000831.sz])
def handlebar(ContextInfo):
df = ContextInfo.get_market_data(['close', 'open'], stock_code = ContextInfo.get_universe(), skip_paused = True, period = '1d', dividend_type = 'front', count = 2)
print(df)
输出:
close open
20190618 17.59 17.60
20190619 17.40 17.11
(4)多个股票代码,在一个时间点取值,返回 pandas.DataFrame(pandas 二维表格型数据结构)类型的值。
代码:
def init(ContextInfo):
ContextInfo.set_universe(['000831.SZ', '600000.SH'])
def handlebar(ContextInfo):
df = ContextInfo.get_market_data(['close', 'open'], stock_code = ContextInfo.get_universe(), skip_paused = True, period = '1d', dividend_type = 'front', count = -1)
print(df)
输出:
close open
000831.SZ 17.40 17.11
600000.SH 11.88 12.04
(5)多支股票代码,在一个时间段取值,返回 pandas.Panel(pandas 三维数组结构)类型的值。
代码:
def init(ContextInfo):
ContextInfo.set_universe(['000831.SZ', '600000.SH'])
def handlebar(ContextInfo):
df = ContextInfo.get_market_data(['close', 'open'], stock_code = ContextInfo.get_universe(), skip_paused = True, period = '1d', dividend_type = 'front', count = 2)
print(df)
<class 'pandas.core.panel.Panel'>
Dimensions: 2 (items) x 2 (major_axis) x 2 (minor_axis)
Items axis: 000831.SZ to 600000.SH
Major_axis axis: 20190618 to 20190619
Minor_axis axis: close to open
*注:
需要下载历史数据;
pandas 相关介绍详见 pandas 官方文档;
Python 需要安装 pandas;
时间区间:两边闭区间。
get_history_data() 和 get_market_data() 两者区别:get_history_data() 是获取设定的股票池中股票某段行情,主要用来构建简单的指标;get_market_data() 可获取任意股票行情,返回行情数据可以是 dataframe,可用于复杂的分析。
def handlebar(ContextInfo):
# 以 period 参数指定需要的周期
Result = ContextInfo.get_market_data(['open','high','low','close'],
['600000.SH'], '20170101', '20170102', True, '1d', 'none')
d_m = ContextInfo.get_market_data(['close'], ['600000.SH'], start_time =
'20181230', end_time = '20190107', period = '1d')
print(d_m)
m_m = ContextInfo.get_market_data(['close'], ['600000.SH'], start_time =
'20181230', end_time = '20190107', period = '1m')
print(m_m)
def init(ContextInfo):
# 先设置股票池,此时股票池只有一个股票
ContextInfo.set_universe(['000001.sz'])
def handlebar(ContextInfo):
# 获取平安银行当前 bar 的收盘价
close = ContextInfo.get_market_data(['close'], stock_code = ContextInfo.get_universe(), period = '1d', dividend_type = 'front', count = 1)
# 打印平安银行当前bar的收盘价
print(close) # close 是一个数值
# 获取平安银行最新的开高低收四个价格
df1 = ContextInfo.get_market_data(['open', 'high', 'low', 'close'], stock_code = ContextInfo.get_universe(), period = '1d', dividend_type = 'front', count = 1)
# 打印平安银行当前bar的最高价
print(df1['high']) # df1 是一个 pandas.series
# 获取平安银行最近两天的高开低收
df2 = ContextInfo.get_market_data(['open', 'high', 'low', 'close'], stock_code = ContextInfo.get_universe(), period = '1d', dividend_type = 'front', count = 2)
# 打印平安银行昨天的收盘价
print(df2['close'][-2]) # df2 是一个 pandas.dataframe
用法: ContextInfo.get_full_tick(stock_code=)
参数:
stock_code:number,默认参数,合约代码列表,如 ['600000.SH','600036.SH'],不指定时为当前主图合约。
返回:根据 stock_code 返回一个 dict,该字典的 key 值是股票代码,其值仍然是一个 dict,在该 dict 中存放股票代码对应的最新的数据。该字典数据 key 值有:
lastPrice:最新价
amount:成交额
volume:成交量
pvolume:前成交量
openInt:持仓量
stockStatus:股票状态
lastSettlementPrice:最新结算价
open:开盘价
high:最高价
low:最低价
settlementPrice:结算价
lastClose:收盘价
askPrice:列表,卖价五档
bidPrice:列表,买价五档
askVol:列表,卖量五档
bidVol:列表,买量五档
示例:
def handlebar(ContextInfo):
if not ContextInfo.is_last_bar():
return
Result=ContextInfo.get_full_tick(['600000.SH','000001.SZ'])
(19)获取除权除息日和复权因子 ContextInfo.get_divid_factors()
用法:ContextInfo.get_divid_factors(stock.market)
释义: 获取除权除息日和复权因子
参数: stock.market:股票代码。市场代码,如 '600000.SH'
返回: dict,除权除息日与复权因子的映射字典
示例:
def handlebar(ContextInfo):
Result = ContextInfo.get_divid_factors('600000.SH')
(20)获取当前期货主力合约 ContextInfo.get_main_contract()
用法:ContextInfo.get_main_contract(codemarket)
释义: 获取当前期货主力合约
参数: codemarket:合约和市场,合约格式为品种名加 00,如 IF00.IF,zn00.SF
返回: str,合约代码
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_main_contract('IF00.IF'))
用法: timetag_to_datetime(timetag, format)
释义: 将毫秒时间转换成日期时间
timetag:毫秒时间,1512748800000
Format:格式字符串,'%Y-%m-%d %H:%M:%S' 等任意格式
返回: str,合约代码
示例:
def handlebar(ContextInfo):
print(timetag_to_datetime(1512748860000, '%Y%m%d %H:%M:%S'))
用法: ContextInfo.get_total_share(stockcode)
释义: 获取总股数
参数: stockcode:string,股票代码,缺省值 '',默认为当前图代码,如:'600000.SH'
返回: number
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_total_share('600000.SH'))
用法: ContextInfo.get_trading_dates(stockcode, start_date, end_date, count, period)
释义: 获取指定个股 / 合约 / 指数的 K 线(交易日)列表
stockcode:string,股票代码,缺省值'',默认为当前图代码,如 '600000.SH'
start_date:string,开始时间,缺省值'',为空时不使用,如 '20170101','20170101000000'
end_date:string,结束时间,缺省值'',默认为当前 bar 的时间,如'20170102','20170102000000'
count:int,K 线个数,必须大于 0,取包括 end_date 往前的 count 个 K 线,start_date 不为空时不使用
period:string,K 线类型如下:
'1d':日线
'1m':1 分钟线
'3m':3 分钟线
'5m':5 分钟线
'15m':15 分钟线
'30m':30 分钟线
'1h': 小时线
'1w': 周线
'1mon': 月线
'1q': 季线
'1hy': 半年线
'1y': 年线
*注:可缺省参数:start_date,end_date
返回: List,K 线周期(交易日)列表,period 为日线时返回 ['20170101', '20170102', ...],其它返回 ['20170101010000', '20170102020000', ...]
def handlebar(ContextInfo):
print(ContextInfo.get_trading_dates('600000.SH', '20170101', '20170401', 1, '1d'))
(24)根据代码获取对应股票的内盘成交量 ContextInfo.get_svol()
用法: ContextInfo.get_svol(stockcode)
释义: 根据代码获取对应股票的内盘成交量
参数: stockcode:股票代码,如 '000001.SZ',缺省值'',默认为当前图代码
返回: string
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_svol('000001.sz'))
(25)根据代码获取对应股票的外盘成交量 ContextInfo.get_bvol()
用法: ContextInfo.get_bvol(stockcode)
释义: 根据代码获取对应股票的外盘成交量
参数: stockcode:股票代码,如 '000001.SZ',缺省值'',默认为当前图代码
返回: string
示例:
def handlebar(ContextInfo):
print(ContextInfo.get_bvol('000001.sz'))
(26)获取龙虎榜数据 ContextInfo.get_longhubang()
用法: ContextInfo.get_longhubang(stock_list, startTime, endTime)
释义: 获取龙虎榜数据
stock_list: 股票列表, list, 如 ['600000.SH', '600036.SH']
startTime: 起始时间, 如 '20170101'
endTime: 结束时间, 如 '20180101'
返回: Dataframe, 字段:
reason: 上榜原因
close: 收盘价
spreadRate: 涨跌幅
TurnoverVolume: 成交量
Turnover_Amount: 成交金额
buyTraderBooth: 买方席位,datframe
sellTraderBooth: 卖方席位,datframe
• buyTraderBooth 或 sellTraderBooth 包含字段:
traderName: 交易营业部名称
buyAmount: 买入金额
buyPercent: 买入金额占总成交占比
sellAmount: 卖出金额
sellPercent: 卖出金额占总成交占比
totalAmount: 该席位总成交金额
rank: 席位排行
direction: 买卖方向
def handlebar(ContextInfo):
print(ContextInfo.get_longhubang(['000002.sz Wall', '20100101', '20180101'))
用法: get_top10_share_holder(self, stock_list, data_name, start_time, end_time)
释义: 获取十大股东数据
data_name:flow_holder 或 holder
stock_list:股票列表,list,如 ['600000.SH', '600036.SH']
startTime:起始时间,如 '20170101'
endTime:结束时间,如 '20180101'
series(一只股票一个季度)
dataframe(多只股票一个季度数据或者一只股票多个季度数据)
holdName: 股东名称
holderType: 持股类型
holdNum: 持股数量,
changReason: 变动原因
holdRatio: 持股比例
stockType: 股份性质
rank: 持股排名
status: 持股状态
changNum: 增减数量
changeRatio: 增减比例
def handlebar(ContextInfo):
print(ContextInfo.get_top10_share_holder(['000002.sz'], 'flow_holder',
'20100101', '20180101'))
ContextInfo.get_option_detail_data(optioncode)
用法: ContextInfo.get_option_detail_data(optioncode)
释义: 获取指定期权品种的详细信息
optioncode:期权代码,如'10001506.SHO',当填写空字符串时候默认为当前主图的期权品种
dict
字段
ExchangeID:期权市场代码 InstrumentID:期权代码 ProductID:期权标的的产品 ID OpenDate:发行日期 ExpireDate:到期日 PreClose:前收价格 SettlementPrice:前结算价格 UpStopPrice:当日涨停价 DownStopPrice:当日跌停价 LongMarginRatio:多头保证金率 ShortMarginRatio:空头保证金率
PriceTick:最小变价单位
VolumeMultiple:合约乘数
MaxMarketOrderVolume:涨跌停价最大下单量
MinMarketOrderVolume:涨跌停价最小下单量
MaxLimitOrderVolume:限价单最大下单量
MinLimitOrderVolume:限价单最小下单量
OptUnit:期权合约单位
MarginUnit:期权单位保证金
OptUndlCode:期权标的证券代码
OptUndlMarket:期权标的证券市场
OptExercisePrice:期权行权价
NeeqExeType:全国股转转让类型
OptUndlRiskFreeRate:期权标的无风险利率
OptUndlHistoryRate:期权标的历史波动率
EndDelivDate:期权行权终止日
示例:
def handlebar(ContextInfo):
print ContextInfo.get_option_detail_data('10001506.SHO')
**用法:**ContextInfo.load_stk_list(filePath,fileName)
释义: 获取一篮子证券编码数据
txt 文件信息格式:600000.SH,600004.SH,600006.SH,或 600000.SH600004.SH600006.SH(最后一个字段 600006.SH 需要增加分隔符)
参数:
filePath:文件路径
fileName:文件名 (比如:a.txt,b.csv)
返回: 返回文档内容
示例:
def handlebar(ContextInfo):
ContextInfo.load_stk_list('D:/data/', 'list.txt')
用法: ContextInfo.load_stk_vol_list(filePath,fileName)
释义: 获取一篮子证券编码及数量数据
txt 文件信息格式:600000.SH,100,600004.SH,200,或 600000.SH100600004.SH200(篮子数据成对存在 (前面是合约代码,后面是数量) 且数量字段 200 后需要增加分隔符)
csv 文件信息格式:600000.SH,100,600004.SH,200,(篮子数据成对存在 (前面是合约代码,后面是数量) 且数量字段 200 后需要增加分隔符)
filePath:文件路径
fileName:文件名 (比如:a.txt,b.csv)
返回: 返回文档内容
def handlebar(ContextInfo):
ContextInfo.load_stk_vol_list('D:/data/', 'list.txt')
ContextInfo.get_local_data(stock_code,start_time=",end_time=",period='1d',divid_type='none',count=-1)
释义: 获取本地行情数据
stock_code:默认参数,合约代码 code.market 不指定时为当前图合约
start_time:默认参数,开始时间,格式'20171209'或'20171209010101'
end_time:默认参数,结束时间,格式同 start_time
period:string,默认参数,,K 线类型,可选值:
'tick': 分笔线(只用于获取'quoter'字段数据)
'realtime': 实时线
'1d': 日线
'md': 多日线
'1m': 1分钟线
'3m': 3分钟线
'5m': 5分钟线
'15m': 15分钟线
'30m': 30分钟线
'mm': 多分钟线
'1h': 小时线
'mh': 多小时线
'1w': 周线
'1mon': 月线
'1q': 季线
'1hy': 半年线
'1y': 年线
dividend_type:默认参数,number,除复权,可选值:
'none': 不复权
'front': 向前复权
'back': 向后复权
'front_ratio': 等比向前复权
'back_ratio': 等比向后复权
count:默认参数,大于等于 0 时,若指定了 start_time,end_time,此时以 end_time 为基准向前取 count 条;若 start_time,end_time 缺省,默认取本地数据最新的 count 条数据;若 start_time,end_time,count 都缺省时,默认取本地全部数据。
特别的,默认参数需带上参数名方可生效,调用方式与 python 别无二致。
返回:返回一个 dict,键值为 timetag,value 为另一个 dict(valuedict)
period='tick'时函数获取分笔数据,valuedict 字典数据 key 值有:
lastPrice: 最新价
amount: 成交额
volume: 成交量
pvolume: 前成交量
openInt: 持仓量
stockStatus: 股票状态
lastSettlementPrice: 最新结算价
open: 开盘价
high: 最高价
low: 最低价
settlementPrice: 结算价
lastClose: 收盘价
askPrice: 列表,卖价五档
bidPrice: 列表,买价五档
askVol: 列表,卖量五档
bidVol: 列表,买量五档
period 为其他值时,valuedict 字典数据 key 值有:
amount: 成交额
volume: 成交量
open: 开盘价
high: 最高价
low: 最低价
close: 收盘价
*注:时间区间两边闭区间
示例:
def handlebar(ContextInfo):
Result=ContextInfo.get_local_data(stock_code='600000.SH',start_time='20170101',end_time='20170102',period='1d',divid_type='none')
**用法:**ContextInfo.get_turnover_rate(stock_list,startTime,endTime)
释义: 获取换手率
stock_list:股票列表,list,如 ['600000.SH','000001.SZ']
startTime:起始时间,如'20170101'
endTime:结束时间,如'20180101'
返回: dataframe
示例:
def handlebar(ContextInfo):
print( ContextInfo.get_turnover_rate(['000002.sz'], '20170101', '20180101'))
用法: get_etf_info(stockcode)
释义: 根据 ETF 基金代码获取 ETF 申赎清单及对应成分股数据
stockcode:ETF 基金代码(如"510050.SH")
返回:返回一个 dict,键值为 timetag,value 为另一个 dict(valuedict)
etfCode:ETF 代码
etfExchID:ETF 市场
prCode:基金申赎代码
cashBalance:现金差额(单位:元)
maxCashRatio:现金替代比例上限
reportUnit:最小申购、赎回单位(单位:份)
name:基金名称
navPerCU:最小申购、赎回单位净值(单位:元)
nav:基金份额净值(单位:元)
ecc:预估现金差额(单位:元)
needPublish:是否需要公布 IOPV(1:是,0:否)
enableCreation:是否允许申购(1:是,0:否)
enableRedemption:是否允许赎回(1:是,0:否)
creationLimit:申购上限(单位:份,0:不限制)
redemptionLimit:赎回上限(单位:份,0:不限制)
tradingDay:交易日期(格式 YYYYMMDD)
preTradingDay:前交易日期(格式 YYYYMMDD)
stocks:成分股列表
exchangeID:ETF 基金市场代码
etfCode:ETF 基金代码
etfName:ETF 基金名称
componentExchID:成份股市场代码
componentCode:成份股代码
componentName:成份股名称
componentVolume:成份股数量
ReplaceFlag:替代标记 (48:禁止替代,49:允许替代,50:必须替代,51:替补替代)
ReplaceRatio:溢价比率
ReplaceBalance:替代金额
示例:
get_etf_info("510050.SH")#获取ETF基金代码为511050的全部ETF申赎清单数据
(34)根据 ETF 基金代码获取 ETF 的基金份额参考净值 get_etf_iopv()
用法: get_etf_iopv(stockcode)
释义: 根据 ETF 基金代码获取 ETF 的基金份额参考净值
参数:
stockcode:ETF 基金代码(如"510050.SH")
**返回:**IOPV,基金份额参考净值
示例:
get_etf_iopv("510050.SH")
用法: ContextInfo.get_instrumentdetail(stockcode)
释义: 根据代码获取合约详细信息
参数:
stockcode:string,股票代码,如'600000.SH'
返回:根据 stockcode 返回一个 dict。该字典数据 key 值有:
ExchangeID:合约市场代码
InstrumentID:合约代码
InstrumentName:合约名称
ProductID:合约的品种 ID(期货)
ProductName:合约的品种名称 (期货)
CreateDate:上市日期 (期货)
OpenDate:IPO 日期 (股票)
ExpireDate: 退市日或者到期日
PreClose: 前收盘价格
SettlementPrice: 前结算价格
UpStopPrice: 当日涨停价
DownStopPrice: 当日跌停价
FloatVolumn: 流通股本
TotalVolumn: 总股本
LongMarginRatio: 多头保证金率
ShortMarginRatio: 空头保证金率
PriceTick: 最小变价单位
VolumeMultiple: 合约乘数(对期货以外的品种,默认是1)
MainContract: 主力合约标记
LastVolume: 昨日持仓量
InstrumentStatus: 合约停牌状态
IsTrading: 合约是否可交易
IsRecent: 是否是近月合约
示例:
def handlebar(ContextInfo):
print ContextInfo.get_instrumentdetail('600000.SH')
(36)获取期货合约到期日 ContextInfo.get_contract_expire_date()
释义: 获取期货合约到期日
参数:
**返回:**int,合约到期日
示例:
def handlebar(ContextInfo):
print( ContextInfo.get_contract_expire_date('IF00.IF'))
交易函数下单跟界面人工点击下单走的下单、风控流程是一样的,唯一的区别是:交易函数下单通过解析下单函数接口传过来的参数,形成相应的下单任务;而界面人工点击下单通过解析界面的输入、选择,形成相应的下单任务。
运作流程:

(2)运行策略

(3)触发下单,解析参数


(5)形成委托,过风控
(6)成交

君智系统提供了一系列的 Python 下单函数接口,如下所示。
*注:在回测模式中,交易函数调用虚拟账号进行交易,在历史 K 线上记录买卖点,用以计算策略净值/回测指标;实盘运行调用策略中设置的资金账号进行交易,产生实际委托;模拟运行模式下交易函数无效。其中,can_cancel_order, cancel_task, cancel 和 do_order 交易函数在回测模式中无实际意义,不建议使用。
| 函数名 | 释义 |
|---|---|
| passorder | 综合交易下单 |
| smart_algo_passorder | 智能算法交易 |
| get_trade_detail_data | 取交易细明数据函数 |
| get_value_by_order_id | 根据委托 Id 取委托或成交信息 |
| get_last_order_id | 获取最新的委托或成交的委托 Id |
| can_cancel_order | 查询委托是否可撤销 |
| cancel | 取消委托 |
| cancel_task | 撤销任务 |
| pause_task | 暂停任务 |
| resume_task | 继续任务 |
| do_order | 实时触发前一根 bar 信号函数 |
| stoploss_limitprice | 以限价单方式止损/止盈 |
| stoploss_marketprice | 以市价单方式止损/止盈 |
| get_new_purchase_limit | 获取账号新股申购额度 |
| 函数名 | 释义 |
|---|---|
| order_lots | 指定手数交易 |
| order_value | 指定价值交易 |
| order_percent | 一定比例下单 |
| order_target_value | 目标价值下单 |
| order_target_percent | 目标比例下单 |
| order_shares | 指定股数交易 |
| 函数名 | 释义 |
|---|---|
| buy_open | 买入开仓 |
| sell_close_tdayfi rst | 卖出平仓,平今优先 |
| sell_close_ydayfi rst | 卖出平仓,平昨优先 |
| sell_open | 卖出开仓 |
| buy_close_tdayfi rst | 买入平仓,平今优先 |
| buy_close_ydayfi rst | 买入平仓,平昨优先 |
用法: passorder(opType, orderType, accountid, orderCode, prType, modelprice, volume[, strategyName, quickTrade, userOrderId], ContextInfo)
释义: 综合交易下单
opType,操作类型,可选值:
期货六键:
0:开多 1:平昨多 2:平今多 3:开空 4:平昨空 5:平今空
期货四键:
6:平多,优先平今 7:平多,优先平昨 8:平空,优先平今 9:平空,优先平昨
10:卖出,如有多仓,优先平仓,优先平今,如有余量,再开空
11:卖出,如有多仓,优先平仓,优先平昨,如有余量,再开空
12:买入,如有空仓,优先平仓,优先平今,如有余量,再开多
13:买入,如有空仓,优先平仓,优先平昨,如有余量,再开多
14:买入,不优先平仓
15:卖出,不优先平仓
股票买卖:
23:股票买入,或沪港通、深港通股票买入
24:股票卖出,或沪港通、深港通股票卖出
27:融资买入
28:融券卖出
29:买券还券
30:直接还券
31:卖券还款
32:直接还款
33:信用账号股票买入
34:信用账号股票卖出
50:买入开仓 51:卖出平仓 52:卖出开仓 53:买入平仓 54:备兑开仓 55:备兑平仓 56:认购行权 57:认沽行权 58:证券锁定 59:证券解锁
二、对所有账号组的操作相当于对账号组里的每个账号做一样的操作,如 passorder(23,
1202, 'testS', '000001.SZ', 5, -1, 50000, ContextInfo),意思就是对账号组 testS 里的所有账
号都以最新价开仓买入 50000 元市值的 000001.SZ 平安银行;
passorder(60,1101,"test",'510050.SH',5,-1,1,ContextInfo) 意思就是账号 test 申购 1 个单位
(900000 股) 的华夏上证 50ETF(只申购不买入成分股)。
1101:单股、单账号、普通、股/手方式下单
1102:单股、单账号、普通、金额(元)方式下单(只支持股票)
1113:单股、单账号、总资产、比例 [0 ~ 1] 方式下单
1123:单股、单账号、可用、比例 [0 ~ 1] 方式下单
1201:单股、账号组(无权重)、普通、股/手方式下单
1202:单股、账号组(无权重)、普通、金额(元)方式下单(只支持股票)
1213:单股、账号组(无权重)、总资产、比例 [0 ~ 1] 方式下单
1223:单股、账号组(无权重)、可用、比例 [0 ~ 1] 方式下单
2101:组合、单账号、普通、按组合股票数量(篮子中股票设定的数量)方式下单 > 对应
volume 的单位为篮子的份
2102:组合、单账号、普通、按组合股票权重(篮子中股票设定的权重)方式下单 > 对应
volume 的单位为元
2103:组合、单账号、普通、按账号可用方式下单 > (底层篮子股票怎么分配?答:按可用
资金比例后按篮子中股票权重分配,如用户没填权重则按相等权重分配)只对股票篮子支持
2201:组合、账号组(无权重)、普通、按组合股票数量方式下单
2202:组合、账号组(无权重)、普通、按组合股票权重方式下单
2203:组合、账号组(无权重)、普通、按账号可用方式下单只对股票篮子支持
passorder(opType, orderType, accountID, orderCode, prType, hedgeRatio, volume, ContextInfo)
accountID = 'stockAccountID, futureAccountID'
orderCode = 'basketName, futureName'
hedgeRatio:套利比例(0 ~ 2 之间值,相当于 %0 至 200% 套利)
volume:份数 \ 资金 \ 比例
orderType(特殊设置)
orderType 可选值:
2331:组合、套利、合约价值自动套利、按组合股票数量方式下单
2332:组合、套利、按合约价值自动套利、按组合股票权重方式下单
2333:组合、套利、按合约价值自动套利、按账号可用方式下单
passorder(opType, orderType, accountID, orderCode, prType, price, volume, ContextInfo) *注:下单的账号 ID(可多个)或账号组名或套利组名(一个篮子一个套利账号,如 accountID =股票账户名,期货账号')
passorder(opType, orderType, accountID, orderCode, prType, price, volume, ContextInfo) *注:
一、如果是单股或单期货、港股,则该参数填合约代码;
二、如果是组合交易,则该参数填篮子名称;
三、如果是组合套利,则填一个篮子名和一个期货合约名(如 orderCode = '篮子名,期货合约名')
passorder(opType, orderType, accountID, orderCode, prType, price, volume, ContextInfo) 可选值(特别的对于套利,这个 prType 只对篮子起作用,期货的采用默认的方式):
-1:无效(实际下单时,需要用交易面板交易函数那设定的选价类型)0:卖 5 价 1:卖 4 价 2:卖 3 价 3:卖 2 价 4:卖 1 价 5:最新价 6:买 1 价 7:买 2 价(组合不支持)8:买 3 价(组合不支持)9:买 4 价(组合不支持)10:买 5 价(组合不支持)
11:(指定价)模型价(只对单股情况支持,对组合交易不支持)12:涨跌停价 13:挂单价 14:对手价
27:市价即成剩撤 (仅对股票期权申报有效)
28:市价即全成否则撤 (仅对股票期权申报有效)
29:市价剩转限价 (仅对股票期权申报有效)
42:最优五档即时成交剩余撤销申报 (仅对上交所申报有效)
43:最优五档即时成交剩转限价申报 (仅对上交所申报有效)
44:对手方最优价格委托 (仅对深交所申报有效)
45:本方最优价格委托 (仅对深交所申报有效)
46:即时成交剩余撤销委托 (仅对深交所申报有效)
47:最优五档即时成交剩余撤销委托 (仅对深交所申报有效)
48:全额成交或撤销委托 (仅对深交所申报有效)
49:科创板盘后定价
passorder(opType, orderType, accountID, orderCode, prType, price, volume, ContextInfo) *注:
一、单股下单时,prType 是模型价/科创板盘后定价时 price 有效;其它情况无效;即单股时,prType 参数为 11,49 时被使用。prType 参数不为 11,49 时也需填写,填写的内容可为 -1,0,2,100 等任意数字;
二、组合下单时,是组合套利时,price 作套利比例有效,其它情况无效。
volume,下单数量(股 / 手 / 元 / %)
passorder(opType, orderType, accountID, orderCode, prType, price, volume, ContextInfo) 根据 orderType 值最后一位确定 volume 的单位:
单股下单时:
1:股 / 手 2:金额(元)3:比例(%)
组合下单时:
1:按组合股票数量(份)
2:按组合股票权重(元)
3:按账号可用(%)
strategyName,string,自定义策略名,可缺省不写,用来区分 order 委托和 deal 成交来自不同的策略。根据该策略名,get_trade_detail_data,get_last_order_id 函数可以获取相应策略名对应的委托或持仓结果。
*注:strategyName 只对同账号本地客户端有效,即 strategyName 只对当前客户端下的单进行策略区分,且该策略区分只能当前客户端使用。
quickTrade,int,设定是否立即触发下单,可选值:
0: 否
1: 是
*注:passorder 是对最后一根 K 线完全走完后生成的模型信号在下一根 K 线的第一个 tick 数据来时触发下单交易;采用 quickTrade 参数设置为 1 时,非历史 bar 上执行时(ContextInfo.is_last_bar() 为 True),只要策略模型中调用到就触发下单交易。quickTrade 参数设置为 2 时,不判断 bar 状态,只要策略模型中调用到就触发下单交易,历史 bar 上也能触发下单,请谨慎使用。
userOrderId,string,用户自设委托 ID,可缺省不写,写的时候必须把起前面的 strategyName 和 quickTrade 参数也填写。对应 order 委托对象和 deal 成交对象中的 m_strRemark 属性,通过 get_trade_detail_data 函数或委托主推函数 order_callback 和成交主推函数 deal_callback 可拿到这两个对象信息。
userOrderParam,string,用户自定义交易参数模板名称,可缺省不写,写的时候必须把起前面的 strategyName 和 quickTrade 参数也填写。
返回: 无
示例:
def handlebar(ContextInfo):
# 单股单账号期货最新价买入 10 手
passorder(0, 1101, 'test', target, 5, -1, 10, ContextInfo)
# 单股单账号期货指定价买入 10 手
passorder(0, 1101, 'test', target, 11, 3000, ContextInfo)
# 单股单账号股票最新价买入 100 股(1 手)
passorder(23, 1101, 'test', target, 5, 0, 100, ContextInfo)
# 单股单账号股票指定价买入 100 股(1 手)
passorder(23, 1101, 'test', target, 11, 7, 100, ContextInfo)
用法: smart_algo_passorder(opType, orderType, accountid, orderCode, prType, modelprice, volume, smartAlgoType, limitOverRate, minAmountPerOrder, [targetPriceLevel], ContextInfo)
opType,操作类型,可选值:
23:股票买入,或沪港通、深港通股票买入
24:股票卖出,或沪港通、深港通股票卖出
27:融资买入
28:融券卖出
29:买券还券
30:直接还券
31:卖券还款
32:直接还款
33:信用账号股票买入
34:信用账号股票卖出
1101:单股、单账号、普通、股/手方式下单
1102:单股、单账号、普通、金额(元)方式下单(只支持股票)
1113:单股、单账号、总资产、比例 [0 ~ 1] 方式下单
1123:单股、单账号、可用、比例 [0 ~ 1] 方式下单
1201:单股、账号组(无权重)、普通、股/手方式下单
1202:单股、账号组(无权重)、普通、金额(元)方式下单(只支持股票)
1213:单股、账号组(无权重)、总资产、比例 [0 ~ 1] 方式下单 1223:单股、账号组(无权重)、可用、比例 [0 ~ 1] 方式下单
*注:下单的账号 ID(可多个)或账号组名
orderCode,下单代码
*注:单股下单,则该参数填合约代码;
可选值:
-1:无效(实际下单时,需要用交易面板交易函数那设定的选价类型)0:卖 5 价 1:卖 4 价 2:卖 3 价 3:卖 2 价 4:卖 1 价 5:最新价 6:买 1 价 7:买 2 价 8:买 3 价 9:买 4 价 10:买 5 价 11:(指定价)模型价 12:涨跌停价 13:挂单价 14:对手价 49:科创板盘后定价
*注:prType 是模型价/科创板盘后定价时 price 有效;其它情况无效;即 prType 参数为 11,49 时被使用。prType 参数不为 11,49 时也需填写,填写的内容可为 -1,0,2,100 等任意数字。
根据 orderType 值最后一位确定 volume 的单位:
单股下单时:
1:股 2:金额(元)3:比例(%)
strageName,策略名不同于 passorder,这里不可缺省
quickTrade,参数内容说明 quickTrade:int,是否立马触发下单,0 否,1 是*注:
passorder 是对最后一根 K 线完全走完后生成的模型信号在下一根 K 线的第一个 tick 数据来时触发下单交易;
采用 quickTrade 参数设置为 1 时,非历史 bar 上执行时(ContextInfo.is_last_bar() 为 True),只要策略模型中调用到就触发下单交易。
quickTrade 参数设置为 2 时,不判断 bar 状态,只要策略模型中调用到就触发下单交易,历史 bar 上也能触发下单,请谨慎使用。
不同于 passorder,这里不可缺省
smartAlgoType,string,智能算法类型
可选值:
VWAP:VWAP TWAP:TWAP VP:跟量 PINLINE:跟价 DMA:快捷 FLOAT:盘口 SWITCH:换仓 ICEBERG:冰山 MOC:尾盘
limitOverRate,int,量比,数据范围 0-100,如果输入其他无效值,则 limitOverRate 为 0。*注:网格算法无此项。
minAmountPerOrder,int,智能算法最小委托金额,数据范围 0-100000,默认为 0。
targetPriceLevel,智能算法目标价格
可选值:
1:己方盘口 1
2:己方盘口 2
3:己方盘口 3
4:己方盘口 4
5:己方盘口 5
6:最新价
7:对方盘口
*注:
一、输入无效值则 targetPriceLevel 为 1;
二、本项只针对冰山算法,其他算法可缺省。
可选值:
VWAP:VWAP TWAP:TWAP VP:跟量 PINLINE:跟价
DMA: 快捷
FLOAT: 盘口
SWITCH: 换仓
ICEBERG: 冰山
MOC: 尾盘
startTime,智能算法开始时间
def handlebar(ContextInfo):
smart_algo_passorder(23,1101,'600000105','000001.SZ',5,-1,50000,"strageName",0,
"remark","TWAP",20,0,ContextInfo);
#账户600000105最新价开仓买入50000股的000001.SZ平安银行,使用TWAP智能算法,量比20%,最小买卖
金额0
smart_algo_passorder(23,1101,'600000105','000001.SZ',5,-1,50000,"strageName",1
,"remark","TWAP",20,0,0,'09:30:00','14:00:00',ContextInfo);
#账户600000105最新价快速交易开仓买入50000股的000001.SZ平安银行,使用TWAP智能算法,量比20%,
最小买卖金额0且有效时长为09:30-14:00
用法: get_trade_detail_data(accountID, strAccountType, strDatatype, strategyName) 或不区分策略 get_trade_detail_data(accountID, strAccountType, strDatatype)
释义: 获取交易明细数据函数
accountID:string,资金账号。
strAccountType:string,账号类型,可选值:
'FUTURE': 期货
'STOCK': 股票
'CREDIT': 信用
'HUGANGTONG': 沪港通
'SHENGANGTONG': 深港通
'STOCK_OPTION': 期权
strDatatype:string,数据类型:
strategyName:string,策略名,对应 passorder 下单函数中的参数 strategyName 的值,只对委托 'ORDER'、成交 'DEAL' 起作用。
返回: list,list 中放的是 PythonObj,通过 dir(pythonobj) 可返回某个对象的属性列表。
*注:有五种交易相关信息,包括:
POSITION: 持仓
ORDER: 委托
DEAL: 成交
ACCOUNT: 账号
TASK: 任务
def handlebar(ContextInfo):
obj_list = get_trade_detail_data('6000000248','stock','position')
for obj in obj_list:
print(obj.m_strInstrumentID)
# 查看有哪些属性字段
print(dir(obj))
# 可用资金查询
acct_info = get_trade_detail_data('6000000248', 'stock', 'account')
for i in acct_info:
print(i.m_dAvailable)
# 当前持仓查询
position_info = get_trade_detail_data('6000000248', 'stock', 'position')
for i in position_info:
print(i.m_strInstrumentID, i.m_nVolume)
用法: get_value_by_order_id(orderId, accountID, strAccountType, strDatatype)
释义: 根据委托号获取委托或成交信息。
orderId:string,委托号。
accountID:string,资金账号。
strAccountType:string,账号类型,可选值:
'FUTURE': 期货
'STOCK': 股票
'CREDIT': 信用
'HUGANGTONG': 沪港通
'SHENGANGTONG': 深港通
'STCK_OPTION': 期权
strDatatype:string,数据类型:
返回: pythonObj
示例:
def init(ContextInfo):
ContextInfo.accid = '6000000248'
def handlebar(ContextInfo):
orderid = get_last_order_id(ContextInfo.accid, 'stock', 'order')
print(orderid)
obj = get_value_by_order_id(orderid,ContextInfo.accid, 'stock', 'order')
print(obj.m_strInstrumentID)
用法: get_last_order_id(accountID, strAccountType, strDatatype, strategyName) 或不区分策略 get_last_order_id(accountID, strAccountType, strDatatype)
释义: 获取最新的委托或成交的委托号。
参数:
accountID:string,资金账号。
strAccountType:string,账号类型,可选值:
'FUTURE': 期货
'STOCK': 股票
'CREDIT': 信用
'HUGANGTONG': 沪港通
'SHENGANGTONG': 深港通
'STOCK_OPTION': 期权
strDatatype:string,数据类型:
'ORDER': 委托
'DEAL': 成交
strategyName,string,策略名,对应 passorder 下单函数中的参数 strategyName 的值。
返回: String,委托号,如果没找到返回 '-1'。
def init(ContextInfo):
ContextInfo.accid = '6000000248'
def handlebar(ContextInfo):
orderid = get_last_order_id(ContextInfo.accid, 'stock', 'order')
print(orderid)
obj = get_value_by_order_id(orderid,ContextInfo.accid, 'stock', 'order')
print(obj.m_strInstrumentID)
用法: can_cancel_order(orderId, accountID, strAccountType)
释义: 查询委托是否可撤销。
orderId,string,委托号。
accountID:string,资金账号。
strAccountType:string,账号类型,可选值:
'FUTURE': 期货
'STOCK': 股票
'CREDIT': 信用
'HUGANGTONG': 沪港通
'SHENGANGTONG': 深港通
'STOCK_OPTION': 期权
返回: bool,是否可撤,返回值含义:
True: 可撤销
False: 不可撤销
def init(ContextInfo):
ContextInfo.accid = '6000000248'
def handlebar(ContextInfo):
orderid = get_last_order_id(ContextInfo.accid,'stock','order')
print(orderid)
can_cancel = can_cancel_order(orderid,ContextInfo.accid,'stock')
print('是否可撤:', can_cancel)
用法: cancel(orderId, accountId, accountType, ContextInfo)
或 cancel(m_nRef, accountId, accountType, ContextInfo)
释义: 取消委托。
- orderId: string, 委托号。
strAccountType:string,账号类型,可选值:
'FUTURE': 期货
'STOCK': 股票
'CREDIT': 信用
'HUGANGTONG': 沪港通
'SHENGANGTONG': 深港通
'STOCK_OPTION': 期权
返回: bool,是否发出了取消委托信号,返回值含义:
True: 是 False: 否
'''
使用委托号撤单
(1)下单前,根据 get_trade_detail_data 函数返回账号的信息,判定资金是否充足,账号是否在登录状态,统计持仓情况等等。
(2)满足一定的模型条件,用 passorder 下单。
(3)下单后,时刻根据 get_last_order_id 函数获取委托和成交的最新id,注意如果委托生成了,就有了委托号(这个id需要自己保存做一个全局控制)。
(4)用该委托号根据 get_value_by_order_id 函数查看委托的状态,各种情况等。
当一个委托的状态变成“已成'后,那么对应的成交 deal 信息就有一条成交数据;用该委托号可查看成交情况。
*注:委托列表和成交列表中的委托号是一样的,都是这个 m_strOrderSysID 属性值。
可用 get_last_order_id 获取最新的 order 的委托号,然后根据这个委托号获取 deal 的信息,当获取成功后,也说明这笔交易是成了,可再根据 position 持仓信息再进一步验证。
(5)根据委托号获取委托信息,根据委托状态,或模型设定,用 cancel 取消委托。
'''
def init(ContextInfo):
ContextInfo.accid = '6000000248'
def handlebar(ContextInfo):
orderId = get_last_order_id(contextInfo.accid, 'stock', 'order')
print(cancel(orderid, ContextInfo.accid, 'stock', ContextInfo))
'11
使用订单编号撤单
(1)下单前,根据 get_trade_detail_data 函数返回账号的信息,判定资金是否充足,账号是否在登录状态,统计持仓情况等等。
(2) 满足一定的模型条件, 用 passorder 下单。
(3) 使用订单编号撤单, 订单编号在下单后即可生成, 使用get_trade_detail_data获取订单编号。
(4) 根据委托状态, 或模型设定, 用 cancel 取消委托。
'''
def init(ContextInfo):
ContextInfo.account='1000000312'
ContextInfo.set_account(ContextInfo.account)
def handlebar(ContextInfo):
if ContextInfo.is_last_bar():
res = get_trade_detail_data(ContextInfo.account,'STOCK','ORDER')
for order in res:
#取订单编号并撤单
if order.m_nOrderStatus in [48,49,50,55]:
ref = order.m_nRef
cancel(str(ref),ContextInfo.account,'STOCK',ContextInfo)
用法: cancel_task(taskId,accountId,accountType,ContextInfo)
释义: 撤销任务。
taskId,string,任务编号,为空的时候表示撤销所有该资金账号可撤的任务。
accountID:string,资金账号。
strAccountType:string,账号类型,可选值:
'FUTURE': 期货
'STOCK': 股票
'CREDIT': 信用
'HUGANGTONG': 沪港通
'SHENGANGTONG': 深港通
'STOCK_OPTION': 期权
- ContextInfo: pythonobj
返回: bool,是否发出了取消任务信号,返回值含义:
True: 是 False: 否
'''
(1) 根据get_trade_detail_data函数返回任务的信息,获取任务编号(m_nTaskId),任务状态等等;
(2) 根据任务编号,用cancel_task取消委托。
'''
def init(ContextInfo):
ContextInfo.accid = '6000000248'
def handlebar(ContextInfo):
objlist = get_trade_detail_data(ContextInfo.accid,'stock','task')
for obj in obj_list:
cancel_task(obj.m_nTaskId,ContextInfo.accid,'stock',ContextInfo)
用法: pause_task(taskId,accountId,accountType,ContextInfo)
释义: 暂停智能算法任务。
taskId,string,任务编号,为空的时候表示暂停所有该资金账号可暂停的任务。
accountID:string,资金账号。
strAccountType:string,账号类型,可选值:
'FUTURE': 期货
'STOCK': 股票
'CREDIT': 信用
'HUGANGTONG': 沪港通
'SHENGANGTONG': 深港通
'STOCK_OPTION': 期权
- ContextInfo: pythonobj
返回: bool,是否发出了暂停任务信号,返回值含义:
True: 是 False: 否
'''
(1) 根据get_trade_detail_data函数返回任务的信息,获取任务编号(m_nTaskId),任务状态等等;
(2) 根据任务编号,用pause_task暂停智能算法任务。
'''
def init(ContextInfo):
ContextInfo.accid = '6000000248'
def handlebar(ContextInfo):
objlist = get_trade_detail_data(ContextInfo.accid,'stock','task')
for obj in obj_list:
pause_task(obj.m_nTaskId,ContextInfo.accid,'stock',ContextInfo)
用法: cancel_task(taskId,accountId,accountType,ContextInfo)
释义: 继续智能算法任务。
taskId,string,任务编号,,为空的时候表示启动所有该资金账号已暂停的任务。
accountID:string,资金账号。
strAccountType:string,账号类型,可选值:
'FUTURE': 期货
'STOCK': 股票
'CREDIT': 信用
'HUGANGTONG': 沪港通
'SHENGANGTONG': 深港通
'STOCK_OPTION': 期权
- ContextInfo: pythonobj
返回: bool,是否发出了重启信号,返回值含义:
True: 是 False: 否
示例:
'''
(1) 根据get_trade_detail_data函数返回任务的信息,获取任务编号(m_nTaskId),任务状态等等;
(2) 根据任务编号,用resume_task启动已暂停智能算法任务。
'''
def init(ContextInfo):
ContextInfo.accid = '6000000248'
def handlebar(contextInfo):
objlist = get_trade_detail_data(ContextInfo.accid,'stock','task')
for obj in obj_list:
resume_task(obj.m_nTaskId,ContextInfo.accid,'stock',ContextInfo)
用法: do_order(ContextInfo)
释义: 实时触发前一根 bar 信号函数。
系统实盘中交易下单函数一般是把上一个周期产生的信号在最新的周期的第一个 tick 下单出去,而日 K 线第一个 tick 是在 9:25 分集合竞价结束时产生,如果策略模型在 9:25 分之后跑又想把前一天的下单信号发出去,就可用 do_order 函数配合实现。
特别的,需要注意,有调用 do_order 函数的策略模型跑在 9:25 分之前或别的日内周期下时,原有下单函数和 do_order 函数都有下单信号,有可能导致重复下单。、
参数:无
返回:无
# 实现跑日 K 线及以上周期下,在固定时间点把前一周期的交易信号发送出去
def init(ContextInfo):
pass
def handlebar(ContextInfo):
order_lots('000002.sz', 1, ContextInfo, '600000248')
ticktimetag = ContextInfo.get_tick_timetag()
int_time = int(timetag_to_datetime(ticketimag, '%H%M%S'))
if 100500 <= int_time < 100505:
do_order(ContextInfo)
用法: order_lots(stockcode, lots[, style, price], ContextInfo[, accId])
释义: 指定手数交易,指定手数发送买/卖单。如有需要落单类型当做一个参量传入,如果忽略掉落单类型,那么默认以最新价下单。
stockcode:代码,string,如 '000002.SZ'
lots:手数,int
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE5', 'SALE4', 'SALE3', 'SALE2', 'SALE1': 卖5-1价
'BUY1', 'BUY2', 'BUY3', 'BUY4', 'BUY5': 买1-5价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
示例:
def handlebar(ContextInfo):
# 按最新价下 1 手买入
order_lots('000002.sz', 1, ContextInfo, '600000248')
# 用对手价下 1 手卖出
order_lots('000002.sz', -1, 'COMPETE', ContextInfo, '600000248')
# 用指定价 37.5 下 2 手卖出
order_lots('000002.sz', -2, 'fix', 37.5, ContextInfo, '600000248')
用法: order_value(stockcode, value[, style, price], ContextInfo[, accId])
释义: 指定价值交易,使用想要花费的金钱买入 / 卖出股票,而不是买入 / 卖出想要的股数,正数代表买入,负数代表卖出。股票的股数总是会被调整成对应的 100 的倍数(在中国 A 股市场 1 手是 100 股)。当您提交一个卖单时,该方法代表的意义是您希望通过卖出该股票套现的金额,如果金额超出了您所持有股票的价值,那么您将卖出所有股票。需要注意,如果资金不足,该 API 将不会创建发送订单。
stockcode:代码,string,如 '000002.SZ'
value:金额(元),double
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE5', 'SALE4', 'SALE3', 'SALE2', 'SALE1': 卖5-1价
'BUY1', 'BUY2', 'BUY3', 'BUY4', 'BUY5': 买1-5价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
示例:
def handlebar(ContextInfo):
# 按最新价下 10000 元买入
order_value('000002.sz', 10000, ContextInfo, '600000248')
# 用对手价下 10000 元卖出
order_value('000002.sz', -10000, 'COMPETE', ContextInfo, '600000248')
# 用指定价 37.5 下 20000 元卖出
order_value('000002.sz', -20000, 'fix', 37.5, ContextInfo, '600000248')
用法: order_percent(stockcode, percent[, style, price], ContextInfo[, accId])
释义: 指定比例交易,发送一个等于目前投资组合价值(市场价值和目前现金的总和)一定百分比的买/ 卖单,正数代表买,负数代表卖。股票的股数总是会被调整成对应的一手的股票数的倍数(1 手是 100 股)。百分比是一个小数,并且小于或等于 1(小于等于 100%),0.5 表示的是 50%。需要注意,如果资金不足,该 API 将不会创建发送订单。
stockcode:代码,string,如 '000002.SZ'
percent:比例,double
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE5', 'SALE4', 'SALE3', 'SALE2', 'SALE1': 卖5-1价
'BUY1', 'BUY2', 'BUY3', 'BUY4', 'BUY5': 买1-5价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
def handlebar(ContextInfo):
# 按最新价下 5.1% 价值买入
order_percent('000002.sz', 0.051, ContextInfo, '600000248')
# 用对手价下 5.1% 价值卖出
order_percent('000002.sz', -0.051, 'COMPETE', ContextInfo, '600000248')
# 用指定价 37.5 下 10.2% 价值卖出
order_percent('000002.sz', -0.102, 'fix', 37.5, ContextInfo, '600000248')
(15)指定目标价值交易 order_target_value()
用法: order_target_value(stockcode, tar_value[, style, price], ContextInfo[, accId])
释义: 指定目标价值交易,买入 / 卖出并且自动调整该证券的仓位到一个目标价值。如果还没有任何该证券的仓位,那么会买入全部目标价值的证券;如果已经有了该证券的仓位,则会买入 / 卖出调整该证券的现在仓位和目标仓位的价值差值的数目的证券。需要注意,如果资金不足,该 API 将不会创建发送订单。
stockcode:代码,string,如 '000002.SZ'
tar_value:目标金额(元),double,非负数
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE5', 'SALE4', 'SALE3', 'SALE2', 'SALE1': 卖5-1价
'BUY1', 'BUY2', 'BUY3', 'BUY4', 'BUY5': 买1-5价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
def handlebar(ContextInfo):
# 按最新价下调仓到 10000 元持仓
order_target_value('000002.sz', 10000, ContextInfo, '600000248')
# 用对手价调仓到 10000 元持仓
order_target_value('000002.sz', 10000, 'COMPETE', ContextInfo, '600000248')
# 用指定价 37.5 下调仓到 20000 元持仓
order_target_value('000002.sz', 20000, 'fix', 37.5, ContextInfo, '600000248')
用法: order_target_percent(stockcode, tar_percent[, style, price], ContextInfo[, accId])
释义: 指定目标比例交易,买入 / 卖出证券以自动调整该证券的仓位到占有一个指定的投资组合的目标百分比。投资组合价值等于所有已有仓位的价值和剩余现金的总和。买 / 卖单会被下舍入一手股数(A 股是 100 的倍数)的倍数。目标百分比应该是一个小数,并且最大值应该小于等于 1,比如 0.5 表示 50%,需要注意,如果资金不足,该 API 将不会创建发送订单。
stockcode:代码,string,如 '000002.SZ'
tar_percent:目标百分比 [0 ~ 1],double
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE5', 'SALE4', 'SALE3', 'SALE2', 'SALE1': 卖5-1价
'BUY1', 'BUY2', 'BUY3', 'BUY4', 'BUY5': 买1-5价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
def handlebar(ContextInfo):
# 按最新价下买入调仓到 5.1% 持仓
order_target_percent('000002.SZ', 0.051, ContextInfo, '600000248')
# 用对手价调仓到 5.1% 持仓
order_target_percent('000002.SZ', 0.051, 'COMPETE', ContextInfo, '600000248')
# 用指定价 37.5 调仓到 10.2% 持仓
order_target_percent('000002.SZ', 0.102, 'fix', 37.5, ContextInfo, '600000248')
用法: order_shares(stockcode, shares[, style, price], ContextInfo[, accId])
释义: 指定股数交易,指定股数的买 / 卖单,最常见的落单方式之一。如有需要落单类型当做一个参量传入,如果忽略掉落单类型,那么默认以最新价下单。
stockcode:代码,string,如 '000002.SZ'
shares:股数,int
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE5', 'SALE4', 'SALE3', 'SALE2', 'SALE1': 卖5-1价
'BUY1', 'BUY2', 'BUY3', 'BUY4', 'BUY5': 买1-5价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
返回: 无
def handlebar(ContextInfo):
# 按最新价下 100 股买入
order_shares('000002.sz', 100, ContextInfo, '600000248')
# 用对手价下 100 股卖出
order_shares('000002.sz', -100, 'COMPETE', ContextInfo, '600000248')
# 用指定价 37.5 下 200 股卖出
order_shares('000002.sz', -200, 'fix', 37.5, ContextInfo, '600000248')
用法: buy_open(stockcode, amount[, style, price], ContextInfo[, accId])
释义: 期货买入开仓
stockcode:代码,string,如 'IF1805.IF'
amount:手数,int
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE1': 卖一价
'BUY1': 买一价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
示例:
def handlebar(ContextInfo):
# 按最新价 1 手买入开仓
buy_open('IF1805.IF', 1, ContextInfo, '110476')
# 用对手价 1 手买入开仓
buy_open('IF1805.IF', 1, 'COMPETE', ContextInfo, '110476')
# 用指定价 3750 元 2 手买入开仓
buy_open('IF1805.IF', 2, 'fix', 3750, ContextInfo, '110476')
用法: buy_close_tdayfirst(stockcode, amount[, style, price], ContextInfo[, accId])
释义: 期货买入平仓,平今优先
stockcode:代码,string,如 'IF1805.IF'
amount:手数,int
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE1': 卖一价
'BUY1': 买一价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
def handlebar(ContextInfo):
# 按最新价 1 手买入平仓,平今优先
buy_close_tdayfirst('IF1805.IF', 1, ContextInfo, '110476')
# 用对手价 1 手买入平仓,平今优先
buy_close_tdayfirst('IF1805.IF', 1, 'COMPETE', ContextInfo, '110476')
# 用指定价 3750 元 2 手买入平仓,平今优先
buy_close_tdayfirst('IF1805.IF', 2, 'fix', 3750, ContextInfo, '110476')
用法: buy_close_ydayfirst(stockcode, amount[, style, price], ContextInfo[, accId])
释义: 期货买入开仓,平昨优先
stockcode:代码,string,如 'IF1805.IF'
amount:手数,int
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX':指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE1': 卖一价
'BUY1': 买一价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
示例:
def handlebar(ContextInfo):
# 按最新价 1 手买入平仓,平昨优先
buy_close_ydayfirst('IF1805.IF', 1, ContextInfo, '110476')
# 用对手价 1 手买入平仓,平昨优先
buy_close_ydayfirst('IF1805.IF', 1, 'COMPETE', ContextInfo, '110476')
# 用指定价 3750 元 2 手买入平仓,平昨优先
buy_close_ydayfirst('IF1805.IF', 2, 'fix', 3750, ContextInfo, '110476')
用法: sell_open(stockcode, amount[, style, price], ContextInfo[, accId])
stockcode:代码,string,如 'IF1805.IF'
amount:手数,int
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE1': 卖一价
'BUY1': 买一价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
返回: 无
def handlebar(ContextInfo):
# 按最新价 1 手卖出开仓
sell_open('IF1805.IF', 1, ContextInfo, '110476')
# 用对手价 1 手卖出开仓
sell_open('IF1805.IF', 1, 'COMPETE', ContextInfo, '110476')
# 用指定价 3750 元 2 手卖出开仓
sell_open('IF1805.IF', 2, 'fix',3750, ContextInfo, '110476')
用法: sell_close_tdayfirst(stockcode, amount[, style, price], ContextInfo[, accId])
释义: 期货卖出平仓,平今优先
stockcode:代码,string,如 'IF1805.IF'
amount:手数,int
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE1': 卖一价
'BUY1': 买一价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
def handlebar(ContextInfo):
# 按最新价下 1 手卖出平仓,平今优先
sell_close_tdayfirst('IF1805.IF', 1, ContextInfo, '110476')
# 用对手价 1 手卖出平仓,平今优先
sell_close_tdayfirst('IF1805.IF', 1, 'COMPETE', ContextInfo, '110476')
# 用指定价 3750 元 2 手卖出平仓,平今优先
sell_close_tdayfirst('IF1805.IF', 1, 'fix', 3750, ContextInfo, '110476')
用法: sell_close_ydayfirst(stockcode, amount[, style, price], ContextInfo[, accId])
释义: 期货卖出平仓,平今优先
stockcode:代码,string,如 'IF1805.IF'
amount:手数,int
style:下单选价类型,string,默认为最新价 'LATEST',可选值:
'LATEST': 最新
'FIX': 指定
'HANG': 挂单
'COMPETE': 对手
'MARKET': 市价
'SALE1': 卖一价
'BUY1': 买一价
price:价格,double
ContextInfo:PythonObj,Python 对象,这里必须是 ContextInfo
accId:账号,string
示例:
def handlebar(ContextInfo):
# 按最新价 1 手卖出平仓,平昨优先
sell_close_ydayfirst('IF1805.IF', 1, ContextInfo, '110476')
# 用对手价 1 手卖出平仓,平昨优先
sell_close_ydayfirst('IF1805.IF', 1, 'COMPETE', ContextInfo, '110476')
# 用指定价 3750 元 2 手卖出平仓,平昨优先
sell_close_ydayfirst('IF1805.IF', 2, 'fix', 3750, ContextInfo, '110476')
用法: get_debt_contract(accId)
释义: 获取信用账户负债合约明细
参数:
accId:信用账户
返回: list,list 中放的是 PythonObj,通过 dir(pythonobj) 可返回某个对象的属性列表。
def handlebar(ContextInfo):
obj_list = get_debt_contract('6000000248')
for obj in obj_list:
# 输出负债合约名
print(obj.m_strInstrumentName)
用法: get_debt_contract(accId)
释义: 获取信用账户担保合约明细
参数:
accId:信用账户
示例:
def handlebar(ContextInfo):
obj_list = get_assure_contract('6000000248')
for obj in obj_list:
# 输出担保合约名
print(obj.m_strInstrumentName)
用法: get_enable_short_contract(accId)
释义: 获取信用账户当前可融券的明细
参数:
accId:信用账户
def handlebar(ContextInfo):
obj_list = get_enable_short_contract('6000000248')
for obj in obj_list:
# 输出可融券合约名
print(obj.m_strInstrumentName)
**用法:**stoploss_limitprice(mode,accountid,stockcode,stopprice,limitprice,volume,orderderction)
释义: 以限价单方式止损/止盈
参数:
mode:int,止损:0,止盈:1
accountid:string,账号
stockcode:string,需要止损的品种,代码。市场格式 (600000.SH,IF2003.IF)
stopprice:double,止损点
limitprice:double,限价单的指定价
volume:int,止损单的下单量,不填写时候默认平该品种全仓
orderderction:string,买卖方向,期货止损时候必须填写"short"对应平空,"long"对应平多,品种为股票时填写""
def handlebar(ContextInfo):
stoploss_limitprice(0,'10455','IF2003.IF',3000.12,3000.05,1,"short")
用法: stoploss_marketprice(mode,accountid,stockcode,stopprice,volume,orderderction)
释义: 以市价单方式止损/止盈
mode:int,止损:0,止盈:1
accountid:string,账号
stockcode:string,需要止损的品种,代码。市场格式 (600000.SH,IF2003.IF)
stopprice:double,止损点
volume:int,止损单的下单量,不填写时候默认平该品种全仓
orderderction:string,买卖方向,期货止损时候必须填写"short"对应平空,"long"对应平多,品种为股票时填写""
def handlebar(ContextInfo):
stoploss_marketprice(0,'10455','IF2003.IF',3000.12,1,"long")
用法: get_ipo_data([,type])
释义: 获取当日新股新债信息,返回结果为一个字典,包括新股申购代码,申购名称,最大申购数量,最小申购数量等数据
type:为空时返回新股新债信息,type="STOCK"时只返回新股申购信息,type="BOND"时只返回新债申购信息
def init(ContextInfo):
ipoData=get_ipo_data()#返回新股新债信息
ipoStock=get_ipo_data("STOCK")#返回新股信息
ipoCB=get_ipo_data("BOND")#返回新债申购信息
用法: get_new_purchase_limit(accid)
释义: 获取账户新股申购额度,返回结果为一个字典,包括上海主板,深圳市场,上海科创版的申购额度
accid:资金账号,必须时股票账号或者信用账号
def init(ContextInfo):
ContextInfo.accid="10000001"#返回新股新债信息
purchase_limit=get_new_purchase_limit(ContextInfo.accid)
*注:在使用成交回报实时主推函数时,需要在 init 函数中使用 set_account() 用于绑定资金账号返回回调信息。
成交回报实时主推函数仅在实盘运行模式下生效。
用法: account_callback(ContextInfo, accountInfo)
释义: 当资金账号状态有变化时,运行这个函数
ContextInfo:特定对象
accountInfo:资金账号对象,可对应查看5.4. 附录 4 交易函数内含属性说明
def init(ContextInfo):
# 设置对应的资金账号
ContextInfo.set_account('6000000058')
def handlebar(ContextInfo):
pass
def account_callback(ContextInfo, accountInfo):
print('accountInfo')
print(accountInfo.m_strStatus) # m_strStatus 为资金账号的属性之一,表示资金账号的状态
用法: order_callback(ContextInfo, orderInfo)
释义: 当账号委托状态有变化时,运行这个函数
ContextInfo:特定对象
orderInfo:委托账号对象,可对应查看5.4. 附录 4 交易函数内含属性说明
返回: 无
def init(ContextInfo):
# 设置对应的资金账号
ContextInfo.set_account('6000000058')
def handlebar(ContextInfo):
pass
def order_callback(ContextInfo, orderInfo):
print('orderInfo')
用法: deal_callback(ContextInfo, dealInfo)
释义: 当账号成交状态有变化时,运行这个函数
ContextInfo:特定对象
dealInfo:资金账号对象,可对应查看5.4. 附录 4 交易函数内含属性说明
示例:
def init(ContextInfo):
# 设置对应的资金账号
ContextInfo.set_account('6000000058')
def handlebar(ContextInfo):
pass
def deal_callback(ContextInfo, dealInfo):
print('dealInfo')
用法: position_callback(ContextInfo, positonInfo)
释义: 当账号持仓状态有变化时,运行这个函数
参数:
ContextInfo:特定对象
positonInfo:资金账号对象,可对应查看5.4. 附录 4 交易函数内含属性说明
返回: 无
def init(ContextInfo):
# 设置对应的资金账号
ContextInfo.set_account('6000000058')
def handlebar(ContextInfo):
pass
def position_callback(ContextInfo, positonInfo):
print('positonInfo')
用法: orderError_callback(ContextInfo,orderArgs,errMsg)
释义: 当账号下单异常时,运行这个函数
ContextInfo:特定对象
orderArgs:下单参数,可对应查看 [5.4. 附录 4 交易函数内含属性说明]
errMsg:错误信息
返回: 无
示例:
def init(ContextInfo):
# 设置对应的资金账号
ContextInfo.set_account('6000000058')
def handlebar(ContextInfo):
pass
def position_callback(ContextInfo, orderArgs,errMsg):
print('orderArgs')
print(errMsg)
*注:以下函数均支持回测和实盘/模拟运行模式。
用法: ext_data(extdataname, stockcode, deviation, ContextInfo)
释义: 获取扩展数据
extdataname:string,扩展数据名
stockcode:string,形式如 'stkcodemarket',如 '600000.SH'
deviation:number,K 线偏移,可取值:
0: 不偏移
N: 向右偏移N
-N: 向左偏移N
ContextInfo:pythonObj,Python 对象,这里必须是 ContextInfo
返回: number
示例:
def handlebar(ContextInfo):
print(ext_data('mycci', '600000.SH', 0, ContextInfo))
(2)获取引用的扩展数据的数值在所有品种中的排名 ext_data_rank()
用法: ext_data_rank(extdataname, stockcode, deviation, ContextInfo)
释义: 获取引用的扩展数据的数值在所有品种中的排名
参数:
extdataname:string,扩展数据名
stockcode:string,形式如 'stkcodemarket',如 '600000.SH'
deviation:number,K 线偏移,可取值:
0:不偏移
N:向右偏移 N
-N:向左偏移 N
ContextInfo:pythonObj,Python 对象,这里必须是 ContextInfo
返回: number
示例:
def handlebar(ContextInfo):
print(ext_data_rank('mycci', '600000.SH', 0, ContextInfo))
(3)获取引用的扩展数据的数值在指定时间区间内所有品种中的排名 ext_data_rank_range()
用法: ext_data_rank_range(extdataname, stockcode, begintime, endtime, ContextInfo)
释义: 获取引用的扩展数据的数值在指定时间区间内所有品种中的排名
参数:
extdataname:string,扩展数据名
stockcode:string,形式如 'stkcodemarket',如 '600000.SH'
begintime:string,区间的起始时间(包括该时间点在内)格式为 '2016-08-02 12:12:30'
endtime:string,区间的结束时间(包括该时间点在内)格式为 '2017-08-02 12:12:30
ContextInfo:pythonObj,Python 对象,这里必须是 ContextInfo
返回: pythonDict
def handlebar(ContextInfo):
print(ext_data_rank_range('mycci', '600000.SH', '2016-08-02 12:12:30',
'2017-08-02 12:12:30', ContextInfo))
用法: ext_data_range(extdataname, stockcode, begintime, endtime, ContextInfo)
释义: 获取扩展数据在指定时间区间内的值
extdataname:string,扩展数据名
stockcode:string,形式如 'stkcodemarket',如 '600000.SH'
begintime:string,区间的起始时间(包括该时间点在内)格式为 '2016-08-02 12:12:30'
endtime:string,区间的结束时间(包括该时间点在内)格式为 '2017-08-02 12:12:30'
ContextInfo:pythonObj,Python 对象,这里必须是 ContextInfo
返回: pythonDict
def handlebar(ContextInfo):
print(ext_data_range('mycci', '600000.SH', '2016-08-02 12:12:30', '2017-08-02 12:12:30', ContextInfo))
ContextInfo.get_ext_all_data()
用法: ContextInfo.get_ext_all_data(extdataname,start_time='19720101',end_time='22010101')
释义: 引用扩展数据在指定时间区域内的所有值和排名
*注:本函数最好在 init 中调用,一次性将要用的数据取出
extdataname:string,扩展数据名
start_time:起始时间,可缺省,缺省值 1972 年 1 月 1 日
end_time:截止时间,可缺省,缺省值 2201 年 1 月 1 日
Items:时间戳
Major_axis:股票代码
Minor_axis:扩展数据的域名 (rank 和 value)
def init(ContextInfo):
print(ContextInfo.get_ext_all_data('mycci'))
用法: get_factor_value(factorname, stockcode, deviation, ContextInfo)
释义: 获取因子数据
factorname:string,因子名
stockcode:string,形式如 'stkcodemarket',如 '600000.SH'
deviation:number,K 线偏移,0 不偏移,N 向右偏移 N,-N 向左偏移 N
ContextInfo:pythonObj,Python 对象,这里必须是 ContextInfo
返回: number
def handlebar(ContextInfo):
print(get_factor_value('zzz', '600000.SH', 0, ContextInfo))
用法: get_factor_rank(factorname, stockcode, deviation, ContextInfo)
释义: 获取引用的因子数据的数值在所有品种中排名
factorname:string,因子名
stockcode:string,形式如 'stkcodemarket',如 '600000.SH'
deviation:number,K 线偏移,0 不偏移,N 向右偏移 N,-N 向左偏移 N
ContextInfo:pythonObj,Python 对象,这里必须是 ContextInfo
返回: number
def handlebar(ContextInfo):
print(get_factor_rank('zzz', '600000.SH', 0, ContextInfo))
用法: call_vba(factorname, stockcode, [period, dividend_type, barpos, ]ContextInfo)
释义: 获取引用的 VBA 模型运行的结果
*注:使用该函数时需补充好本地 K 线或分笔数据
factorname:string,模型名及引用变量,如 'MA.ma1'
stockcode:string,形式如 'stkcodemarket',如 '600000.SH '
period:string,K 线周期类型,可缺省,默认为当前主图周期线型,可选值:
'tick': 分笔线
'1d': 日线
'1m': 1分钟线
'3m': 3分钟线
'5m': 5分钟线
'15m': 15分钟线
'30m': 30分钟线
'1h': 小时线
'1w': 周线
'1mon': 月线
'1q': 季线
'1hy': 半年线
'1y': 年线
dividend_type:string,除复权,可缺省,默认当前图复权方式,可选值:
'none': 不复权
'front': 向前复权
'back': 向后复权
'front_ratio': 等比向前复权
'back_ratio': 等比向后复权
barpos:number,对应 bar 下标,可缺省,默认当前主图调用到的 bar 的对应下标
ContextInfo:pythonObj,Python 对象,这里必须是 ContextInfo
示例:
def handlebar(ContextInfo):
call_vba('MA.ma1', '600036.SH', ContextInfo)
call_formula(formulaName,code,period,divideType,basket,argsDict,startime="",endTime="",count =-1)
释义: python 调用组合模型,返回 GruopModelInfo 结构体
*注:使用该函数时需补充好本地 K 线或分笔数据
formulaName:string,组合模型名
stockcode:string,组合模型主图代码形式如'stkcode.market',如'000300.SH'
period:string,K 线周期类型,可缺省,默认为当前主图周期线型,可选值:
'tick':分笔线
'1d': 日线
'1m': 1分钟线
'3m': 3分钟线
'5m': 5分钟线
'15m': 15分钟线
'30m': 30分钟线
'1h': 小时线
'1w': 周线
'1mon': 月线
'1q': 季线
'1hy': 半年线
'1y': 年线
dividend_type:string,除复权,可缺省,默认当前图复权方式,可选值:
'none': 不复权
'front': 向前复权
'back': 向后复权
'front_ratio': 等比向前复权
'back_ratio': 等比向后复权
basket:dict,组合模型的股票池权重,形如{'SH600000':0.06,'SZ000001':0.01}
argsDict:dict,组合模型的入参,{参数名:参数值},形如{'a':1}
startTime:string,缺失参数,组合模型运行起始时间,形如:'20200101
endTime:string,缺失参数,组合模型运截止时间,形如:'20200101'
count:int,缺省参数,组合模型运行范围为向前 count 根 bar
返回: GruopModelInfo 结构体。GruopModelInfo.result 为当前模型的运行结果,运行 GruopModelInfo.unsubscribe() 会取消组合模型的运行,GruopModelInfo 随着 python 的析构也会调用取消组合模型运行。
def handlebar(ContextInfo):
basket={'SH600000':0.06,'sz000001':0.01}
argsDict={'a':100}
groupModelInfo=call_formula('testGroupModel','000300.SH',basket,argsDict);
print(groupModelInfo.result);
groupModelInfo.unsubscribe();#取消组合模型运行
*注:以下函数均支持回测和实盘/模拟运行模式。
用法: ContextInfo.paint(name, value, index, line_style, color = 'white', limit = '')
释义: 在界面上画图
name:string,需显示的指标名
value:number,需显示的数值
index:number,显示索引位置,填 -1 表示按主图索引显示
- line_style: number, 线型, 可取值:
0: 曲线
42: 柱状线
color:string,颜色(不填默认为白色)目前支持以下几种颜色:
blue: 蓝
brown: 棕
cyan: 蓝绿
green: 绿
magenta: 品红
red: 红
white: 白
yellow: 黄
limit:string,画线控制,可取值:
'noaxis': 不影响坐标画线
'nodraw': 不画线
返回:无
def handlebar(ContextInfo):
realtimetag = ContextInfo.get_bar_timetag(ContextInfo.barpos)
value = ContextInfo.get_close_price('', '', realtimetag)
ContextInfo.paint('close', value, -1, 0, 'white','noaxis')
用法: ContextInfo.draw_text(condition, position, text)
释义: 在图形上显示数字
参数:
condition:条件
Position:位置
text:文字
返回: 无
示例:
def handlebar(ContextInfo):
ContextInfo.draw_text(1, 10, '文字')
用法: ContextInfo.draw_number(cond, height, number, precision)
释义: 在图形上显示数字
cond:bool,条件
height:number,显示文字的高度位置
text:string,显示的数字
precision:为小数显示位数(取值范围 0 - 7)
返回: 无
示例:
def handlebar(ContextInfo):
close = ContextInfo.get_market_data(['close'])
ContextInfo.draw_number(1 > 0, close, 66, 1)
用法: ContextInfo.draw_vertline(cond, number1, number2, color = '', limit = '')
释义: 在数字 1 和数字 2 之间绘垂直线
参数:
cond:bool,条件
number1:number,数字 1
number2:number,数字 2
color:string,颜色(不填默认为白色)目前支持以下几种颜色:
blue: 蓝
brown: 棕
cyan: 蓝绿
green: 绿
magenta: 品红
red: 红
white: 白
yellow: 黄
limit:string,画线控制,可取值:
'noaxis': 不影响坐标画线
'nodraw': 不画线
返回: 无
示例:
def handlebar(ContextInfo):
close = ContextInfo.get_market_data(['close'])
open = ContextInfo.get_market_data(['open'])
ContextInfo.draw_vertline(1 > 0, close, open, 'cyan')
用法: ContextInfo.draw_icon(cond, height, type)
释义: 在图形上绘制小图标
cond:bool,条件
height:number,图标的位置
text:number,图标的类型,可取值:
1:椭圆 0:矩形
返回: 无
示例:
def handlebar(ContextInfo):
close = ContextInfo.get_market_data(['close'])
ContextInfo.draw_icon(1 > 0, close, 0)
财务数据接口通过读取下载本地的数据取数,使用前需要补充本地数据。除公告日期和报表截止日期为时间戳毫秒格式其他单位为元或 %,数据主要包括资产负债表 (ASHAREBALANCESHEET)、利润表 (ASHAREINCOME)、现金流量表(ASHARECASHFLOW)、股本表(CAPITALSTRUCTURE)的主要字段数据以及经过计算的主要财务指标数据(PERSHAREINDEX)。建议使用本文档对照表中的英文表名和国泰君安英文字段。
ContextInfo.get_financial_data(fieldList, stockList, startDate, enDate, report_type = 'announce_time')
| 字段名类型 | 释义与用例 |
|---|---|
| List(必 | 财报字段列表:['ASHAREBALANCESHEET.fix_assets', '利润 |
| fieldList | |
| 须) | 表。净利润'] |
| List(必 | |
| stockList | 股票列表:['600000.SH', '000001.SZ'] |
| 须) | |
| Str(必 | |
| startDate | 开始时间:'20171209' |
| 须) | |
| Str(必 | |
| endDate | 结束时间:'20171212' |
| 须) | |
| Str(可 | 报表时间类型,可缺省,默认是按照数据的公告期为区分取数据,设置 |
| report_type | 为'report_time'为按照报告期取数据,' announce_time'为 |
| 选) | 按照公告日期取数据 |
函数根据 stockList 代码列表,startDate,endDate 时间范围,返回不同的的数据类型。如下:
(1)代码列表 1 时间范围为 1,返回:pandas.Series index = 字段
(2)代码列表 1 时间范围为 n,返回:pandas.DataFrame index = 时间,columns = 字段
(3)代码列表 n 时间范围为 1,返回:pandas.DataFrame index = 代码,columns = 字段
(4)代码列表 n 时间范围为 n,返回:pandas.Panel items = 代码,major_axis = 时间,minor_axis = 字段
def handlebar(ContextInfo):
#取总股本和净利润
fieldList = ['CAPITALSTRUCTURE.total_capital', '利润表.净利润']
stockList = ['600000.SH','000001.SZ']
startDate = '20171209'
endDate = '20171212'
ContextInfo.get_financial_data(fieldList, stockList, startDate, endDate, report_type = 'report_time')
选择按照公告期取数和按照报告期取数的区别:
若某公司当年 4 月 26 日发布上年度年报,如果选择按照公告期取数,则当年 4 月 26 日之后至下个财报发布日期之间的数据都是上年度年报的财务数据。
若选择按照报告期取数,则上年度第 4 季度(上年度 10 月 1 日 - 12 月 31 日)的数据就是上年度报告期的数据。
ContextInfo.get_financial_data(tabname, colname, market, code, report_type = 'report_time', barpos)(与用法 1 可同时使用)
| 字段名 | 类型 | 释义与用例 |
|---|---|---|
| tabname | Str(必须) | 表名:'ASHAREBALANCESHEET' |
| colname | Str(必须) | 字段名:'fix_assets' |
| market | Str(必须) | 市场:'SH' |
| code | Str(必须) | 代码:'600000' |
| report_type | Str(可选) | 报表时间类型,可缺省,默认是按照数据的公告期为区分取数据,设置为 'report_time' 为按照报告期取数据,' announce_time' 为按照公告日期取数据 |
| barpos | number | 当前 bar 的索引 |
返回:
number
示例:
def handlebar(ContextInfo):
index = ContextInfo.barpos
ContextInfo.get_financial_data('ASHAREBALANCESHEET', 'fix_assets', 'SH',
'600000', index);
根据公告期获取报表原始数据:
getfindata('表格名称', '字段名称')
示例:
固定资产:
getfindata('ASHAREBALANCESHEET', 'fix_assets')
获取每年固定某个季度的数据,该年所有数据都是该季度的数据:
getfindata('表格名称', '字段名称', session)
示例:
固定资产:
//获取每年三季报
getfindata('ASHAREBALANCESHEET', 'fix_assets', 3)
4.3.1. 资产负债表 (ASHAREBALANCESHEET)
| 中文字段 | 国泰君安字段 |
|---|---|
| 应收利息 | int_rcv |
| 可供出售金融资产 | fin_assets_avail_for_sale |
| 持有至到期投资 | held_to_mty_invest |
| 长期股权投资 | long_term_eqy_invest |
| 固定资产 | fix_assets |
| 无形资产 | intang_assets |
| 递延所得税资产 | deferred_tax_assets |
| 资产总计 | tot_assets |
| 交易性金融负债 | tradable_fin_liab |
| 应付职工薪酬 | empl_ben_payable |
| 应交税费 | taxes_surcharges_payable |
| 应付利息 | int_payable |
| 应付债券 | bonds_payable |
| 递延所得税负债 | deferred_tax_liab |
| 负债合计 | tot_liab |
| 实收资本 (或股本) | cap_stk |
| 资本公积金 | cap_rsrv |
| 盈余公积金 | surplus_rsrv |
| 未分配利润 | undistributed_profit |
| 归属于母公司股东权益合计 | tot_shrhldr_eqy_excl_min_int |
| 少数股东权益 | minority_int |
| 负债和股东权益总计 | tot_liab_shrhldr_eqy |
| 所有者权益合计 | total_equity |
| 货币资金 | cash_equivalents |
| 应收票据 | bill_receivable |
| 应收账款 | account_receivable |
| 预付账款 | advance_payment |
| 其他应收款 | other_receivable |
| 其他流动资产 | other_current_assets |
| 流动资产合计 | total_current_assets |
| 存货 | inventories |
| 在建工程 | constru_in_process |
| 工程物资 | construction_materials |
| 长期待摊费用 | long_deferred_expense |
| 非流动资产合计 | total_non_current_assets |
| 短期借款 | shortterm_loan |
| 应付股利 | dividend_payable |
| 其他应付款 | other_payable |
| 一年内到期的非流动负债 | non_current_liability_in_one_year |
| 其他流动负债 | other_current_liability |
| 长期应付款 | longterm_account_payable |
| 应付账款 | accounts_payable |
| 预收账款 | advance_peceipts |
| 流动负债合计 | total_current_liability |
| 应付票据 | notes_payable |
| 长期借款 | long_term_loans |
| 专项应付款 | grants_received |
| 其他非流动负债 | other_non_current_liabilities |
| 非流动负债合计 | non_current_liabilities |
| 专项储备 | specific_reserves |
| 商誉 | goodwill |
| 报告截止日 | m_timetag |
| 公告日 | m_anntime |
| 中文字段 | 国泰君安字段 |
|---|---|
| 投资收益 | plus_net_invest_inc |
| 联营企业和合营企业的投资收益 | incl_inc_invest_assoc_jv_entp |
| 营业税金及附加 | less_taxes_surcharges_ops |
| 营业总收入 | revenue |
| 营业总成本 | total_operating_cost |
| 营业收入 | revenue_inc |
| 营业成本 | total_expense |
| 资产减值损失 | less_impai r_loss_assets |
| 营业利润 | oper_profit |
| 营业外收入 | plus_non_oper_rev |
| 营业外支出 | less_non_oper_exp |
| 利润总额 | tot_profit |
| 所得税 | inc_tax |
| 净利润 | net_profit_incl_min_int_inc |
| 归属净利润 | net_profit_excl_min_int_inc |
| 管理费用 | less_gerl_admin_exp |
| 销售费用 | sale_expense |
| 财务费用 | financial_expense |
| 综合收益总额 | total_income |
| 归属于少数股东的综合收益总额 | total_income_minority |
| 公允价值变动收益 | change_income_fai r_value |
| 已赚保费 | earned_premium |
| 报告截止日 | m_timetag |
| 公告日 | m_anntime |
| 中文字段 | 国泰君安字段 |
|---|---|
| 收到其他与经营活动有关的现金 | other_cash_recp_ral_oper_act |
| 经营活动现金流入小计 | stot_cash_inflows_oper_act |
| 支付给职工以及为职工支付的现金 | cash_pay_beh_empl |
| 支付的各项税费 | pay_all_typ_tax |
| 支付其他与经营活动有关的现金 | other_cash_pay_ral_oper_act |
| 经营活动现金流出小计 | stot_cash_outflows_oper_act |
| 经营活动产生的现金流量净额 | net_cash_flows_oper_act |
| 取得投资收益所收到的现金 | cash_recp_return_invest |
| 处置固定资产、无形资产和其他长期投资收到 | net_cash_recp_disp_fiolta |
| 的现金 | |
| 投资活动现金流入小计 | stot_cash_inflows_inv_act |
| 投资支付的现金 | cash_paid_invest |
| 购建固定资产、无形资产和其他长期投资支付 | cash_pay_acq_const_fiolta |
| 的现金 | |
| 支付其他与投资的现金 | other_cash_pay_ral_inv_act |
| 投资活动产生的现金流出小计 | stot_cash_outflows_inv_act |
| 投资活动产生的现金流量净额 | net_cash_flows_inv_act |
| 吸收投资收到的现金 | cash_recp_cap_contrib |
| 取得借款收到的现金 | cash_recp_borrow |
| 收到其他与筹资活动有关的现金 | other_cash_recp_ral_fnc_act |
| 筹资活动现金流入小计 | stot_cash_inflows_fnc_act |
| 偿还债务支付现金 | cash_prepay_amt_borr |
| 分配股利、利润或偿付利息支付的现金 | cash_pay_dist_dpcp_int_exp |
| 支付其他与筹资的现金 | other_cash_pay_ral_fnc_act |
| 筹资活动现金流出小计 | stot_cash_outflows_fnc_act |
| 筹资活动产生的现金流量净额 | net_cash_flows_fnc_act |
| 汇率变动对现金的影响 | eff_fx_flu_cash |
| 现金及现金等价物净增加额 | net_incr_cash_cash_equ |
| 销售商品、提供劳务收到的现金 | goods_sale_and_service_render_cash |
| 收到的税费与返还 | tax_levy_refund |
| 购买商品、接受劳务支付的现金 | goods_and_services_cash_paid |
| 处置子公司及其他收到的现金 | net_cash_deal_subcompany |
| 其中子公司吸收现金 | cash_from_mino_s_invest_sub |
| 处置固定资产、无形资产和其他长期资产支付 | fix_intan_other_asset_dispo_cash_payment |
| 的现金净额 | |
| 报告截止日 | m_timetag |
| 公告日 | m_anntime |
| 中文字段 | 国泰君安字段 |
|---|---|
| 总股本 | total_capital |
| 已上市流通 A 股 | ci rculating_capital |
| 限售流通股份 | restrict_ci rculating_capital |
| 报告截止日 | m_timetag |
| 公告日 | m_anntime |
| 中文字段 | 国泰君安字段 |
|---|---|
| 每股经营活动现金流量 | s_fa_ocfps |
| 每股净资产 | s_fa_bps |
| 基本每股收益 | s_fa_eps_basic |
| 稀释每股收益 | s_fa_eps_diluted |
| 每股未分配利润 | s_fa_undistributedps |
| 每股资本公积金 | s_fa_surpluscapitalps |
| 扣非每股收益 | adjusted_earnings_per_share |
| 主营收入 | inc_revenue |
| 毛利润 | inc_gross_profit |
| 利润总额 | inc_profit_before_tax |
| 净利润 | du_profit |
| 归属于母公司所有者的净利润 | inc_net_profit |
| 扣非净利润 | adjusted_net_profit |
| 净资产收益率 | du_return_on_equity |
| 销售毛利率 | sales_gross_profit |
| 主营收入同比增长 | inc_revenue_rate |
| 净利润同比增长 | du_profit_rate |
| 归属于母公司所有者的净利润同比增长 | inc_net_profit_rate |
| 扣非净利润同比增长 | adjusted_net_profit_rate |
| 营业总收入滚动环比增长 | inc_total_revenue_annual |
| 归属净利润滚动环比增长 | inc_net_profit_to_shareholders_annual |
| 扣非净利润滚动环比增长 | adjusted_profit_to_profit_annual |
| 加权净资产收益率 | equity_roe |
| 摊薄净资产收益率 | net_roe |
| 摊薄总资产收益率 | total_roe |
| 毛利率 | gross_profit |
| 净利率 | net_profit |
| 实际税率 | actual_tax_rate |
| 预收款营业收入 | pre_pay_operate_income |
| 销售现金流营业收入 | sales_cash_flow |
| 资产负债比率 | gear_ratio |
| 存货周转率 | inventory_turnover |
| 市场 | 代码 |
|---|---|
| 上证所 | SH |
| 深交所 | SZ |
| 大商所 | DF |
| 郑商所 | ZF |
| 上期所 | SF |
| 中金所 | IF |
| 沪港通 | HGT |
| 深港通 | SGT |
| 外部自定义市场 | ED |
| 证监会行业 |
|---|
| CSRC 保险业 |
| CSRC 采矿业 |
| CSRC 餐饮业 |
| CSRC 仓储业 |
| CSRC 电力、热力、燃气及水生产和供应业 |
| CSRC 电力、热力生产和供应业 |
| CSRC 电信、广播电视和卫星传输服务 |
| CSRC 房地产业 |
| CSRC 房屋建筑业 |
| CSRC 纺织服装、服饰业 |
| CSRC 纺织业 |
| CSRC 非金属矿采选业 |
| CSRC 非金属矿物制品业 |
| CSRC 废弃资源综合利用业 |
| CSRC 公共设施管理业 |
| CSRC 广播、电视、电影和影视录音制作业 |
| CSRC 航空运输业 |
| CSRC 黑色金属矿采选业 |
| CSRC 互联网和相关服务 |
| CSRC 化学纤维制造业 |
| CSRC 货币金融服务 |
| CSRC 计算机、通信和其他电子设备制造业 |
| CSRC 家具制造业 |
| CSRC 建筑安装业 |
| CSRC 建筑业 |
| CSRC 建筑装饰和其他建筑业 |
| CSRC 交通运输、仓储和邮政业 |
| CSRC 教育 |
| CSRC 金融业 |
| CSRC 金属制品业 |
| CSRC 酒、饮料和精制茶制造业 |
| CSRC 开采辅助活动 |
| CSRC 科学研究和技术服务业 |
| CSRC 林业 |
| CSRC 零售业 |
| CSRC 煤炭开采和洗选业 |
| CSRC 农、林、牧、渔服务业 |
| CSRC 农、林、牧、渔业 |
| CSRC 农副食品加工业 |
| CSRC 农业 |
| CSRC 批发和零售业 |
| CSRC 批发业 |
| CSRC 皮革、毛皮、羽毛及其制品和制鞋业 |
| CSRC 其他金融业 |
| CSRC 其他制造业 |
| CSRC 汽车制造业 |
| CSRC 燃气生产和供应业 |
| CSRC 软件和信息技术服务业 |
| CSRC 商务服务业 |
| CSRC 生态保护和环境治理业 |
| CSRC 石油和天然气开采业 |
| CSRC 食品制造业 |
| CSRC 水的生产和供应业 |
| CSRC 水利、环境和公共设施管理业 |
| CSRC 水上运输业 |
| CSRC 体育 |
| CSRC 铁路、船舶、航空航天和其他运输设备制造业 |
| CSRC 铁路运输业 |
| CSRC 通用设备制造业 |
| CSRC 土木工程建筑业 |
| CSRC 卫生 |
| CSRC 卫生和社会工作 |
| CSRC 文化、体育和娱乐业 |
| CSRC 文化艺术业 |
| CSRC 文教、工美、体育和娱乐用品制造业 |
| CSRC 橡胶和塑料制品业 |
| CSRC 新闻和出版业 |
| CSRC 信息传输、软件和信息技术服务业 |
| CSRC 畜牧业 |
| CSRC 研究和试验发展 |
| CSRC 医药制造业 |
| CSRC 仪器仪表制造业 |
| CSRC 印刷和记录媒介复制业 |
| CSRC 邮政业 |
| CSRC 有色金属矿采选业 |
| CSRC 渔业 |
| CSRC 制造业 |
| CSRC 住宿和餐饮业 |
| CSRC 住宿业 |
| CSRC 专业技术服务业 |
| CSRC 专用设备制造业 |
| CSRC 资本市场服务 |
| CSRC 综合 |
| CSRC 租赁和商务服务业 |
| CSRC 租赁业 |
注:*代表任意阿拉伯数字
| 类型描述 | 市场代码 | 类别标号 |
|---|---|---|
| 沪市 | ******,SH | 1 |
| 深市 | ******,SZ | 2 |
| 中金 | \|\|\|,IF | 3 |
| 上期 | \|\|\|,SF | 4 |
| 大商 | \|\|\|,DF | 5 |
| 郑商 | \|\|\|,ZF | 6 |
| 开放基金 | ******,OF | 7 |
| 股票期权 | ******,SHO | 8 |
| 新三板 | ******,NEEQ | 9 |
| 沪市 A 股 | 60****,SH | 101 |
| 沪市 B 股 | 90****,SH | 102 |
| 沪市封基 | 50****,SH | 103 |
| 沪市指数 | 000***,SH | 104 |
| 沪市 ETF | 510***\|511***\|512***\|513***\|518***,SH | 105 |
| 沪市权证 | 58****,SH | 106 |
| 沪市申购 | 73****\|78****,SH | 107 |
| 沪市可交换公司债券 | 132***,SH | 108 |
| 沪市可交换公司债券质押券出入 | 133***,SH | 109 |
| 库 | ||
| 沪市可交换公司债券换股 | 192***,SH | 110 |
| 沪市并购重组私募债券挂牌转让 | 1355**\|1356**\|1357**\|1358**\|1359**,SH | 111 |
| 沪市证券公司短期债券挂牌转让 | 1350**\|1351**\|1352**\|1353**\|1354**,SH | 112 |
| 沪市信贷资产支持证券交易 | 128***,SH | 113 |
| asset-backed securities | ||
| 沪市公司债券质押券入库 | 102***\|134***,SH | 114 |
| 沪市公司债 | 122***\|123***\|124***\|127***\|136***,SH | 115 |
| 沪市公开发行优先股交易 | 330***,SH | 116 |
| 沪市非公开发行优先股转让 | 360***,SH | 117 |
| 沪市公开发行优先股申购 | 770***,SH | 118 |
| 沪市公开发行优先股配股/配售 | 771***,SH | 119 |
| 沪市公开发行优先股申购款分配 | 772***,SH | 120 |
| 沪市公开发行优先股申购配号 | 773***,SH | 121 |
| 沪市国债回购(席位托管方式) | 201***,SH | 122 |
| 沪市企业债回购 | 202***,SH | 123 |
| 沪市国债买断式回购 | 203***,SH | 124 |
| 沪市新质押式国债回购 | 204***,SH | 125 |
| 沪市附息国债 | 010***\|019***,SH | 127 |
| 沪市金融债 | 018***,SH | 128 |
| 沪市贴现国债 | 020***,SH | 129 |
| 沪市中央政府债(国债) | 010***\|019***\|020***,SH | 130 |
| 沪市分离债 | 126***,SH | 131 |
| 沪市资产证券化 | 121***,SH | 132 |
| 沪市信贷资产支持 | 128***,SH | 133 |
| 沪市企业债(席位托管方式) | 120***\|129***,SH | 134 |
| 沪市可转债 | 100***\|110***\|112***\|113***\|128***,SH | 135 |
| 沪市地方债 | 130***\|140***,SH | 136 |
| 沪市政府债(国债 + 地方债) | 010***\|019***\|020***\|130***,SH | 137 |
| 上海可交换私募债 | 1380**,SH | 138 |
| 沪市标准券 | 888880\|SHRQ88,SH | 139 |
| 沪市封闭式基金 | 500***\|5058**,SH | 140 |
| 沪市政策性金融债 | 018***\|028***\|038***,SH | 141 |
| 沪市上海质押代码 | 09****\|102***\|103***\|104***\|105***\|106***\|107***\|108***\|133***,SH | 142 |
| 2000 年前发行国债 | 009***,SH | 143 |
| 记账式贴现国债质押式回购标准 | 107***,SH | 144 |
| 券入库 | ||
| 公司债质押式回购标准券入库 | 1040**\|1041**\|1042**\|1043**\|1044**,SH | 145 |
| 国债分销 | 7510**\|7511**,SH | 146 |
| 地方政府债质押式回购标准券入 | 106***\|141***,SH | 147 |
| 库 | ||
| 地方政府债分销 | 75190*\|75191*\|75192*\|75193*\|75194*\|75195*\|75196*,SH | 148 |
| 分离债质押式回购标准券入库 | 1050**\|1051**\|1052**\|1053**\|1054**\|1055**\|1056**\|1057*\|1058**,SH | 149 |
| 债券质押式报价回购 | 205***,SH | 150 |
| 中小企业私募债券在固定收益平 | 125***,SH | 151 |
| 台转让 | ||
| 跨境 ETF | 513030\|513500\|513100\|510900\|513600\|513660,SH | 152 |
| 跨境 LOF | ,SH | 153 |
| 上海创新型封闭式基金 | 5058**,SH | 154 |
| 上海的固定收益类 | 511***,SH | 155 |
| 上海黄金 | 518**0,SH | 156 |
| 上海实时申赎货币基金 | 5198**\|5195**\|5199**,SH | 157 |
| 上海交易型货币基金 | 5116**\|5117**\|5118**\|5119**,SH | 158 |
| 上海股票申购代码 | 730***\|732***\|780***,SH | 159 |
| 上海债券申购代码 | 733***\|783***,SH | 160 |
| 上海基金申购代码 | 735***,SH | 161 |
| 上海新股配号 | 741***\|791***\|736***,SH | 162 |
| 上海配售首发配号 | 747***\|797***,SH | 163 |
| 上海可转债资金申购配号 | 744***\|794***\|756***,SH | 164 |
| 上海申购款 | 740***\|790***\|734***,SH | 165 |
| 上海发债款 | 743***\|793***\|755***,SH | 166 |
| 上海配股代码 | 700***\|760***\|742***,SH | 167 |
| 上海配转债代码 | 704***\|764***\|753***,SH | 168 |
| 上海 LOF | 501***,SH | 169 |
| 上海分级基金 | 502***,SH | 170 |
| 沪新股额 | SHXGED,SH | 171 |
| 沪增发股 | 730***\|731***\|780***\|781***,SH | 172 |
| 上海跨境 ETF 申赎代码 | 513031\|513501\|513101\|510901\|513601\|513661,SH | 173 |
| 上海债券 ETF | 511010\|511210\|511220,SH | 174 |
| 上海企业债券挂牌转让 | 139***,SH | 175 |
| 上海可交换私募债 | 1380**,SH | 176 |
| 沪市 1 天回购 | 204001,SH | 177 |
| 沪市 2 天回购 | 204002,SH | 178 |
| 沪市 3 天回购 | 204003,SH | 179 |
| 沪市 4 天回购 | 204004,SH | 180 |
| 沪市 7 天回购 | 204007,SH | 181 |
| 沪市 14 天回购 | 204014,SH | 182 |
| 沪市 28 天回购 | 204028,SH | 183 |
| 沪市 28 天以上回购 | 204091\|204182,SH | 184 |
| 上海分级基金子基金 | 5021\|5022\|5024\|5025\|502**7\|502008\|502018\|502028\|502038\|502058\|502049\|502050,SH | 185 |
| 深市 A 股 | 00****\|30****,SZ | 10001 |
| 深市 B 股 | 20****,SZ | 10002 |
| 深市封基 | 15****\|16****\|18****,SZ | 10003 |
| 深市主板 | 000***\|001***,SZ | 10004 |
| 深市小板 | 002***\|003***\|004***,SZ | 10005 |
| 深市创业板 | 30****,SZ | 10006 |
| 深市指数 | 39****,SZ | 10007 |
| 深市 ETF | 159***,SZ | 10008 |
| 深市权证 | 03****,SZ | 10009 |
| 深市国债回购 (131990 不是的, | 131990,SZ | 10010 |
| 需要业务支持) | ||
| 深市附息国债 | 100***\|101***\|102***\|103***\|104***\|105***\|106***\|107***,SZ | 10011 |
| 深市贴现国债 | 108***,SZ | 10012 |
| 深市公司债 | 112***,SZ | 10013 |
| 深市企业债 | 111***,SZ | 10014 |
| 深市分离债 | 115***,SZ | 10015 |
| 深市私募债 | 118***\|114***,SZ | 10016 |
| 深市专项资金管理规划 | 119***,SZ | 10017 |
| 深市地方政府债 | 109***,SZ | 10018 |
| 深市可转债 | 12****,SZ | 10019 |
| 深市标准券 | 131990\|SZRQ88,SZ | 10020 |
| 深市封闭式基金 | 184***,SZ | 10021 |
| 深市 LOF | 16****,SZ | 10022 |
| 深市分级基金 | 150***\|151***,SZ | 10023 |
| 深市中小企业可交换私募债 | 117***,SZ | 10024 |
| 深市证券公司次级债 | 1189**,SZ | 10025 |
| 深市其他中小企业私募债 | 1180**\|1181**\|1182**\|1183**\|1184**\|1185**\|1186**\|1187**\|1188**,SZ | 10026 |
| 深市资产支持证券 | 1190**\|1191**\|1192**\|1193**\|1194**,SZ | 10027 |
| 深市分级基金子基金 | 150***\|151***,SZ | 10028 |
| 深市跨境 ETF | 159920\|159941,SZ | 10029 |
| 深市跨境 LOF | 160125\|160416\|160717\|160719\|161116\|161210\|161714\|161815\|162411\|164701\|164815\|165510\|165513,SZ | 10030 |
| 深市创新型封闭式基金 | 150***,SZ | 10031 |
| 深市主板可转换公司债券 | 127***,SZ | 10032 |
| 深市创业板可转换公司债券 | 123***,SZ | 10033 |
| 深市中小板可转换公司债券 | 128***,SZ | 10034 |
| 深市国债回购 (131900 不是的, | 131***,SZ | 10035 |
| 需要业务支持) | ||
| 深市黄金 | 159934,SZ | 10036 |
| 深市实时申赎货币基金 | 1590**,SZ | 10037 |
| 深新股额 | SZXGED,SZ | 10038 |
| 深增发股 | 07****\|37***,SZ | 10039 |
| 深圳配股 | 08****,SZ | 10040 |
| 深圳债券 ETF 仅此一支 | 159926,SZ | 10041 |
| 深市 1 天回购 | 131810,SZ | 10042 |
| 深市 2 天回购 | 131811,SZ | 10043 |
| 深市 3 天回购 | 131800,SZ | 10044 |
| 深市 4 天回购 | 131809,SZ | 10045 |
| 深市 7 天回购 | 131801,SZ | 10046 |
| 深市 14 天回购 | 131802,SZ | 10047 |
| 深市 28 天回购 | 131803,SZ | 10048 |
| 深市 28 天以上回购 | 131805\|131806,SZ | 10049 |
| 中金所指数期货 | IF****\|IH****\|IC****\|IF**\|IH**\|IC**,IF | 30001 |
| 中金所国债期货 | TF****\|T****\|HTFF****\|TF**\|T**\|HTFF**,IF | 30002 |
| 类型描述 | 类型集合 | 类别标号 |
|---|---|---|
| 沪深 A 股 | 沪市 A 股\|深市 A 股 | 100001 |
| 沪深 B 股 | 沪市 B 股\|深市 B 股 | 100002 |
| 沪深狭义股 | 沪深 A 股\|沪深 B 股 | 100003 |
| 票 | ||
| 沪深封基 | 沪市封基\|深市封基 | 100004 |
| 指数 | 沪市指数\|深市指数 | 100005 |
| 商品期货 | 上期\|大商\|郑商 | 100006 |
| 期货市场 | 中金\|商品期货 | 100007 |
| 股票 | 沪市\|深市 | 100008 |
| 深市中央政 | ||
| 府债(国 | 深市附息国债\|深市贴现国债 | 100009 |
| 债) | ||
| 深市政府债 | 深市中央政府债(国债)\|深市地方政府债 | 100010 |
| 深市所有债 | 深市附息国债\|深市贴现国债\|深市地方政府债\|深市可转债\|深市企业 | 100011 |
| 券 | 债\|深市分离债\|深市私募债\|深市专项资金管理规划 | |
| 广义的股票 | ! 指数 | 100012 |
| ETF | 沪市 ETF\|深市 ETF | 100013 |
| 封闭式基金 | 沪市封闭式基金\|深市封闭式基金 | 100014 |
| 权证 | 沪市权证\|深市权证 | 100015 |
| 债券 | 上海债券\|深市所有债券 | 100016 |
| 深市国债回 | 深市国债回购 (131900 不是的,需要业务支持)&(! 深市国债回购 (131990 | 100017 |
| 购 | 不是的,需要业务支持)) | |
| 标准券 | 沪市标准券\|深市标准券 | 100018 |
| 债券回购 | 沪市国债回购(席位托管方式)\|深市国债回购 | 100020 |
| 质押式回购 | 沪市新质押式国债回购\|深市国债回购 | 100021 |
| 黄金 | 上海黄金\|深市黄金 | 100022 |
| 实时申赎货 | 上海实时申赎货币基金\|深市实时申赎货币基金 | 100023 |
| 币基金 | ||
| 货币基金 | 实时申赎货币基金\|上海交易型货币基金 | 100024 |
| 上海申购代 | 上海股票申购代码\|上海债券申购代码\|上海基金申购代码 | 100025 |
| 码 | ||
| 跨境 ETF | 深市跨境 ETF\|跨境 ETF | 100026 |
| 跨境 LOF | 跨境 LOF\|深市跨境 LOF | 100027 |
| 可交易的 | 沪深 A 股\|沪深封基\|ETF\|权证\|沪市申购\|深市创业板\|债券回购\|债券 ETF\|上海的固定收益类\|黄金\|货币基金\|深市中央政府债(国债)\|沪市中央政府债(国债)\|沪市地方债\|深市地方政府债\|上海申购代码\|沪市上海质押代码\|跨境 ETF\|跨境 LOF\|上海配股代码\|上海配转债代码\|深市可转债\|沪市可转债\|沪增发股\|深增发股 | 100028 |
| 主板 | 沪市 A 股\|深市主板 | 100029 |
| 回转交易 | 债券\|黄金\|上海的固定收益类\|权证\|跨境 ETF\|跨境 LOF\|上海交易型货币基金 | 100030 |
| 上海配号 | 上海新股配号\|上海配售首发配号\|上海可转债资金申购配号 | 100031 |
| 沪深新股申 | 沪新股额\|深新股额 | 100032 |
| 购额度 | ||
| 沪深配股代 | 上海配股代码\|深圳配股 | 100033 |
| 码 | ||
| 固定收益: | ||
| 跟踪债券指 | ||
| 数的交易型 | ||
| 开放式指数 | 上海的固定收益类 | 100034 |
| 基金、交易 | ||
| 型货币市场 | ||
| 基金 | ||
| 固定收益类 | 沪市附息国债\|深市附息国债\|沪市贴现国债\|深市贴现国债\|沪市政府债(国债 + 地方债)\|深市政府债\|深市企业债\|沪市企业债(席位托管方式)\|深市私募债\|沪市可转债\|深市可转债\|沪市分离债\|深市分离债\|债券回购\|标准券\|货币基金\|上海的固定收益类 | 100035 |
| 分级基金 | 上海分级基金\|深市分级基金 | 100036 |
| LOF | 上海 LOF\|深市 LOF | 100037 |
| 债券 ETF | 上海债券 ETF\|深圳债券 ETF | 100038 |
| 上海债券 | 沪市政府债(国债 + 地方债)\|沪市可转债\|沪市公司债\|沪市企业债(席位托管方式)\|沪市资产证券化\|沪市分离债\|沪市金融债\|沪市信贷资产支持\|沪市可交换公司债券\|沪市并购重组私募债券挂牌转让\|沪市证券公司短期债券挂牌转让\|上海可交换私募债\|上海企业债券挂牌转让\|上海可交换私募债 | 100039 |
| 1 天逆回购 | 沪市 1 天回购\|深市 1 天回购 | 100040 |
| 2 天逆回购 | 沪市 2 天回购\|深市 2 天回购 | 100041 |
| 3 天逆回购 | 沪市 3 天回购\|深市 3 天回购 | 100042 |
| 4 天逆回购 | 沪市 4 天回购\|深市 4 天回购 | 100043 |
| 7 天逆回购 | 沪市 7 天回购\|深市 7 天回购 | 100044 |
| 14 天逆回购 | 沪市 14 天回购\|深市 14 天回购 | 100045 |
| 28 天逆回购 | 沪市 28 天回购\|深市 28 天回购 | 100046 |
| 28 天以上逆 | 沪市 28 天以上回购\|深市 28 天以上回购 | 100047 |
| 回购 |
m_dMaxMarginRate: 保证金比率,股票的保证金率等于 1,股票不需要
m_dFrozenMargin: 冻结保证金,外源性,股票的保证金就是冻结资金,股票不需要
m_dFrozenCash: 冻结金额,内外源冻结保证金和手续费四个的和
m_dFrozenCommission: 冻结手续费,外源性冻结资金源
m_dRisk: 风险度,风险度,冻结资金 / 可用资金,股票不需要
m_dNav: 单位净值
m_dPreBalance: 期初权益,股票不需要,也叫静态权益
m_dBalance: 总资产,动态权益,即市值
m_dAvailable: 可用金额
m_dCommission: 手续费,已经用掉的手续费
m_dPositionProfit: 持仓盈亏
m_dCloseProfit: 平仓盈亏,股票不需要
m_dCashIn: 出入金净值
m_dCurrMargin: 当前使用的保证金,股票不需要
m_dInitBalance: 初始权益
m_strStatus: 状态
m_dInitCloseMoney: 期初平仓盈亏,初始平仓盈亏
m_dInstrumentValue: 总市值,合约价值,合约价值
m_dDeposit: 入金
m_dWithdraw: 出金
m_dPreCredit: 上次信用额度,股票不需要
m_dPreMortgage: 上次质押,股票不需要
m_dMortgage: 质押,股票不需要
m_dCredit: 信用额度,股票不需要
m_dAssetBalance: 证券初始资金,股票不需要
m_strOpenDate: 起始日期,股票不需要
m_dFetchBalance: 可取金额
m_strTradingDate: 交易日
m_dStockValue: 股票总市值,期货没有
m_dLoanValue: 债券总市值,期货没有
m_dFundValue: 基金总市值,包括 ETF 和封闭式基金,期货没有
m_dRepurchaseValue: 回购总市值,所有回购,期货没有
m_dLongValue: 多单总市值,现货没有
m_dShortValue: 单总市值,现货没有
m_dNetValue: 净持仓总市值,净持仓市值 = 多 - 空
m_dAssureAsset: 净资产
m_dTotalDebit: 总负债
m_dEntrustAsset: 可信资产,用于校对
m_dInstrumentValueRMB: 总市值(人民币),沪港通
m_dSubscribeFee: 申购费,申购费
m_dGoldValue: 库存市值,黄金现货库存市值
m_dGoldFrozen: 现货冻结,黄金现货冻结
m_dMargin: 占用保证金,维持保证金
m_strMoneyType: 币种
m_dPurchasingPower: 购买力,盈透购买力
m_dRawMargin : 原始保证金
m_dBuyWaitMoney: 买入待交收金额(元),买入待交收
m_dSellWaitMoney: 卖出待交收金额(元),卖出待交收
m_dReceiveInterestTotal: 本期间应计利息
m_dRoyalty: 权利金收支,期货期权用
m_dFrozenRoyalty: 冻结权利金,期货期权用
m_dRealUsedMargin: 实时占用保证金,用于股票期权
m_dRealRiskDegree: 实时风险度
m_strExchangeID: 证券市场
m_strExchangeName: 交易市场
m_strProductID: 品种代码
m_strProductName: 品种名称
m_strInstrumentID: 证券代码
m_strInstrumentName: 证券名称,合约名称
m_nTaskId:任务号
m_strOrderRef: 内部委托号,下单引用等于股票的内部委托号
m_nOrderPriceType: EBrokerPriceType 类型,例如市价单、限价单
m_nDirection: EEntrustBS 类型,操作,多空,期货多空,股票买卖永远是 48,其他的 dir 同理
m_nOffsetFlag: EOffset_Flag_Type 类型,操作,期货开平,股票买卖其实就是开平
m_nHedgeFlag: EHedge_Flag_Type 类型,投保
m_dLimitPrice: 委托价格,限价单的限价,就是报价
m_nVolumeTotalOriginal: 委托量,最初委托量
m_nOrderSubmitStatus: EEntrustSubmitStatus 类型,报单状态,提交状态,股票中不需要报单状态
m_strOrderSysID: 合同编号,委托号
m_nOrderStatus: EEntrustStatus,委托状态
m_nVolumeTraded: 成交数量,已成交量
m_nVolumeTotal: 委托剩余量,当前总委托量,股票的含义是总委托量减去成交量
m_nErrorID: 状态信息
m_dFrozenMargin: 冻结金额,冻结保证金
m_dFrozenCommission: 冻结手续费
m_strInsertDate: 委托日期,报单日期
m_strInsertTime: 委托时间
m_dTradedPrice: 成交均价(股票)
m_dCancelAmount: 已撤数量
m_strOptName: 买卖标记,展示委托属性的中文
m_dTradeAmount: 成交金额,成交额,期货 = 均价 * 量 * 合约乘数
m_eEntrustType: EEntrustTypes,委托类别
m_strCancelInfo: 废单原因
m_strUnderCode: 标的证券代码
m_eCoveredFlag: ECoveredFlag,备兑标记 '0' - 非备兑,'1' - 备兑
m_strCompactNo: 合约编号
m_strRemark:投资备注
m_nRef:订单编号
m_strExchangeID: 证券市场,交易所代码
m_strExchangeName: 交易市场,交易所名称
m_strProductID: 品种代码
m_strProductName: 品种名称
m_strInstrumentID: 证券代码
m_strInstrumentName: 证券名称
m_strTradeID: 成交编号
m_nTaskId:任务号
m_strOrderRef: 下单引用,等于股票的内部委托号
m_strOrderSysID: 合同编号,报单编号,委托号
m_nDirection: EEntrustBS,买卖方向
m_nOffsetFlag: EOffset_Flag_Type,开平,股票的买卖
m_nHedgeFlag: EHedge_Flag_Type,投保,股票不需要
m_dPrice: 成交均价
m_nVolume: 成交量,期货单位手,股票做到股
m_strTradeDate: 成交日期
m_strTradeTime: 成交时间
m_dComssion: 手续费
m_dTradeAmount: 成交额,期货 = 均价 * 量 * 合约乘数
m_nOrderPriceType: EBrokerPriceType 类型,例如市价单、限价单
m_strOptName:买卖标记,展示委托属性的中文
m_eEntrustType: EEntrustTypes 类型,委托类别
m_eFutureTradeType: EFutureTradeType 类型,成交类型
m_nRealOffsetFlag: EOffset_Flag_Type 类型,实际开平,主要是区分平今和平昨
m_eCoveredFlag: ECoveredFlag 类型,备兑标记 '0' - 非备兑,'1' - 备兑
m_nCloseTodayVolume: 平今量,不显示
m_dOrderPriceRMB: 委托价格(人民币),目前用于港股通
m_dPriceRMB: 成交价格(人民币),目前用于港股通
m_dTradeAmountRMB:成交金额(人民币),目前用于港股通
m_dReferenceRate: 汇率,目前用于港股通
m_strXTTrade: 是否是国泰君安交易
m_strCompactNo: 合约编号
m_dCloseProfit: 平仓盈亏,目前用于外盘
m_strRemark:投资备注
m_nRef:订单编号
m_strExchangeID: 证券市场
m_strExchangeName: 市场名称
m_strProductID: 品种代码
m_strProductName: 品种名称
m_strInstrumentID: 证券代码
m_strInstrumentName: 证券名称
m_nHedgeFlag: EHedge_Flag_Type 类型,投保,股票不需要
m_nDirection: EEntrustBS 类型,买卖 ; 股票不需要
m_strOpenDate: 成交日期
m_strTradeID: 成交号,最初开仓位的成交
m_nVolume: 当前拥股,持仓量
m_dOpenPrice: 持仓成本
m_strTradingDay: 在实盘运行中是当前交易日,在回测中是股票最后交易过的日期
m_dMargin: 使用的保证金,历史的直接用 ctp 的,新的自己用成本价 * 存量 * 系数算,股票不需要
m_dOpenCost: 开仓成本,等于股票的成本价 * 第一次建仓的量,后续减持不影响,不算手续费,股票不需要
m_dSettlementPrice: 最新价,结算价,对于股票的当前价
m_nCloseVolume: 平仓量,等于股票已经卖掉的股票不需要
m_dCloseAmount: 平仓额,等于股票每次卖出的量 * 卖出价 * 合约乘数(股票为 1)的累加股票不需要
m_dFloatProfit: 浮动盈亏,当前量 * (当前价 - 开仓价) * 合约乘数(股票为 1)
m_dCloseProfit: 平仓盈亏,平仓额 - 开仓价 * 平仓量 * 合约乘数(股票为 1)股票不需要
m_dMarketValue: 市值,合约价值
m_dPositionCost: 持仓成本,股票不需要
m_dPositionProfit: 持仓盈亏,股票不需要
m_dLastSettlementPrice: 最新结算价,股票不需要
m_dInstrumentValue: 合约价值,股票不需要
m_bIsToday: 是否今仓
m_strStockHolder: 股东账号
m_nFrozenVolume: 冻结数量,冻结持仓,期货不用这个字段,冻结数量
m_nCanUseVolume: 可用余额,可用持仓,期货不用这个字段,股票的可用数量
m_nOnRoadVolume: 在途股份,在途持仓,期货不用这个字段,股票的在途数量
m_nYesterdayVolume: 昨夜拥股,期货不用这个字段,股票的股份余额
m_dLastPrice: 最新价,结算价,对于股票的当前价
m_dProfitRate: 盈亏比例,持仓盈亏比例
m_eFutureTradeType: EFutureTradeType,成交类型
m_strExpireDate: 到期日,逆回购用
m_strComTradeID: 组合成交号,套利成交 ID
m_nLegId: 组合序号,组合 ID
m_dTotalCost: 累计成本,自定义累计成本,股票信用用到
m_dSingleCost: 单股成本,自定义单股成本,股票信用用到
m_nCoveredVolume: 备兑数量,用于个股期权
m_eSideFlag: ESideFlag 持仓类型,用于个股期权,标记 '0' - 权利,'1' - 义务,'2' - '备兑'
m_dReferenceRate: 汇率,目前用于港股通
m_dStructFundVol: 分级基金可用(可分拆或可合并)
m_dRedemptionVolume: 分级基金可赎回量
m_nPREnableVolume: 申赎可用量(记录当日申购赎回的股票或基金数量)
m_dRealUsedMargin: 实时占用保证金,用于期权
m_dRoyalty: 权利金
m_dMaxMarginRate: 保证金比率,股票的保证金率等于 1,股票不需要
m_dFrozenMargin: 冻结保证金,外源性,股票的保证金就是冻结资金,股票不需要
m_dFrozenCash: 冻结金额,内外源冻结保证金和手续费四个的和
m_dFrozenCommission: 冻结手续费,外源性冻结资金源
m_dRisk: 风险度,冻结资金/可用资金,股票不需要
m_dNav: 单位净值
m_dPreBalance: 期初权益,股票不需要,也叫静态权益
m_dBalance: 总资产,动态权益,即市值
m_dAvailable: 可用金额
m_dCommission: 手续费,已经用掉的手续费
m_dPositionProfit: 持仓盈亏
m_dCloseProfit: 平仓盈亏,股票不需要
m_dCashIn: 出入金净值
m_dCurrMargin: 当前使用的保证金,股票不需要
m_dInitBalance: 初始权益
m_strStatus: 状态
m_dInitCloseMoney: 期初平仓盈亏,初始平仓盈亏
m_dInstrumentValue: 总市值,合约价值,合约价值
m_dDeposit: 入金
m_dWithdraw: 出金
m_dPreCredit: 上次信用额度,股票不需要
m_dPreMortgage: 上次质押,股票不需要
m_dMortgage: 质押,股票不需要
m_dCredit: 信用额度,股票不需要
m_dAssetBalance: 证券初始资金,股票不需要
m_strOpenDate: 起始日期股票不需要
m_dFetchBalance: 可取金额
m_strTradingDate: 交易日
m_dStockValue: 股票总市值,期货没有
m_dLoanValue: 债券总市值,期货没有
m_dFundValue: 基金总市值,包括 ETF 和封闭式基金,期货没有
m_dRepurchaseValue: 回购总市值,所有回购,期货没有
m_dLongValue: 多单总市值,现货没有
m_dShortValue: 单总市值,现货没有
m_dNetValue: 净持仓总市值,净持仓市值 = 多 - 空
m_dAssureAsset: 净资产
m_dTotalDebit: 总负债
m_dEntrustAsset: 可信资产,用于校对
m_dInstrumentValueRMB: 总市值(人民币),沪港通
m_dSubscribeFee: 申购费,申购费
m_dGoldValue: 库存市值,黄金现货库存市值
m_dGoldFrozen: 现货冻结,黄金现货冻结
m_dMargin: 占用保证金,维持保证金
m_strMoneyType: 币种
m_dPurchasingPower: 购买力,盈透购买力
m_dRawMargin : 原始保证金
m_dBuyWaitMoney: 买入待交收金额(元),买入待交收
m_dSellWaitMoney: 卖出待交收金额(元),卖出待交收
m_dReceiveInterestTotal: 本期间应计利息
m_dRoyalty: 权利金收支,期货期权用
m_dFrozenRoyalty: 冻结权利金,期货期权用
m_dRealUsedMargin: 实时占用保证金,用于股票期权
m_dRealRiskDegree: 实时风险度
m_dPerAssurescaleValue: 个人维持担保比例
m_dEnableBailBalance: 可用保证金
m_dUsedBailBalance: 已用保证金
m_dAssureEnbuyBalance: 可买担保品资金
m_dFinEnbuyBalance: 可买标的券资金
m_dSloEnrepaidBalance: 可还券资金
m_dFinEnrepaidBalance: 可还款资金
m_dFinMaxQuota: 融资授信额度
m_dFinEnableQuota: 融资可用额度
m_dFinUsedQuota: 融资已用额度
m_dFinUsedBail: 融资已用保证金额
m_dFinCompactBalance: 融资合约金额
m_dFinCompactFare: 融资合约费用
m_dFinCompactInterest: 融资合约利息
m_dFinMarketValue: 融资市值
m_dFinIncome: 融资合约盈亏
m_dSloMaxQuota: 融券授信额度
m_dSloEnableQuota: 融券可用额度
m_dSloUsedQuota: 融券已用额度
m_dSloUsedBail: 融券已用保证金额
m_dSloCompactBalance: 融券合约金额
m_dSloCompactFare: 融券合约费用
m_dSloCompactInterest: 融券合约利息
m_dSloMarketValue: 融券市值
m_dSloIncome: 融券合约盈亏
m_dOtherFare: 其它费用
m_dUnderlyMarketValue: 标的证券市值
m_dFinEnableBalance: 可融资金额
m_dDiffEnableBailBalance: 可用保证金调整值
m_dBuySecuRepayFrozenMargin: 买券还券冻结资金
m_dBuySecuRepayFrozenCommission: 买券还券冻结手续费
m_dSpecialEnableBalance: 专项可融金额
m_dEncumberedAssets: 担保资产
m_dSloSellBalance: 融券卖出资金
m_dDiffAssureEnbuyBalance: 可买担保品资金调整值
m_dDiffFinEnbuyBalance: 可买标的券资金调整值
m_dDiffFinEnrepaidBalance: 可还款资金调整值
m_dOtherRealCompactBalance: 其他负债合约金额
m_dOtherFinCompactInterest: 其他负债合约利息金额
m_dUsedSloSellBalance: 已用融券卖出资金
m_dFetchAssetBalance: 可提出资产总额
m_dTotalEnableQuota: 可用总信用额度
m_dTotalUsedQuota: 已用总信用额度;
m_dDebtProfit: 负债总浮盈
m_dDebtLoss: 负债总浮亏
m_nContractEndDate: 合同到期日期
m_dFinDebt: 融资负债
m_dFinProfitAmortized: 融资浮盈折算
m_dSloProfit: 融券浮盈
m_dSloProfitAmortized: 融券浮盈折算
m_dFinLoss: 融资浮亏
m_dSloLoss: 融券浮亏
m_nPlatformID: 平台号
m_strBrokerID: 经纪公司编号
m_strBrokerName: 证券公司,期货公司,经纪公司,证券公司
m_strAccountID: 资金账号,账号,账号,资金账号
m_strExchangeID: 交易所
m_strInstrumentID: 证券代码
m_strInstrumentName: 股票名称
m_dSloRatio: 融券保证金比例
m_eSloStatus: EXTSubjectsStatus,融券状态
m_nEnableAmount: 融券可融数量
m_eQuerySloType: EXTSloTypeQueryMode,查询类型
m_strExpireDate: 到期日期
m_strExchangeID: 交易所
m_strInstrumentID: 证券代码
m_strExchangeName: 交易所名称
m_strInstrumentName: 股票名称
m_nOpenDate: 合约开仓日期
m_strCompactId: 合约编号
m_dCrdtRatio: 融资融券保证金比例
m_strEntrustNo: 委托编号
m_dEntrustPrice: 委托价格
m_nEntrustVol: 委托数量
m_nBusinessVol: 合约开仓数量
m_dBusinessBalance: 合约开仓金额
m_dBusinessFare: 合约开仓费用
m_eCompactType: EXTCompactType,合约类型
m_eCompactStatus: EXTCompactStatus,合约状态
m_dRealCompactBalance: 未还合约金额
m_nRealCompactVol: 未还合约数量
m_dRealCompactFare: 未还合约费用
m_dRealCompactInterest: 未还合约利息
m_dRepaidInterest: 已还利息
m_nRepaidVol: 已还数量
m_dRepaidBalance: 已还金额
m_dCompactInterest: 合约总利息
m_dUsedBailBalance: 占用保证金
m_dYearRate: 合约年利率
m_nRetEndDate: 归还截止日
m_strDateClear: 了结日期
m_strPositionStr: 定位串
m_dPrice: 最新价
m_nOpenTime: 合约开仓时间
m_nCancelVol: 合约撤单数量
m_eCashgroupProp: EXTCompactBrushSource,头寸来源
m_dUnRepayBalance: 负债金额
m_nRepayPriority: 偿还优先级
m_dRealDefaultInterest: 未还罚息
m_dOtherRealCompactBalance: 其他负债合约金额
m_dOtherRealCompactInterest: 其他负债合约利息金额
m_nPlatformID: 平台号//目前主要用于区别不同的行情,根据此来选择对应行情
m_strBrokerID: 经纪公司编号
m_strBrokerName: 证券公司,期货公司,经纪公司,证券公司
m_strExchangeID: 交易所
m_strInstrumentID: 证券代码
m_strInstrumentName: 股票名称
m_dSloRatio: 融券保证金比例
m_eSloStatus: EXTSubjectsStatus,融券状态
m_nEnableAmount: 融券可融数量
m_dFinRatio: 融资保证金比例
m_eFinStatus: EXTSubjectsStatus,融资状态
m_dAssureRatio: 担保品折算比例
m_eAssureStatus: EXTSubjectsStatus,是否可做担保
m_dFinRate: 融资日利率
m_dSloRate: 融券日利率
m_dFinPenaltyRate: 融资日罚息利率
m_dSloPenaltyRate: 融券日罚息利率
m_strAccountID: 资金账号,账号,账号,资金账号
m_eAssureUseSloCashStatus: EXTSpecialAssure,是否可以用融券资金买入
opType: passorder 的 opType 参数
orderType: passorder 的 orderType 参数
accountID:资金账号
orderCode:交易代码
prType: passorder 的 prType,价格类型
modelPrice:下单价格
modelVolume: 下单量(手数或股数)
strategyName:策略名 _ &&& _ 投资备注
m_nTaskId:任务号
m_eStatus:任务状态 ETaskStatus 类型,见 ETaskStatus 说明
m_strMsg:任务状态消息
m_startTime: 任务开始时间,时间戳类型
m_endTime:任务结束时间,时间戳类型
m_cancelTime: 任务取消时间
m_nBusinessNum: 已成交量
m_bServerRun: 是否服务器运行
m_nGroupId: 组合 Id
m_stockCode: 下单代码 (不针对组合下单)
m_strAccountID: 下单用户 (单用户下单)
m_eOperationType: 下单操作:开平、多空……EOperationType 类型,见 EOperationType 说明
m_eOrderType: 算法交易、普通交易 EOrderType 类型,见 EOrderType 说明
m_ePriceType: 报价方式:对手、最新…… EPriceType 类型见 EPriceType 说明
m_dFixPrice: 委托价
m_nNum: 委托量
5-1.enum_EEntrustBS //买卖方向
ENTRUST_BUY: 48 //买入,多
ENTRUST_SELL: 49 //卖出,空
ENTRUST_PLEDGE_IN: 81 //质押入库
48 //已经提交
49 //撤单已经提交
50 //修改已经提交
51 //已经接受
52 //报单已经被拒绝
53 //撤单已经被拒绝
54 //改单已经被拒绝
ENTRUST_BUY_SELL: 48 //买卖
ENTRUST_QUERY: 49 //查询
ENTRUST_CANCE: 50 //撤单
ENTRUST_APPEND: 51 //补单
ENTRUST_COMFIRM: 52 //确认
ENTRUST_BIG: 53 //大宗
ENTRUST_FIN: 54 //融资委托
ENTRUST_SLO: 55 //融券委托
ENTRUST_CLOSE: 56 //信用平仓
ENTRUST_CREDIT_NORMAL: 57 //信用普通委托
ENTRUST_CANCEL_OPEN: 58 //撤单补单
ENTRUST_TYPE_OPTION_EXERCISE: 59 //行权
ENTRUST_TYPE_OPTION_SECU_LOCK: 60 //锁定
ENTRUST_TYPE_OPTION_SECU_UNLOCK: 61 //解锁
5-4.enum_EEntrustStatus //委托状态
ENTRUST_STATUS_WAIT_END: 0 //委托状态已经在 ENTRUST_STATUS_CANCELED 或以上,
但是成交数额还不够,等成交回报来
ENTRUST_STATUS_UNREPORTED: 48 //未报
ENTRUST_STATUS_WAIT_REPORTING: 49 //待报
ENTRUST_STATUS_REPORTED: 50 //已报
ENTRUST_STATUS_REPORTED_CANCEL: 51 //已报待撤
ENTRUST_STATUS_PARTSUCC_CANCEL: 52 //部成待撤
ENTRUST_STATUS_PART_CANCEL: 53 //部撤
ENTRUST_STATUS_CANCELED: 54 //已撤
ENTRUST_STATUS_PART_SUCC: 55 //部成
ENTRUST_STATUS_SUCCEEDED: 56 //已成
ENTRUST_STATUS_JUNK: 57 //废单
ENTRUST_STATUS_DETERMINED: 86 //已确认
ENTRUST_STATUS_UNKNOWN: 255 //未知
5-5.enum_EHedge_Flag_Type
HEDGE_FLAG_SPECULATION: 49 //投机
HEDGE_FLAG_ARBITRAGE: 50 //套利
HEDGE_FLAG_HEDGE: 51 //套保
5-6.enum_EFutureTradeType // 成交类型
FUTRUE_TRADE_TYPE_COMMON: 48 //普通成交
FUTURE_TRADE_TYPE_OPTIONSEXECUTION: 49 //期权成交,ptionsExecution
FUTURE_TRADE_TYPE_OTC: 50 //OTC 成交
FUTURE_TRADE_TYPE_EFPDIRVED: 51 //期转现衍生成交
FUTURE_TRADE_TYPE_COMBINATION_DERIVED: 52 //组合衍生成交
5-7.enum_EBrokerPriceType // 价格类型
BROKER_PRICE_ANY: 49 //市价
BROKER_PRICE_LIMIT: 50 //限价
BROKER_PRICE_BEST: 51 //最优价
BROKER_PRICE_PROP_ALLOTMENT: 52 //配股
BROKER_PRICE_PROP_REFER: 53 //转托
BROKER_PRICE_PROP_SUBSCRIBE: 54 //申购
BROKER_PRICE_PROP_BUYBACK: 55 //回购
BROKER_PRICE_PROP_PLACING: 56 //配售
BROKER_PRICE_PROP_DECIDE: 57 //指定
BROKER_PRICE_PROP_EQUITY: 58 //转股
BROKER_PRICE_PROP_SELLBACK: 59 //回售
BROKER_PRICE_PROP_DIVIDEND: 60 //股息
BROKER_PRICE_PROP_SHENZHEN_PLACING: 68 //深圳配售确认
BROKER_PRICE_PROP_CANCEL_PLACING: 69 //配售放弃
BROKER_PRICE_PROP_WDZY: 70 //无冻质押
BROKER_PRICE_PROP_DJZY: 71 //冻结质押
BROKER_PRICE_PROP_WDJY: 72 //无冻解押
BROKER_PRICE_PROP_JDJY: 73 //解冻解押
BROKER_PRICE_PROP_ETF: 81 //ETF 申购
BROKER_PRICE_PROP_VOTE: 75 //投票
BROKER_PRICE_PROP_YYSGYS: 92 //要约收购预售
BROKER_PRICE_PROP_YSYYJC: 77 //预售要约解除
BROKER_PRICE_PROP_FUND_DEVIDEND //基金设红
BROKER_PRICE_PROP_FUND_ENTRUST: 79 //基金申赎
BROKER_PRICE_PROP_CROSS_MARKET: 80 //跨市转托
BROKER_PRICE_PROP_EXERCIS: 83 //权证行权
BROKER_PRICE_PROP_PEER_PRICE_FIRST: 84 //对手方最优价格
BROKER_PRICE_PROP_L5_FIRST_LIMITPX: 85 //最优五档即时成交剩余转限价
BROKER_PRICE_PROP_MIME_PRICE_FIRST: 86 //本方最优价格
BROKER_PRICE_PROP_INSTBUSI_RESTCANCEL: 87 //即时成交剩余撤销
BROKER_PRICE_PROP_L5_FIRST_CANCEL: 88 //最优五档即时成交剩余撤销
BROKER_PRICE_PROP_FULL_REAL_CANCEL: 89 //全额成交并撤单
BROKER_PRICE_PROP_DIRECT_SECU_REPAY: 101 //直接还券
BROKER_PRICE_PROP_FUND_CHAIHE: 90 //基金拆合
BROKER_PRICE_PROP_DEBT_CONVERSION: 91 //债转股
BROKER_PRICE_BID_LIMIT: 92 //港股通竞价限价
BROKER_PRICE_ENHANCED_LIMIT: 93 //港股通增强限价
BROKER_PRICE_RETAIL_LIMIT: 94 //港股通零股限价
BROKER_PRICE_PROP_INCREASE_SHARE: 'j' //增发
BROKER_PRICE_PROP_COLLATERAL_TRANSFER: 107 //担保品划转
BROKER_PRICE_PROP_NEEQ_PRICING: 'w' //定价(全国股转 - 挂牌公司交易 - 协议转让)
BROKER_PRICE_PROP_NEEQ_MATCH_CONFIRM: 'x' //成交确认(全国股转 - 挂牌公司交易 -
协议转让)
BROKER_PRICE_PROP_NEEQ_MUTUAL_MATCH_CONFIRM: 'y' //互报成交确认(全国股转
挂牌公司交易 - 协议转让)
BROKER_PRICE_PROP_NEEQ_LIMIT: 'z' //限价(用于挂牌公司交易 - 做市转让 - 限价买卖和两
网及退市交易 - 限价买卖)
5-8.enum_EOffset_Flag_Type //操作类型
EOFF_THOST_FTDC_OF_INVALID: -1
EOFF_THOST_FTDC_OF_Open: 48 //买入,开仓
EOFF_THOST_FTDC_OF_Close: 49 //卖出,平仓
EOFF_THOST_FTDC_OF_ForceClose: 50 //强平
EOFF_THOST_FTDC_OF_CloseToday: 51 //平今
EOFF_THOST_FTDC_OF_CloseYesterday: 52 //平昨
EOFF_THOST_FTDC_OF_ForceOff: 53 //强减
EOFF_THOST_FTDC_OF_LocalForceClose: 54 //本地强平
EOFF_THOST_FTDC_OF_PLEDGE_IN: 81 //质押入库
EOFF_THOST_FTDC_OF_PLEDGE_OUT: 66 //质押出库
EOFF_THOST_FTDC_OF_ALLOTMENT: 67 //股票配股
5-9.enum EXTSubjectsStatus //融资融券状态
SUBJECTS_STATUS_NORMAL: 48 //正常
SUBJECTS_STATUS_PAUSE: 49 //暂停
SUBJECTS_STATUS_NOT: 50 //作废
5-10.enum EXTSloTypeQueryMode //查询类型
XT_SLOTYPE_QUERYMODE_NOMARL: 48 //普通
XT_SLOTYPE_QUERYMODE_SPECIAL: 49 //专项
5-11.enum EXTCompactType //合约类型
COMPACT_TYPE_ALL: 32 //不限制
COMPACT_TYPE_FIN: 48 //融资
COMPACT_TYPE_SLO: 49 //融券
5-12 enum EXTCompactStatus //合约状态
COMPACT_STATUS_ALL: 32 //不限制
COMPACT_STATUS_UNDONE: 48 //未归还
COMPACT_STATUS_PART_DONE: 49 //部分归还
COMPACT_STATUS_DONE: 50 //已归还
COMPACT_STATUS_DONE_BY_SELF: 51 //自行了结
COMPACT_STATUS_DONE_BY_HAND: 52 //手工了结
COMPACT_STATUS_NOT_DEBT: 53 //未形成负债
COMPACT_STATUS_EXPIRY: 54 //合约已过期
5-13.enum EXTCompactBrushSource //头寸来源
XT_COMPACT_BRUSH_SOURCE_ALL: 32 //不限制
XT_COMPACT_BRUSH_SOURCE_NORMAL: 48 //普通头寸
XT_COMPACT_BRUSH_SOURCE_SPECIAL: 49 //专项头寸
5-14.enum_EXTSpecialAssure //是否可以用融券资金买入
ASSURE_USE_SLO_CASH_DISABLE: 48 //担保品买入不允许使用融券资金
ASSURE_USE_SLO_CASH_ENABLE: 49 //担保品买入允许使用融券资金
5-15 enum_EOperationType : // 下单操作类型 主要交易类型
OPT_OPEN_LONG|开多 : 0; // 期货操作的第 1 个,请保持此 OPT 在期货操作的第 1 个,否则客
户端判断操作是期货还是股票的代码会有问题
OPT_CLOSE_LONG_HISTORY:1 //平昨多黄金用平多表示
OPT_CLOSE_LONG_TODAY: 2 //平今多
OPT_OPEN_SHORT:3 //开空
OPT_CLOSE_SHORT_HISTORY:4 //平昨空,平昨空,平昨空,平昨空,平昨空,平昨空,平昨
空,平昨空,平空; // 黄金用平空表示
OPT_CLOSE_SHORT_TODAY:5 //平今空;
OPT_CLOSE_LONG_TODAY_FIRST:6 //平多优先平今;
OPT_CLOSE_LONG_HISTORY_FIRST:7 //平多优先平昨;
OPT_CLOSE_SHORT_TODAY_FIRST:8 //平空优先平今;
OPT_CLOSE_SHORT_HISTORY_FIRST:9 //|平空优先平昨;
OPT_CLOSE_LONG_TODAY_HISTORY_THEN_OPEN_SHORT:10 //卖出优先平今;
OPT_CLOSE_LONG_HISTORY_TODAY_THEN_OPEN_SHORT:11//卖出优先平昨;
OPT_CLOSE_SHORT_TODAY_HISTORY_THEN_OPEN_LONG:12//买入优先平今;
OPT_CLOSE_SHORT_HISTORY_TODAY_THEN_OPEN_LONG:13//买入优先平昨;
OPT_CLOSE_LONG:14 //平多
OPT_CLOSE_SHORT:15 //平空
OPT_OPEN:16 //开仓
OPT_CLOSE: 17 // 平仓
OPT_BUY: 18 //买入
OPT_SELL:19 //卖出
OPT_FIN_BUY: 20 //融资买入
OPT_SLO_SELL: 21 //融券卖出
OPT_BUY_SECU_REPAY:22 //买券还券
OPT_DIRECT_SECU_REPAY:23 //直接还券
OPT_SELL_CASH_REPAY:24 //卖券还款
OPT_DIRECT_CASH_REPAY:25 //直接还款
5-15 enum_EOrderType : // 算法交易、普通交易类型
OTP_ORDINARY; 0 //常规
OTP_ALGORITHM; 1 //算法交易
OTP_RANDVOLUME; 2 // 随机量交易
OTP_ALGORITHM3 3 // 算法交易 3
OTP_ZXJT; 4 // 中信建投算法
OTP_ZSGS; 5 // 隔时交易
OTP_ORDINARY_BASKET_TRIGGER_SINGLE_ORDER; 6 //普通交易的触价单笔委托方式
OTP_ALGORITHM_BASKET_TRIGGER_SINGLE_ORDER; 7 //算法交易的触价单笔委托方式
OTP_ZXZQ; 8 // 中信证券算法
OTP_GENUS; 9 //金纳算法
OTP_JAZZ; 10 //爵士算法
OTP_VWAP; 11 //智能 VWAP
OTP_TWAP; 12 //智能 TWAP
OTP_XTALGO; 13 //智能算法
OTP_HUACHUANG; 14 //华创算法
OTP_HUARUN; 15 //华润算法
OTP_CUSTOM; 16 //回转算法
OPT_EXTERN; 17 //主动算法
OTP_GUANGFA; 18 //广发算法
5-15 enum_EPriceType : // 价格类型
PRTP_SALE5; 0 // 卖 5
PRTP_SALE4; 1 // 卖 4
PRTP_SALE3; 2 // 卖 3
PRTP_SALE2; 3 // 卖 2
PRTP_SALE1; 4 // 卖 1
PRTP_LATEST; 5 // 最新价
PRTP_BUY1; 6 // 买 1
PRTP_BUY2; 7 // 买 2
PRTP_BUY3; 8 // 买 3
PRTP_BUY4; 9 // 买 4
PRTP_BUY5; 10 // 买 5
PRTP_FIX; 11 // 指定价
PRTP_MARKET; 12 // 市价_涨跌停价
PRTP_HANG; 13 // 挂单价
PRTP_COMPETE; 14 // 对手价
PRTP_AUTO; 15 // 自动盘口
PRTP_CLOSE; 16 //昨收价
PRTP_AVERAGE; 17 // 大宗加权平均价
PRTP_MARKET_BEST;18 //市价_最优价
PRTP_MARKET_CANCEL;19 //市价_即成剩撤
PRTP_MARKET_CANCEL_ALL;20 //市价_全额成交或撤
PRTP_MARKET_CANCEL_1; 21 //市价_最优 1 档即成剩撤
PRTP_MARKET_CANCEL_5; 22 //市价_最优 5 档即成剩撤
PRTP_MARKET_CONVERT_1;23 //市价_最优 1 档即成剩转
PRTP_MARKET_CONVERT_5;24 //市价_最优 5 档即成剩转
PRTP_STK_OPTION_ASK;25 //询价
PRTP_STK_OPTION_FIX_CANCEL_ALL; 26 //限价即时全部成交否则撤单
PRTP_STK_OPTION_MARKET_CACEL_LEFT;27 //市价即时成交剩余撤单
PRTP_STK_OPTION_MARKET_CANCEL_ALL;28 //市价即时全部成交否则撤单
PRTP_STK_OPTION_MARKET_CONVERT_FIX;29 //市价剩余转限价
PRTP_SALE6; 30 // 卖 6
PRTP_SALE7; 31 // 卖 7
PRTP_SALE8; 32 // 卖 8
PRTP_SALE9; 33 // 卖 9
PRTP_SALE10; 34 // 卖 10
PRTP_BUY6; 35 // 买 6
PRTP_BUY7; 36 // 买 7
PRTP_BUY8; 37 // 买 8
PRTP_BUY9; 38 // 买 9
PRTP_BUY10; 39 // 买 10
PRTP_UPPER_LIMIT_PRICE; 40 //涨停价
PRTP_LOWER_LIMIT_PRICE; 41 //跌停价
PRTP_MARKET_SH_CONVERT_5_CANCEL; 42 //最优五档即时成交剩余撤销
PRTP_MARKET_SH_CONVERT_5_LIMIT; 43 //最优五档即时成交剩转限价
PRTP_MARKET_PEER_PRICE_FIRST; 44 //对手方最优价格委托
PRTP_MARKET_MINE_PRICE_FIRST; 45 //本方最优价格委托
PRTP_MARKET_SZ_INSTBUSI_RESTCANCEL; 46 //即时成交剩余撤销委托
PRTP_MARKET_SZ_CONVERT_5_CANCEL; 47 //最优五档即时成交剩余撤销委托
PRTP_MARKET_SZ_FULL_REAL_CANCEL; 48 //全额成交或撤销委托
PRTP_AFTER_FIX_PRICE; 49 // 盘后定价申报
5-16 enum_ETaskStatus : // 任务状态
TASK_STATUS_UNKNOWN : 0;//未知
TASK_STATUS_WAITING;//等待
TASK_STATUS_COMMITING;
TASK_STATUS_RUNNING;//执行中
TASK_STATUS_PAUSE;//暂停
TASK_STATUS_CANCELING_DEPRECATED;//撤销中
TASK_STATUS_EXCEPTION_CANCELING_DEPRECATED;//异常撤销中
TASK_STATUS_COMPLETED;//完成
TASK_STATUS_CANCELED;//已撤
TASK_STATUS_REJECTED;//打回
TASK_STATUS_EXCEPTION_CANCELED;//异常终止
TASK_STATUS_DROPPED;//放弃,目前用于组合交易中,放弃补单
TASK_STATUS_FORCE_CANCELED_DEPRECATED;//强制终止
这三节课其实有非常紧密的联系:
Coding Agents 帮助你更高效地编写代码,Code Quality 帮助你验证代码,Communication & Collaboration 帮助整个团队理解、审查和维护代码。
下面分别讲解技术原理、具体例子、实际使用方法以及课程练习。
Coding Agent 是一种能够使用外部工具完成编程任务的 AI 系统。
普通聊天 AI 通常主要通过对话提供解释和代码建议。
Coding Agent 除了生成文本,还可以在得到相应权限的情况下:
因此,它不只是告诉你如何修改代码,而是可以实际执行相关开发步骤。
| 能力 | 普通 AI 对话 | Coding Agent |
|---|---|---|
| 解释代码 | 可以 | 可以 |
| 生成代码 | 可以 | 可以 |
| 自动读取项目文件 | 取决于工具 | 通常支持 |
| 直接修改项目 | 取决于工具 | 通常支持 |
| 执行测试 | 需要执行工具 | 通常支持 |
| 根据报错迭代修复 | 需要反馈 | 可以通过工具循环完成 |
课程建议采用一个理解模型:
把 Coding Agent 想象成一名能力较强、但仍然需要指导和监督的初级工程师。
你负责告诉它目标、限制和验收标准,它负责执行具体任务,你则要检查结果。
这是课程最重要的技术原理。
传统 LLM(Large Language Model,大语言模型)主要根据输入上下文生成输出。
但 Coding Agent 在此基础上增加了一个负责执行工具调用的程序,教材称为 Agent Harness。
User Prompt
用户提出编程需求
LLM
分析上下文,生成下一步动作
Agent Harness(智能体运行框架)
文件读写
终端命令
运行测试
工具结果反馈给模型,继续分析和修正
例如,你告诉 Agent:
将这个 Python 脚本改造成命令行工具,使用 argparse 解析参数,添加类型注解,并确保类型检查通过。
Agent 可能执行这样的流程:
argparse。mypy 类型检查。这个过程最关键的地方,是 Feedback Loop(反馈循环)。
它不是只生成一段代码,而是利用真实的工具运行结果验证自己的工作。
Context Window(上下文窗口)指模型在一次推理中能够处理的上下文长度限制。
例如,一个项目可能包含:
project/
├── app.py
├── database.py
├── utils.py
├── tests/
├── docs/
└── README.md
如果 AI 同时读取大量文件、文档、终端输出和历史对话,就会消耗上下文容量。
这会带来两个问题:
因此,有效使用 Coding Agent,不只是写出好的 Prompt,还需要管理提供给它的上下文。
课程介绍了三种常见方法:
| 方法 | 含义 | 适用场景 |
|---|---|---|
| Clear Context | 开始新的对话 | 切换到完全不同的任务 |
| Rewind | 回退之前的对话步骤 | Agent 沿错误方向工作 |
| Compaction | 压缩已有对话信息 | 对话过长,需要保留重要上下文 |
这部分还有一个重要结论:
提供更多上下文不一定更好,提供准确且相关的上下文才更重要。
假设你有一个 Python 项目,需要增加 CSV 导出功能。
你可以要求 Agent:
在现有项目中增加导出 CSV 的功能。保留现有 API,增加单元测试,运行全部测试,并列出修改的文件。
这比简单要求“帮我写一个 CSV 函数”更完整。
因为你不仅告诉它要做什么,还明确了不能破坏什么,以及如何验收。
例如:
mypy .
报告:
error: Incompatible return value type
你可以要求 Agent 找出原因、修复问题,再重新运行 mypy。
这种能够自动运行检查工具的任务非常适合 Agent。
Refactoring 指在尽量保持外部行为不变的前提下,改善代码结构。
例如,将一个 500 行的 Python 文件拆分成:
project/
├── api.py
├── models.py
├── services.py
└── utils.py
Agent 可以帮助调整导入路径、函数位置以及相关测试。
但是必须验证重构没有破坏原有功能。
可以让 Agent 检查:
例如:
Review the changes since the last commit. Focus on correctness, security and missing tests.
但这不意味着 AI 的审查结果一定正确。它可能遗漏真实问题,也可能把正常代码误判为 Bug。
这对新加入项目的开发者尤其有用。
例如:
Explain how authentication works in this repository. Identify the main entry points and relevant files.
Agent 可以阅读相关文件,帮助你理解认证流程。
这比漫无目的地逐个阅读文件通常更高效。
教材还介绍了 Vibe Coding。
其含义是:开发者主要通过自然语言描述目标,由 AI 完成绝大部分实际代码编写。
这种方式适合快速原型和探索性项目,但对于长期维护的软件,开发者仍然需要理解代码、安全边界和测试结果。
这四个术语很容易混淆。
假设你的项目中有:
project/
├── AGENTS.md
├── src/
└── tests/
AGENTS.md 可以用于告诉兼容的 Coding Agent 如何在这个项目中工作。
例如:
# Project Instructions
- Use Python 3.12.
- Format code with Ruff.
- Run pytest after changing code.
- Do not modify generated files.
- Do not commit API keys.
它的作用类似于一份给 AI 开发者阅读的项目说明。
不同 Agent 对指令文件的名称、作用范围和加载规则可能不同。
AGENTS.md 一般用于项目级约定。
Skill 则可以把某项专门任务的操作方法单独封装。
例如:
skills/
└── code-review/
└── SKILL.md
里面可以说明:
Agent 在需要进行代码审查时,再按自身支持的机制加载对应的 Skill。
这样可以减少每次对话都加载大量无关指导信息的问题。
Subagent 是由主 Agent 调用、负责特定任务的智能体。
例如,主 Agent 正在实现新功能,同时可以将代码检查任务交给专门的子智能体。
Main Agent
负责整体开发任务
Code Agent
实现功能
Checking Agent
运行 mypy、ruff
教材提供的练习就是创建一个 Python Code Checking Subagent,使它能够:
mypy。ruff。MCP 是一种用于连接 AI 应用与外部工具或数据源的开放协议。
例如,Agent 可以通过支持的 MCP 服务访问文档或其他工作系统。
因此,它和前面的概念并不相同:
| 概念 | 主要解决的问题 |
|---|---|
| AGENTS.md | Agent 应当遵守哪些项目规则? |
| Skill | Agent 如何完成某类专门任务? |
| Subagent | 哪个专门 Agent 来完成子任务? |
| MCP | Agent 如何连接外部工具和数据源? |
教材还介绍了让多个 Agent 同时开发。
例如:
如果多个 Agent 直接修改同一工作目录,就可能发生冲突。
因此课程推荐结合 Git Worktree,为不同 Agent 提供相对独立的工作目录。
教材特别强调了几个风险:
第一,AI 可能产生错误代码。即使代码可以运行,也不代表它满足业务要求。
第二,AI 可能陷入调试循环。它不断尝试修改,但没有真正定位问题,甚至造成更多修改。
第三,隐私与安全。部分 Coding Agent 会把代码、上下文或工具结果传输给云端模型。使用前需要理解相关权限和数据处理方式。
第四,过度依赖。如果完全不理解生成的代码,短期看似节省了时间,长期却可能降低你独立开发和排查问题的能力。
因此,教材特别提醒:不要把允许 Agent 不经确认执行危险操作的模式当作日常默认配置。即使使用隔离容器或虚拟机,也必须考虑网络、文件挂载和凭证的安全边界。
这一节的核心不是“让 AI 替代程序员”,而是:
学会如何提出明确任务、提供正确上下文,并通过真实工具验证 AI 的工作结果。
这一节讨论一个非常实际的问题:
程序可以运行,是否意味着代码质量很好?
答案是否定的。
例如,下面两段 Python 代码在正常输入下可以产生相同结果:
def add(a,b):return a+b
def add(a: int, b: int) -> int: return a + b
第二段代码结构更清晰,而且具有类型注解。
但即使第二段代码写得很整洁,也不能证明它没有逻辑错误。
因此,课程介绍了一系列不同层次的质量保证工具:
Formatting、Linting、Testing、Pre-commit Hooks、Continuous Integration 和 Command Runners。
Formatting 是自动统一代码风格的过程。
例如,你写了:
def calculate(a,b): return a+b
格式化工具可以调整为:
def calculate(a, b): return a + b
通常可以自动处理:
常见工具包括:
| 语言 | 工具 |
|---|---|
| Python | Ruff Formatter、Black |
| JavaScript / TypeScript | Prettier |
| Go | gofmt |
| 多种文件格式 | Prettier 等 |
例如,Python 项目使用 Ruff:
ruff format .
就可以按照配置格式化项目。
还可以配置 IDE 在保存文件时自动格式化。
为什么这很重要?
假设一个团队有十个人,每个人都习惯不同的缩进、换行和引号方式。
代码审查时,就会出现大量无意义的格式变化。
统一格式的好处,是让程序员把注意力集中在真正重要的逻辑修改上。
Formatting 和 Linting 的区别非常重要。
Formatting 关注代码怎么写得整齐;Linting 关注代码中是否存在可疑或不合理的写法。
例如:
import osdef calculate(): x = 10 return 42
这里的 os 没有使用,x 也没有被使用。
代码能够运行,但存在没有必要的内容。
Linter 可能报告:
Unused import: os
Local variable x is assigned but never used
使用 Ruff:
ruff check .
可以运行规则检查。
某些可安全自动修复的问题可以使用:
ruff check --fix .
但是,不是所有 Lint 警告都意味着代码一定错误。
部分规则可能产生 False Positive(误报),而且自动修复仍需要检查结果。
| 工具 | 主要检查内容 | 示例 |
|---|---|---|
| Formatter | 格式与排版 | 空格、缩进、换行 |
| Linter | 可疑写法和代码规范 | 未使用变量、复杂条件 |
| Type Checker | 类型是否一致 | 函数返回 str 却声明为 int |
例如:
def get_age() -> int: return "twenty"
mypy 这类类型检查工具可以指出返回值与声明的类型不一致。
但类型检查通过,也不意味着程序逻辑一定正确。
教材还介绍了 Semgrep。
普通文本搜索主要匹配字符,而 Semgrep 可以根据程序语言结构搜索代码模式。
例如:
semgrep -l python \
-e "subprocess.Popen(..., shell=True, ...)"
它可以帮助找出符合特定调用模式的 Python 代码。
这种能力对于自定义安全检查、查找危险 API 用法和执行团队代码规则非常实用。
这是代码质量部分最重要的概念之一。
假设你写了:
def divide(a, b): return a / b
你手动运行:
print(divide(10, 2))
输出:
5.0
于是你认为程序正确。
但这只验证了一个输入组合。
例如:
divide(10, 0)
会发生什么?
它会抛出 ZeroDivisionError。
这不一定意味着实现错误,因为函数的设计可能本来就要求分母非零。但它说明,我们需要明确函数的预期行为并测试。
单元测试通常针对单个函数或较小的功能单元。
例如:
# calculator.pydef add(a: int, b: int) -> int: return a + b
使用 pytest:
# test_calculator.pyfrom calculator import adddef test_add(): assert add(2, 3) == 5def test_add_negative(): assert add(-2, 3) == 1
执行:
pytest
如果实现符合断言,测试就会通过。
assert 的意思是:断言后面的条件必须成立。
单元测试主要检查单个组件。
集成测试则关注多个组件协同工作时是否正常。
例如:
API
↓
Business Logic
↓
Database
一个 API 的业务逻辑可能完全正确,但数据库连接配置错误,导致整个功能不可用。
集成测试可以覆盖这种跨组件的问题。
端到端测试会从用户使用场景出发,测试一条较完整的业务流程。
例如,一个购物网站:
用户登录
↓
选择商品
↓
加入购物车
↓
提交订单
↓
确认结果
这类测试通常更接近用户实际使用系统的方式。
教材还介绍了:
例如,除法函数的一项性质是:
对于任意满足条件的数 a 和非零数 b:
[ (a/b)\times b\approx a ]
这里通常要考虑浮点数误差。
Property-Based Testing 工具可以根据这种性质生成大量不同的输入,而不局限于几个手写测试案例。
假设你有一个函数:
def classify(x): if x > 0: return "positive" elif x < 0: return "negative" else: return "zero"
你只测试:
classify(10)
虽然测试通过,但你并没有测试负数和零。
Code Coverage(代码覆盖率)用于衡量执行测试时,哪些代码被运行过。
假设某个项目的行覆盖率为 75%
75% 已执行
25% 未执行
使用 pytest-cov 可以生成覆盖率报告,例如:
pytest --cov=. --cov-report=html
然后查看 HTML 报告,找到哪些代码没有得到测试。
但是教材特别提醒:
高覆盖率不等于高质量测试。
假设一个测试只是调用函数,却完全不检查结果,那么它也可能提高覆盖率。
因此,比起盲目追求 100%,更重要的是测试关键行为、边界情况和错误处理是否正确。
你已经学过 Git,因此这一部分比较容易理解。
正常提交流程:
修改代码
↓
git add
↓
git commit
如果我们希望每次提交前都自动检查代码格式和 Lint 问题,就可以使用 Git Hook。
例如:
修改代码
↓
git add
↓
Pre-commit Checks
├── Formatter
├── Linter
└── Other Checks
↓
git commit
Pre-commit Hook 可以在提交前运行配置好的检查任务。
如果检查不通过,提交通常会被阻止,直到问题得到修复。
它主要解决:
防止不符合项目规范的代码轻易进入版本历史。
不过本地 Hook 可以被跳过,团队也不能假设每个人都正确安装了 Hook。
这就是为什么还需要 CI。
这是现代软件开发中非常重要的工程实践。
假设你的项目托管在 GitHub。
每次开发者提交代码或创建 Pull Request 时,CI 系统都可以自动运行检查。
Git Push / Pull Request
GitHub Actions (CI)
Format
Lint
Test
PASS
检查通过
FAIL
反馈错误
例如,一个 GitHub Actions 工作流可以写成:
name: Python CI
on: [push, pull_request]
jobs:
quality:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v4
- uses: actions/setup-python@v5
with:
python-version: "3.12"
- name: Install tools
run: python -m pip install ruff pytest
- name: Lint
run: ruff check .
- name: Format check
run: ruff format --check .
- name: Test
run: pytest
这是一个用于理解 CI 的简化示例。
它会在 push 或 Pull Request 事件发生时检查项目。
真实项目还需要根据依赖安装方式、测试配置和安全策略调整工作流。
例如,课程网站可以在提交代码后自动运行检查,再构建并部署到 GitHub Pages。
项目变大之后,开发者可能需要记住很多命令:
uv run ruff check .
uv run ruff format .
uv run pytest
uv run mypy .
教材介绍了 just 这样的 Command Runner。
你可以在项目中定义:
lint:
uv run ruff check .
format:
uv run ruff format .
test:
uv run pytest
然后执行:
just lint
just test
它的本质是:
给复杂或常用的项目命令提供统一、易记的入口。
这也能够降低新成员加入项目时的学习成本。
这部分虽然看起来与代码质量不同,但在代码搜索、日志分析和批量替换中非常实用。
Regex(Regular Expression,正则表达式)是一种描述文本匹配模式的语言。
例如:
abc
匹配字符串中的 abc。
\d+
匹配一个或多个数字。
\d{4}-\d{2}-\d{2}
匹配类似:
2026-01-14
的日期形式。
但注意,它同样可能匹配:
2026-01-99
因为这个正则表达式检查的是字符格式,而不是日期是否合法。
| 符号 | 意思 | 示例 |
|---|---|---|
. |
匹配一个字符 | a.c |
* |
前面的模式重复 0 次或多次 | a* |
+ |
前面的模式重复 1 次或多次 | a+ |
? |
前面的模式出现 0 次或 1 次 | a? |
\d |
数字字符 | \d{4} |
\w |
单词字符 | \w+ |
[abc] |
a、b、c 中的一个 | [abc] |
^ |
字符串或行的开头,取决于模式 | ^Hello |
$ |
字符串或行的结尾,取决于模式 | end$ |
(...) |
捕获分组 | (\d+) |
a\|b |
两个模式二选一 | cat\|dog |
假设你有一个日期:
2026-01-14
只想获取月份 01。
可以使用:
import retext = "2026-01-14"match = re.match( r"\d{4}-(\d{2})-\d{2}", text)print(match.group(1))
输出:
01
其中括号:
(\d{2})
表示捕获两位数字。
.group(1) 表示获取第一个捕获组的内容。
这是正则表达式中非常容易出错的地方。
假设字符串为:
"name": "Alice", "college": "MIT"
如果使用:
"name": "(.*)"
.* 默认是贪婪匹配,可能匹配尽可能长的内容,把后面的字段也包含进去。
而:
"name": "(.*?)"
使用非贪婪匹配,会尽量在第一个符合条件的位置停止。
但教材特别提醒:
对于 JSON、HTML 等具有复杂结构的数据,不应该依赖简单正则表达式进行完整解析。
例如,要提取 JSON 中的 name:
import jsondata = '{"name": "Alice", "college": "MIT"}'person = json.loads(data)print(person["name"])
这比尝试编写一个处理所有 JSON 转义情况的正则表达式更加可靠。
这一节与前面两节有所不同。
前两节主要讲技术工具,而这节课强调:
优秀的软件工程师不仅需要写出正确的代码,还要让其他人能够理解、审查、使用和维护这些代码。
课程开头提出了一个非常重要的原则:
记录和传达 Why(为什么),而不仅仅是 What(做了什么)。
因为代码通常已经能告诉别人“程序做了什么”,但往往无法告诉别人“当初为什么这样设计”。
先看一个没有太大价值的注释:
# Increase counter by onecounter += 1
这段注释几乎没有增加任何信息。
因为代码已经能够清楚表达它的行为。
再看另一种:
# Retry at most three times because the upstream# service rate-limits repeated failed requests.MAX_RETRIES = 3
第二段注释不仅解释了常量的含义,还解释了为什么选择这个值。
这就更有价值。
| 类型 | 应该解释什么 |
|---|---|
| TODO | 哪些工作尚未完成,为什么暂时没有做 |
| References | 算法、规范或实现依据来自哪里 |
| Correctness Arguments | 为什么这段复杂代码能够产生正确结果 |
| Hard-learned Lessons | 过去遇到过哪些不明显的问题 |
| Rationale for Constants | 某个固定数值为什么这样设置 |
| Load-bearing Choices | 哪些看似普通的实现细节不能随意修改 |
| Why not | 为什么没有使用一个看起来更简单的方案 |
例如:
# Do not replace this ordered collection# with a set: later processing depends# on preserving the original input order.
它不是在描述代码执行了什么,而是在提醒未来的维护者:
这里有一个容易被忽略的设计约束。
如果没有这段注释,其他程序员可能出于性能考虑将其替换为普通集合,从而意外改变程序行为。
这里还涉及一个非常重要的写作原则:
注释应该补充代码无法充分传达的信息,而不是重复代码。
README 通常是别人接触一个项目时看到的第一份文档。
教材建议 README 尽早回答四个问题:
注意它的顺序。
很多开发者习惯先写一大段安装教程。
但用户首先想知道的是:这个工具是否解决自己的问题。
例如,一个 Python CSV 清洗工具的 README 可以这样组织:
README.md 示例结构
CSV Cleaner
A command-line tool for cleaning duplicate rows in CSV files.
首先说明项目的用途
Why use it?
Remove duplicate rows automatically without manually editing spreadsheets.
解释项目的实际价值
Usage
csv-cleaner input.csv --output clean.csv
展示用户如何使用
Installation
pip install csv-cleaner
最后说明安装过程,命令仅作示例
一个好的 README 应该让用户能够快速判断项目是否适合自己,并在需要时找到详细信息。
你之前学过:
git commit -m "fix bug"
这虽然是有效命令,但提交信息的价值很低。
因为它没有解释:
教材推荐使用:
Problem → Solution → Implications
即:
问题 → 解决方案 → 影响
例如,假设系统中的付款请求偶尔被重复处理。
一个较好的提交信息可以写成:
Prevent duplicate payment processing
Problem:
Network retries may submit the same payment
request multiple times.
Solution:
Use an idempotency key to identify repeated
requests and reuse the existing result.
Implications:
Payment requests now require a stable
idempotency key from the caller.
这个提交信息不仅说明了修改内容,还解释了问题背景以及可能产生的影响。
这在几个月后调查历史问题时会非常有用。
教材还推荐将代码按照独立的逻辑变化组织成 Commit。
例如:
较好的提交组织
Commit A: Add user authentication
Commit B: Add authentication tests
Commit C: Update authentication docs
不理想的提交组织
Commit A: Fix login, update payment, rename files, format code, change README
把无关修改塞进同一个 Commit,会让代码审查和后续排查问题变得更加困难。
你之前学过的:
git add -p
就可以帮助你将文件中的不同修改块分开暂存,创建逻辑上更清晰的提交。
假设你发现某个软件有问题。
你提交了一个 Issue:
This doesn't work. Please fix it.
维护者很可能不知道问题发生在哪里。
课程建议,一个好的 Bug Report 至少应该说明:
例如:
Bug Report 示例
Title: CSV export fails when the input is empty
Environment
Python 3.12, Ubuntu 24.04, application v1.2.0
Expected Behavior
The command should produce an empty CSV file containing the header row.
Actual Behavior
The program raises an IndexError.
Steps to Reproduce
csv-cleaner input.csv --output result.csv.What I Tried
Tested with a non-empty CSV file; the problem did not occur.
这种报告让维护者更容易理解和复现问题。
这是软件工程中非常重要的能力。
假设你的程序有 10,000 行代码,某个功能发生异常。
你可以尝试将导致错误的代码逐渐简化:
10,000 行项目
↓
500 行相关模块
↓
50 行相关逻辑
↓
10 行最小复现代码
最终得到一个只包含问题核心的示例。
这样的示例非常有价值,因为它可以排除不相关因素,帮助维护者快速定位错误。
有时你在缩小问题范围的过程中,就会自己发现根本原因。
Pull Request(PR)是 GitHub 等平台中常见的协作机制。
它让开发者提出代码修改,并邀请维护者审查、讨论和合并。
一个典型的工作流程是:
1
2
建立开发分支
3
实现一个明确的修改
4
运行格式检查与测试
5
创建 Pull Request
6
进行 Code Review
7
根据反馈修改并合并
教材建议你在提交 PR 前,先确认项目是否已有类似的 Issue 或正在进行的工作。
还要尽量控制 PR 的范围,不要为了实现一个小功能而同时修改大量无关文件。
一个好的 PR 描述不仅要说明修改了什么,还要解释:
为什么需要这个修改,以及为什么当前实现值得被项目接受。
维护者需要长期承担代码维护责任,因此合理的技术方案也可能因为维护成本过高或不符合项目方向而被拒绝。
Code Review 不只是寻找 Bug。
它还帮助团队共享知识、发现不合理的设计以及提高代码可维护性。
教材提出了几个很实用的原则。
评价代码,而不是评价程序员。
不理想:
You wrote confusing code.
更好的方式:
This function is difficult to follow. Could we split validation and processing into separate functions?
第二种表达更加聚焦于问题,也更容易推动改进。
评论应该尽量可执行。
例如:
不理想:
Don't use globals.
更好的方式:
Could we replace these global variables with a configuration object to make testing easier?
并不是所有 Review Comment 都应该阻止 PR 合并。
例如:
Blocking Issue:
一个身份验证函数允许未授权用户访问数据。
这是需要优先解决的正确性和安全问题。
Suggestion:
某个变量名可以更清楚。
这是可以讨论的改进建议,不一定需要阻止合并。
代码审查需要关注重要问题。
如果审查者不断纠结无关紧要的排版细节,会消耗开发者和维护者的时间。
这也是前面为什么需要 Formatter:机器可以自动处理的问题,就没有必要让人工 Review 占用大量时间。
教材引用了 Julia Evans 关于如何提问的建议。
其中最重要的技巧是:
先说明你的理解,再指出你不理解的具体部分。
例如:
不理想:
I don't understand Docker.
更好的问题:
My understanding is that Docker containers share the host kernel, while virtual machines have their own guest OS. Does that mean Docker containers cannot run a different kernel from the host?
第二个问题更加具体。
回答者能够直接看出你已经理解了什么,以及需要澄清什么。
同样,提问时还应该尽量说明自己尝试了什么,以及遇到了怎样的结果。
这不仅适用于人与人之间的沟通,也适用于向 AI 提问。
教材最后讨论了 AI 在软件工程中的使用规范。
它强调:
当 AI 对你的工作有实质性贡献时,应该按照项目或组织的规则披露 AI 的使用情况。
例如:
这几种情况并不相同。
教材还提醒,如果公司或团队对数据隐私、合规、代码生成以及 AI 使用有特殊要求,开发者应该遵守相关政策。
在考试、技术面试等考核情境中,也需要遵守明确的工具使用规则。
AI 可以帮助你提高效率,但不能代替你对代码正确性和工程责任的判断。
我们用一个具体项目,把三份课程材料连接起来。
假设你准备开发一个 Python 命令行工具:
CSV Cleaner:自动删除 CSV 文件中的重复记录。
你向 Coding Agent 提出任务:
Create a Python CLI that reads a CSV file, removes duplicate rows, and writes the cleaned data to a new file. Use argparse for command-line arguments, include type annotations, and add unit tests. Do not overwrite the input file.
Agent 可以阅读文件、创建程序、编写测试,并尝试执行检查。
代码生成后,你运行:
ruff format .
ruff check .
mypy .
pytest
分别检查代码格式、潜在问题、类型一致性和功能正确性。
接下来通过 Pre-commit Hook 和 GitHub Actions 自动运行这些检查。
这样,即使 AI 修改了代码,也必须经过相同的质量验证流程。
你创建清晰的提交记录:
git add .
git commit -m "Add CSV deduplication CLI"
编写 README,说明工具用途、使用方法和安装方法。
然后创建 Pull Request,向审查者说明:
项目解决了什么问题、采用了什么实现方式、如何测试,以及是否存在已知限制。
完整的软件工程工作流
需求与验收标准
明确什么才算完成
Coding Agent + Developer
生成、理解、修改代码
Formatter + Linter + Type Checker + Tests
自动验证代码质量
Git Commit + Pull Request
记录修改目的和技术决策
CI + Human Code Review
自动检查与人工判断,共同决定能否合并
这三个部分共同构成了现代软件工程实践的核心。
三份教材包含了很多练习。如果你刚开始学习,我建议先完成下面这些具有代表性的任务。
综合学习任务
0/8 已完成
用 Coding Agent 完成一个小功能
让 AI 修改一个 Python 程序,并观察它如何读取文件、运行命令和修复错误。
创建 Agent 项目指导文件
编写 AGENTS.md,规定代码风格、测试命令和禁止修改的文件,测试 Agent 是否遵守。
配置 Ruff 和 pytest
让一个 Python 项目具备代码格式化、静态分析和单元测试。
练习覆盖率分析
执行带覆盖率的测试,找出未覆盖代码,并为关键情况补充测试。
配置 GitHub Actions
在 Push 和 Pull Request 时自动运行格式检查、Lint 和测试。
练习正则表达式
使用捕获组提取日期月份,比较贪婪与非贪婪匹配,再用 JSON 解析器处理结构化数据。
编写 README 和 Commit Message
说明项目用途、使用方法,并在提交说明中解释 Problem、Solution 和 Implications。
进行一次 Code Review
审查一份真实或练习用的 PR,区分 Blocking Issues 与 Suggestions,并提出可执行的反馈。
| 课程 | 最值得记住的原则 |
|---|---|
| Coding Agents | AI 可以执行编程任务,但必须有明确目标、合适上下文和结果验证 |
| Code Quality | Formatter、Linter、Type Checker、Tests 和 CI 解决不同层次的代码质量问题 |
| Communication & Collaboration | 优秀的技术沟通应该解释 Why,让其他人理解和长期维护你的工作 |
最终需要建立的思维方式是:
不要只是追求把代码写出来,而是要确保代码符合需求、经过验证、容易理解,并能够由其他工程师继续维护。
这三节课真正教给你的,就是如何从“会写程序的人”逐渐成长为“能够可靠交付软件的工程师”。
本次访谈主要是一场关于 Google AI 战略、技术发展和基础设施投资的访谈,而不是一场全面讨论 AI 社会经济影响的访谈。
文章涵盖的主要主题:
说明:当前版本是经过 AI 结构重组的访谈文章,不是逐句逐字翻译稿。它保留了主要论点、案例和关键数字,但不能保证满
足「所有内容均不遗漏」这一严格要求。
根据访谈字幕整理为第一人称叙述。文中的“我”指 Google CEO Sundar Pichai;主持人的提问以少量问题标题呈现,主体保留为我的回答与观点。已对自动字幕中的重复、口误和明显识别错误作必要的语义整理。模型名称及个别专有名词按字幕保留;字幕无法可靠辨认之处不擅自补全。
我们来玩一个游戏:
扔硬币,如果扔出的是正面则重复扔硬币,直到扔出反面为止,一次游戏结束。一次游戏的奖金是根据扔硬币的次数决定的,即:
如果第 1 次就扔出反面,奖金 2 块;
如果第 2 次才扔出反面,奖金 4 块;
...
如果第 n 次才扔出反面,奖金 2^n;
问:你最多愿意每次花多少钱玩这个游戏?
很显然,这个游戏的期望是
E = 2*(1/2) + 4*(1/2)(1/2) + ... + 2^n(1/2)^n + ...
= 1 + 1 + 1 + ...
= ∞
所以理论上我们花费任意有限的价格去参与游戏应该都是划算的。但是,这个结论明显与人们的直觉相悖。事实上,现实中几乎没有人愿意花费 20 以上的价格去玩这个游戏,更不用说花费任意有限的价格了。
然而,在现实中人们精力有限、生命有限,只能进行有限次游戏。这时,使用基于“无限次”游戏假设计算出的“期望值”来进行决策,是否会存在问题呢?
我们再仔细观察一下游戏的规则,发现无穷大的期望,来自于在时间的无穷远方,将一个高阶无穷大的奖励压缩进了一个无穷小的概率。对任何现实中的人来说,高阶无穷大和无穷大没有什么区别,因此没有人能够拿到最终的这个所谓无穷大的收益。
这使我们不得不反思,延迟满足是否总是那么行之有效?如果把一个超级巨大的奖励放在一个非常漫长的延时之后,真的会有人实现吗?延迟满足在此时真的还有意义吗?
我又想到了强化学习中的 Q-learning,距离当前时刻越近,所得到的 reward 越高(我没有仔细研究过 RL,不清楚是否大部分的 reward 都是这么设置的)。这看起来也很有道理:在实现一个目标的开始阶段,你得到的 reward 越高,你越可能保持在正确的道路上。而如果是越往后 reward 越高,你更有可能在开始阶段走了一条奇怪的路子摆烂,直到最后一步,虽然 reward 奇大无比,但是你因为开始偏离得太多,几乎完全不可能得到这个 reward 了。
所以我在想,也许我们应该给自己在更近的阶段设置更多的奖励,我们才能 keep motivated,而不是把一个巨大的奖励藏在无穷远处,画饼充饥。延迟满足并不总是有效,因为人的生命与精力并不是无穷的。一味欺骗自己、麻痹自己,相信那个无穷远处的高阶无穷大奖励,恰恰是不理性的,反而容易让人堕入虚无的深渊。


