《System design interview》随缘记录帖
最近在 x 上看到有朋友推了这本书,然后和另一位快手 + 腾讯爷聊的时候发现他对此书也十分推崇。因此计划在休息的时候随缘看看,有困惑/想法在此记录
看起来是讲分布式数据库的设计理念的
Chapter 1: 可靠性、可伸缩性和可维护性
互联网如此鬼斧神工,常常使人忘记这是人造产物。
OS 课中我们学过,任务分为:计算密集型和 IO 密集型。如今很多应用程序都是 数据密集型(data-intensive) ,而非 计算密集型(compute-intensive),因此我们必须对数据的处理进行优雅的设计。
可靠性
可靠性(Reliability): 在出现问题时,也能完成预期工作。
- 造成错误的原因叫做 故障(fault) ,能预料并应对故障的系统特性可称为 (一定范围内的)容错(limited-fault-tolerant) 或 回弹性(resilient) 。
- 故障(fault) 不同于 失效(failure), 故障 通常定义为系统的一部分状态偏离其标准,而 失效 则是系统作为一个整体停止向用户提供服务。
- 我们的目的是:即使发生 fault,但不至于 failure。可以通过“主动”fault 来测试系统的稳健性,进而进行提升。
- 硬件故障、软件错误、人为错误。(更全面的硬件支持,更严格的软件工程……)
可伸缩性
可伸缩性(Scalability): 描述系统应对负载增长的能力。
考虑 twitter 的两个业务:
- 发布推文:用户可以向其粉丝发布新消息(平均 4.6k 请求 / 秒,峰值超过 12k 请求 / 秒)。
- 主页时间线:用户可以查阅他们关注的人发布的推文(300k 请求 / 秒)。
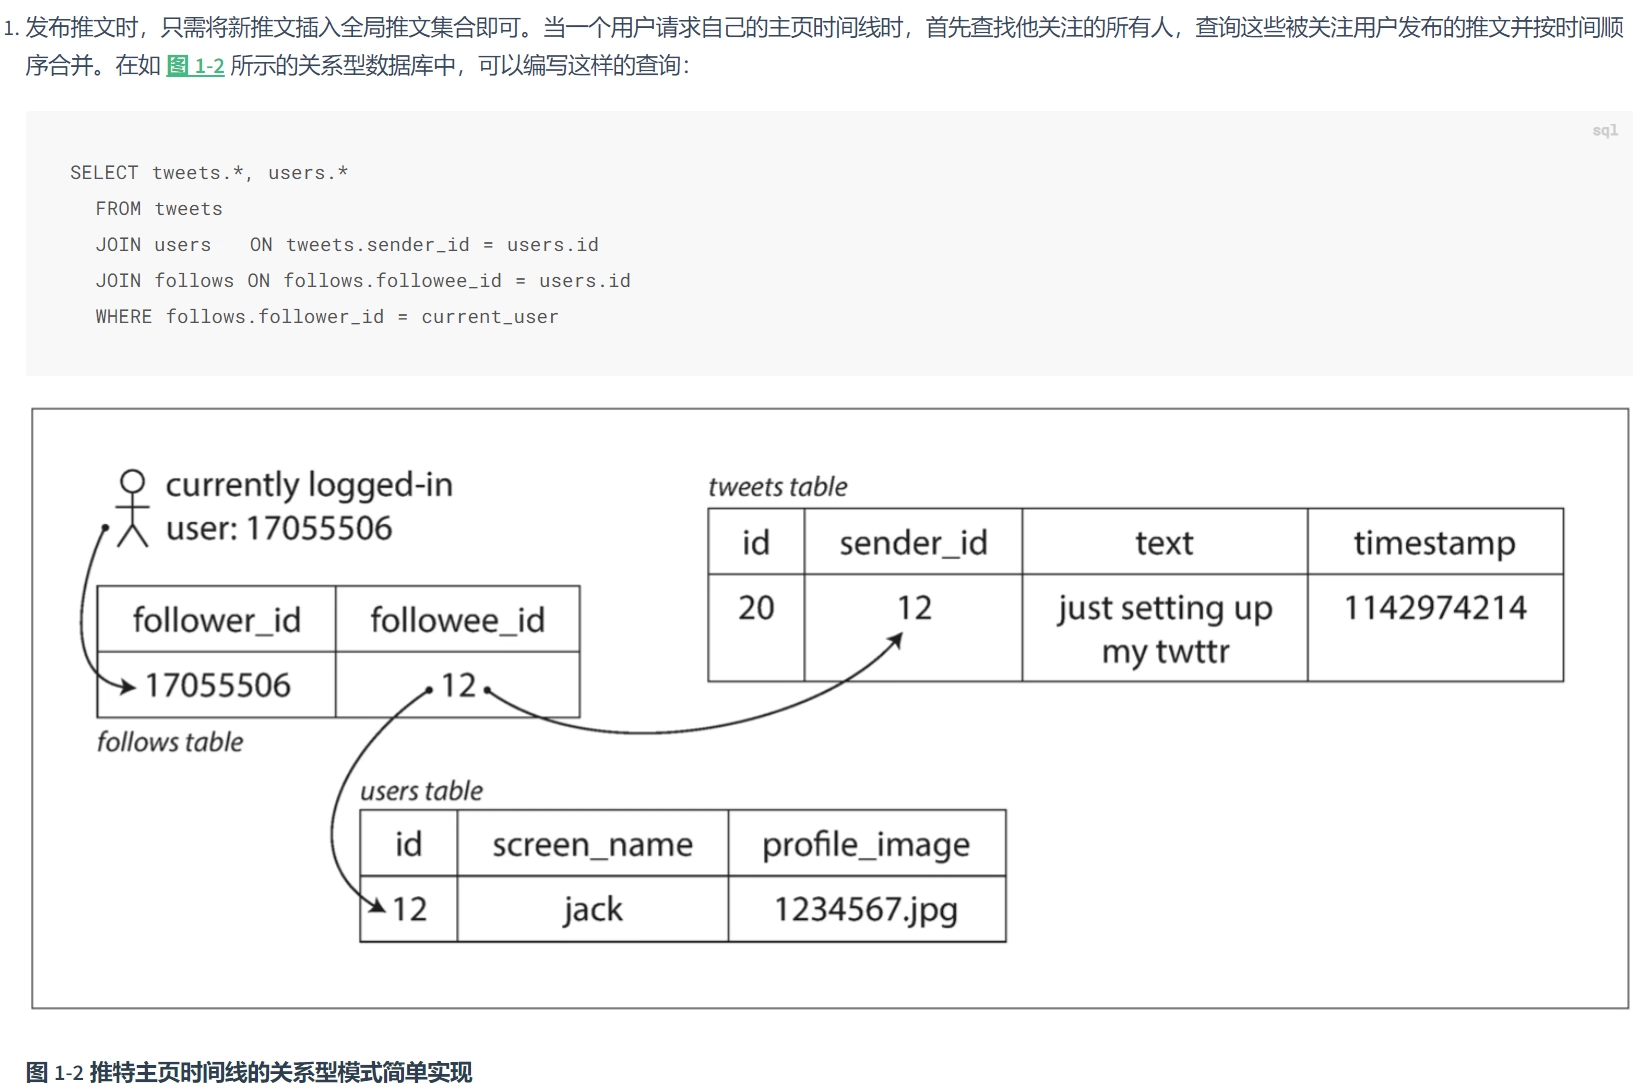
方法一 该方法面对大量主页时间线会难以维系效率。
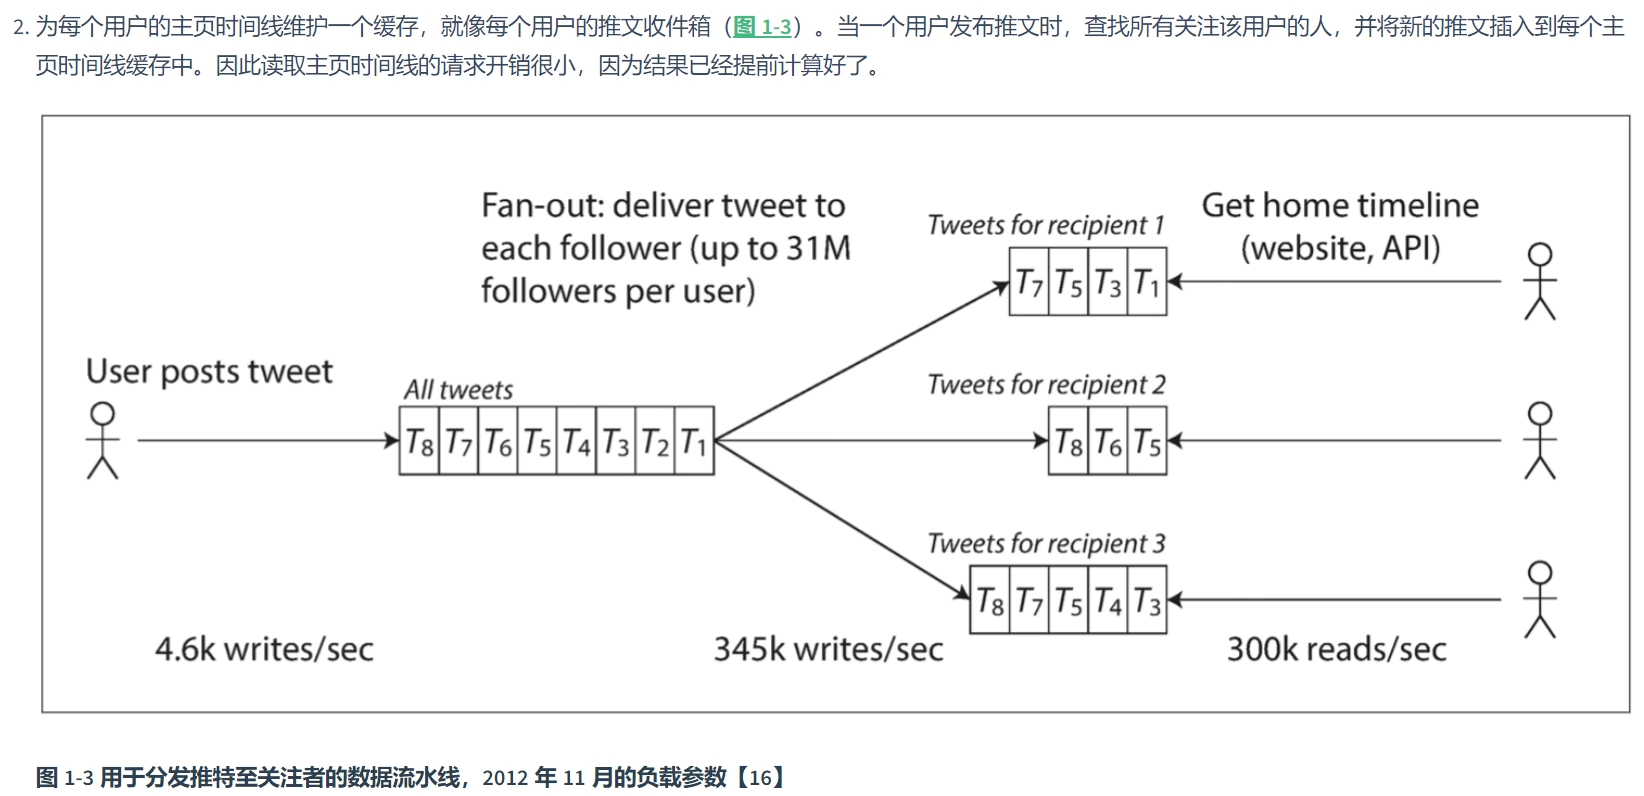
方法二 类似于读写的解耦,读的需求量远远高于写,并且需要在实际中和方法一相互结合,以避免头部博主一篇推文能产生百万、千万甚至更高次数的请求。。
延迟与响应时间
- 响应时间(response time) 是客户所看到的,除处理请求的时间( 服务时间(service time) )外,还包括网络延迟和排队延迟的时间。
- 延迟(latency) 是某个请求等待处理的 持续时长 ,在此期间它处于 休眠(latent) 状态,并等待服务。
性能评价
一般使用百分位点。例如响应时间中位数是 200 毫秒,这意味着一半请求的返回时间少于 200 毫秒,另一半比这个要长。
当一个请求需要多个后端请求时,单个后端慢请求就会拖慢整个终端用户的请求
可维护性
我们总是听到“屎山代码”,但我连屎山也不会写。
为了避免自己的软件系统变成遗留系统,我们特别关注软件系统的三个设计原则:
- 可操作性(Operability)便于运维团队保持系统平稳运行。
- 简单性(Simplicity)从系统中消除尽可能多的 复杂度(complexity),使新工程师也能轻松理解系统(注意这和用户接口的简单性不一样)。
- 可演化性(evolvability)使工程师在未来能轻松地对系统进行更改,当需求变化时为新应用场景做适配。也称为 可扩展性(extensibility)、可修改性(modifiability) 或 可塑性(plasticity)。
简化系统并不一定意味着减少功能;也可以意味消除 额外(accidental) 的复杂度(因实现方式的落后导致的复杂)。消除 额外复杂度 的最好工具之一是 抽象(abstraction) 。
Chapter2: 数据模型与查询语言
人的想象永远无法挣脱认知的局限
数据模型影响软件的构建方式,也影响问题解决的思考方式。
关系模型与文档模型
关系模型:数据被组织成关系(Table),每个关系是元组(Tuple,Row)的无序集合。
对象关系不匹配
面向对象(OOP)的编程语言被广泛用于应用开发,但是这与 SQL 数据模型之间存在转换的困难,需要引入额外的转换层。
例如,我们可以使用多个表来存储一份简历中会涉及到的内容,如 Position、Education 等,但是实际上对于这样的文档,使用 json 来存储十分方便,它相对于多表模式存在更好的局部性(locality)。
多对一和多对多的关系
有些属性我们并不会选择使用纯文本字符来存储,而是以 ID 来记录。二者的权衡是一个副本(Duplication)问题,ID 信息对人类无意义,但在数据库中有关系映射;文本信息则在每处都对人类有意义。
但是 ID 好处在于永远不需要改变,我们只需要更新其所映射的内容,即可自动更新所有信息,而文本信息则需要对所有的副本进行更改,这难免会产生遗漏,进而产生不一致风险。(去除这样的重复是数据库规范化思想之一,是三大范式的第?范式(忘记了))
在表示多对一和多对多的关系时,关系数据库和文档数据库并没有根本的不同:在这两种情况下,相关项目都被一个唯一的标识符引用,这个标识符在关系模型中被称为外键,在文档模型中称为文档引用
对高度关联的数据而言,文档模型是极其糟糕的,关系模型是可以接受的,而选用图形模型(后文会讲)是最自然的。
文档模型中的模式灵活性
文档数据库有时称为无模式(schemaless),但这具有误导性,因为读取数据的代码通常假定某种结构 —— 即存在隐式模式,但不由数据库强制执行。更精确的术语是读时模式(schema-on-read,数据的结构只在数据被读取时才被解释),相应的是写时模式(schema-on-write,传统的关系数据库方法中,模式明确,且数据库确保所有的数据都符合其模式)。读时模式类似于编程语言中的动态(运行时)类型检查,而写时模式类似于静态(编译时)类型检查。
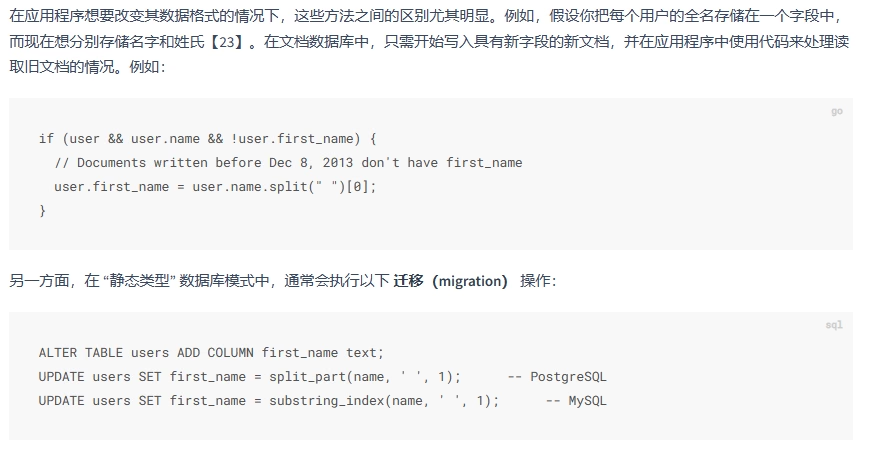
MySQL 在执行 ALTER TABLE 时会复制整个表,这可能意味着在更改一个大型表时会花费几分钟甚至几个小时的停机时间。大型表运行 UPDATE 是一个巨大的开销,我们可以使用读取时填充的策略,类似于第一章中,仅在需要时拉取信息。
数据查询语言
SQL
Web 上的声明查询
在 Web 浏览器中,使用声明式 CSS 样式比使用 JavaScript 命令式地操作样式要好得多。类似的,在数据库中,使用 SQL 这样的声明式查询语言比使用命令式查询 API 要好得多。
图数据模型
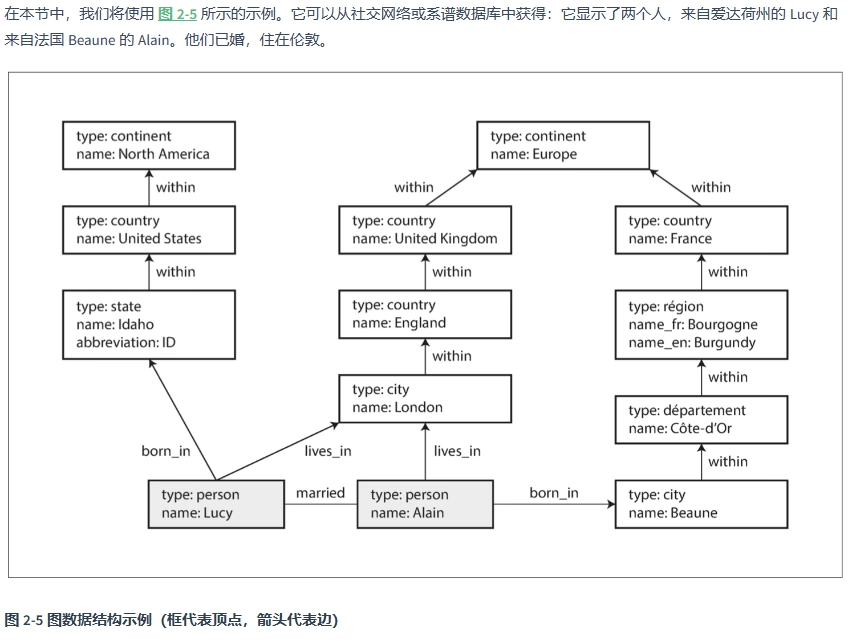
一个图由两种对象组成:顶点(vertices,也称为节点,即 nodes,或实体,即 entities),和边(edges,也称为关系,即 relationships,或弧,即 arcs)。
TODO
感觉直接读这个对我还是有点难,先读一些基础的相关书籍:
《System Design Interview》Chapter One Review
 rotartsinimdA
Chapter Two: Back-Of-The-Envelope Estimation
rotartsinimdA Chapter Three: A Framework for System Design Interviews
这个书很好,我最近也在读
 Anonymous Coward Old
得看原版 翻译版太抽象了…………
rotartsinimdA 我英文不好,得靠 Google translate
Anonymous Coward Old 我也差不多 但是直接看汉语版会麻。。
我英文看不懂导致的困意也不如我看汉语版看得迷迷糊糊产生的困意足。。
rotartsinimdA 翻译长篇文字就是很难,得兼具文字和技术素养才能译得好,所以译本这东西良莠不齐实在正常。华章系列里不是也有译得不好的吗。
 greyishsong
是的😭
ddia 这一版译文的主要问题在于用语过于生涩,加上本身这玩意没几句就要蹦出来几个术语,buff 叠满了非常累。另一方面,通篇指针满天飞,初读连自动解引用都难,更别提想理解就必须解引用强制多态了 😇
Chapter four: Design A Rate Limiter
Chapter Five: Design Consistent Hashing