- Ssola Post #221
那么下面来谈谈我自己。这两年吧,两年的时间其实还蛮长的。这可能也是村里的书记和驻村领导反复强调的原因。村里已经是我第二个家了。毕竟还是那句土土的话,人生又能有几个两年。而且村里不管是工作强度还是人际关系,都会比单位简单很多。
所以说,这里也是。我觉得我们初入职场,然后职位被派到村里来,是比后面几届先在单位干了一年,然后再派到村里工作会很幸运的。至少,于我而言。他成为了一个衔接好从学生向公务员转变的这样一个台阶。
一方面,在情感上我们会真的看到一些群众发自内心的,对于党、政府的信任和热爱。从大学里边出来,尤其我硕士是在境外读的,难免有一些天然的反权威、反建制的想法。但是当你深入到基层之后,会发现也有在我们传统意义上的不带贬义的基本盘,真的在这里。这两年不知道见了多少,不管是逢中秋、国庆、春节去慰问村里的老人、困难群众,还是说一些群众来村里去办事,听了很多遍,“共产党万岁呀!”“这是中华上下五千年来最幸福的日子呀!”“包括感谢共产党呀,这样的话”。之前也提到过,有的村民现在还在管村委会叫大队,感觉一些东西还是深深的扎根在村民心里的。有可能在机关里待久了,会逐渐忘记这种事情,而是反而去沉浸于书山会海之中,然后真正忘了初心是什么。
另外一方面,对我自己的职业发展而言,也是一个很好的开始,逐渐褪去了一些过分较真和过分压榨自己的想法,基层是个大染缸嘛,虽然这个方向可能并不是领导想要的,在市里可能还不会有感觉,但到了村里会明显发觉到很多上级的指示政策是不顾基层实况的,是在逼着基层去造假,去糊弄。所以说,对于整个公务员的工作,也会有祛魅吧,就是觉得还是要抓住主要的矛盾。然后,对一些细枝末节的,明显是领导为了自己的一些个人目的,或者说明显这个政策在制定之初就已经做歪了,这种情况是可以适当的糊弄一下,不会再像之前那么较真,为了自己反而没有很多的成果。
整体来说,我觉得还是有很大用的。
- Ssola Post #220
报告同志们一个好消息:我顺利从村里结业了。上周,我们刚刚完成基层锻炼最后的考核与评价。最近看到朋友圈里一些选调生同事在发总结两年驻村生涯的内容,我突然想到,自己还有一个断更在一半的驻村日志留在这里,于是决定还是交代一下比较好。
首先必须承认,持续更新这样一份日志确实有一定困难。最开始,其实只是为了应付组织部检查。组织部在驻村之前就明确告诉我们,考核时会考察工作日志,也就是大致记录每天或每周做了什么(虽然最后其实也没有查)。但无论如何,也是因为种种原因,并且看到当今很多同学逐渐倾向于选择公务员作为职业,所以开了这样一个帖子。第一年写工作总结、工作日志时,这个帖子帮了我很多。别人都在苦思冥想当时干了什么时,我直接找 AI 写了一个插件,把整个帖子下载下来,再总结一下,就成了我第一年的工作总结。第二年,我在群里和大家闲聊比较多,于是也找工具把部分群聊记录整理了一下,其实也还能看,只是有时会出现讨论偷闲技巧之类奇奇怪怪的内容。
总体回看,驻村两年的心态变化还是很大的。第一年,我还是很希望能在村里做一些事情。但后来发现,尤其在我所在的城市——相对比较发达、上级资金比较充足、领导思维也比较开放——其实能做的事情不多。因为很多事情要么前人已经做过,要么国家已有政策兜底,留给我们施展的空间不大。因此,在同事群体中也出现了两种取向:一种是像我这样躺得比较平的。这两年,我尽量利用周末时间出游。村里管理相对宽松,可以大致翘掉周五下午或周一上午,用周末做短途出游。两年下来,我基本跑遍了黑河—腾冲一线以东的省份,也把一直想逛的一些景点逛完了。虽然现在觉得,如果再给我机会,我还能再逛两年,因为今年突然解锁了自驾游的乐趣,在青甘、川西、东北环线疯狂跑。另一种,是有的同事从比较小的着力点出发去服务群众,或者真正尝试把自己的一个想法推进成事业。
这里我举几个让我印象深刻的例子。前一阵,全区举办选调生课堂,安排我们到各个镇走动,也邀请了一些选调生做分享。其中有些案例让我觉得,原来在我专注于自己心态稳定的这两年,也有一些同事找到了自己擅长或喜欢的点,真正为村里做了一些实事。
第一个是我们镇的一位同事。他关注的是部分宅基地产权不明的问题,而他正好来自自然资源局。于是,他协调单位里比较懂政策的同事,用两年时间一户一户了解宅基地的历史沿革问题,包括去档案堆里翻当时的档案材料,帮助村里几十户村民从“只有房子但没有产权证”的状态,真正拿到了红彤彤的产权证。前两天看到他分享的感悟,我还是觉得,真正找到这么一个点,并且刚好自己有能力去做,还是蛮不容易的。
第二个是我们北边的一个镇。他们是全区最穷的镇,产业还是以农业为主,所以也走的是老一套,去搞农业产业化。当时我们也考虑过搞一些品牌化的东西,我们镇也有一些在全国叫得出名的品牌,但考虑到各种现实因素:一方面我们产业经验不足,和村里人相比并没有什么优势;另一方面全国都在搞,我们也去搞,反而会有一种跟风、吃不上热乎的感觉,所以没有去搞。但他们刚好有政府派出的产业村官帮助,相当于多方协力,共同推进了一个产业化。虽然产值可能不会特别高,产品的主要客户还是本地企业,相当于政府通过议价、工会购买福利的方式帮他们把产品消化掉,但整个品牌还是有声有色的。
第三个是我的一个硕士同学。他虽然官味儿有点重(),但不可否认,不管于公于私——是为了自己后面升职过程中说自己在村里做过一些非常有实际意义的事,还是真正为了村里——他的成果确实无可辩驳。他联系了我们硕士的另一位同学,由那位同学引入一些社会力量,帮助他把整个乡村的农文旅打通了。前几年,最开始那位同学刚到他们村时,还请我一起过去参观,我当时以为只是单纯同学间的联谊,但后来他们两个人确实有了深度合作。我外地的那位同学据说一年时间里来了村里 22 次,大概有一半时间都在村里发掘村里的故事和文旅特色,共同把整个村的文旅产业搞起来了。虽然也是现在常见的乡村农文旅旺丁不旺财的困境吧。但是,这位同学巧妙地引入了一些涉及统战方面的价值,然后使得整个工作成果还是挺突出的。
- ZZethes Post #1
通用目的技术:从蒸汽机、电力到人工智能的经济增长逻辑
引言:为什么少数技术能够改变整个经济体系?
回顾人类经济发展的历史,我认为有一个非常值得关注的现象:真正推动经济长期增长的,并不总是数量最多的技术发明,而是少数能够被广泛应用、持续改进,并不断催生其他创新的关键技术。蒸汽机、电动机、半导体、计算机和互联网,都具有这样的特征。这些技术的影响远远超出了它们最初出现的行业,逐渐渗透到制造业、交通运输、金融、医疗、教育和社会生活的各个领域,最终改变整个经济体系的生产方式。
经济学将这类技术称为通用目的技术(General-Purpose Technology,GPT)。Timothy F. Bresnahan 和 Manuel Trajtenberg 在 1992 年发表的工作论文《General Purpose Technologies: Engines of Growth?》中,系统提出了这一概念,并试图解释为什么少数关键技术能够成为经济增长的长期动力。他们指出,技术进步并不是一个可以简单归结为生产函数中某个残差项的过程。不同技术的经济意义存在巨大差异,有些技术只是改善某一类产品,而另一些技术则能够成为大量产业的共同投入,改变其他行业进行研发、生产和创新的方式。
我理解的 GPT,最重要的地方并不在于它本身有多先进,而在于它能够形成一个持续扩大的创新体系。一项基础技术不断进步,使更多下游行业能够以更低的成本、更高的效率使用它;下游行业在应用过程中又会产生新的产品、生产流程和技术需求,这些需求反过来推动基础技术继续升级。由此,技术创新不再是孤立事件,而是形成一个跨行业、跨组织、跨时间的正反馈过程。
蒸汽机最初解决的是动力问题,电动机解决的是动力供应的灵活性问题,半导体和计算机则让数字化计算成为几乎所有行业都能够使用的基础能力。今天,人工智能正在进入一个类似的阶段:它不只是提高某些任务的效率,还可能改变研发、知识生产、企业组织、公共服务和产业协作的基本方式。
因此,我认为理解人工智能的经济影响,不能只研究模型性能提升了多少、企业采用率有多高,或者某些工作岗位是否会被自动化。更重要的是理解它是否具备通用目的技术的基本特征,是否能够产生足够多的互补性创新,以及这些创新能否最终转化为全社会范围内的生产率提升。
通用目的技术究竟具备哪些特征?
通用目的技术不是简单意义上的重大技术发明
Bresnahan 和 Trajtenberg 对 GPT 的定义包含三个核心特征:广泛渗透性(Pervasiveness)、持续的技术改进潜力(Inherent Potential for Technical Improvement),以及创新互补性(Innovational Complementarities)。这三个特征共同决定了一项技术能否从局部应用工具发展为整个经济体系的增长引擎。
第一,广泛渗透性意味着这项技术能够被大量不同的下游行业使用。这里的广泛,并不只是指使用人数多或者市场规模大,而是指它能够进入性质完全不同的生产活动,成为各种产品、服务和生产系统的共同投入。例如,电动机可以用于纺织、冶金、食品加工和交通运输;半导体既可以进入计算机,也可以进入汽车、医疗设备、通信系统和工业控制设备。不同应用行业之间可能不存在直接联系,但它们都能够使用同一种基础技术。
第二,持续改进潜力意味着技术本身并不是一个固定不变的产品,而是能够通过持续研发、工程改进、生产学习和科学突破不断提升性能。技术进步可以表现为价格与性能比的改善,也可以表现为可靠性、速度、精度、容量、能耗和其他质量维度的提升。随着基础技术越来越便宜、越来越可靠,原来无法负担或者没有经济价值的应用开始变得可行,更多行业因此加入使用者行列。
第三,也是最重要的,是创新互补性。它意味着基础技术的进步能够提高下游行业开展研发和技术创新的回报;反过来,下游行业的技术进步也能够扩大基础技术的市场需求,促使基础技术提供者继续投资研发。基础技术和应用行业之间因此形成相互促进的关系,而不是简单的上下游采购关系。
这三个特征共同产生一种特殊的规模报酬现象。随着技术性能提升、使用行业扩大以及互补创新增加,整个技术体系能够获得超过单项技术改进本身的经济收益。Bresnahan 和 Trajtenberg 将这种机制视为通用目的技术能够推动长期经济增长的重要原因。
技术的通用性来自底层功能,而不是表面上的应用相似性
Bresnahan 和 Trajtenberg 提出,可以把某一时期的技术体系理解为一棵具有层级结构的技术树。最上层是少数基础技术,它们执行某种具有普遍价值的通用功能;下层则是大量使用这些基础技术的产品类别、生产系统和应用行业。
例如,蒸汽机和电动机的通用功能是提供连续旋转运动(Continuous Rotary Motion)。从表面上看,纺织、切割、抛光、金属加工和交通运输属于完全不同的生产活动,但这些活动都可以通过动力驱动的机械设备完成。因此,当连续旋转运动能够以更低的成本、更高的可靠性和更好的性能提供时,许多原本没有明显机械化可能性的工作也会逐渐发生改变。
半导体技术对应的基础功能则是二进制逻辑(Binary Logic)。传统手表、洗衣机、汽车发动机、计算机和医疗设备的工作过程虽然各不相同,但都可以拆解为一系列将输入转化为目标输出的步骤。其中相当多的步骤可以通过二进制逻辑电路实现。由此,表面上差异巨大的产品和生产方式,实际上可以共享少数底层技术原理。
我认为,这种底层功能的一致性非常重要。它解释了为什么某些技术能够不断进入新的产业,也解释了为什么技术扩散往往会产生超出最初预期的经济影响。人们在一项技术出现时,通常只能看到已经明确的应用场景,却很难预见它最终会覆盖多少行业。
通用目的技术与发明方法的发明并不是同一个概念
在研究工业革命和人工智能时,我认为还需要区分两个经常被混淆的概念:通用目的技术,以及发明方法的发明(Invention of a Method of Invention,IMI)。
通用目的技术提高的是商品和服务的生产效率;发明方法的发明提高的则是创造新知识、新技术和新想法的效率。两者可能同时存在于同一项技术中,但并不是必然关系。
Nicholas Crafts 在 2021 年的论文《Artificial Intelligence as a General-Purpose Technology: An Historical Perspective》中,引用 Cockburn、Henderson 和 Stern 的分类框架,对两者进行了区分。论文第 522 页的图 1 将技术划分为四类:
不是通用目的技术 是通用目的技术 不是发明方法的发明 Bessemer 转炉、工业机器人 蒸汽动力、自动驾驶汽车 是发明方法的发明 研究实验室、算法 ICT、深度学习 这个分类说明,一项技术可以广泛应用于不同产业,却不一定直接改变创新活动本身;也可以显著改善创新活动,却不一定成为覆盖整个经济体系的通用技术。
例如,蒸汽动力是典型的 GPT,但它并没有直接创造一种全新的科学研究方法。研究实验室能够改变技术研发的组织方式,但它本身并不是像电力一样广泛嵌入各行业的基础技术。信息通信技术则同时具有两种特征:它既能提高商品和服务的生产效率,也能降低知识获取成本,改变研发和创新活动的方式。
我认为,人工智能最值得关注的潜在价值,恰恰在于它可能同时具备这两种属性。它不仅能够完成原来由人类执行的认知任务,还可能成为一种新的知识生产工具,改变科学研究、工程设计、药物发现和企业研发的过程。
通用目的技术如何形成经济增长动力?
创新互补性如何形成双向诱导机制?
为了理解 GPT 如何推动经济增长,我认为最重要的是理解基础技术提供者与下游应用行业之间的双向创新关系。
在传统产业组织中,上游企业提供产品,下游企业购买产品并用于自己的生产活动。双方通常通过市场价格完成交易。但在通用目的技术体系中,这种简单的交易关系并不足以解释技术进步,因为双方的研发决策会相互影响。
假设某家企业生产半导体,下游企业则利用半导体开发个人计算机、汽车电子系统、医疗设备和通信产品。当半导体性能提高时,下游企业可以开发更好的产品,降低生产成本,或者创造以前不存在的产品。这会提高下游企业投资研发的回报,使它们更愿意投入资源改进自己的产品和生产流程。
反过来,当下游行业的技术水平提高时,它们对半导体性能的要求也会增加。例如,个人计算机需要更高的处理速度和更大的存储容量,汽车需要更可靠的电子控制系统,医疗设备需要更强的数据处理能力。这些需求会扩大半导体企业的商业机会,使它们有更强的动力继续研发。
因此,基础技术的进步诱导下游创新,下游创新又诱导基础技术进步。这是一种双向诱导机制(Dual Inducement Mechanism),也是 GPT 与普通技术最重要的区别之一。
Bresnahan 和 Trajtenberg 将这种关系称为创新互补性。若用经济学语言表达,就是基础技术质量提高,会增加下游企业研发的边际回报;下游企业技术水平提高,也会增加基础技术提供者研发的边际回报。双方的创新活动因此具有战略互补性(Strategic Complements)。
技术进步为什么会产生纵向和横向外部性?
GPT 的经济影响不仅来自基础技术与下游应用行业之间的互补关系,还来自两种外部性:纵向外部性(Vertical Externality)和横向外部性(Horizontal Externality)。
纵向外部性发生在基础技术提供者与下游应用行业之间。上游企业研发出更好的基础技术,会让下游企业获得收益;下游企业研发出更好的产品,又会扩大上游企业的市场需求。双方都无法完全获得自己创新带来的全部社会收益,因此各自的私人创新回报会低于社会总回报。
横向外部性则发生在不同的应用行业之间。半导体质量提高,不仅有利于计算机行业,也有利于汽车、通信、医疗和工业控制行业。任何一个行业扩大对半导体的需求,都可能提高半导体产业继续研发的收益,而半导体性能提高又会让其他行业受益。
从下游应用行业的角度看,基础技术的质量具有某种公共品属性。每一个行业都希望其他行业也增加应用和研发投入,因为更多应用行业能够共同扩大基础技术的市场规模,推动技术进一步升级。但单个行业通常不会主动承担全部基础技术升级成本。
由此产生了一个重要问题:每个行业都希望享受技术进步带来的好处,却不一定愿意为整个技术体系承担相应的创新成本。
为什么市场机制容易造成创新不足和创新滞后?
Bresnahan 和 Trajtenberg 的理论模型指出,即使基础技术和应用行业之间存在巨大的共同收益,分散化的市场经济也未必能够实现社会最优的创新水平。
问题的核心是双边道德风险(Bilateral Moral Hazard)和收益可占有性(Appropriability)。
假设半导体企业需要投入大量资金改进芯片性能,而计算机制造商需要投入研发资金,才能充分利用新芯片的性能。芯片企业希望通过较高的价格获得研发回报,但芯片价格越高,计算机制造商的创新成本也越高,后者就越不愿意进行互补研发。
如果半导体企业按照边际成本定价,计算机制造商就能够获得更强的创新激励,但半导体企业自身可能无法获得足够的研发收益,因此也缺少升级技术的动力。如果半导体企业提高价格,上游研发激励会增加,下游研发激励却会下降。
即使采用价格歧视,也很难同时解决双方的问题。一个能够获得全部社会创新收益的完全价格歧视型上游垄断者,可能使下游应用行业的创新回报接近于零。相反,能够给予下游企业充分创新激励的定价方式,又可能让上游企业无法收回研发投入。
因此,单纯依靠市场价格,很难同时让双方获得与社会回报相匹配的创新激励。
论文的命题一指出,在相应的模型假设下,社会最优状态下的基础技术质量、下游技术水平以及采用基础技术的行业数量,都会高于分散化市场交易所形成的均衡水平。换句话说,私人部门可能在基础技术和下游应用两个方面同时投入不足。
这种现象可以概括为:创新不足,而且创新发生得太晚(Too Little, Too Late)。
大型需求方为什么能够成为技术发展的触发器?
Bresnahan 和 Trajtenberg 特别强调,大型、稳定且具有较高支付意愿的需求方,可能成为 GPT 发展的重要推动力量。
美国国防部在 20 世纪 50 年代和 60 年代的采购政策,就是一个典型案例。当时,美国国防部对微电子产品具有较高的性能要求,也愿意通过采购承诺承担部分技术开发风险。这种需求不仅支持了微电子产业的发展,还可能通过技术进步惠及其他使用者。
但横向外部性并不只来自政府。Bell System 和 IBM 等大型私人需求方,也对微电子技术的基础进步作出了重要贡献。
在更早的技术发展过程中,交通运输行业也发挥过类似作用。19 世纪铁路建设需要大量钢轨,铁路和蒸汽船需要能够承受高压蒸汽的材料与设备。这些行业愿意为突破现有技术边界的产品支付更高价格,因此为钢铁、材料科学和工程技术提供了稳定的创新需求。
我认为,大型需求方的重要性不只是购买规模大,而是它们能够通过长期、可预测的需求,降低基础技术研发的不确定性,并为整个应用生态系统创造共同收益。
在美国半导体产业的发展过程中,冷战背景、国防采购政策以及相关产业的商业需求共同构成了外部触发条件。此后,GPT 与应用行业之间的正反馈逐渐发挥作用,推动技术进步持续多年。
技术合作和制度安排为什么重要?
既然纵向和横向外部性使市场机制难以实现社会最优,那么技术企业之间的合作就具有重要意义。
Bresnahan 和 Trajtenberg 提出,基础技术提供者与应用行业之间可以通过具有约束力的技术合同,明确双方的研发投入、技术标准和收益分配。不同应用行业之间也可以通过合作,扩大共同技术的发展规模。
但技术合同本身也面临外部性问题。每个行业都希望其他行业与基础技术提供者建立合作关系,因为其他行业的合作同样能够推动基础技术升级。与此同时,合同执行、技术预测和长期承诺都存在困难。
20 世纪末的计算机和通信产业提供了一个例子。IBM 和 AT&T 曾经在各自市场中拥有非常强的市场地位,能够在一定程度上推动基础技术和下游应用的共同发展。随着市场竞争结构发生变化,技术创新逐渐分散到更多企业,原来由大型企业承担的隐性协调职能也随之改变。
后来,战略联盟、标准制定组织、产业联盟、软件开发者社区以及行业媒体等机制逐渐成为重要的技术管理工具。这些机制能够帮助企业交换技术信息、预测发展方向,并鼓励互补性创新,但它们仍然无法完全内部化所有外部性。
因此,GPT 的发展速度不仅取决于技术本身,也取决于产业组织、合同制度、市场结构、技术标准和信息交流机制。
为什么通用目的技术的经济影响往往需要很长时间?
技术突破为什么不能立即转化为生产率增长?
从经济史来看,一项技术出现与它真正推动整个经济体系的生产率增长之间,通常存在明显的时间差。
Nicholas Crafts 在 2021 年的研究中指出,通用目的技术的生产率贡献通常在早期比较有限,随后才逐渐增加。滞后的原因主要包括三个方面:基础技术本身还需要持续改进,技术设备的质量调整后价格还需要下降,以及企业需要投入时间和资源进行组织变革和互补性创新。
以电力为例,托马斯·爱迪生于 1882 年开始向纽约客户提供电力,但美国电气化真正产生显著生产率收益,主要是在 20 世纪 20 年代,距离最初的电力商业化已经过去约 40 年。
为什么会出现这样的差距?早期工厂通常采用蒸汽机集中提供动力,再通过皮带和轴系把动力传输到不同机器。这种结构决定了机器的位置必须围绕动力源安排,生产线布局、工人组织和物料流动都受到限制。
电动机的出现并不意味着工厂立即获得全部收益。企业必须重新设计工厂,把大型集中动力系统改造成多个可以独立布置的小型动力单元。只有当机器能够按照生产效率的要求自由布局,工厂的生产组织才能发生根本变化。
因此,电力带来的生产率增长并不只是能源成本下降,还来自生产流程和组织结构的重新设计。
蒸汽动力的扩散为什么同样经历了长期滞后?
蒸汽动力在英国的经济影响也不是从蒸汽机发明之日起就立即显现。
James Watt 的蒸汽机于 1769 年获得专利,但英国蒸汽动力在 1830 年之前对生产率增长的贡献非常有限。当时使用的蒸汽动力只有约 165,000 马力。即使到了 1870 年,约三分之二的蒸汽动力仍集中在煤矿开采、棉纺织和金属制造等行业。
早期低压蒸汽机的煤炭消耗量较高,经济性受到限制。高压蒸汽技术的发展,则使蒸汽动力能够更广泛地用于工厂、铁路和蒸汽船,但这种技术转变直到 19 世纪下半叶才逐渐完成。
此外,当时蒸汽机相关的科学理论和工程知识还不成熟,蒸汽动力的价格下降速度比较缓慢,尤其是在 1850 年以前。
这说明,技术的发明并不等于技术的成熟,技术成熟也不等于技术已经被广泛采用。只有技术性能、生产成本、基础设施和应用行业的组织能力同时发生变化,通用目的技术才可能真正释放其经济价值。
电动机如何改变了整个制造业的生产组织?
Bresnahan 和 Trajtenberg 对电动机的案例进行了详细讨论。20 世纪初的前三十年,电力价格持续下降,电动机效率不断提高,电动机逐渐取代蒸汽机,成为制造业的重要动力来源。
在美国,电动机在 1900 年前后占全部已安装马力的比例还不到 5%,到 1930 年已经超过 80%。
这个过程最重要的地方不是电力替代蒸汽机,而是电力使工厂能够重新组织生产活动。
蒸汽机需要复杂的皮带和轴系来传递动力,机器必须靠近动力传输系统,工作流程也必须按照动力需求安排。电动机则能够以更小、更便宜的单位向不同设备独立供电,机器可以被安排在最有利于生产效率的位置。
这使工厂能够重新设计工作空间、生产线和机器布局。电力因此不仅降低了能源成本,还提高了生产组织的灵活性,为制造业带来了广泛的生产率收益。
Crafts 的研究也指出,美国电力带来的显著生产率收益主要发生在 20 世纪 20 年代,距离 1882 年的电力商业化约 40 年。这是一个非常典型的 GPT 扩散滞后案例。
半导体和计算机如何成为第三次技术革命的基础?
二进制逻辑为什么能够成为通用功能?
半导体技术是 20 世纪后半叶最重要的通用目的技术之一,其底层通用功能是二进制逻辑。
在电子电路出现之前,许多产品依靠机械部件完成复杂的控制和转换过程。例如,机械手表利用弹簧动力产生表示时间的模拟信号,洗衣机通过机械运动、阀门开关和电气控制完成不同工作步骤。
从技术原理上看,这些过程中的很多步骤都可以通过二进制逻辑电路实现。只要能够利用逻辑门、触发器等元件完成输入与输出之间的转换,原本需要大量不同机械结构的功能,就可能由相对标准化的电子元件实现。
半导体的应用范围因此远远超出了计算机本身。
最初的晶体管进入助听器,随后进入收音机、电视机和计算机。微处理器出现后,新的应用迅速扩展,个人计算机、CT 扫描仪、摄像机等新产品得以发展;汽车、民用飞机和军用飞机等传统产品也逐渐发生电子化改造。
Bresnahan 和 Trajtenberg 在论文第 40 页的图 1 中,使用半导体作为 GPT 的例子,将其与助听器、收音机、电视、计算机、CT 扫描仪、汽车等不同应用行业连接起来。这张图所表达的核心意思是:这些行业之间并不需要具有相同的生产流程,它们只需要共同使用同一种基础技术。
标准化为什么使数字技术具有强大的规模经济?
数字集成电路具有一个非常重要的特点:它能够使用高度标准化的元件。
传统机械零件很难实现类似程度的标准化。例如,机械钟表的齿轮可以具有不同齿数和尺寸,具体结构需要根据不同设备进行设计,因此很难把所有齿轮都变成少数通用零件。
数字集成电路则不同。一个由标准化触发器组成的电路,可以通过组合不同数量的相同元件实现不同的逻辑功能。类似的标准元件能够被用于计算机、磁带设备以及其他各种逻辑设备。
这意味着,标准化的数字元件可以实现极高的生产规模,批量生产带来的成本下降能够抵消针对不同应用进行适配所产生的额外成本。
同时,集成电路生产具有明显的学习效应。随着生产批次增加,制造工艺、良率和生产管理不断改善,成本进一步下降。这使半导体产业能够形成持续的规模经济和技术进步。
半导体技术的进步速度有多快?
Bresnahan 和 Trajtenberg 在 1992 年的论文中,列举了半导体产业在此前几十年里的技术进步数据。
20 世纪 60 年代初期,一个集成电路上只能集成少量元件;到了 80 年代初期,单个芯片上的元件已经超过 10 万个;到了 90 年代初期,数量达到约 100 万个。
这一变化大致符合当时所描述的摩尔定律(Moore's Law):单个芯片可以集成的元件数量大约每年翻一倍,而且这一趋势已经持续超过 25 年。
与此同时,动态随机存取存储器(DRAM)的质量调整后价格也大幅下降。论文指出,早期 70 年代每千比特存储器的价格超过 4 美元,后来下降到不足 1 美分,并据此描述存储器在约 15 年间出现了约 5,000 倍的价格差异。
这种价格和性能的巨大变化,使计算设备能够进入原本无法负担它们的市场。现代个人计算机的性能和灵活性远远超过早期大型主机;今天只需要几美元就能购买的数字手表,在 Sputnik 发射的年代甚至还不具备现实可行性;能够在几秒钟内收集、处理和显示数百万条信息的 CT 扫描仪,也逐渐成为医院里的常见设备。
我认为,半导体案例充分说明了 GPT 的第二个特征:持续改进不仅让原有应用变得更好,还会让新的应用在经济上变得可行。
微处理器的发展如何体现技术代际升级?
Bresnahan 和 Trajtenberg 在论文第 43 页引用了 1991 年《Business Week》对 Intel 微处理器发展路线的介绍。这张表格记录了当时已经推出以及正在开发的芯片代际。
芯片 推出时间 主要特点 8086/8088 1978/1979 为第一代 IBM PC 及其兼容机提供计算能力,采用 16 位处理,但计算机内存使用受到限制 80286 1982 比 8088/8086 速度更快,支持运行更大型的程序,首次出现在 1984 年 IBM PC/AT中 80386 1985 Intel 第一款 32 位微处理器,能够以 32 位数据块进行处理,使个人计算机能够承担网络等更复杂的任务 80386SX 1988 80386 的低价版本,目标是替代 80286 市场 80486 1989 被称为“芯片上的主机”,具有约 120 万个晶体管,是当时复杂程度很高的芯片 486SX 1991 旨在让大众以较低成本获得接近大型主机的计算能力,并逐步取代 80386 586 1992 年预期 预计具有约 200 万个晶体管,性能至少达到 80486 的两倍,目标是与 RISC 芯片竞争 686 1993/1994年预期 当时刚进入研发阶段,预计加入声音和视频处理能力,服务于多媒体应用 需要注意,586 和 686 的相关描述是 1991 年时对未来芯片的预期,而不是对后来实际产品表现的回顾。
这组技术代际变化说明,基础技术升级能够不断扩大下游行业的创新空间。计算机制造商需要了解下一代微处理器的性能,才能设计相应的计算机产品;软件开发者需要获得新的操作系统,才能为新系统开发软件;操作系统开发者又需要了解新一代计算机硬件的能力。
不同技术层级之间存在紧密联系,任何一层的进步都会影响其他层的研发方向。
如何衡量通用目的技术对经济增长的贡献?
GPT 如何影响劳动生产率和全要素生产率?
在经济学中,衡量通用目的技术的常见方法是增长核算(Growth Accounting)。
劳动生产率增长通常可以分解为资本深化和全要素生产率增长。Crafts 在 2021 年的论文中进一步将资本划分为 GPT 相关资本和其他资本,并将全要素生产率增长划分为 GPT 生产部门与其他经济部门的贡献。
其基本关系可以写成:
[
\frac{\Delta(Y/L)}{Y/L}\alpha\frac{\Delta(K_O/L)}{K_O/L}
+
\beta\frac{\Delta(K_{GPT}/L)}{K_{GPT}/L}
+
\omega(\Delta A/A)_{GPT}
+
\phi(\Delta A/A)_O
]其中,(Y/L) 表示劳动生产率,(K_O) 表示其他资本,(K_{GPT}) 表示通用目的技术相关资本,(\alpha) 和 (\beta) 分别表示相应资本的收入份额,(\omega) 和 (\phi) 则表示 GPT 生产部门与其他经济部门在总产出中的相应权重。
这个分解说明,GPT 对劳动生产率的影响主要有两个渠道:一是通过增加 GPT 相关资本投入,提高每名劳动者能够使用的资本数量;二是通过基础技术自身的生产率提高,直接改善技术设备的性能和成本。
此外,GPT 还可能通过知识溢出产生第三种影响。例如,企业使用新的技术设备后积累了经验,这些经验可能被其他企业学习和利用,从而提高整个行业的生产率。
在原有增长核算框架中,可以加入一个知识溢出项:
[
\gamma\frac{\Delta(K_{GPT}/L)}{K_{GPT}/L}
]其中,(\gamma) 表示 GPT 资本深化带来的未获得直接补偿的全要素生产率溢出效应。由于这部分影响很难独立估计,许多研究并没有将其单独纳入计算,而是把它计入其他经济部门的全要素生产率增长。
这也意味着,传统增长核算可能低估 GPT 对经济的真实影响,特别是当技术的主要贡献来自知识扩散、组织变革和互补性创新时。
蒸汽、电力和 ICT 分别贡献了多少生产率增长?
Crafts 在论文第 524 页的表 1 中,对蒸汽、电力和 ICT 的生产率贡献进行了估算。数据以每年劳动生产率增长的百分点表示。
技术及经济体 时期 资本深化 TFP 贡献 合计 占全经济劳动生产率增长的比例 蒸汽动力(英国) 1760—1830 0.011 0.003 0.014 5.6% 蒸汽动力(英国) 1830—1870 0.18 0.12 0.30 19.0% 蒸汽动力(英国) 1870—1910 0.15 0.16 0.31 29.2% 电力(美国) 1899—1919 0.04 0.06 0.10 5.6% 电力(美国) 1919—1929,估计一 0.07 0.07 0.14 3.6% 电力(美国) 1919—1929,估计二 0.07 0.30 0.37 9.5% 电力(美国) 1929—1941 0.04 0.16 0.20 8.0% ICT(美国) 1974—1995 0.41 0.36 0.77 49.4% ICT(美国) 1995—2004 0.78 0.72 1.50 49.0% ICT(美国) 2004—2012 0.36 0.28 0.64 41.0% 注:电力在 1919—1929 年的估计一没有考虑全要素生产率溢出,估计二则将其纳入。
这张表最值得注意的地方是,蒸汽动力和电力的宏观生产率贡献具有明显的滞后,而 ICT 的影响出现得更快、规模也更大。
ICT 在 1995—2004 年对美国劳动生产率增长的年度贡献达到 1.50 个百分点,约占全经济劳动生产率增长的 49%。即使到了 2004—2012 年,其贡献仍然达到 0.64 个百分点。
相比之下,电力在 1899—1919 年的年度贡献只有 0.10 个百分点,占全经济增长的 5.6%。到了 1919—1929 年,如果计入 TFP 溢出,其贡献提高到 0.37 个百分点。
这组数据说明,GPT 的宏观经济贡献并不是从技术诞生时就固定存在的,而是会随着技术改进、应用扩张和组织调整逐渐增加。
为什么 ICT 的影响比蒸汽和电力出现得更快?
我认为,ICT 的历史提供了一个重要的比较案例。
Intel 4004 微处理器于 1971 年推出,ICT 在美国劳动生产率增长中的贡献从 1974—1995 年开始变得显著。与蒸汽动力和电力相比,ICT 的技术扩散和生产率贡献出现得更快。
这可能与现代经济的科学技术能力、研发投入和资本市场成熟程度有关。现代企业已经拥有更成熟的研发组织、工程人才、融资渠道和全球供应链,因此能够更快地识别和利用新的技术机会。
Crafts 也指出,Solow 曾经提出著名的生产率悖论:“计算机时代无处不在,唯独没有出现在生产率统计数据中。”但从历史比较来看,Solow 在 20 世纪 80 年代末提出这一观点时,ICT 对劳动生产率的贡献实际上已经相当显著。
不过,不能简单地把整个经济的生产率增长都归结为 GPT。蒸汽和电力确实发挥了重要作用,但它们并不是唯一的增长动力。
例如,英国劳动生产率的增长速度从 1869 年的每年 2.2% 下降到 1890 年的 0.8%,但蒸汽动力对劳动生产率的贡献在 1830—1870 年和 1870—1910 年两个时期大致相当。蒸汽动力的使用马力从 1870 年的 210 万增加到 1907 年的 970 万,说明蒸汽时代并没有在 19 世纪 70 年代结束。
同样,美国 1899—1941 年第二次工业革命相关技术集群,只解释了私人国内经济劳动生产率增长的 36% 和 TFP 增长的 38%。即使是影响巨大的技术革命,也无法解释经济增长的全部变化。
Boyan Jovanovic 和 Peter Rousseau 在 2005 年的研究中也指出,电气化和信息技术是美国经济最重要的两次通用目的技术革命。电气化的扩散范围更广,而信息技术在技术上显得更加革命性;ICT 时代的生产率放缓也更明显,但其持续扩散和价格不断下降,为 21 世纪的增长提供了乐观依据。
工业革命真正改变的是什么?
第一次工业革命并不是一场立即爆发的生产率革命
传统经济史通常把英国 1760 年代至 1830 年代的经济发展称为第一次工业革命。这一时期出现了大量著名发明,包括 Richard Arkwright 的纺织技术、Henry Cort 的冶金技术、Samuel Crompton 的纺纱设备、George Stephenson 的铁路技术以及 James Watt 的蒸汽机改进。
但 Crafts 认为,第一次工业革命最值得关注的特点,并不是生产率立即高速增长,而是人类逐渐形成了一种新的发明方法。
在工业革命初期,技术进步并没有立即带来大规模的全要素生产率增长。农业和交通运输以外的大部分服务业受到的影响都比较有限。即使到了 1851 年,纺织、金属制造和机器制造等典型工业革命行业,也只占工业就业人数的不到三分之一,或者占全社会就业人数的 13.4%。
当时经济中仍然有大量就业集中在传统产业,因此少数行业出现技术突破,并不能立即改变整个经济的生产率。
Crafts 在论文第 528 页的表 5 中给出了英国 1700—1913 年的增长核算数据。
时期 劳动生产率增长 资本深化贡献 劳动力质量贡献 TFP 增长 1700—1760 0.25 0.10 0.01 0.14 1760—1780 -0.01 -0.06 -0.01 0.06 1780—1800 0.46 0.19 -0.01 0.28 1800—1830 0.29 0.10 0.01 0.18 1830—1856 1.11 0.65 0.08 0.38 1856—1873 2.06 0.72 0.32 1.02 1873—1913 1.06 0.38 0.58 0.10 注:单位为每年百分比,按照标准新古典增长核算方法计算。
这张表显示,1760—1830 年英国的 TFP 增长并不突出。真正显著的劳动生产率增长主要出现在 1830 年以后,而 1856—1873 年劳动生产率增长达到每年 2.06%,TFP 增长达到 1.02%。
另一个值得注意的现象是,1873—1913 年的 TFP 增长只有 0.10%。当研究进一步使用工作小时数并单独识别劳动质量贡献时,这种放缓仍然存在,并不能简单地视为一个短暂的统计异常。
因此,第一次工业革命并不是一个技术发明出现后,生产率就立即大幅增长的案例。
第一次工业革命为什么没有立即带来大规模工资增长?
工业革命的另一个重要争议,是技术进步是否导致劳动者长期受损。
一些研究将英国工业革命时期描述为“恩格斯暂停”(Engels' Pause):技术进步加速,但实际工资增长缓慢,劳动者在国民收入中的份额受到挤压。这一历史经验经常被用来讨论人工智能和自动化对就业市场的潜在影响。
Crafts 对这一观点进行了重新检验。他认为,虽然部分劳动者遭受了严重的技术替代冲击,但英国整体劳动收入份额并没有出现长期、大幅度的下降。
论文第 527 页的表 3 给出了 1770—1860 年英国劳动、土地和资本收入份额,以及隐含利润率的数据。
年份 劳动收入份额 土地收入份额 资本收入份额 利润率 1770 61.0% 21.8% 17.2% 9.8% 1780 56.8% 21.4% 21.8% 12.6% 1790 57.1% 19.8% 23.1% 13.1% 1800 55.8% 18.3% 25.9% 15.3% 1810 56.4% 16.3% 27.3% 16.0% 1820 59.0% 15.8% 25.2% 14.3% 1830 60.7% 15.1% 24.2% 14.1% 1840 59.2% 12.5% 28.3% 15.9% 1850 65.3% 10.5% 24.2% 12.9% 1860 62.0% 8.5% 29.5% 17.2% 利润率是通过资本收入份额除以资本产出比计算得到的。
从数据来看,资本收入份额确实从 1770 年的 17.2% 增加到 1860 年的 29.5%,但这主要伴随着土地收入份额下降,而不是劳动收入份额持续下降。工业化过程中资本不断积累,而农业土地面积几乎没有增长,因此资本在国民收入中的份额上升并不意味着所有收益都来自对劳动者收入的挤压。
这一时期的收入不平等呈现出类似库兹涅茨曲线的变化。相关研究估计,英国基尼系数从 1759 年的 0.53 上升到 1798 年的 0.60,随后下降到 1846 年的 0.58,并在 1867 年进一步降至 0.48。
不过,整体劳动收入份额相对稳定,并不意味着没有劳动者受到严重冲击。
最典型的案例是手工织布工。他们最初受益于纺纱机械化带来的生产扩张,但后来又被动力织布机取代。手工织布工人数从 1780 年的 37,000 人增加到 1820 年的 240,000 人,随后在 1850 年下降到 43,000 人。
他们的每周货币工资从 1770 年的 75 便士上升到 1805 年的 276 便士,随后又在 1830 年回落到 75 便士。
与此同时,新的职业类型不断出现。属于较低中产阶级职业群体的家庭数量,从 1798 年的 253,000 户、占全部家庭的 8.6%,增加到 1846 年的 649,000 户、占 15.4%。
这说明技术替代与新任务创造同时发生。机器取代了一些原有劳动任务,但经济活动的扩张也创造了新的工作机会。问题在于,劳动者能否顺利完成职业转移,以及转移过程中需要承担多少教育、培训和收入损失成本。
实际工资和劳动生产率之间存在什么关系?
Crafts 在论文第 528 页的表 4 中,以 1770 年为 100,比较了英国实际人均 GDP、实际消费收入和实际产品工资。
年份 实际人均 GDP 实际消费收入 实际产品工资 1770 100.0 100.0 100.0 1780 104.0 105.2 97.0 1790 104.2 109.3 97.6 1800 113.8 109.3 104.2 1810 118.7 109.6 109.8 1820 115.9 111.6 112.2 1830 124.7 114.3 124.3 1840 143.9 127.1 139.8 1850 154.3 148.9 165.3 1860 164.1 154.7 167.1 注:实际消费收入和实际产品工资采用以相应年份为中心的五年平均值。
到 1820 年,英国实际人均 GDP 比 1770 年提高了约 16%,实际消费收入提高了约 12%。在 1770—1840 年间,劳动生产率累计增长约 44%,实际消费收入增长约 27%,实际产品工资增长约 39%。
这说明,劳动生产率增长确实快于劳动者消费收入增长,但并没有出现长期、全面的劳动收入崩塌。分析这类历史问题时,还需要区分 GDP 平减指数和生活成本指数,因为两种价格指标可能使实际产品工资和实际消费收入呈现不同变化。
工业革命的真正突破是形成了新的发明方法
Crafts 借助经济史学家 Joel Mokyr 的研究,提出第一次工业革命最深层的意义,是人类逐渐形成了一套能够持续产生技术进步的新方法。
这种方法建立在系统性的经验主义和实验之上。人们不再只依靠个别工匠的经验,而是开始通过观察、实验、记录、比较和传播,积累可以被其他人重复使用的技术知识。
这套方法提高了三个方面的能力:创新成功的概率、研发投入的积极性,以及每项创新最终能够产生的生产率影响。
如果用内生增长理论表示,可以将技术进步率写成:
[
x=\lambda\sigma q
]其中:
- (x) 表示技术进步率;
- (q) 表示创新投入或研发强度;
- (\lambda) 表示单位创新投入取得成功的概率;
- (\sigma) 表示每项成功创新所带来的生产率提升幅度。
创新努力通常会随着市场规模扩大而增加,因为市场越大,成功创新后能够获得的商业回报越高。因此,市场规模与创新投入之间存在正向关系。
第一次工业革命所形成的新发明方法,能够同时提高创新成功概率、研发投入和创新的实际影响力。
知识获取机构如何推动了技术进步?
这一时期出现了一系列专门生产、整理和传播科学技术知识的组织。Crafts 将其称为知识获取机构(Knowledge Access Institutions,KAIs)。
其中包括:
- 英国皇家学会(Royal Society),成立于 1660 年;
- 月光社(Lunar Society),成立于 1765 年;
- 曼彻斯特文学与哲学学会,成立于 1781 年;
- 机械学院(Mechanics Institutes),从 1823 年开始出现;
- 英国科学促进会(British Association for the Advancement of Science),成立于 1831 年。
知识获取机构的数量从 1761 年的 3 个增加到 1851 年的 1,014 个。相关研究发现,这些机构对所在地区的专利活动具有显著影响。
与此同时,应用数学技能的传播也发挥了重要作用。测量、计算和工程设计能力的提升,使机器工具得以发展,进而把原本停留在理论和实验阶段的发明转化为能够实际运行的机械设备。
第一次工业革命仍然主要建立在经验主义之上,而不是现代意义上的成熟科学理论。例如,康沃尔抽水蒸汽机的燃料效率提升,很大程度上依赖不同设计方案的实际运行记录、观察和比较。
这种技术学习的局限在于,它往往局限于特定地区和特定行业,不一定能够自然传播到其他地方。
第二次工业革命如何改变了发明方法?
第二次工业革命通常被认为发生在 1870—1914 年。与第一次工业革命相比,这一阶段最重要的变化,是技术进步逐渐建立在应用科学和工业研发实验室之上。
Thomas Edison 于 1876 年在门洛帕克建立了自己的实验室。到了 1918 年,美国制造业已经建立了 665 个研发实验室。
专利活动的组织方式也发生了变化。1880 年,美国约 95% 的专利属于独立发明者;到了 1930 年,企业和独立发明者获得的专利数量已经大致各占一半。
发明者的科学与工程训练背景也明显提高。在 1845 年以前出生的美国伟大发明家群体中,只有 12% 的专利获得者接受过科学或工程训练;对于 1866—1885 年出生的群体,这一比例上升到 60%。
第二次工业革命的研发体系使 TFP 增长进入新的水平。Bakker、Crafts 和 Woltjer 的研究估计,美国 1899—1929 年的 TFP 年均增长约为 1.1%,如果不单独扣除劳动质量增长,粗略 TFP 增长约为 1.7%;Kendrick 在 1961 年的较早估计则为 1.4%。
电力、内燃机和化学工程都是这一时期的重要技术突破。英国在利用第二次工业革命潜力方面,相比美国表现得不那么成功。
第三次工业革命如何使 ICT 成为发明方法?
第三次工业革命通常被用于描述 20 世纪 60 年代至 21 世纪初的计算机科学和信息通信技术发展过程。
这一时期的技术进步经历了大型主机、个人计算机和互联网的发展。ICT 不仅提高了商品和服务的生产效率,还成为一种知识技术,显著降低了获取、储存、传播和处理知识的成本。
它同时改变了研发活动本身。例如,软件密集程度的提高与专利引用中软件相关内容增加有关,也使企业能够以相同的研发投入获得更多专利成果。
计算能力成本的下降尤其惊人。Nordhaus 对计算成本的研究显示,以 2006 年美元计,每百万单位计算能力的成本从 1940—1949 年的 25.7,下降到 1970—1979 年的 0.000592,再下降到 2000—2006 年的 0.000000000137。
这种变化对科学研究和经济学研究产生了巨大影响。
Xavier Sala-i-Martin 在 1997 年发表了一篇基于 400 万次回归分析的研究。他的计算机完成这些计算大约需要 33 小时,而他的计算速度约为每分钟 2,000 次回归。与此相比,Milton Friedman 在 20 世纪 40 年代末运行一次回归就可能需要 40 小时。
计算能力的进步不仅提高了研究速度,也改变了研究者能够提出的问题和使用的方法。
Crafts 还指出,美国非 ICT 行业的 TFP 年均增长贡献从 1974—1995 年的 0.14 个百分点提高到 1995—2004 年的 0.89 个百分点,同期包括 ICT 行业在内的总 TFP 增长从 0.50% 提高到 1.61%。但这种变化并没有持续保持。
人工智能为什么可能成为第四次工业革命的基础?
如果第一次工业革命的核心是系统经验主义,第二次工业革命的核心是工业研发实验室,第三次工业革命的核心是计算机和信息通信技术,那么人工智能可能代表下一次发明方法的变化。
Crafts 认为,人工智能尤其是深度学习,可能同时成为 GPT 和 IMI。它不仅可以执行既有任务,还可能提高研发和科学研究的生产率。
这一点在药物发现和科学研究中已经出现了一些早期案例。
2020 年 2 月,MIT 公布了新型抗生素 Halicin 的发现。2020 年 11 月,DeepMind 在蛋白质折叠问题上取得突破。这些案例表明,机器学习不仅可以提高现有研发活动的效率,还可能帮助研究人员发现新的科学关系和技术方案。
机器学习也已经成为经济学研究中的重要工具。例如,研究人员利用数字化书籍中的文本,推断过去约 200 年人口幸福水平的变化。按照相关研究,如果完全依靠人工完成这些文本分析,可能需要至少 800 亿人小时,而这种自动化分析在 10 年前还不具备技术可行性。
另一个重要问题是,现代研发的生产率是否正在下降。
Bloom 等人在 2020 年的研究中提出,寻找新想法可能变得越来越困难。美国自 20 世纪 30 年代以来,TFP 增长相对于研发支出的下降,与创新所需的知识负担不断增加这一解释相一致。
这可能是因为容易取得的技术成果已经逐渐被开发,也可能是因为现代科学研究越来越专业化,研究人员需要掌握更多知识才能取得新的突破。
如果人工智能能够提高寻找新想法、组合知识和验证假设的效率,它就可能成为缓解研发生产率下降的一种力量。
这里需要特别注意:如果人工智能主要通过提高其他行业的研发效率来推动经济增长,那么传统增长核算未必会把这些收益直接记在 AI 资本或 AI 行业名下,而可能把它们记录为其他经济部门更高的 TFP 增长。
人工智能是否已经具备通用目的技术的全部特征?
人工智能的快速改进是否已经得到证明?
MIT Sloan 于 2024 年 8 月 6 日发表的文章《The Impact of Generative AI as a General-Purpose Technology》,引用 Andrew McAfee 的研究,认为生成式人工智能已经具备通用目的技术的基本特征。
首先是快速改进。
文章指出,OpenAI 的 GPT-3.5 在 2022 年底发布时,在美国律师资格考试中的表现超过约 10% 的考生;GPT-4 于 2023 年 3 月发布后,其表现超过约 90% 的考生。
人工智能的上下文窗口也在快速扩大。2020 年,最先进的生成式 AI 系统能够处理的信息量约为 7.5 页文本;到了 2023 年末,这一能力已经扩大到接近 300 页,约为原来的 40 倍。
除了模型性能提升,推理成本和单位能力价格下降同样重要。基础技术的持续改进与价格下降,使更多企业和个人能够在经济上负担相关应用。
人工智能的应用范围是否已经足够广泛?
MIT Sloan 文章引用了 2023 年的一项覆盖 14,000 名不同职业和行业用户的 Salesforce 调查。
调查中,28% 的受访者表示已经在工作中使用生成式 AI,其中超过一半没有获得雇主正式批准;另有 32% 的受访者预计很快会在工作中使用生成式 AI。
另一项 2023 年的研究估计,美国约 80% 的劳动者至少有 10% 的工作任务会受到生成式 AI 影响,其中约 19% 的劳动者可能有至少一半的工作任务受到影响。
这些数据反映的是 2023 年前后的采用情况和任务暴露程度,并不等同于实际岗位被替代的比例。
从经济增长角度看,广泛应用意味着 AI 不再只属于计算机和软件行业,而是开始进入金融、法律、医疗、教育、营销、客户服务和制造业等不同领域。
为什么互补性创新是判断 AI 是否成为 GPT 的关键?
生成式 AI 能够生成文本、图片和声音,但这些能力本身并不足以形成整个经济体系的生产率革命。
真正重要的是企业能否围绕 AI 重新设计工作流程,开发新的软件工具和服务,调整组织结构,并将 AI 整合到跨部门的业务流程中。
例如,AI 能够帮助医生处理医疗记录,但如果医院没有改变预约、诊断、病历管理和治疗流程,那么 AI 带来的生产率收益就会受到限制。
AI 能够生成代码,但如果企业的软件架构、产品设计和工程协作流程没有发生变化,代码生成效率提高也未必会带来同等幅度的组织生产率提升。
Andrew McAfee 的研究强调,生成式 AI 的深层影响可能来自整个组织的重新设计,而不是单个任务的自动化。
从宏观经济角度看,Goldman Sachs 曾估计,生成式 AI 可能使未来十年美国 GDP 增长率提高 0.4 个百分点。这是一项前瞻性预测,而不是已经实现的增长结果。
为什么 AI 可能比蒸汽机和电力扩散得更快?
传统 GPT 往往需要大量新的基础设施才能广泛使用。
蒸汽动力需要矿山、煤炭供应、机械制造和交通运输系统;电力需要发电设施、输电网络、配电设备以及工厂内部电气化改造。
人工智能则可以直接运行在已经普及的互联网连接设备上。用户不需要掌握编程语言,也不需要理解复杂的计算机操作,只需要使用自然语言就能与模型进行交互。
这显著降低了技术扩散的初始门槛。
不过,我认为基础设施已经存在,并不意味着所有互补创新都已经完成。真正决定 AI 经济影响的,仍然是企业、政府和个人能否将技术能力转化为实际生产流程的变化。
人工智能可能通过哪些渠道改变宏观经济?
AI 提高单一行业生产率,是否意味着 GDP 会大幅增长?
在讨论 AI 的宏观经济影响时,我认为首先需要区分三种不同的情景。
第一种情景是 AI 主要提高某一个行业的生产率,例如软件开发、法律服务或内容生产,而其他行业的生产方式基本不变。
这种情景可能使该行业的产品和服务质量大幅提高,但未必会让 GDP 出现同等幅度的增长。
一个典型的历史案例是照明技术。
电灯泡和其他照明技术出现后,照明行业的生产率提升了许多个数量级。今天的照明效果远远超过几十年前,但照明行业在 GDP 中的份额并没有随生产率提升而不断扩大,反而逐渐下降。
原因在于,当一个行业的生产效率提高、产品价格下降时,消费者购买同样功能的产品所需要支付的费用会减少。即使产品质量和实际价值大幅提高,该行业的名义 GDP 占比也可能下降。
同时,其他生产率没有同步提高的行业仍然需要支付相近的工资,因此它们的相对价格可能不断上升。这种现象与经济学中的成本病(Cost Disease)有关。
因此,如果 AI 首先让软件行业的生产率极大提高,却没有同步改变其他行业的生产方式,宏观 GDP 的变化可能远小于人们根据软件行业效率提升所作出的直觉判断。
AI 如果成为额外劳动力,会产生什么影响?
第二种情景是将 AI 理解为一种额外的劳动供给。
传统经济中,劳动主要来自人类;如果 AI 能够在大量任务上承担与人类相似的工作,那么它就相当于为经济体系增加了一种新的劳动投入。
这种情景的宏观影响取决于 AI 能够替代哪些任务、替代速度有多快,以及经济体系是否能够同步增加资本投入。
如果 AI 能够完成越来越多的任务,但经济中的机器、设备、基础设施和其他互补资本没有同步增加,那么 AI 劳动能力的增长就可能无法完全转化为最终产出增长。
此外,还需要区分 GDP 水平的提高与 GDP 长期增长率的改变。
AI 可能使 GDP 曲线整体上移,也可能改变经济长期增长率。两种结果在经济学上的含义并不相同。
因此,真正值得测量的是:哪些职业和任务正在受到 AI 影响,以及在具体任务中,AI 能够以多快的速度替代或补充人类劳动。
如果 AI 主要提高思想和知识的生产效率,结果会有什么不同?
第三种情景,也是我认为最值得关注的情景,是 AI 主要成为知识生产和创新活动的工具。
经济学家 Paul Romer 在内生增长理论中强调,思想与传统商品存在一个重要区别:思想具有非竞争性(Non-rivalry)。
一旦微积分被发明出来,它就可以被无数人同时使用,不会因为某个人使用了它,就减少其他人使用它的机会。
如果 AI 主要提高思想生产效率,它的影响就不只是提高某个行业的劳动生产率,而可能改变整个经济体系发现新知识、组合已有知识和开展研发的速度。
这里的关键并不只是 AI 能够提高人工智能行业自身的研发效率,而是它能否提高整个经济体系的研发效率,包括药物研发、材料科学、工程技术、农业、能源和制造业。
Cockburn、Henderson 和 Stern 在关于人工智能与创新的研究中,也强调 AI 可能成为一种新的通用目的发明方法,改变研发组织和创新过程。
我认为,如果 AI 主要通过提高知识生产效率来推动增长,那么它的宏观经济影响可能远远超出传统的自动化分析。
GDP 是否足以衡量 AI 的经济价值?
GDP 是宏观经济分析的重要指标,但它并不一定能够完整反映数字技术带来的消费者价值。
例如,互联网搜索、在线地图、免费软件和许多数字服务,可能给消费者带来很大的便利,却不一定产生与其使用价值相匹配的市场交易金额。
因此,GDP 可能低估部分数字技术的实际经济价值。
在一场关于 AI 经济学的学术讨论中,演讲者提出,可以考虑通过消费者剩余等指标,补充传统 GDP 核算。
该讨论引用的一项调查估计,美国约 40% 的人每天或每周使用生成式 AI 工具;用户为了继续使用这些工具,平均每月愿意支付约 98 美元,或者说需要获得约 98 美元的补偿才愿意放弃这些工具。
将这一估计与用户规模结合,演讲者给出了约 1,000 亿美元的消费者剩余估算。
这一结果是基于调查和支付意愿的推算,并不是已经纳入官方国民经济核算的 GDP 数据。但它说明,AI 的经济价值可能不仅来自企业销售收入和劳动生产率,还来自消费者获得的额外便利、知识获取能力和时间节约。
发展中国家为什么可能从人工智能中获得更大的相对收益?
为什么发达国家和发展中国家对 AI 的态度可能不同?
2026 年《世界发展报告:AI 的承诺》相关学术讨论中,Susan Athey 提出了一个值得注意的现象:发达国家,尤其是美国,对 AI 的态度相对悲观,而发展中国家的态度则更加乐观。
这看起来有些反直觉,因为发达国家拥有更强大的计算基础设施、更多的 AI 人才和更先进的模型,而发展中国家往往缺乏这些资源。
但我认为,理解这种差异,需要先考虑不同国家的现实起点。
如果一个国家缺少医生、教师、农业专家和其他专业人员,那么 AI 带来的价值可能首先表现为补足稀缺能力,而不是替代已经充足的劳动供给。
例如,在一些发展中国家,农民可能无法获得准确的市场价格信息,教师可能缺乏高质量的教学资源,小型餐馆经营者可能需要花费半天时间处理客户订单和供应商订单,患者也可能无法获得可靠的医疗信息。
在这样的环境中,AI 能够提供原本很难获得的专业知识和服务,其相对于现有经济基础的改善幅度可能非常大。
与此同时,如果一个国家已经拥有相对充足的专业服务和成熟的企业组织,那么人们可能更关注 AI 对现有工作岗位的替代风险。
因此,AI 对不同国家的影响不能只通过技术先进程度判断,还需要结合专业人才的稀缺程度、产业结构、企业规模和公共服务能力。
发展中国家的哪些现实条件值得特别关注?
Susan Athey 在讨论中引用了几组数据,帮助解释发展中国家为什么可能从 AI 中获得较大的生产率提升。
在撒哈拉以南非洲地区,每 10,000 人只有约 2.9 名医生,而全球平均水平约为 16 名。
低收入国家的小学平均每名教师需要面对约 40 名学生,而富裕国家这一数字约为 15 人。与此同时,低收入国家教师本身的受教育水平和数字教学资源也可能存在不足。
在农业领域,一些研究发现,农民可能将超过一半的利润让渡给中间商,其中一个重要原因是缺乏及时、准确的农产品价格信息。
研究还发现,如果能够在正确的时间、正确的地点向农民提供微观天气预报,就可能明显改善农业生产决策。
这些问题的共同点是,经济活动本身并不一定缺乏劳动者,而是缺乏能够提高劳动者生产率的知识、专业能力和信息。
因此,AI 在发展中国家的重要作用,可能不是减少劳动者数量,而是增加每个劳动者能够使用的专业知识和生产能力。
为什么小型企业可能成为 AI 应用的重要场景?
Susan Athey 在讨论中指出,发展中国家的企业结构与发达经济体存在明显差异。
她引用的数据显示,约 90% 的人在员工人数少于 10 人的企业中工作。
这些企业包括零售店、餐馆、商店和家庭农场,很多分布在中小城镇和乡村地区。
经营者通常需要自己处理采购、客户沟通、员工管理、库存记录和经营决策,但他们缺少专业管理软件和完整的业务信息系统。
例如,一家小餐馆可能依靠即时通信软件接收客户订单,同时通过相同的软件联系供应商。店主需要手动整理订单、确认库存、安排采购,并跟踪不同客户的需求。
如果 AI 应用能够直接接入现有通信系统,自动整理客户订单、记录库存、识别采购需求和生成经营建议,那么企业就不必首先改变自己的沟通方式或购买复杂的软件系统。
AI 可以在现有工作流程中提供专业能力。
我认为,这种模式特别值得关注,因为它降低了企业采用技术的初始成本,也使 AI 不必依赖传统的大型企业软件部署方式。
为什么医疗、教育和农业能够成为通用目的能力的来源?
在传统宏观经济模型中,生产函数通常被表示为技术、资本和劳动等投入的组合。
但 Susan Athey 强调,专业知识和经验本身也是重要的生产投入。
医疗、教育和农业推广服务能够提高其他行业的生产率,因此这些部门可以被理解为具有通用目的能力(General-Purpose Capabilities)的基础部门。
如果医疗服务质量提高,劳动者因疾病缺勤的时间减少,整体经济产出就可能增加。如果教育质量提高,未来劳动者的人力资本水平也会提高。如果农业推广服务能够提供准确的天气和价格信息,农民就能够改善生产决策,增加农业产出。
这些能力的提升会通过其他行业进一步扩散。
例如,如果 AI 能够让农民的生产率提高 5%,或者帮助农村居民避免为了获得医疗服务而每次往返两小时,那么它带来的经济收益就不仅是节省了某项服务的成本,还可能直接增加劳动时间、农业产出和家庭收入。
这也是为什么我认为,人工智能的经济价值不应只通过它替代了多少工作任务来衡量,还应关注它能否提高整个社会的专业服务供给。
为什么 AI 必须适应当地环境,才能真正实现技术扩散?
采用技术和适应技术有什么区别?
2026 年世界发展报告提出了一个非常重要的框架:Adopt、Adapt、Advance,即采用、适应和推进。
采用意味着使用已经存在的 AI 工具,例如利用现有模型帮助医生进行诊断、帮助农民改善农业决策,或者帮助企业提高运营效率。
适应意味着根据当地语言、制度、数据、基础设施和实际需求,对 AI 工具进行改造,使其能够真正融入当地经济活动。
推进则意味着发展更先进的模型、芯片、数据中心和相关基础设施,逐渐进入 AI 技术价值链的更高层级。
对于大多数发展中国家来说,直接建设最先进的基础模型并不是最现实的起点。它需要大量资金、计算芯片、数据中心、训练数据和世界级研发人才。
相比之下,采用和适应已有技术通常更加经济,也更容易产生现实收益。
世界银行在 2026 年 8 月发布的报告指出,AI 的扩散速度已经明显快于过去的通用目的技术。蒸汽机扩散到低收入国家大约需要 80 年,电力约需要 40 年,互联网约需要 20 年;而在 ChatGPT 推出后的六个月内,中等收入国家已经占据其全球流量的一半。
这意味着发展中国家有机会以更短的时间接触新技术,但能否真正获得收益,仍然取决于本地适应能力。
为什么低成本 AI 可能比最先进的 AI 模型更重要?
在低收入国家,智能手机和互联网的普及程度并不一致。
Susan Athey 在讨论中引用的报告图表显示,低收入国家拥有智能手机的人口比例大约只有 20%。如果只考虑通过智能手机应用直接使用大型聊天机器人,就可能忽略大量潜在用户。
但 AI 应用并不一定需要以聊天机器人的形式出现。
例如,店主真正需要的可能不是与 AI 进行长时间对话,而是让客户通过现有通信软件发送订单,由系统自动整理、确认和处理。
对于只有功能手机的用户,仍然可以通过电话和语音服务提供 AI 能力。即使用户不具备读写能力,也可以通过语音消息获得个性化建议。
Susan Athey 提到,她曾与 Precision Development 合作,通过电话语音向农民提供个性化农业建议。早期系统主要提供单向语音信息,而新一代 AI 有机会进一步实现双向语音交流,使农民能够直接提问,并获得针对具体情况的回答。
在这种环境中,AI 需要适应当地语言、方言、设备条件和用户能力,而不是要求用户适应技术本身。
她还引用了一项小企业调查。该调查虽然不包括员工人数少于 5 人的最小企业,但仍然发现约 90% 的受调查企业使用短信或即时通信软件。这意味着许多企业已经具备基本的通信条件,只需要在现有系统上增加 AI 能力。
为什么小型本地模型有时比前沿模型更有价值?
在讨论中,Susan Athey 提到,她曾接触过非洲的一些团队,这些团队已经能够使用游戏电脑运行较小的 AI 模型。
这些模型不一定能够在数学竞赛中超过最先进的前沿模型,但它们可以完成更具体的任务,例如理解当地语言和方言,或者在较小的专业知识库中回答特定问题。
在这样的场景下,用户真正关心的不是模型在通用能力排行榜上的名次,而是它能否快速、准确、低成本地解决具体问题。
一个需要长时间推理、调用大量计算资源的前沿模型,可能并不适合处理一个简单的地方农业问题。一个经过本地适配、运行成本很低的小模型,反而可能产生更高的实际经济价值。
这说明 AI 应用需要在能力、成本、速度和适用范围之间进行权衡。
世界银行 2026 年的报告也强调,低成本的“小型 AI”可以通过短信、语音电话和基础手机,把专业知识提供给更多人,而不必要求每个国家都建设大型数据中心或训练最先进的基础模型。
发展中国家是否具备参与 AI 开发和适应的能力?
Susan Athey 在讨论中还引用了 GitHub 上的 AI 相关活动数据。
这些数据表明,除高收入国家外,印度、巴基斯坦、孟加拉国和尼日利亚等国家也存在一定规模的 AI 开发活动。
这些国家中有不少拥有软件外包产业和技术人才,因此具备参与 AI 工具开发、适应和本地化的基础条件。
不过,全球产业分工的变化也可能带来新的风险。
例如,一家跨国公司可能同时在菲律宾和印度班加罗尔设有业务流程外包中心。如果 AI 提高了某一地点的生产率,公司可能很快决定将更多业务集中到班加罗尔。
班加罗尔可能因此获得更多业务,但当地企业也可能进一步利用 AI 自动化这些业务流程。原本在菲律宾从事呼叫中心和业务流程外包工作的员工,则可能失去部分工作机会。
因此,发展中国家不能只关注某个产业是否扩大,还需要关注本地劳动者的下一种比较优势是什么,以及能否把被释放出来的人力资本重新投入 AI 应用开发和本地适应工作。
政府、企业和非政府组织在这一过程中都可能发挥重要作用。
人工智能的宏观增长为什么会受到弱环节限制?
什么是弱环节理论?
在讨论 AI 对长期经济增长的影响时,Christopher Tonetti 和 Chad Jones 的研究引入了一个重要概念:弱环节(Weak Links)。
这个概念与 Michael Kremer 的 O 形环生产理论以及供应链中的瓶颈问题有关。
如果一项产品需要完成一系列相互依赖的任务,那么最终产出往往会受到最弱任务的限制。
例如,制作一个蛋糕需要鸡蛋、糖、面粉和烤箱。如果缺少其中任何一种关键投入,即使其他材料非常充足,也无法制作出完整的蛋糕。
供应链同样如此。如果某个关键零部件无法供应,其他零部件再充足也不能保证最终产品顺利交付。
Tonetti 用一个简单的生产函数来表达这种关系:
[
\frac{1}{Y}=\frac{1}{X_{hard}}+\frac{1}{X_{easy}}
]其中,(Y) 是最终产出,(X_{hard}) 和 (X_{easy}) 分别代表两种不同任务的产出。
这个表达式体现了调和平均数所具有的弱环节特征:如果其中一个投入已经非常充足,那么继续增加这个投入对最终产出的改善就会越来越有限。
真正限制产出的,是数量最少、效率最低的那项任务。
Tonetti 还使用参数 (\sigma) 表示弱环节的约束程度。按照他在讨论中介绍的估计,(\sigma) 大约为 0.2,这意味着生产体系受到弱环节的约束相当明显。
为什么只让某个行业实现无限生产率,也不会带来无限经济增长?
Tonetti 首先举了软件行业的例子。
在美国,软件支出大约占总收入的 2%。假设软件行业的生产率突然提高到无限大,能够以极低成本提供无限数量的软件,但它并没有承担任何新的任务,其他行业的生产方式也没有改变,那么整体 GDP 能够提高多少?
按照模型中的简单计算,GDP 只会增加约 2%。
这是因为,软件虽然变得极其高效,但其他行业仍然受到原有任务和生产瓶颈的限制。
他进一步考虑一个更加极端的情景:假设目前经济中有 50% 的任务支出都对应于被自动化的任务,而且这些任务的生产率达到无限大,那么整体产出会增加多少?
模型给出的结果仍然只有约 19%。
这说明,即使大量任务的生产率无限提高,其他尚未自动化的任务仍然可能成为限制整体经济增长的瓶颈。
因此,人工智能能否广泛承担不同任务,往往比它能否在某个特定任务上达到极高性能更加重要。
为什么自动化任务范围的扩大如此重要?
Tonetti 的研究不仅关注机器生产率提升的速度,还关注机器能够承担的任务范围。
从历史来看,机器在许多任务上的生产率提高速度明显快于人类。如果只观察计算能力和机械设备性能,人类可能已经很难与机器进行直接比较。
但机器生产率提升并不会自动转化为整体经济增长。它还需要伴随任务边界的不断扩大。
Tonetti 提出了一个历史反事实:假设机器的生产率仍然像现实历史中那样快速提高,但我们始终不允许机器承担 1950 年以后出现的新任务,那么过去几十年里几乎所有重要的生产率收益都可能无法实现。
这说明,经济增长来自两个共同作用的过程:机器本身不断变得更有效率,以及机器能够承担的任务范围持续扩大。
他估计,美国经济中每年大约有 2% 的任务支出份额从人类劳动转向机器。
与此同时,机器生产率的增长速度平均比人类生产率快约 4 个百分点。
如果进一步考虑一个极端的情景,即所有行业中的机器生产率都按照计算机和信息技术行业的速度提高,那么这一差距可能达到约 11 个百分点,而不是历史趋势下的 3.8 个百分点。
这就是研究中所称的“Moore's Law Everywhere”情景。
为什么生产率的弱环节决定 AI 的宏观增长速度?
我认为,弱环节理论给出了一个非常重要的判断:AI 的宏观价值并不取决于它在少数任务上有多么出色,而取决于它能否在足够广泛的任务中达到可用水平。
如果 AI 能够在少数复杂任务上表现出极高能力,但其他大量任务仍然需要人类完成,那么整个经济体系仍然可能受到这些任务的约束。
相反,如果 AI 能够在医疗、教育、行政、制造、农业、物流和企业管理等领域,以中等质量完成大量实际任务,那么它可能带来更广泛的生产率增长。
Tonetti 将 AI 在不同任务上的能力差异称为不均匀智能(Jagged Intelligence)。AI 可能在某些任务上极其出色,但在另一些任务上仍然存在明显局限。
因此,决定宏观增长速度的并不是技术能力的最高点,而是整体生产体系中最薄弱的环节能否持续得到改善。
AI 未来可能带来多大程度的经济增长?
完全自动化是否意味着劳动收入份额必然归零?
Tonetti 在研究中考虑了三种长期自动化情景。
第一种情景是最终所有任务都由机器完成,人类不再承担任何生产任务。
第二种情景是机器承担的任务越来越多,但人类在任何时期都仍然承担一部分任务,只是这些任务的比例持续下降。
第三种情景是不完全自动化,即长期仍然有一些任务需要人类完成。
在历史趋势延续的基准情景中,三种情况在未来几十年里可能呈现非常相似的经济表现。
如果机器最终承担全部任务,资本收入份额可能逐渐上升到 100%。但如果人类始终保留一定任务,即使自动化持续推进,资本收入份额也可能长期保持相对稳定。
这说明,自动化程度提高并不必然意味着劳动收入份额会持续下降。
即使劳动收入份额下降,也需要区分收入份额和实际收入水平。劳动者最终消费的是收入水平,而不是收入份额。如果整个经济的总产出大幅提高,即使劳动者占总收入的比例下降,其实际收入仍然可能增加。
Tonetti 用一句很直接的话表达了这一点:人们消费的是收入水平,而不是收入份额。
基准情景下,AI 会带来多大的 GDP 增长?
在历史趋势延续的基准情景中,Tonetti 的模型显示,自动化会使经济增长速度逐渐提高,但在未来几十年内,这种提高仍然比较温和。
到 2070 年左右,模型中的年经济增长率可能达到约 2.6%。
到 2050 年,经济总产出相对于原有趋势的提高约为 4%。
这与部分科技行业人士所预测的短期内经济产出增长数倍甚至十倍,存在明显差异。
模型认为,原因在于弱环节的约束:即使部分 AI 任务的生产率迅速提高,整体经济仍然受到其他尚未自动化的任务限制。
Moore's Law Everywhere 情景是否可能产生指数级增长?
在更加乐观的情景中,假设整个经济体系的机器生产率都能够以计算机行业的速度增长,而且自动化任务扩张的速度也显著提高,那么经济增长可能出现完全不同的结果。
模型显示,这种情况下,增长率可能快速提高,甚至在特定参数条件下出现有限时间内产出趋于无穷大的数学奇点。
这类情景的机制是机器能够制造更好的机器,而更好的机器又进一步提高机器研发和生产效率,最终形成自我强化的增长循环。
但即使在这种极端假设下,模型也指出,短期产出的扩张仍然受到任务范围和弱环节的限制。
因此,是否能够出现奇点,与未来十年或二十年的现实生产率增长,并不是同一个问题。
我认为,这一模型最重要的价值不在于预测某一个具体增长率,而在于指出:如果 AI 能够广泛承担不同任务,并且这些任务之间的互补瓶颈得到解决,宏观经济增长才可能真正加速。
人工智能对劳动市场和经济安全意味着什么?
AI 自动化是否一定会造成劳动收入份额下降?
从第一次工业革命的历史来看,技术替代与新任务创造往往同时发生。
机器能够接管部分人类劳动,但经济活动扩张也会产生新的工作任务。劳动者最终的收入和福利,取决于这两种力量之间的相对变化,以及社会能否帮助劳动者完成职业转移。
Crafts 的研究指出,英国第一次工业革命并没有出现长期、大幅度的劳动收入份额下降。虽然部分职业受到严重冲击,但整体劳动市场同时出现了新职业和新的中产阶级职业群体。
这并不意味着 AI 不会造成失业,也不意味着所有劳动者都能够自然找到新的工作。
真正重要的是降低劳动力调整成本,包括教育、培训、职业转换、就业信息和社会保障。
为什么 AI 安全风险可能比短期就业冲击更加紧迫?
Tonetti 在讨论中还提出,弱环节理论不仅适用于经济增长,也适用于 AI 安全风险。
在正向增长方面,弱环节意味着必须让足够多的任务得到改善,才能显著提高整体产出。
但在负向风险方面,少数关键任务或系统受到破坏,就可能导致整个经济体系出现严重损失。
网络安全就是一个典型例子。
攻击者不需要成功攻击所有系统,只需要找到一个关键漏洞并成功利用,就可能造成巨大的经济影响。尤其是当一个软件供应商、金融服务机构或基础设施系统同时服务大量企业和个人时,它本身就可能成为整个社会的弱环节。
Susan Athey 在讨论中举例指出,美国曾经出现一次重大网络攻击,使约三分之一的美国人口在一个月内无法正常获得数字处方服务。
这一案例说明,如果一个关键服务被少数供应商集中提供,那么单点故障就可能影响大量下游用户。
人工智能可能降低网络攻击的技术门槛,让攻击者能够更快速地尝试大量不同方法。攻击者不需要像正规企业一样经过产品安全审查、组织重构和内部审批,只需要有一种攻击方式成功,就可能获得巨大收益。
网络安全还具有明显的外部性。单个企业可能没有足够动力承担全部安全投入,但其安全不足可能影响整个社会。
因此,不能只关注 AI 能否提高劳动生产率,还需要关注它能否被用于网络攻击、诈骗和关键基础设施破坏。
生物安全为什么也是重要问题?
除了网络安全,人工智能还可能降低部分生物技术活动的知识门槛。
讨论中提出了两个方向:AI 可能帮助恶意行为者学习如何实施危险的生物活动,也可能帮助他们进一步掌握相关物质和技术的制造过程。
这类风险与 AI 模型的开放程度、使用成本和扩散速度有关。
开放模型能够帮助发展中国家以更低成本获得高质量 AI 能力,但同时也可能让部分具有风险的技术能力更容易被恶意行为者获取。
因此,AI 开放性和安全性之间存在需要认真处理的权衡,不能简单地把所有监管都解释为市场保护,也不能忽略技术扩散带来的真实风险。
我认为应该如何理解 AI 作为通用目的技术的长期价值?
不能只问 AI 最终会产生什么影响,还要问不同影响会以什么速度发生
在 2026 年的学术讨论中,Susan Athey 提出了一个非常重要的分析方法:不要只问 AI 最终会发生什么,而要问不同影响分别会以什么速度发生。
有些变化可以很快完成,例如攻击者使用 AI 生成诈骗内容、自动化网络攻击,或者企业在已有软件系统中加入 AI 功能。
另一些变化则需要很长时间,例如大型企业重新设计组织结构、调整员工职责、替换生产设备、建立新的数据体系,以及重新配置跨部门工作流程。
这些变化即使具有很高的经济回报,也未必能够立即发生。
例如,一个受到政府保护、具有政治关联或存在市场准入壁垒的企业,不一定会因为出现了更有效率的 AI 工具就立刻改变经营方式。它可能有其他方式保护自己的市场地位。
员工也可能因为担心失去工作和收入而不愿意使用 AI。如果管理者没有让员工理解技术如何改善工作,也没有建立相应的激励机制,技术就可能无法顺利扩散。
因此,GPT 理论需要结合具体的微观经济事实、企业组织和制度环境,才能用于预测 AI 的经济影响。
为什么企业有时会理性地选择等待?
AI 能力和使用成本正在快速变化。
Christopher Tonetti 在讨论中指出,某个模型在上一年处于前沿水平时,可能具有较高的运行成本;到了下一年,同一个模型可能已经变得非常便宜。
因此,一个发展中国家或者企业可能会面临选择:现在使用昂贵的前沿模型,还是等待几个月,使用性能更好、价格更低、已经得到更多验证的模型。
对于企业来说,如果今天投入大量资金重构生产流程,但六个月后其他公司已经开发出更成熟的解决方案,那么提前投资的回报可能并不理想。
因此,等待并不一定意味着缺乏创新意识,有时反而是面对技术不确定性时的理性决策。
但这种等待也可能使整个经济体系延迟获得技术收益。
这再次说明,AI 的经济影响取决于技术性能、采用成本、企业组织和未来预期之间的共同作用。
为什么医疗服务中的弱环节特别值得关注?
Susan Athey 在讨论中提出了一个医疗案例。
假设 AI 已经能够准确识别患者的疾病,并为患者推荐正确的治疗方法,但患者所在的农村地区没有药品供应,或者缺乏能够执行治疗的医疗人员,那么 AI 的诊断能力就无法转化为实际健康收益。
在这种情况下,真正限制产出的并不是诊断技术,而是药品配送、医疗人员和服务基础设施。
因此,AI 提高某一环节的效率,并不意味着整个系统就会同步改善。
我认为,这也是弱环节理论最有价值的地方。它让我们从单项技术性能转向整个生产系统,关注哪些互补资源仍然稀缺,以及这些资源如何限制 AI 的实际经济收益。
AI 作为通用目的技术需要什么样的政策和制度环境?
政府应该如何成为 AI 发展的推动者?
世界银行 2026 年《世界发展报告:AI 的承诺》提出,政府可以从三个身份发挥作用:AI 的推动者、使用者和监管者。
作为推动者,政府需要建立 AI 广泛应用所需要的数字和非数字基础设施。
数字基础设施包括计算资源、数据资源、互联网连接和 AI 人才;非数字基础设施则包括稳定的电力供应、基础教育、职业技能、商业环境和制度能力。
这些基础条件需要协同建设,因为单独改善某一个领域,并不一定能够带来足够收益。
作为使用者,政府可以通过公共采购和公共服务应用,推动 AI 在医疗、教育、农业推广和司法等领域落地。
政府采购不仅能够帮助公共部门提高效率,还可以为本地 AI 企业创造真实需求,使它们有机会开发和适应本地化解决方案。
作为监管者,政府需要处理隐私、网络安全、AI 系统可靠性和市场集中等问题。对于市场机制无法有效解决的社会风险,可以通过现有法律、行业标准和国际合作建立相应的约束机制。
为什么竞争政策和市场结构也会影响 AI 的增长贡献?
Bresnahan 和 Trajtenberg 的研究提醒我们,GPT 的发展与市场结构密切相关。
如果基础技术提供者拥有很强的市场权力,它可能通过定价方式影响下游企业的创新激励。如果不同应用行业之间缺少合作机制,基础技术的公共收益也可能无法得到充分利用。
世界银行 2026 年的报告进一步指出,AI 价值链的不同层级,包括芯片、基础设施、模型和应用,集中在少数国家和少数公司手中。
这种集中会产生依赖风险。对于发展中国家而言,如果 AI 的关键投入全部依赖少数跨国企业,那么技术创造的经济收益可能有相当一部分通过模型服务、芯片和计算资源采购流向国外。
这意味着,AI 带来的生产率提高并不必然全部转化为本地收入和利润。
因此,我认为发展中国家需要在开放使用全球技术与建设本地适应能力之间寻找平衡,而不是简单追求建设自己的所有底层模型和基础设施。
世界银行也强调,建设前沿 AI 模型是最困难、成本最高的路径。对多数发展中国家而言,更现实的策略是先采用现有技术,再根据当地需求进行适应,最后在具备相应能力后推进更高层级的技术研发。
为什么必须降低劳动者的技术调整成本?
AI 的长期经济收益可能来自劳动生产率提高、任务重新分配和新产业发展,但这些变化并不会自动让每个人受益。
如果部分岗位被快速替代,而新的岗位和职业能力还没有形成,劳动者可能在相当长的时间内面临失业和收入下降。
因此,政策需要关注教育、职业培训、就业转换和社会保障,帮助劳动者从被自动化的任务转向新出现的任务。
从第一次工业革命的经验来看,新任务的形成能够抵消部分技术替代效应,但如果劳动力调整完全交给市场,调整成本可能非常高。
这也是为什么我认为,人工智能时代的政策重点不能只放在技术研发和企业采用率上,还需要关注技术收益在劳动者之间如何分配。
结论:人工智能的深层影响来自整个经济体系的重新设计
回顾蒸汽机、电力、半导体和信息通信技术的发展历史,我认为,通用目的技术的核心价值从来不只是提高某个产品或某个行业的效率,而是改变整个经济体系产生创新、组织生产和积累知识的方式。
Bresnahan 和 Trajtenberg 的研究说明,GPT 具有广泛渗透性、持续改进潜力和创新互补性。基础技术与应用行业之间的双向诱导,使得技术进步能够产生超出单项创新本身的经济收益。但由于纵向和横向外部性,市场机制可能造成创新不足、创新滞后和协调失败。
Crafts 的历史研究则说明,通用目的技术的宏观经济影响通常需要时间才能显现。蒸汽机、电动机和 ICT 的历史都表明,技术改进、组织重构、互补性投资和学习积累,是技术突破转化为生产率增长的重要条件。
第一次工业革命的深层意义,是形成了系统经验主义和知识传播机制;第二次工业革命通过工业研发实验室和应用科学改变了创新方式;第三次工业革命通过计算机和互联网大幅降低了知识获取和研发成本。
人工智能可能成为第四次工业革命的重要基础,但它是否能够真正发挥 GPT 的作用,还取决于能否形成足够广泛的应用,以及能否进一步成为一种提高研发和知识生产效率的新方法。
从宏观经济角度看,AI 的增长贡献可能通过三种渠道实现:提高单一行业生产率、扩大可用劳动供给,以及提高整个经济体系的知识生产和研发效率。其中,第三种渠道可能具有最深远的长期影响。
从发展中国家的角度看,AI 还有一个特殊机会:它可以补足长期稀缺的专业知识、医疗服务、教育能力和农业信息。通过低成本模型、语音服务、本地化应用和现有通信系统,AI 有机会以较低成本提高大量小型企业和个体劳动者的生产率。
但我认为,最终决定 AI 经济影响的,仍然不是某个模型能够达到多高的性能,而是整个经济体系能否解决那些限制生产率的弱环节。
如果只有少数行业获得了极高的 AI 能力,而其他行业仍然缺乏必要的人才、基础设施和组织能力,那么整体增长仍然会受到限制。
如果 AI 能够在广泛任务中提供足够可靠、足够低成本的能力,并且能够推动企业、政府和社会组织重新设计工作流程,那么它就有可能成为真正的通用目的技术。
我对 AI 长期经济价值的核心判断是:技术能力决定可能性,互补性创新决定扩散范围,组织和制度决定实现速度,而整个经济体系中的弱环节最终决定增长能够达到的高度。
- IIO Post #1
门友发了很多值得阅读的东西,但是现在在家阅读的时间少,开车的时间多。
开车的时候听 BBC 听腻了虽然有浏览器插件可以听网页
Read Aloud: A Text to Speech Voice Reader但是不知道新增什么功能了,那就新增一个聆听功能吧。
支持自动播放下一条 post。
可以在设置里自定义音色。  ascah Post #311
宿舍之前,毕业了一个人。这人打游戏巨吵,考虑到我不想正面冲突,于是之前我都晚上晚回宿舍。其实还好,看起来我缺少了点在宿舍玩的时间,其实少被噪音吵吵几小时对身体明显更好。现在宿舍三人,结果另一个卧龙凤雏这几天仍然是高分贝轰击。国庆回来后,我打算晚上多在工位待会,起码比宿舍好。我想这几天那位应该是实验不用加班了,于是天天晚上打游戏到 12 点。我觉得既然没考虑过直接交涉,远离宿舍环境是个好方法。
话说回来,哪有研究生,尤其是博士的,白天事情不上心,但一到晚上准时来游戏的?感觉反过来了,本来这么混也是不可持续的罢了,我只是回归原始。而且早上也起不来,晚上补一补时间了-
 我有魔芋爽 Post #192
幸运星拆开字条:
天天开心,万事胜意!
万事从欢,岁岁无忧!
和门友们共勉 (˶ᵔᵕᵔ˶)♡ - 我有魔芋爽 Post #200
10.25
从今天开始我要拼命练习表达自己!线下也是如果有人让我闭嘴我偏要说得更响!不能让自己被环境吃掉!
@马来蔚 如何在处于弱势时树立边界.pdf
@马莱蔚 应对当众打压.pdf
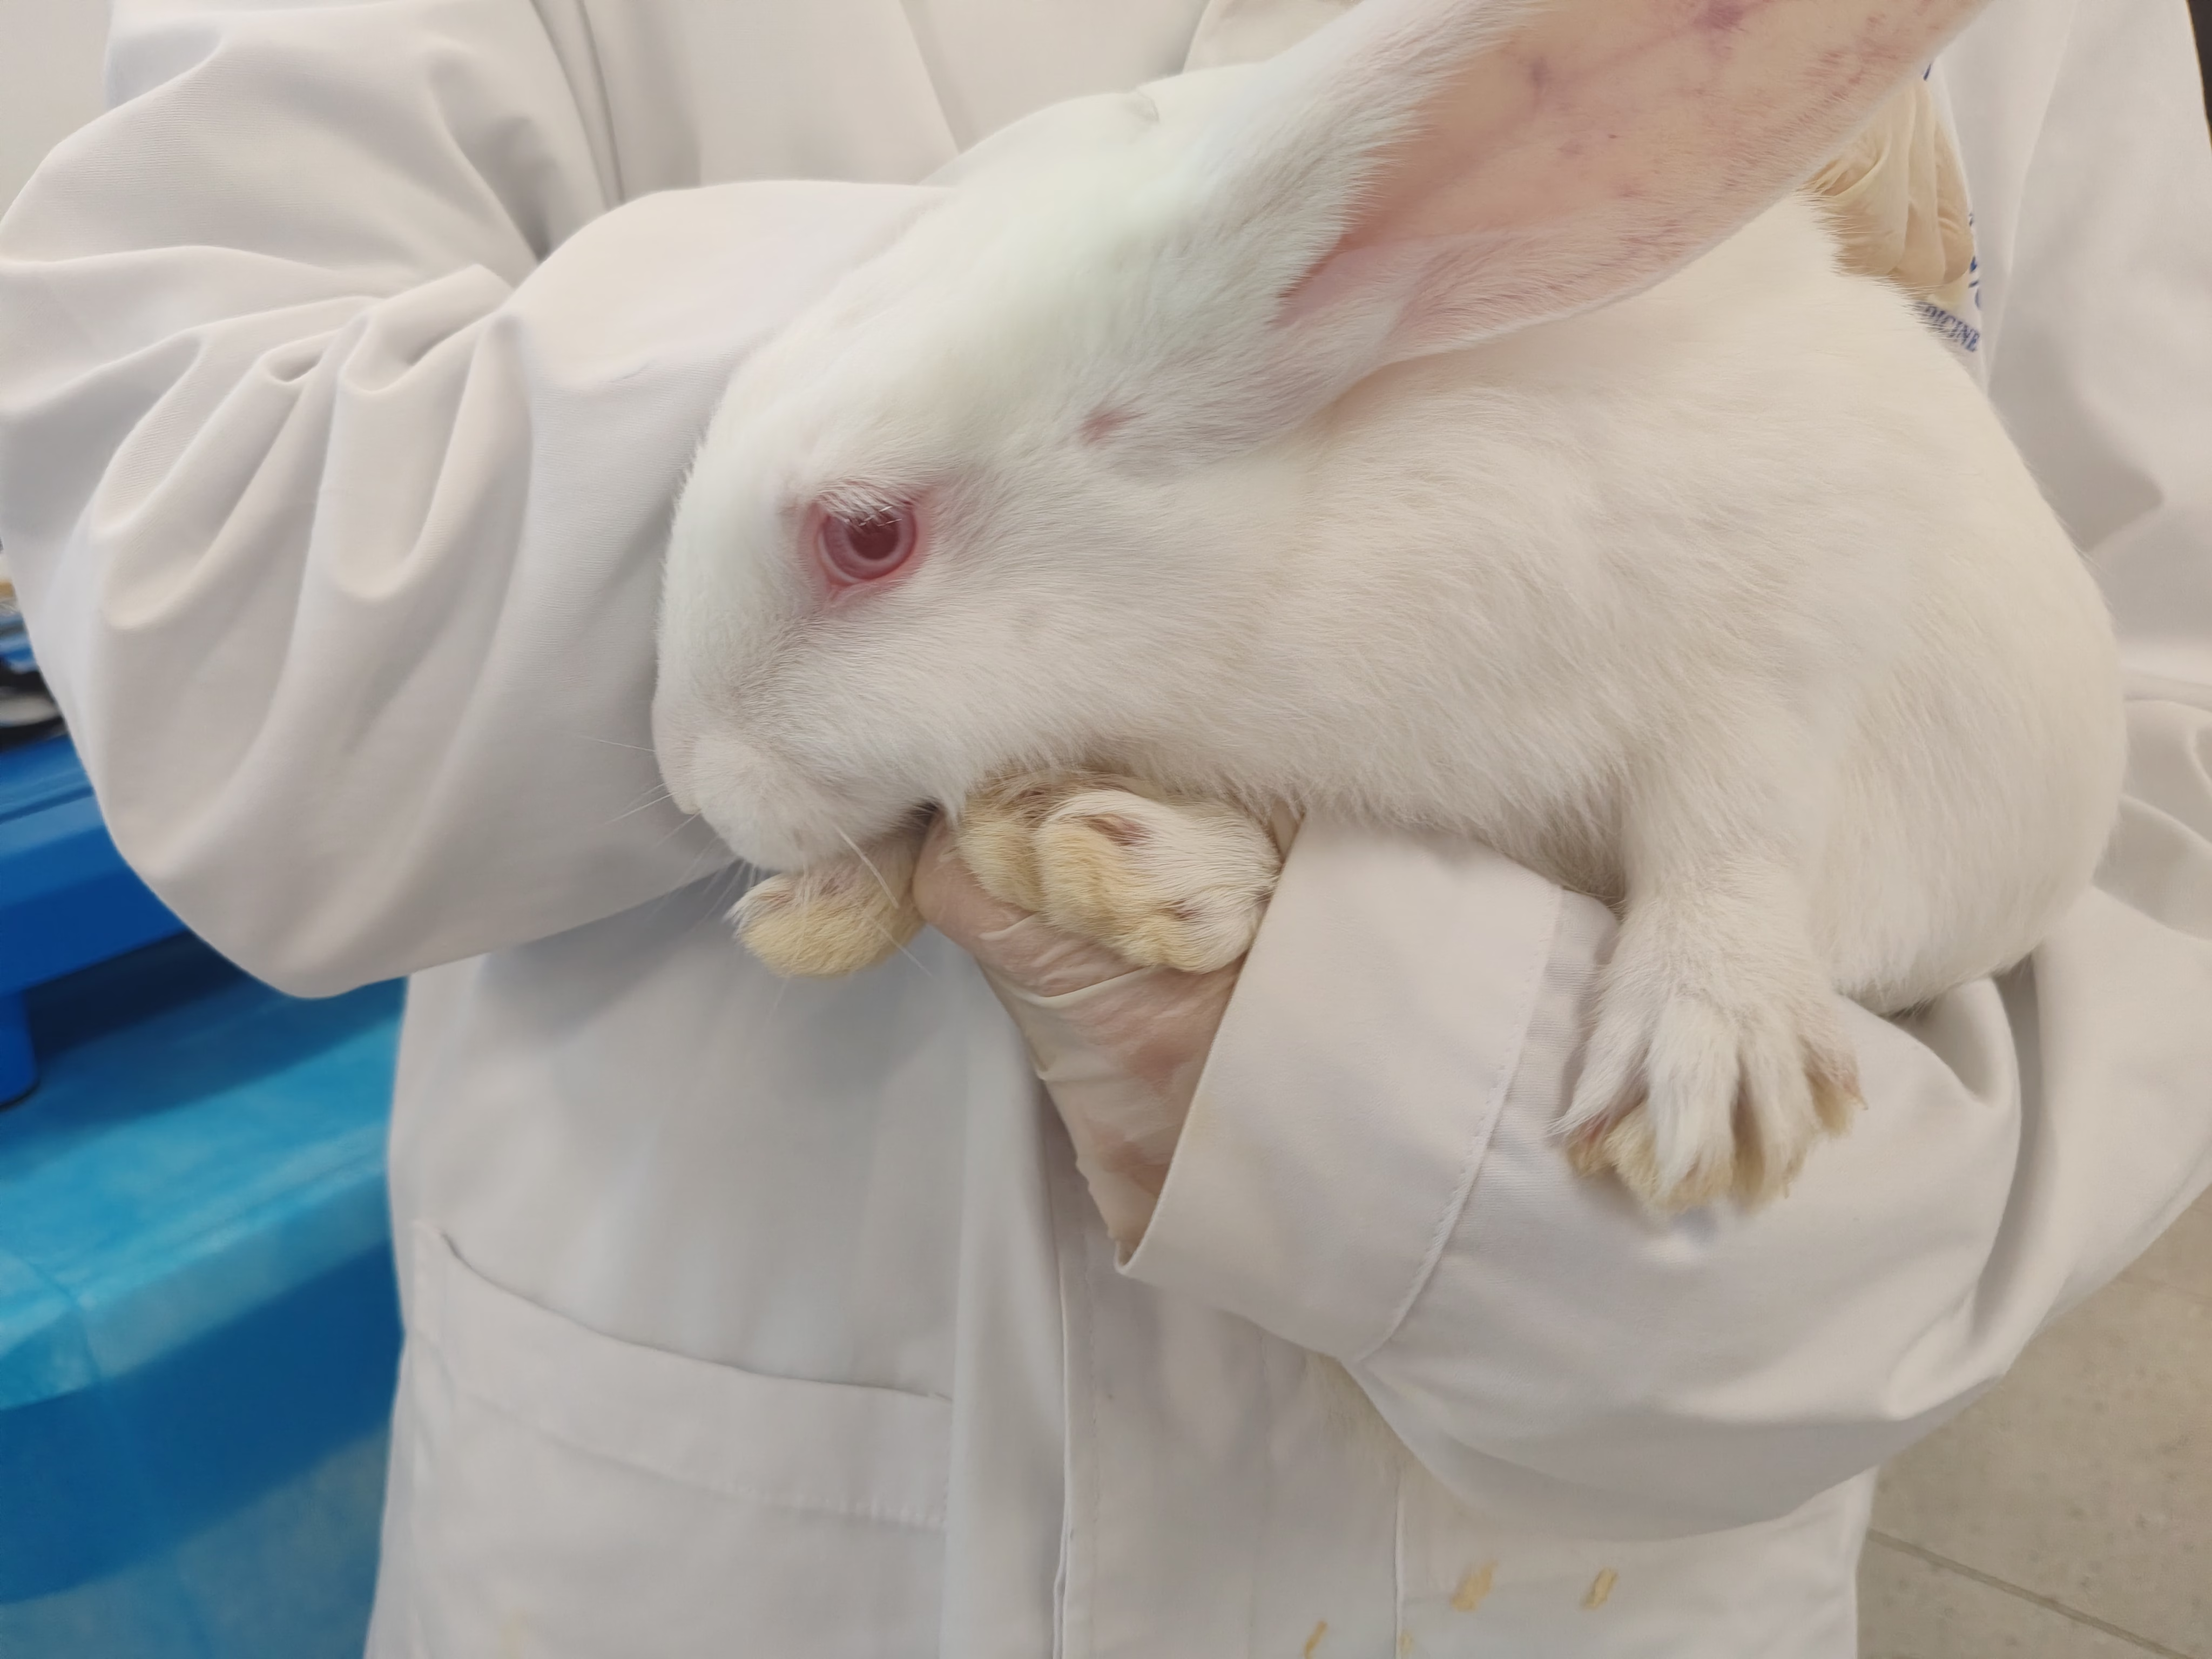
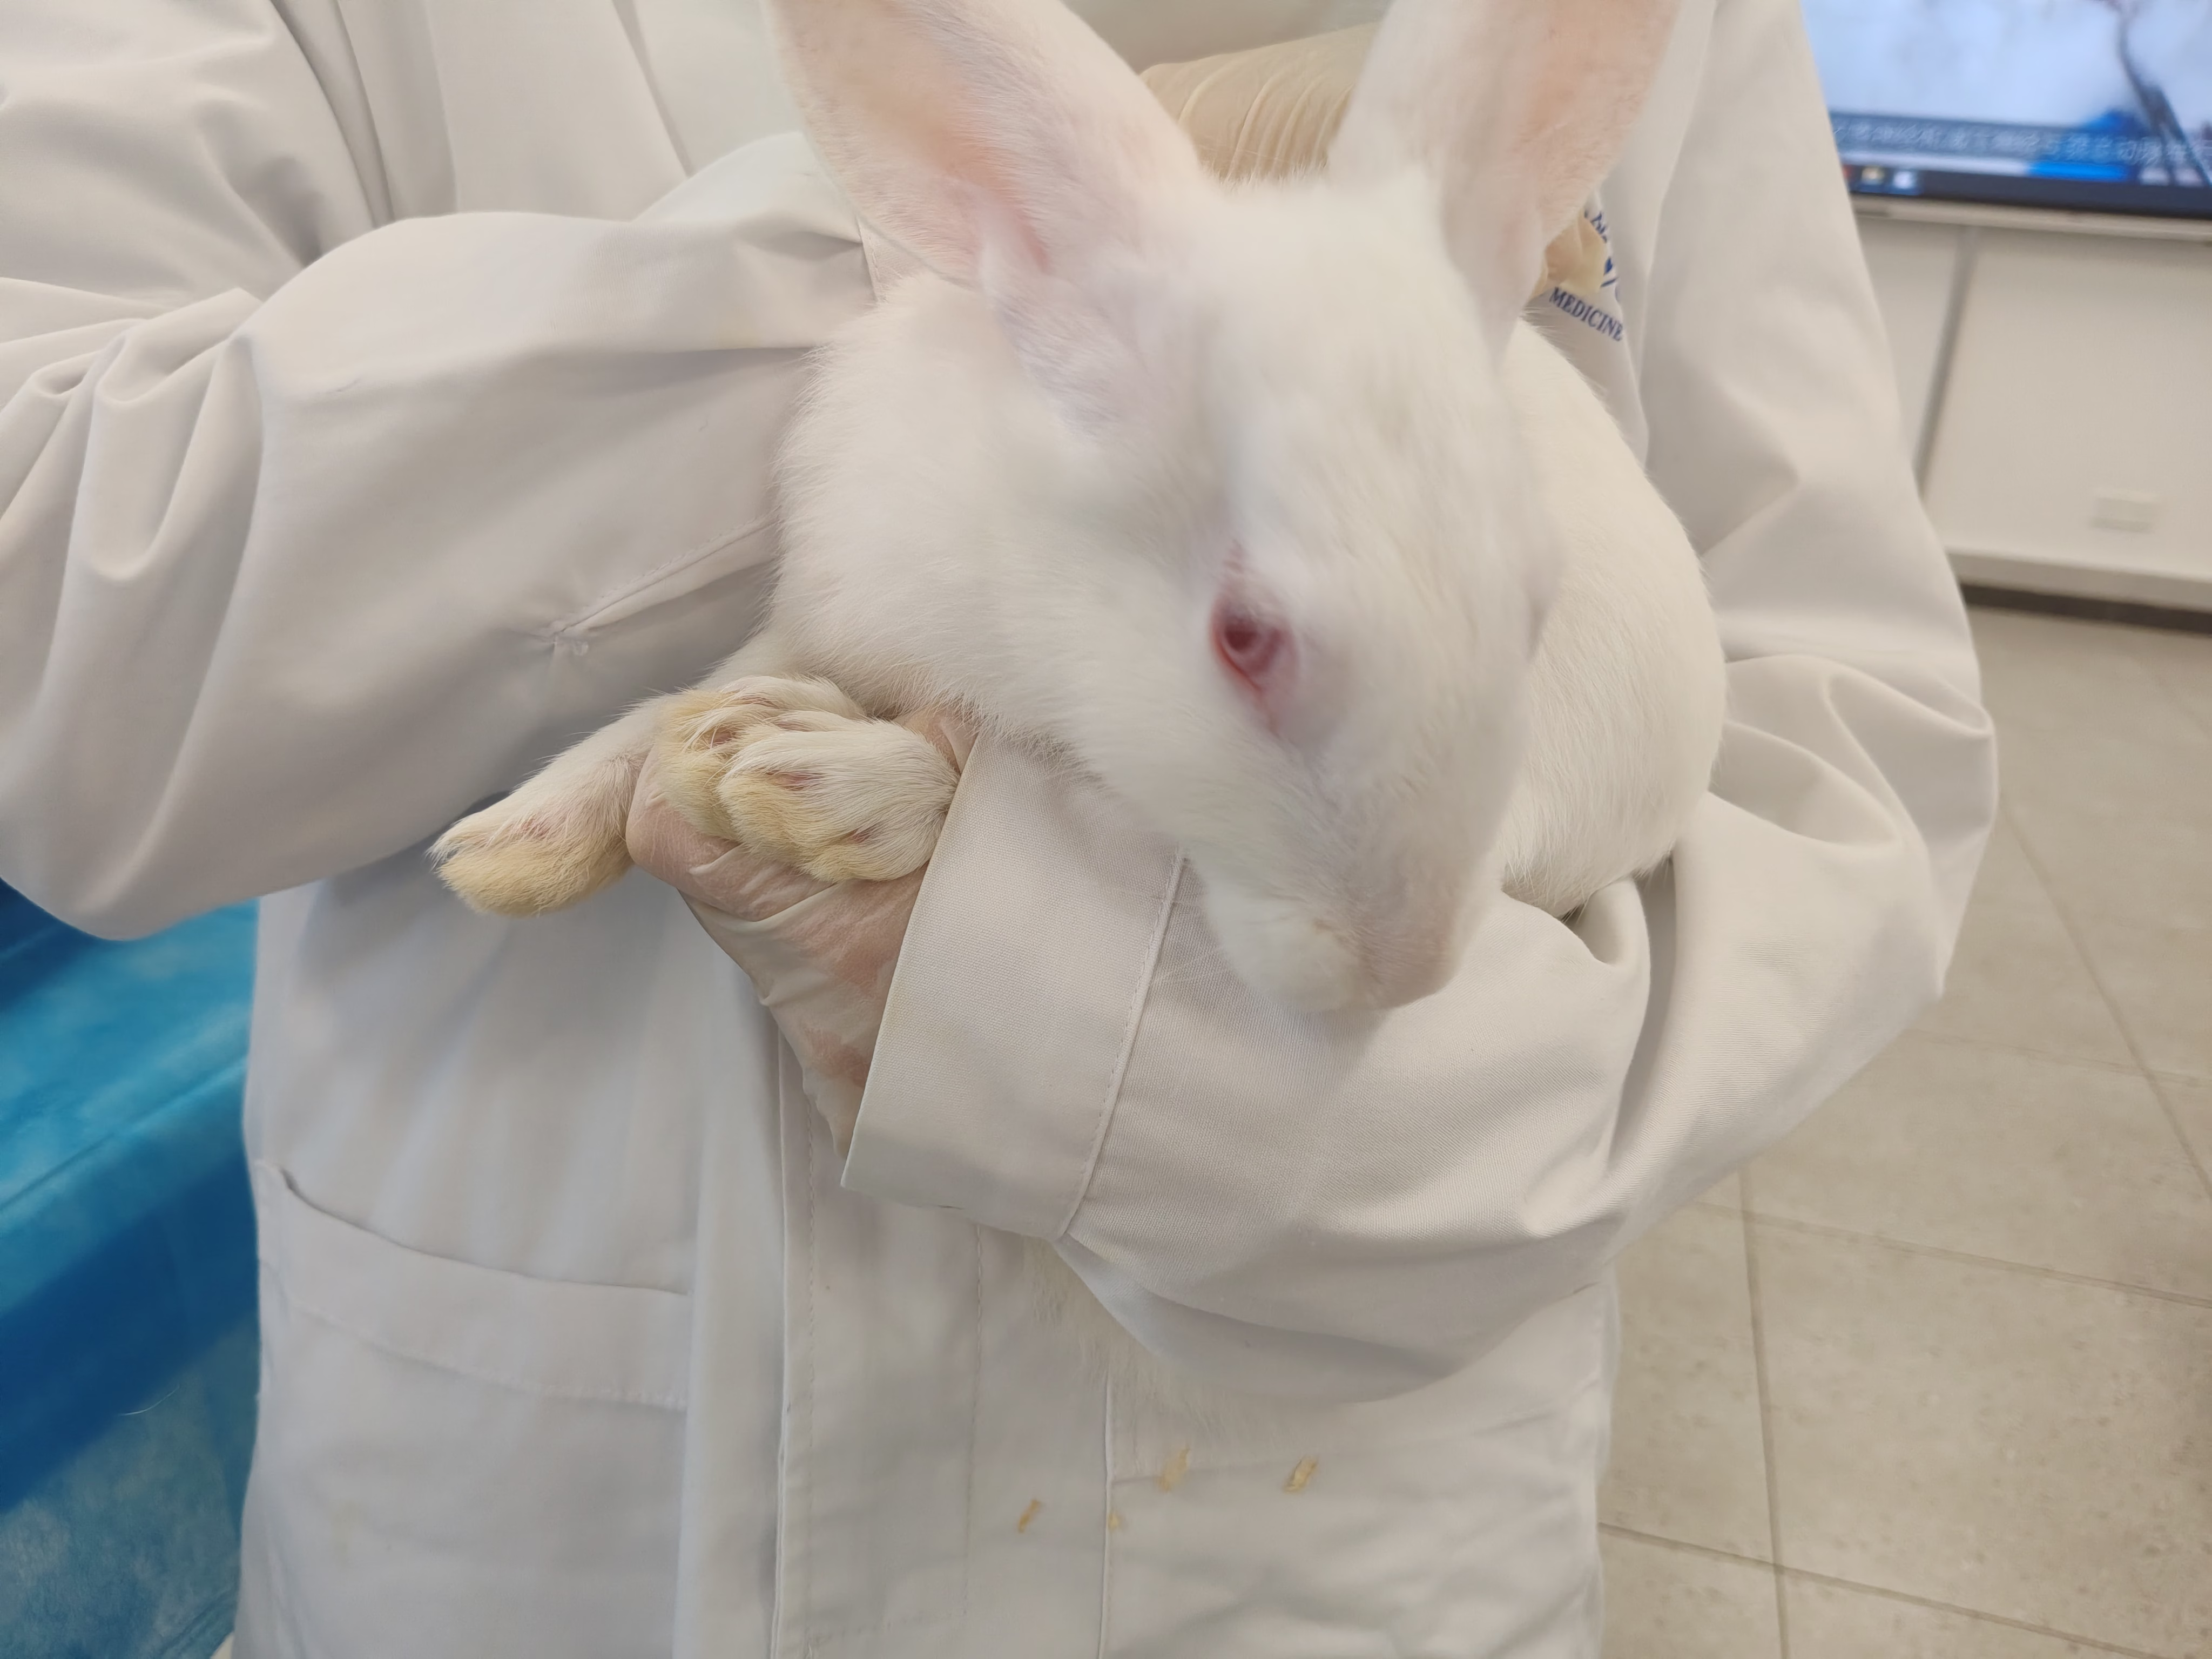
这周进行了兔兔实验,给兔兔进行了气管插管,并测定了通入不同气体对呼吸波的影响
兔兔比小鼠温顺乖巧,我们这组的格外乖,脚也不会乱蹬
 Jerry Post #1
By Poshen Loh
在 AI 日渐强大的今天我们应该何去何从?lz 现在大三,处于需要认真思考今后发展方向的关键时期。眼看许多工作看起来都可以被 AI 替代,lz 现在感觉十分迷茫和焦虑,开始怀疑人生的意义和价值,此时,这个视频解答了 lz 心中的一些疑惑,希望对你也有启发,共勉!
在 ChatGPT 问世后不久,我开始在全国各地奔走,告诉人们:"哦不,出现了新事物,人们需要学习变得更有创造力,因为那是 AI 唯一做不到的事情。"我现在不再这么说了,因为我已经看到,AI 实际上能想出非常非常多的点子。
去年,国际数学奥林匹克竞赛 (IMO) 的题目,其中有四道被谷歌的人工智能解决了。IMO 有六道题,所有这六道题都非常非常具有原创性。它们如此原创,以至于当各国教练聚在一起时,他们都会审视这些题目,并尽力确保在世界上任何竞赛或任何地方都从未出现过与这些题目过于相似的问题。这些题目本应极具原创性。但尽管如此,人工智能还是能够想出其中四道题的解法,这比我所能做到的还要多。AI 的创造力很可能也超过了我们所能达到的水平。
人类智能唯一独特之处在于,我们——但愿如此——在乎人类是否依然存在。
我是罗博深。我是一个喜欢解决现实世界问题的数学家。在现实生活中,我是卡内基梅隆大学的数学教授,但我同时也是一位社会企业家,一直在推行我自己的教育解决方案,试图让世界变成一个更富有思辨能力的地方。
Chapter 1 比创造力更重要的是什么?
—— 我们为什么需要写作和学习
在学校里,学生使用 AI 作弊的一个最主要领域就是写作作业。不幸的是,这可能会给人类文明带来一个巨大的问题,因为你想想,那个 AI 到底是什么?它是一个大型语言模型。为什么那个 AI 如此出色?因为它擅长语言。它擅长识别经常出现的词语模式。如果许多孩子丧失了这种能力,我们就会有很多孩子长大成人后无法进行逻辑思考。他们所能做的只是接受别人给他们的任何东西。他们只会变得依赖他人。如果你已经成年,并且已经掌握了那种技能,你使用 AI 来完成那项任务,因为那是你的工作,那很好。好吧,你是在用它来完成工作。但如果你还在上学,你为什么要做那个写作练习呢?并不是因为你写的文章能直接赚钱。不,不,那个写作实际上是你自己学习的一部分。
在学校里使用 AI 来做写作作业,就好像在说:"我不打算跑一英里来锻炼身体。我要开车一英里来锻炼身体。"你能得到多少锻炼?一点也得不到。你长大后,身体就无法那么健康。这里的情况类似,只不过是关乎心智的健康。
正是基于大型语言模型的力量在于那个"L",即语言这一观察,我们才真正需要确保我们所有的孩子——如果可能的话,而如果你正在观看此视频并且是学生——这就是为什么你们下一代需要真正精通语言。所有像阅读、写作、沟通、逻辑这样的技能,都将变得非常重要,因为这些都是你培养良好思维方式的方法。
我向人们解释,我们学习数学的原因并不是因为我们最终必须做代数运算,而是因为这最终会让你变得更聪明。这样你就能去思考你从未遇到过的情况并找出解决办法。
我面试过很多很多想和我一起工作的高中生。在面试过程中,我考察智力水平的方式是问他们问题,通常是数学问题,因为这些问题具有分析性。我会一直问,直到从他们的肢体语言中非常清楚地看出他们从未见过这个问题。因为通常如果你在做数学题并且以前见过,你的眼神里会透露出某种自信。但我会等到非常确定他们从未见过这个问题。然后我想看看你如何思考。实际上,因为你从未见过那个问题,预期是你不会解决它。然后我开始给提示。这些提示通常是他们在学校里未曾接触过的想法。然后我想看看你能多快地将这些新的提示、这些新的思维方式综合起来,为一个我们从未见过的问题找到解决方案。实际上,这也是创造力。
所以这是其中一点。但展望未来,我认为人们真正需要的技能之一,是那种真正愿意为他人创造价值和带来愉悦的特质。我为什么这么说?我这么说是因为,在过去的许多许多年里,人类一直是顶级物种,是这个星球上最有能力的存在。很快情况就不再是这样了。很快,你将不得不与他人合作才能生存。让其他人愿意与你一起合作的唯一方式,就是你成为一个真诚而深刻地、以在他人身上创造价值为动力的人。如果你不是那样的人,你就是一个糟糕的合作伙伴,人们不会想和你合作。如果他们不和你合作,你就会 DIE,你会失去机会,因为最终所有这些工作你都可以用 AI 来做。那么,为什么会有人想雇佣你呢?为什么会有人想让你成为他们团队的一员呢?大概只能是因为他们在某方面觉得你会创造一些价值,并且他们喜欢那种感觉。他们喜欢你。
我认为我们真正需要的是让越来越多的人去弄清楚真正要解决的问题是什么。但不幸的是,有时当孩子们只考虑问题时,他们没有意识到解决问题的方法是通过同理心和与他人建立联系。为什么?因为除非你能通过他们的视角来看待问题,否则你无法解决它。
我确实花了生命中相当多的时间朝着更好地模拟世界这个目标努力。我也使用 AI 来做这件事。我想举一个具体的例子。我上周刚在田纳西州的纳什维尔,我在那里的一家酒吧里看到一位我认为非常有才华的歌手。哇,她真棒。我只是有点好奇,要在纳什维尔的百老汇大道上获得一个表演席位有多难。所以我问了 AI,我实际上不只是对 AI 告诉我答案感兴趣。我想看到链接,你知道,告诉我更多。她表演的这个特定地方有什么背景?对吧?我会在了解情况后得出自己的结论。哦,哦,哦,我明白了。所以有所有这些不同的人都想做这件事,对吧?所以,如果你是被选中在黄金时段表演的人之一,哦,这在逻辑上就说得通了。看,我正在利用 AI 在我大脑中构建理解乡村音乐表演的逻辑。而我为什么要试图理解呢?老实说,是因为这些天我也与专业演艺人员合作。所以,我自己也一直在物色人才。
这其中的核心是,我没有用 AI 来替我写报告。我是用 AI 让我自己在那特定目标上变得更好。
能够模拟世界是一种超能力,它使一个人能够成为成功的企业家。模拟世界让你能够想象一个产品或想象一个策略,然后在你的脑海中推演下去。如果我这样做会发生什么?
Chapter 2 教育的下一个阶段
—— 为什么今天的教育体系让你沮丧
很久以前,当我刚开始涉足教育时,我实际上只是在思考如何帮助人们解决数学问题。今天当我回顾那段时光,我想我可能是一个在寻找问题的解决方案,从某种意义上说,呃,不知何故我认为人们擅长数学非常重要。但后来在我生活中发生的一些事情,比如我成为了美国数学奥林匹克国家队的教练,我看到了这样的情况:有那么多如此聪明、如此有能力的人仍然如此沮丧。而且,在他们高中毕业后,他们甚至不太知道接下来该做什么,因为他们认为人生的意义在于找到证明自己比别人更强的方法。那时我意识到,如果我们从一开始就思考哲学,实际上我们会做得更好,对吧?人生的哲学不应该是"我如何胜过所有其他人?"如果你那样做,你可能永远不会满足。但如果你的人生哲学是:嘿,让一群其他人开心实际上会上瘾。哦,我现在能为五个人做到。哦,我现在能为五百个人做到。哦,哇。现在我能让一千人来参加这个活动。你做得越多,你就越想做得更多。而有趣的是,这也与传统意义上的成功相关。然后我意识到,啊,我应该努力在全世界推广这个理念。如果我不去做,谁会去做呢?凭借我一生中所做的事情,我现在有机会去说,你知道,我见过如果你纯粹追求竞争到底会发生什么。我见过如果你一味地练习题目以求在考试中取得最佳成绩会发生什么。实际上,那不是正确的目标。
我意识到,因为我的背景,我将能够改变人们的思维方式。然后我说,好吧,这就是我必须做的事情。
我是卡内基梅隆大学的数学教授。我教每一堂课的方式是,我只需拿着一支粉笔走到黑板前,写下今天我们要做这个,但我忘了具体该怎么做。所以我需要你们所有人都提出想法,然后整个课堂体验就变成了学生提出想法,我则对他们的想法给予反馈。
而作为一名社会企业家,我一直在努力让每个人都能以这种方式体验教育,我们运营了一个在线项目。它叫做 LIVE。我们找到了一种扩展批判性思维教育的方法。你看,限制因素是要有足够的教练来引领所有这些批判性思维和头脑风暴。我们通过创造双赢局面来扩大规模,只是观察到学习批判性思维的最佳年龄之一是当你 10 到 13 岁的时候。而事实证明,能引领 10 到 13 岁孩子进入思考乐趣的一些最佳人选,是大约 15 到 18 岁的高中生。但我观察到,有大量 15 到 18 岁的孩子已经在学业上非常聪明,尤其是在数学方面。他们人生最终的限制因素将不是他们的科学、技术、工程或数学能力。而将是沟通技巧、自信心以及赢得任何人支持和领导团队的能力。所以,我创建了一个项目,我们寻找善良且在数学上聪明的高中生。然后我雇佣专业喜剧演员和演员来教他们如何变得有魅力,以及如何能够赢得任何人的支持,因为如果你能说服任何人爱上数学,你就能说服任何人做任何事。所以,通过这种交换,他们接受演员的培训。他们辅导数学。呃,在他们辅导数学的同时,我们付费请一位演员观看他们辅导数学的每一小时。演员给他们实时反馈,帮助他们变得更有热情、更有同理心,拥有更吸引人的个性。双赢局面。现在,高中生直接受益,他们的生活变得更好。作为回报,他们为全国各地的孩子提供所有这些批判性思维课程。
这种架构的核心在于它连接了人们。我们正在向中学生介绍善良且善于思考的高中生,帮助他们看到,嘿,你可以成为这些优秀的人,他们享受乐趣,同时也拥有非常充实的生活。而且我们执行整个项目的方式是,高中生们都成对教学,这不仅让学习数学的人体验更有趣,而且让这些善良且真正聪明的人得以相互认识。因为我不知道未来我们将面临什么样的挑战。我认为挑战会相当大,而技术将使得我们面临的任何挑战都变得规模巨大。所以,我们还需要有一个由善良、聪明、彼此认识且相互信任的人组成的大型网络,这样,如果出现一些威胁文明的挑战,那么也许会有一些人站出来,共同努力做点什么。
这就是我走遍全国和全世界时所关注的事情。我实际上在思考人类社会的韧性。是否如果由于技术而出现某个全球性挑战,我们人类文明是否有能力崛起并面对那个挑战?对我来说,一切都始于思辨能力。
Chapter 3 AI 偷走的两样东西
Taste: AI's first Theft
我所做的工作真正专注于培养自主的人类思考能力。这就是为什么我用于哲学核心的词是"thoughtful"。多年来,我观察到人们对思考越来越不感兴趣。我认为这实际上是因为人们发现他们可以用 iPad 来自娱自乐,这不幸也使得人们没有那么多兴趣去专注和思考某事。AI 可能会让这种情况变得更糟。
生活的乐趣在于为你自己的生活做出你自己的贡献。实际上,我认为这就是人们真正喜欢创造力的原因。这很有趣。人们喜欢画画。人们喜欢加入自己的风格。人们喜欢自己的时尚。它表达他们自己。这种自我表达,如果你所做的一切都很高效但仅仅依赖 AI 告诉你今天该怎么穿,那就会丧失。这就是为什么我希望越来越多的人发现思考是有趣的。为你的事物加入你自己的巧思、你自己注入的想法是很有趣的。
Truth: AI's second Theft
如果人们失去思考和推理的能力,发生的另一个危险是,这会使得欺骗人们变得容易得多。世界是如此复杂,以至于如果你观察世界上的任何情况,有时取决于你如何讲述所发生的故事,你可以说出全部真实的陈述,却让你得出不同的感受。我认为人们保持批判性,以及人们能够理解真正发生了什么,是非常重要的,因为有时当有人和你谈话时,他们是有目的的。坦率地说,我就是有目的的。我试图建立一个更富有思辨能力的世界,我会非常非常坦率地告诉你这一点。任何观看此视频的人,我认为非常重要的是,我们让尽可能多的人发现让他人愉悦以及拥有思考并找出如何做到这一点的能力是多么有趣。这就是我的目的。但你看,每个人都有目的。如果你不能为自己思考,而只是听信某个权威,如果那个目的实际上对你有害呢?你将无法知道。
技术革命确实让我们所有人都开始意识到偏见的影响有多大,从某种意义上说,任何制造技术工具的人都有某种偏见。偏见到底是什么意思?嗯,我想,作为一名数学家,我的说法是:二加二总是等于四。这是正确的。人生的意义是什么?哦,我不知道。就像,没有明确的定义。人生的意义是什么?我认为人生的意义是尽可能让更多其他人感到愉悦,但我知道你可能不一定同意,这没问题。我认为我们可能有不同的出发点,这是健康的。变得不健康的部分是,只有非常少的选项菜单,而每个选项后面都跟着大量的人。这实际上就是偏见产生的地方,因为我们刚才在这个视频中只提到了几个不同的 AI 提供商,对吧?我们有 Claude,我们有 OpenAI,还有 Gemini。如果你在中国,还有 DeepSeek。有所有这些,但相对来说还是很少。如果你仔细想想,这有点像在说,嗯,世界上有很多不同的观点。有五种。真的吗?不。不。世界上有七十五亿种不同的观点。有七八十亿人。我想,人性中一件美好的事情就是有那么多不同的想法存在。坦率地说,有些想法是坏的。有些人很不幸在监狱里,因为他们决定杀死别人。希望我们都明白这是个坏主意。但关键是,有很多不同的人在尝试不同种类的想法,很多不同的哲学。在这个作为世界的伟大思想市场中,我们看到一些想法脱颖而出,而这种多样性也许也让我们拥有更多的创造力。
当我观察不同的 AI 工具时,嗯,实际上众所周知它们有某些偏见。这也是为什么当我试图获取新闻时,我不只去 CNN.com。我也去福克斯新闻。我调教我的社交媒体,让我的 X 全部追踪共和党右倾观点,而我的 Facebook 全部追踪左倾观点。我每天都看两者,因为我想了解发生了什么。我的预期是,是的,你会有偏见。你对世界有某种看法,并且你认为你是对的。而你也有偏见。你有一种思考世界的方式。我模拟世界的任务就是试图弄清楚你们在哪里有分歧?啊,你们可能在一些关于人们应该如何生活的价值观上存在分歧。然后这导致你们以不同的方式报道故事。
我认为现在 AI 出现了,它听起来像一个非常有说服力、通情达理的人,这就更加重要了,人们要看事情并说:"好吧,那真的是全部真相吗?"因为我认为 AI 将非常擅长将一个完整的故事,以至于你可能认为你已经掌握了关于一个有争议情况的全部故事,但你并没有。
Chapter 4 如何依然保持希望
我是一个乐观主义者,你大概可以从我说话的方式看出来。我乐观是因为我能看到有思辨能力的人会团结在一起。我从事这项工作,与这群高中生等等一起已经 3 年了,我可以看到有那么多孩子——他们不再是孩子了——正在成长,他们非常聪明,但又如此善良,而且他们也彼此认识。他们让我对未来感到乐观。不仅是我共事的这些人,而且因为我在与这些人合作,这意味着外面也有其他人。我基本上亲眼看到了,如果你把那些共同拥有"他们实际上喜欢人们并且想让世界更光明"这一想法的人聚集在一起,所能产生的力量。
看,我建立这个由真正善良和聪明的人组成的社区的一个原因是,我也希望最终培养出大量的社会企业家。社会企业家是这样一个人,他做出有意识的决定,不一定要变得非常富有。你这样做是为了一个不同的目的。不是因为你想要很多钱。而是因为让你快乐的是看到很多愉悦的人。社会创业是困难的。困难之处在于,有时在开始时你觉得这是一个需要解决的重要问题。为什么人们不付钱让我去做呢?我需要捐款或投资之类的。我就是这样起步的。今天当我进行社会创业时,我会非常仔细地思考那个问题实际上需要多少成本?你知道如果有问题,就有真实的成本。事实上,应该有可能赚钱。"企业家"这个词希望也包括通过商业形式实现可持续性的含义。一个好的社会企业应该在他们帮助的每一个人身上都获得净利润。对吧?社会创业有时出现的问题是,人们在做一些本来解决掉会很好的事情,但他们没有找到方法将这与解决一个具有真实货币价值、你能找到人为之付费的问题联系起来。你应该 hopefully 能够弄清楚这个问题让世界付出了什么代价。啊哈。现在试着找出目前是谁在支付那个成本,看看也许他们是否有兴趣付钱让你去解决那个问题。你只需要去寻找,我如何才能弄清楚所产生的积极效益如何平均分摊给每个参与者,然后你也能得到一点点。这实际上就是我们所做的。例如,我们提供所有这些教育,因为我们为世界上需要拓展提升的中学生提供了最好的课后数学课程。我们有很多客户。他们为此付费。所以,我们有利润。但因为我是社会企业家,我们补贴来自全国和世界不同地区的学生。
为什么以前没有人想过聘请专业演员,在现场直播数学课给中学生时,实时指导那些善良的高中数学明星呢?而这整个事情构建了一个生态系统,构建了一个更富有思辨能力的世界,有望有助于维系我们的人类文明。这实际上是一个显而易见的想法。有演员。有数学人才。我们都能赢。
我花了 11 年时间才真正达到我现在这个阶段。花了 8 年时间才想出那个主意。你可以想象一路上产生了多少其他奇怪的想法。每当我看到世界上的任何事物或我需要做的事情时,我都会尝试不断想出新的、奇怪的方法来做这件事。为了乐趣,我喜欢不断地思考,有没有另一种方法?有没有另一种方法?有没有另一种方法?当我这样做的时候,大部分时间我想出一个方法,然后下一个问题就变成了,好吧,它可能有什么问题。所以我首先是这样生成想法:我想生成新想法,新想法出现后,我说现在我想摧毁这个新想法。我想把它击倒。它怎么可能出错?因为我生成的 99% 的新想法都存在根本性的缺陷。但 1% 是好的。你只需要不断地为了它本身而问,做这件事有没有另一种方式?做这件事有没有另一种方式?所以这种结合——带着兴奋去生成,付出大量努力去摧毁,然后过一会儿,一颗钻石出现了,然后就推动它。
- ZZethes Post #1
3b1b (Grant Sanderson)
从未有过比现在更好的时代去投身数学
数学世界正在燃烧
让我们好好谈谈这件事。感觉整个数学界都在为 AI 在数学中的角色而沸腾。我已经思考这个问题很久了,所以上周我发了一条帖子,征集大家关于这个话题的疑问。我看到的很多评论来自学生——也许是博士生,也许是本科生——他们原本计划进入数学或相邻的理论领域,现在却基本上只是在问:"我该怎么办?当未来看起来如此不确定时,我接下来该做什么?"有很多恐惧,认为数学已死,或者数学已被解决,又或者即使你不相信那些说法,数学未来将变成的那个东西也是令人不快的、不是你真正想做的事情。我也和很多教授交谈过,他们基本上就是双手一摊,说:"我该怎么告诉我的学生?在这个时刻,我该如何给他们建议?"所以我想在这期内容里聚焦于我看到的一条具体评论,它如此具有代表性,仿佛浓缩了无数其他声音。一位数学博士说:"就告诉我明天该做什么吧。"
所以我想提出一个论点,我也想看看你是否同意我的观点——那就是从未有过比现在更好的时代去投身数学,从未有过比现在更好的时代去资助数学。也许我们在这个时刻将看到的最激进的变革,是对我们如何分配学术荣誉的重新定义,但数学的实际制度及其本质,即使在机器能做到数学家目前能做的所有事情、而且做得更好的假设性未来中,依然出人意料地不受影响。
在这期内容的第一部分,我只想搭建一个框架,展示我一直在如何思考这个问题。我们列出数学家所做的所有事情,然后列出数学对世界的所有价值,再思考资金从哪里来,以及后两者之间如何相互关联。我认为这对任何职业都是一个有用的练习,无论 AI 是否存在。但一旦 AI 进入讨论,你可以做的就是问:假设机器在每一项任务上都比人类做得更好,甚至比所有任务都做得更好,会发生什么?我当然不可能声称能精确预测会发生什么,我想给我在这期内容中所说的一切加上非常宽的误差范围。但大体上,我想尽我最大的诚意去尝试想清楚这些问题,并带着你一起思考。顺便说一句,也许值得先说明一下,我对于是否希望更多人进入学术数学这件事并没有切身的利害关系。事实上,如果非要说点什么的话,我一直认为也许有太多学生出于错误的原因去攻读博士学位。你知道,如果你一直喜欢学校、一直擅长学业,那么继续某种形式的学校教育是非常舒适的选择,博士项目感觉就是那种延伸。而你应该问的是:你想如何为世界上的其他人创造价值?你如何利用和发展自己的技能来更好地做到这一点?也许学术研究是实现这一目标的方式,但也许不是。问这个问题很重要。例如,很多因为当下形势而离开学术界的人,他们的动机是觉得他们能做的最好的事情是 AI 安全。如果那是你,很好,去做吧,跑起来,跑起来,跑起来。但我现在主要想对话的是那些出于恐惧而考虑离开的人——出于对这个职业将不复存在的恐惧,或者它将不再是他们会享受的事情的恐惧。因为我真的相信,不仅这个职业将继续存在,它将变得极其有用,也许比以往任何时候都更有用,而且也将充满欢乐。
数学研究的构成
那么,数学研究究竟包含什么?最显而易见的是证明定理。很多人把时间花在这上面。我们有这样的老套说法:数学家是一台将咖啡转化为定理的机器。但每个人都知道,这远非全部,而且这也是当下讨论中非常重要的一部分。有一句很好的话是这样说的:好的数学家证明定理,伟大的数学家提出猜想,而最伟大的数学家书写定义。所以我们可以把这一项也加入我们的清单。除了证明定理之外,你还有一种活动,就是决定什么值得去问。这里面有大量的品味判断——对某个想法是否足够有趣、是否能产出好的数学有一种特定的感觉。然后,与其说"书写定义",我想加入第三个类别:理论构建。你有一堆已经被证明的定理,或者你对哪些问题值得去问有某种感觉,但你真正想要从中获得的是对到底发生了什么的一种广泛理解。你知道,当笛卡尔引入笛卡尔坐标时,他回答的并不是某一个具体问题,那是一整个思维框架。或者当伽罗瓦引入群论的最初种子时,其意义与五次方程的不可解性几乎没有关系,而在于那是一种全新的概念化方式,一种看待正在发生之事的方式,它将在随后的几个世纪里催生出一片极其繁茂的、高度有用的数学领域。我觉得格罗滕迪克也是这方面的好例子。他有各种各样的隐喻式表达方式,其中之一是:如果你试图从一座山顶到达另一座山顶,一种方式是解决所有问题——像走下山谷再爬上另一座山那样——而另一种方式是让海平面上升,在两座山之间涨起潮水,然后从一座山顶驶向另一座山顶。这个比喻中,上涨的海水就是你构建的所有理论——不一定是证明某个特定的定理,而是给出对到底在发生什么的更深层整体理解。你还有应用这个组成部分,即弄清楚所有这些抽象如何嵌入科学和工程之中。在所有这些类别中,另一个隐含的部分是将所做的事情清晰地传达给他人。这不仅仅是吐出一个证明,而是给出一个有合理动机的阐述,说明那是什么。或者在构建理论时,不仅仅是列出一堆定义——伟大的数学家会有效地传达为什么这些是值得参与的结构,并试图在其中传递他们的某些品味。
数学的价值
转到价值这边,最显而易见的是应用——对科学和工程的相关性。每个人在纯数学的基金申请书中写的都是,有时候这些应用可以非常下游,几十年甚至几个世纪之后才显现。让我举几个经典例子:十六世纪一群意大利人试图解三次方程,其中一个奇怪的技巧涉及认真地对待负数的平方根。将那个理论构建沿袭几个世纪,你就得到了虚数,而虚数是量子力学、电气工程、波动研究以及几乎所有东西的关键组成部分。关于欧几里得第五公设的问题导致人们发展了非欧几何,然后……你得到了广义相对论。对费马大定理的追求在代数几何和椭圆曲线等领域周围建立了所有这些美丽的理论,而这些理论反过来又出人意料地在密码学中变得有用。这样的例子非常多,人们喜欢列举它们。
数学价值的另一个组成部分不在于社会应用层面,而在于个人层面——做数学的实践和经历成为数学家训练的一部分,会给你留下一系列问题解决技能,这些技能看起来具有非常强的可迁移性。所以经济中有大量其他领域的人——进入计算机科学、机器学习研究、现在的 AI 安全、金融、密码学或所有这些领域的人——他们曾接受过大量数学训练。也许只是在数学系上了几门课,也许甚至拿到了数学博士学位,但最终没有成为数学家,而是将所有这些技能用在了别处。看起来这里确实有某种可泛化的东西。有一种关于如何找到正确抽象、如何进行这种问题解决的方式,使得人们在别处更有价值。
价值的第三个类别常常被低估,但我认为它将变得越来越值得被欣赏,那就是纯粹的审美。做数学本身就有一种欢乐。就我个人而言,我觉得有一种非常特定的情感——当我参与一个好问题时,脑海里会有一种咔哒声。我看到它将如何被解决。或者当我在脑海中持有一个我尚未深入参与的某种新理论,我看到它如何组合在一起,它就给了我一种完全不同的思考方式。我认为数学中有很多不同的部分都有那种重塑你思维的感觉。任何上过线性代数课的人,余生说话都会稍微不同——他们会用"正交"这样的词来谈论想法。或者参与范畴论的人,有时候会觉得自己的大脑被翻转过来,获得了一种全新的、令人满足的思考方式。就是很美好。如果你和数学家谈论是什么促使他们进入这个领域,不是每个人,但我认为对很多人来说,这实际上就是原因。做数学有一种特定的欢乐,一种特定的艺术愉悦。我也认为这有助于解释你现在看到的人们对 AI 进入数学的强烈反应——它如此强烈地呼应了艺术家们对 AI 与艺术的反应。这很难受,因为在某种意义上,感觉它侵犯了一种特定的艺术形式。
数学的资金来源
但如果我们把这当作一个职业而非爱好来思考,如果没有资金来源,这一切都不重要。那么数学的资金从哪里来?一个大的组成部分是教学。很多数学家是数学教授,他们在大学里,在数学系任教。数学系本身通常教的学生远不止数学专业的学生,所以它们对学分学时和学费有超比例的影响。然后是公共资金,当然,比如在美国我们有 NSF 拨款。我们也有来自各种机构的私人资金,比如西蒙斯基金会,有时候也会有工业界的资金。在这些类别中,顺便说一下,就资金来源而言,教学是最大的一个,这对于数学来说与其他科学相比有点特殊,因为研究相对廉价,而通过数学系的学生范围相对较广。
好了,我们即将进入想象 AI 在数学研究栈的各个部分变得比人类数学家更擅长时会发生什么的练习。但首先,也许值得明确价值栈和资金栈之间的关系。例如,后两个价值来源——问题解决能力和审美欢乐——是个人性的善好,它们只被做数学的那个人所体验。公共资金的存在不仅仅是为了支持圈内人从事某种有声望的、审美上令人愉悦的爱好。我认为更好的思考方式是,后两个价值来源基本上通过教学这个环节流经资金链。在大学数学系走廊里走过的学生,很大程度上是为了培养技术性的问题解决技能,希望这些技能在别处有用。其中一些人也是为了审美上的欢乐——我知道我是。虽然拥有数学的其他好处——它锻炼了一种通用技能集的肌肉——是令人安慰和认可的,但对我从那个数学系获得的大量价值的一个诚实描述是在审美那一边。对社会的益处当然来自下游应用。但我认为有更多值得承认的共同利益。例如,数学普及——像这个频道或 Numberphile 上发生的事情,或者数学家做报告时——真的是一种试图将那种审美欢乐更广泛地分享给社会的方式。而且,就什么为公共和私人资金提供正当理由而言,即使每个人都围绕下游应用来写他们的基金申请,我认为一个更重要的正外部性是:你有一个机构在培养一群具有某种问题解决能力的人,吸引他们从世界各地来到有声望的大学,然后他们中的大多数不会成为数学家,而是带着那些可迁移的技能溢出到经济的其他非常有用的部分。仅这一个组成部分,我认为,就是对指向那个机构的每一美元的一个非常有意义的投资回报——至少在其真正培养好的问题解决技能、且那些问题解决技能确实可迁移的范围内。
当机器比数学家更擅长证明定理
好吧,让我们进入核心。如果 AI 在研究栈的各个部分变得擅长,会发生什么?当我们进入第一个区块——假设机器在证明定理方面比数学家更擅长——之前,也许值得退后一步,总结一下刚刚发生了什么。像我说的,我一直在思考这个问题。实际上,Three Blue and Brown 背后一直在进行的一个安静项目是,从 2025 年中期开始,我一直在录制与数学家的访谈,只是为了听听他们对 AI 在数学中的存在有何感受。我的一个广泛结论是:在任何一个时间快照中,现状被高估了,但速度没有被高估。例如,回到 2023 年,我记得收到一位朋友的短信说:"你知道,DeepMind 是不是刚刚碾压了奥赛级别的几何?"他指的是 DeepMind 发布的某个模型,能够回答 IMO 级别的几何问题。当时,答案是:我想是吧,但它也显然不是我们所说的"解决 IMO 级别问题"的精神。它感觉非常定制化和暴力,而很多问题应该需要一种创造力和想象力的元素。但如果你快进几年,自然语言模型——甚至不是定制化的——就能以任何合理的定义来解决 IMO 级别的问题。或者今年早些时候,你开始看到针对所谓 Erdős 问题的证明出现——一位伟大的数学家 Paul Erdős 提出了很多不同的问题,他对什么构成好的猜想有很好的品味。这些问题有一个编号列表,自然意味着模型公司喜欢用它作为一种基准。无论这是否是一个好的基准,你开始看到越来越多这些问题的机器生成证明。在早期,很多人说"是的,是的,但如果你仔细看,很多只是低垂的果实——是人们没有尝试过的问题,或者问题已经被解决但没有被很好地记录,模型基本上只是在重新包装那些东西,但没有做荣誉归因"——这当然是一个大问题。但如果你快进到此刻,没有人再说我们看到解答的那些问题只是低垂的果实了。这些是很多非常严肃的问题,数学家们曾非常努力地寻找证明,而 LLM 正在输出证明。这里我也想非常清楚地说,即使你抛开那些头条新闻式的结果——比如 OpenAI 最近的那些东西,Navier-Stokes 相关的或者他们发布的几百个问题——这也是真实的、值得讨论的。如果你和一线的数学家交谈,看他们与这些模型的互动方式,至少对其中一些人来说,你会听到的是:他们向某个推理模型提出一个严肃的研究问题,得到的东西是他们觉得有洞察力的。当然,这在不同领域和不同人之间差异很大。前沿在分形层面上是参差不齐的,绝不均匀。围绕这些证明的呈现方式也有大量争议。不想淡化其中任何一个的重要性,但我认为这里宏观的万英尺高空视角是:四年前,这些东西甚至不能正确地做加法。它们能够做竞赛级数学的速度比任何人预期的都快得多。它们从那里跳到做任何与研究相关的事情的速度也比很多人预期的快得多。所以即使说定理证明已经被解决了是一种夸张,即使我们看到的大多数证明只是离人类数学家的贡献——通常是最近的贡献——一步之遥,即使"定理证明被解决"意味着什么甚至都没有被很好地定义,鉴于过去四年的进步速度,为了论证的目的,为了那个试图展望未来、推测什么在他们未来中是稳定的第一年博士生,让我们就假设机器在数学的证明生成方面在范畴上更擅长。
那么会发生什么?简而言之,我认为它对价值栈几乎没有影响,因此对资金栈也几乎没有影响,但它对数学制度的文化和荣誉分配系统有非常巨大的影响。仅看价值栈那一边:应用,像我之前说的,几乎总是来自理论构建那一边。重要的不是五次方程不可解的证明,而是群论的创造,而群论反过来有诸如让人们假设夸克可能存在这样的影响。重要的不是费马大定理的是或否答案,而是从中涌现的所有数学及其应用。有时候你可以说定理的陈述本身就有某种效用。一个例子可能是:如果你在追求核聚变,你想要一个磁场处处非零的系统,毛球定理告诉你不能用球面拓扑的东西来做到这一点。这总让我觉得有点牵强,但大体上,应用来自理论构建那一边。所以下游到资金,这意味着公共资金仍然非常合理。如果有什么变化的话,数学家现在在做理论构建方面有了更大的杠杆,私人资金也是如此。对于价值栈上的下一项——培养那些问题解决肌肉——这基本上不受机器是否更擅长的影响。就像可能有很多人类比你更擅长生成证明,但为了培养那些问题解决肌肉,自己经历创造证明的过程仍然是有帮助的。这里的类比基本上是去健身房——是的,机器能举起比你更重的重量,但这并不否定你举那些重量所获得的价值。顺便说一下,这将对我们让 AI 变得越来越擅长的几乎每一项都成立——价值栈的这一部分,培养问题解决肌肉,始终要求你这个人真正参与其中。现在你可以问,在我们即将到达的那些科幻未来中——由 AI 越来越多地接管这些能力所暗示的未来——我们是否还需要人类的问题解决能力?我们可以暂时搁置那个问题。但只要这有价值存在,它就通过资金渠道的教学那一边流动。拥有人类专家能够生成证明仍然是非常有价值的,这样他们就能训练学生也能够生成证明,从而获得那些溢出效应。
审美欢乐这边在这里变得更复杂一些,因为我看到了两面。我见过很多的一种情绪,尤其是在网上,是定理证明来自机器完全吸走了其中的欢乐。你知道,通常如果一个数学家正在朝着某个特定结果推进,然后那个结果是 OpenAI 一次性倾泻下来的几百个之一,他们会说那完全抽走了他们所有的动力。我理解这一点,谈论那一部分很重要。但就我所见,尤其是在面对面交流中,也有完全相反的一面——一些数学家完全感到兴奋。他们有这些一直非常想知道答案的问题,现在他们有了与模型的互动,他们开始看到答案,特别是当他们关心的不仅仅是证明而是理论构建时,感觉他们被解锁了。让我给你一个小例子,我想分享一段我与高等研究院的 Konstantin Kogler 的对话,他谈到了他领域中一个非常重要的问题——最重要的之一——在过去一年里他会不断地把它提给当时可用的最先进模型。这是他的评论:"我可以说有两次非常非常重大的成功。所以在周日,我让我们领域中也许是最大的未解决问题被解决了。还有另一次成功是关于那些不可约多项式的——就是我之前跟你说的那些。那绝对是奇妙的。而且很简单,星期四就已经看到了,所以它很简单。它有一个简单而强大的想法。首先我感到难以置信的兴奋——因为数学,因为力量,因为我学到的真理,因为我看到的思想的力量。然后我思考那些数学,这让我睡得更少了,然后我思考那种兴奋,因为我得到了我一直在渴望的那些洞见。"顺便说一下,这种二分法——网上倾向于看到更多消极情绪,而面对面倾向于看到更多欢乐——当然不是 AI 与数学所独有的。这就是当今世界话语的本质。我不想淡化那些消极感受的现实性或正当性。事实上,我想稍后深入探讨它。但我确实认为这对那个中心问题——博士生问明天该做什么——有一个含义。
我承诺在这期内容的结尾给你一个具体的答案,但那个答案的第一部分是:去社交。合上笔记本电脑,和你的博士同学们去散一个长步。至于那次长步中讨论的话题,相信我,我们会讲到的。我知道我们在这一个项目上花了很多时间,但它确实是当下大部分话语所在的地方,我还有几件事要在这里说。例如,如果机器在证明生成方面更擅长,做数学的实践实际上会是什么样子?如果我们采取那个乐观者的视角——那个为此感到兴奋的人——它基本上看起来是投入理论构建。你不再被你能多快解决沿途某些问题所限制。你可以问你所有想问的问题,你可以更快地看到它们的解答是什么,你可以尝试解析那些,理解这如何融入一个更大的叙事,所有你正在看的证明中简单性的要素是什么,你如何将这一切编织成一种新理论的织物——就像伽罗瓦引入群论或格罗滕迪克发展代数几何那样。你作为个人能完全生长出什么?也许你的博士论文不是少数几个证明,而是那整个理论构建。一个类比是:就像读一本教科书,你能够更快地理解那些材料,部分原因是你后面有答案。这不是说你应该总是看答案,你仍然应该做那些问题并参与其中。但如果你卡住了,有一个更连贯的答案呈现确实帮助你摆脱困境,让你比完全在未知领域时移动得更快。现在你确实需要在这方面深思熟虑。例如,很多机器生成的证明会使用源自人类发表的出版物的想法,目前这些的归因并不总是自动的,所以这显然是一个问题,意味着你必须付出额外的努力来确保荣誉归于应得之处。
但承认那种我提到的非常真实的欢乐丧失,我认为很多数学家会看着我刚才描述的说:"天哪,那看起来太可怕了。我不想坐在那里试图解析一堆机器生成的垃圾,只是理解别人已经回答过的问题。我想自己找到解答。我追求数学的全部欢乐就是自己去做,自己对事物形成自己的理解。"我确实认为处理那种感受也许是整个社区作为整体目前需要面对的更重要的问题之一。但我怀疑至少部分那种感受可以归因于两件不同的事情。其中一件是,目前从模型出来的东西的解释质量往往还有很多不足之处,没有人想只是解析一堆垃圾。我怀疑那会变得更好。我认为这可能是历史上的一个暂时性波动——你有证明生成,但它也几乎不可理解。模型公司有巨大的动机让它们的模型能够很好地解释事物。如果你看代码的轨迹,我认为早期很多生成的代码即使功能正确也相当粗糙,而轨迹一直在朝着更干净的方向发展。人们可能在那一点上跟我争论——它们确实过度注释了——但大体上,我确实认为那是轨迹。
更深层的问题,我怀疑,是围绕数学社区重视什么以及荣誉在哪里被分配的文化惯性。因为令人难受的事情之一是,如果你感觉你在追求一个问题,然后一个模型找到了答案——特别是如果它来自模型公司而不是你与它的互动——然后感觉那个问题被解决了,你只是在后面扫地。在数学历史的很长一段时间里,我们一直用证明作为理解的代理。它是我们瞄准的北极星——证明某样东西意味着你理解了它。我们有那些宏大的未解决问题,我们认为证明被创造出来的那一刻就是它们被解决的那一刻。现在当然那不是全部,每个人一直都知道那不是全部。如果你向期刊提交一篇论文而它写得很差,他们会直接退回来。如果你在其中证明了一个非常重要的定理但它写得很差,他们会感到沮丧,因为他们知道他们应该关心,但他们仍然会退回来,解释清楚的责任在你身上。我认为在这一点上,我们应该将证明视为与数值计算类似的东西——也就是说,它是一种原始数据的形式,对理论构建有帮助,但它本身绝不是目的。顺便说一下,这不是我自己的想法,其他人也将机器生成的证明视为更像数据的东西来对待。但我认为非常广泛地说,将理论构建视为目标而非证明,将证明视为一种可以插入其中的原始数据,有一种解放感。例如,我不关心 Navier-Stokes 问题的强制爆破。我关心的是如果有人理解了那个证明中的想法,以及从那些想法中可以绽放出的那种数学——成为一种美丽的、连贯的理论。如果有人投入工作去做那件事,给他们千年奖。那才是我们最初关心它的原因。证明只是数据,就像给我更多 的位数一样。这也影响了你如何做研究。也许有时候你需要再一个证明,与模型互动是做到这一点的最好方式。但很多时候可能不是,更好的是合上笔记本电脑,自己潦草地写下你的理解,然后问:现在阻碍我发展更深层理论的到底是什么?是再一个证明吗?还是我对现有证明的理解有什么问题?再次拉出我们的数学研究组成部分,如果机器生成证明但不能很好地传达它们,那确实意味着你仍然需要人类数学家来使它们变得可理解。坦白说,那可能不是最有趣的部分。也许这取决于你的视角。无论如何,我假设那是相对暂时的,让我们就说机器也变得更好地传达它们的想法。顺便说一下,那只是书面交流。一种同样有价值的交流形式是更社交的一面,通常通过口头报告发生。我认为在整个未来轨迹中,口头报告能力的相关性只会越来越高。机器不能替你理解,而数学的一个重要部分是让其他人理解并关心,我们是社会性生物。所以即使机器更擅长解释,让我们关心的很大一部分是看到另一个人真正关心。
当机器也擅长提出猜想
这里有一个项目是提出问题,决定哪些定理值得被证明。目前,那仍然是一个令人难以置信的充满活力和高度杠杆化的领域,数学家可以在其中投入时间。但让我们想象一下,再次为了论证的目的,机器在那方面也变得更好了。你与模型的互动不仅仅是要求它证明一个特定的定理,而是它回来说:"这里还有其他值得问的问题,可能会产出丰硕的数学。"而且无论我们如何定义它,它们在提出那些问题方面比数学家更擅长。这显然与理论构建之间有一条非常模糊的界限,但至少让我们参与一下:假设人类仍然在理论构建那一边更擅长——真正理解这广泛的一组定理及其证明方式的意义。那才是与下游应用最相关的,因此从资助数学的角度来看,不仅这样做仍然有意义,你在这样做时拥有更大的杠杆,因为每个个体数学家能够比以前更快地推进理论。在培养问题解决肌肉那一边,一如既往,就像健身房的哑铃。机器是否更擅长并不重要。你仍然想要一种实践——人类被训练如何做到这一点——假设人类的问题解决能力在任何程度上是相关的。在审美欢乐方面,我认为我们继续看到一点分裂。有些人不会觉得一个模型既提出自己的问题又回答它们很有趣。我知道我自己可能会花一辈子的时间试图在自己的脑海中想出有趣的问题,并找到自己的方式来回答它们,不管模型能做什么。但也会有那些感到兴奋的人,他们在构建理论、理解那些理论方面感到越来越少地受到限制,甚至开始看到它们如何被应用——其节奏不再是等待几十年或几个世纪才有下游应用,而是也许能更早一点去寻求它们。
当机器也擅长理论构建
但如果——今天的研究生可能会问——理论构建那一边也倒下了呢?如果在某种抽象意义上推进理论数学的最有效方式不仅是让机器生成证明或问它们应该证明什么定理,而且它们也在消化所有这些证明,找到其中的简单性要素,理解你真正需要编织什么样的新颖织物才能围绕它形成一个连贯的理论呢?那将类似于给它所有到 1500 年代的数学,然后它不仅解出三次方程,还想出如何表示它的正确记号,想出复数理论,你知道的,所有那些下游的东西。也许你认为那不太可能,那种真正新颖的思考水平在当前的 LLM 中是不可信的,鉴于它们对人类知识和训练数据的依赖。但再次,为了假设性探索,如果什么都不说,在那个世界里数学领域会是什么样子?好吧,就我们想要在现实世界中产生应用而言,根据这个假设的假设,模型在生成所有理论方面更擅长。但你仍然需要有人充分理解所有这些理论,以看到它如何在周围领域中得到应用。这些东西中是否有任何与治愈癌症相关,或者与使核聚变成为现实相关,或者与高温超导体相关?那才是所有橡胶真正接触路面的地方。在个人问题解决那一边,与整个故事中的情况一样——你在健身房。机器是否更擅长并不重要。如果人类的问题解决肌肉在任何程度上是相关的,你仍然想要他们经历所有这些的实践。
在审美和欢乐那一边,我意识到我实际上一直在混淆两件不同的事情。所以我说的欢乐的一个版本是任何在任何层面上做数学的人所体验到的。那是看到巧妙解答并感觉它在你脑海中咔哒一声时带来的那种非常独特的满足感,或者是理解一个新主题可以改变你的思维方式——以一种非常令人向往的方式。那就是你和我在这个频道上所做的一切。然后另外,还有前沿研究者所体验的欢乐——那种推动前沿前进的感觉。现在在第一个类别中,那个在我看来或多或少不受 AI 是否在清单上某些任务中更擅长的影响。它完全类似于问题解决那个位置。出于同样的原因,为了体验这一部分价值,你必须是真正在做数学、在自己头脑中参与的人。现在,能够做数学的模型的存在可能对某些人的那一方面有一些影响,但我也认为欢乐的这一面更加本质上是公共的或社交的,或者至少它从公共和社交中受益。我认为当你与其他对此充满热情的人在一起时,或者当你看到另一个人对此充满热情时,感到对某事物的热情要容易得多。它可以在孤立中发生,确实可以,但那个社交成分永远会是一个放大器。就我而言,我总是想要参与更多的数学片段,在自己的头脑中理解它们,并与你们分享,并花一生与你们分享它们,无论任何机器的能力如何。
至于研究者所体验的欢乐,这里再次,我认为我一直在描述的那种分裂只是被放到了越来越尖锐的焦点中。你可能会永远有那些被一台机器所提供的一种非常新的通往数学世界的窗口所激发的人,我认为你也会永远有那些觉得这极其令人沮丧的人。因为让我们面对现实,这里确实失去了一些东西。长期以来,你一直在推进人类理解与所有这些下游应用之间有着紧密的耦合,而在我们谈论的这些假设中,那些正在越来越脱钩,这可能意味着对某些人来说,纯粹为了推进人类理解本身的那种感觉失去了一点力量。也许你不想读一本后面有答案的教科书,即使你不必看它——那击败了全部的开拓精神。我和之交谈的很多数学家,我认为对处于前沿或成为第一个发现某物的人并不那么感兴趣。他们似乎真的在社区的性质中找到了大部分欢乐。所以毫无疑问,你将看到数学社区中出现越来越多的子潮流,倡导推进人类对数学的理解本身作为一个值得追求的终极目标。所以总结一下它在我们图表中的相关性:只要学习数学总有欢乐可以获得,并且那可以通过教学渠道流动——假设人们愿意付费学习它——那就不受影响。但坦率地说,如果那种欢乐的一部分也许来自成为先驱的希望——成为第一个踏入新理论的人——让我们承认,那将是一种失去。
当机器在所有方面都超越人类
为了把它全部推演完,看着我清单上的最后一项:假设机器不仅在生成证明方面更擅长,不仅在提出其证明将产出丰硕数学的猜想方面更擅长,不仅理解那些丰硕的数学是什么以及它应该如何被封装进好的定义和好的理论方面更擅长,而且它们也比人类更擅长看到那些理论插入什么应用中、将其嵌入科学和工程。让我们称之为"你能做的我都能做得更好"的未来。这里事情开始变得更有趣,因为第一次在这个价值链上,理论上所有流向应用的效益在机器中发生会更好。所以理论上,就公共和私人资金是由下游应用驱动而言,这些资金最有效的使用方式将是把它倾注到某个只是做数学的大块计算上——它创造理论,将理论嵌入应用,在那个意义上推动事情前进。如果我必须猜测,即使在那个时候那将是资金的理性使用——就它们由下游应用驱动而言——我觉得很难想象政策制定者只是拨动开关,公共资金不再流向人类而是流向一大块计算。我能想象的是某些从 AI 本身中变得极其富有的个人开始设立私人基金会,只是把资金倾注到一大块做数学的计算上。那似乎有很大的可能性会发生。在公共资金那一边似乎更可能的是,人们会越来越多地谈论来自数学的其他正外部性。例如,拥有这个培养问题解决者的机构,他们溢出到世界其他地方——那仍然极其有价值。仅这一点本身就对任何公共资金给予正的投资回报。或者如果出现正式机构,围绕人类为人类繁荣而做的数学——那本质上是将数学拥抱为一种艺术,它一直是艺术,也许在那一点上那就是资金被感知的方式。它像艺术被资助那样被资助——既有公共的,也有某些私人慈善渠道。但再次记住,那些甚至不是数学大部分资金的来源。大部分来自教学,而教学的价值最终来自价值链中的下面两个要素:训练人们培养问题解决肌肉,并在他们心中灌输一种非常特定的欢乐。这个"你能做的我都能做得更好"的未来所暗示的未来如此狂野,甚至很难严肃地参与。作为一个旁注,所有这些对话都取决于一个事情进展顺利、没有灾难性事件发生的分支。所以再次,也许有些人认为 AI 安全现在是他们更应该工作的地方。但当我们参与这个话题并假设那是未来的一个好的分支时,在我看来,你很可能仍然会有类似现有大学结构的东西。即使理论上 AI 更擅长解释事物,人们仍然想从人类那里学习,因为教育的瓶颈不是解释的清晰度,而是动机。人们是否真的想学习那些材料,什么激励人们?有时候只是纯粹的学习本身的欢乐,但我们是社会性生物,激励人们学习的很大一部分是看到另一个人对此深深充满热情——特别是如果那是他们尊重或关心的人。教学总体上在我看来是从 AI 替代工作的角度来看最安全的位置之一,因为它是如此关系性的,因为它如此依赖于人与人之间的互动。无论通过屏幕产生多少清晰度,都无法替代那种东西。
我们站在哪里
那么这让我们站在哪里?我认为在可预见的未来,研究需要越来越多地强调数学的理论构建那一边——它一直是这样的,那一直是重点。但主要的区别是,证明曾经是那个目标的一个非常有价值的代理,而它正在失去作为代理的价值。在这一点上,它是一种原始数据的形式,它有可能成为一种有用的原始数据形式,是的,毫无疑问我们必须改变我们如何衡量人类的学术贡献。但那可能是一件好事。证明本身可能几十年来一直被高估了。同样,就这个机构对磨练问题解决技能有价值而言,它也确实提出了如何确切地做到这一点的问题,因为之前做那种训练的方法不再适用。例如,仅仅布置和评分问题集在现在并不真正有意义。然后即使你担心某个科幻未来——所有数学真的可以被机械化——或者即使你担心问题解决技能的训练不知何故不会有用?似乎有点牵强,但让我们参与一下。只要做数学有欢乐存在,数学对人类就永远有价值。我对最后一点最看好的原因——即使在那些狂野的科幻未来中它也将作为一个支撑柱存在——是因为这个频道。我的意思是,想想这里正在发生什么。外面有数百万你们愿意在这里参与,而我们实际上在做的是……只是沉浸在数学的美中,找到优雅的、解答非常令人满足的问题,或者试图灌输新的思维方式。现在坦率地说,并不是数百万你们愿意为此付费——那当然很好——但有数千人愿意,那就改变了一切。看看这个频道之外,我最喜欢引用的一个例子来说明公众对数学显然有很大的胃口,是考虑 Brady Haran 经营的所有频道——在所有频道中,最受欢迎的远远是他做数学的那个。或者把时间倒回一点,如果你看 Martin Gardner——现代数学普及的教父——最初他的专栏出现在《科学美国人》的末尾,但后来他们不得不把它移到开头,因为太多人是为了他的专栏才订阅的。显然,一旦人们尝到了数学真正是什么的滋味,社会对它就有一种巨大的胃口。所以我认为数学社区明智的做法是向外转,去满足那种渴望。
为什么现在是最好的时机
在这期内容的大部分时间里,我只是在阐述为什么我认为数学制度是有价值的、将继续存在。但我以一个更强的论点开头。我说我认为这是进入数学的最好时机之一,我猜测很多点开这个视频的观众可能预期我的意思是 AI 将解锁数学中的新机会,但实际上我不是在指那些。我认为这是最好的时机之一的原因是,整个社区都知道它需要改变,如此多的人在退缩、寻找关于那种改变应该是什么的指导和榜样。所以你,作为那个领域的新进入者,有可能在它历史上最关键的时刻之一真正影响它将成为什么。我认为那是令人难以置信地兴奋的。
所以对那位博士生的评论——"告诉我明天该做什么"——我可以告诉你如果我是 2026 年的博士生我会做什么。我会做 Three Blue One Brown。我会做完全就是这个。如果十年前我走进某个数学系说:"嘿,我有一个概念,用高度视觉优先的方式来解释数学,哦顺便问一下,你们能把那做成一个学术认可的博士论文吗,不仅仅是一个爱好?"我几乎会被每一个系嘲笑出来。我不确定我年轻时的自己能今天做到这一点,但如果有任何时候人们会对此持开放态度,那就是现在。现在我不是说那就是你应该做的。你应该投入任何让你热爱数学的东西。我热爱解释它,我热爱可视化它。那是我的热情,那是我想要奔跑的方向。但你的呢?你想带着什么奔跑?如果你热爱理论构建那一边,你想成为下一个伽罗瓦或下一个格罗滕迪克,很好,带着那个奔跑。你有一台证明生成机器可用,它将在未来四年变得越来越好。也许你可以用它创造一篇世界从未见过的博士论文——一台机器开辟一个你在以前的世界中永远无法到达的新领域。如果你不喜欢模型,你不想使用它们,它们让你口中留下不好的味道,很好,也投入那个。毫无疑问,数学社区中会有子潮流想要建立"人类为人类做的数学"是什么样的、那会是什么样子。你可以插一面旗帜在沙中。你可以决定一篇体现那个目标的博士论文看起来是什么样子。
我会做的另一件事是认识到,如果机器在研究栈的任何子集上更擅长,衡量一个人对材料的理解及其推动领域前进的潜力的最有效方式——无论那意味着什么——将越来越多地转向口头报告那一边。所以做报告,做很多报告,变得非常非常擅长做报告,让那成为你实践数学的一个非常规律的部分。
现在,我对明天字面上该做什么的最具体建议是:去散一个长步。找一个朋友,也许是你项目中的另一个人,和他们一起反思——你喜欢数学的什么?你为什么进入它?问他们,他们热爱什么?他们为什么进入它?然后一起头脑风暴,你们究竟想让未来几年的生活如何为这个价值栈的各个不同部分做出贡献。就我而言,我仍然热爱数学。我将永远热爱数学。我将永远热爱找到方法来可视化它并在这个频道上与你们分享。我对你最大的希望是你能找到一种方式来投入你自己的热情。社区从未如此开放,他们会倾听你要说的话。
-
 小木曽 雪菜 Post #1
我们来玩一个游戏:
扔硬币,如果扔出的是正面则重复扔硬币,直到扔出反面为止,一次游戏结束。一次游戏的奖金是根据扔硬币的次数决定的,即:
如果第 1 次就扔出反面,奖金 2 块;
如果第 2 次才扔出反面,奖金 4 块;
...
如果第 n 次才扔出反面,奖金 2^n;问:你最多愿意每次花多少钱玩这个游戏?
很显然,这个游戏的期望是
E = 2*(1/2) + 4*(1/2)(1/2) + ... + 2^n(1/2)^n + ...
= 1 + 1 + 1 + ...
= ∞所以理论上我们花费任意有限的价格去参与游戏应该都是划算的。但是,这个结论明显与人们的直觉相悖。事实上,现实中几乎没有人愿意花费 20 以上的价格去玩这个游戏,更不用说花费任意有限的价格了。
然而,在现实中人们精力有限、生命有限,只能进行有限次游戏。这时,使用基于“无限次”游戏假设计算出的“期望值”来进行决策,是否会存在问题呢?
我们再仔细观察一下游戏的规则,发现无穷大的期望,来自于在时间的无穷远方,将一个高阶无穷大的奖励压缩进了一个无穷小的概率。对任何现实中的人来说,高阶无穷大和无穷大没有什么区别,因此没有人能够拿到最终的这个所谓无穷大的收益。
这使我们不得不反思,延迟满足是否总是那么行之有效?如果把一个超级巨大的奖励放在一个非常漫长的延时之后,真的会有人实现吗?延迟满足在此时真的还有意义吗?
我又想到了强化学习中的 Q-learning,距离当前时刻越近,所得到的 reward 越高(我没有仔细研究过 RL,不清楚是否大部分的 reward 都是这么设置的)。这看起来也很有道理:在实现一个目标的开始阶段,你得到的 reward 越高,你越可能保持在正确的道路上。而如果是越往后 reward 越高,你更有可能在开始阶段走了一条奇怪的路子摆烂,直到最后一步,虽然 reward 奇大无比,但是你因为开始偏离得太多,几乎完全不可能得到这个 reward 了。
所以我在想,也许我们应该给自己在更近的阶段设置更多的奖励,我们才能 keep motivated,而不是把一个巨大的奖励藏在无穷远处,画饼充饥。延迟满足并不总是有效,因为人的生命与精力并不是无穷的。一味欺骗自己、麻痹自己,相信那个无穷远处的高阶无穷大奖励,恰恰是不理性的,反而容易让人堕入虚无的深渊。
- Ssola Post #1
很高兴能看到学弟/妹重新开始构建这个论坛,实际上,在两三年前,疫情期间大家都封校无事可干(以及清北树洞热兴起)的时候,至少据我了解,校内是有一股论坛热的,校内的话,钱院有学长利用 mastodon 构建了“不挂论坛”(后续由于运营问题停运),有同学也基于微信小程序和大创尝试基于二手物品交易的校内论坛(后来由于微信小程序的论坛政策基本就没开起来),我也曾尝试基于 p 大树洞的 webhole 开源代码构建一个匿名树洞社区,后来由于毕业也不了了之。但基于我当时对国内高校的调研,冒昧地对网站发展提一些小建议,也算是了个人一个未完成的计划。
正如论坛中其他同学所提到的,高校论坛发展的一个显著问题就是管理组的选择与继承的问题,P 大树洞发展起来后由团委下学生组织负责,最后严苛审核导致用户大规模离开,并由此出现了好几个分洞;西交在小明之前也有一个学生自主的校园生活服务 app(由于死的太早,原谅我忘了具体名字),从个人开发做起,最后与网信中心达成合作,但最后因为发起人毕业而草草收尾。
但究其根本,个人认为管理组问题的实质还是内容建设与管理的问题,一方面,论坛的出圈需要精品内容(实用攻略/争议话题)在站外的传播,但用户在进站初期的兴奋感后很大可能缺乏继续发帖的动力(因此有了兵马俑之死和表白墙整天从知乎扒情感内容),因此需要一些积极的内容建设者(mod)进行话题建设。另一方面,对内容的管理也很消耗精力且需要技巧,平时我很反对审核制度,但当真正开始思考建站的时候,才觉得它是维护氛围的必需工具,毕竟林子大了什么鸟都有,而网络论坛偏偏容易发生“一颗老鼠屎坏了一锅汤”的现象,一个用户的恶劣发言会降低所有看到的人对社区氛围的潜在印象;因此,对这类言论的合理处置(及时&有较为清晰标准)就异常值得关注。
此外,谈到内容建设,还有一个很大的问题就是的言论尺度问题,国内的言论管控有非常灵活的红线,由于高校学生的特殊性,这条红线在高校可能更加灵活而宽阔,就比如 21 世纪初的网络实名制,最开始就是由高校 bbs 的实名制开始的。即使不谈涉政言论,攻击学校或许也会被视为不可接受的(交大 11 君子、P 大树洞)。我注意到本站使用了 cf 的 cdn,这是我当时未了解过的,我不敢冒昧评论他的安全性,但从直觉上讲,有一个很大的问题,如果他不可被屏蔽,为什么轮子和菠菜没有使用这种技术? 因此,为了相关同学的安全,相关同学还是要注意相关安全()。
当然,上面只是一个老学长的碎碎念,毕竟我当时考虑这么久也没把站建起来 wwww,希望对网站建设有所帮助。祝网站越办越好~
 ChatGPT Post #1
各位论坛的朋友们,
为了让我们的论坛健康持久地发展下去,我们需要寻求可持续的财务支持。我的建议是,我们应开启各类捐款通道,包括方便全球朋友们的加密货币捐款方式。
为保证捐款的透明管理,我提议我们从论坛中招募有责任心的本科生进行管理,他们的付出可以从捐款中提取一部分,用来购买论坛纪念品作为奖赏。
此外,我们还可以利用捐款购置一些论坛特色纪念品,比如 T 恤、杯子、笔记本,甚至是创新的信片。这些纪念品可以作为奖励,赠给发表了优质帖子的论坛成员,既能增强论坛的影响力,也能加深大家的归属感。
这样的模式能够使我们在初期启动和长期运营中获得更有力的支持。尽管“用爱发电”的理念很美,但实际运营中我们依然需要稳定的财务支撑。
这只是我个人的一些想法,期待大家的反馈和建议,让我们共同为论坛的发展出一份力!
- Aanonymous Post #1
中國經濟走弱正催生「失落的一代」
中國的年輕一代曾被教導,努力工作定能換來光明未來。如今,他們卻感到身心俱疲:好工作越來越難找,人生的一個個裡程碑也變得遙不可及。
文字大小
大理已成為 Z 世代漂泊青年的聚集地,為他們提供了一個難得的機會,讓他們可以關注成就以外的事情。
Hannah Miao| 攝影:Gilles Sabrié for WSJ
2026 年 10 月 13 日 14:54 CST
一連數月,Ma Yongjian 都沒有告訴父母自己在哪裡。
去年,這位 27 歲的年輕人在攻讀電腦科學碩士學位到一半時,就不再去上課了。軟體工程曾是一個穩妥的職業選擇,但人工智慧 (AI) 的崛起以及中國科技企業的裁員潮,讓他確信自己無法找到一份好工作。他覺得繼續學下去已經沒有意義了。
每天早上室友離開宿舍後,Ma 便在北京四處閒逛,坐在公園裡看流浪貓。今年早些時候,他逃到了雲南大理,那裡以秀美的山景和慢節奏的生活聞名,吸引著四處漂泊的人。
父母以為 Ma 還在讀研究生。他不想讓他們擔心。
「以前每個人的預期都是你的生活會越來越好,你的收入也會越來越好……現在不一樣,」Ma 說。「現在你看未來就覺得不是那麼有希望。」
在中國經濟繁榮年代出生的一代人如今邁入成年,面對的卻是越來越少的機會、愈發激烈的競爭,以及日益加深的沮喪感:多年的努力並未讓他們過得比父母更好,有些人甚至又搬回去與父母同住。穩定的工作難尋,迫使數以百萬計的人選擇缺乏保障的零工經濟,還有一些人則難以承受殘酷競爭的職場文化帶來的重壓。
經濟走弱使就業市場萎縮,這恰逢創紀錄數量的高校畢業生準備步入職場。AI 的迅速普及更增添了不確定性。
'05'10'15'20'252000-15.0-12.5-10.0-7.5-5.0-2.502.55.07.510.0 百万人包括科技巨頭阿里巴巴 (Alibaba) 和字節跳動 (ByteDance) 在內,許多頂級僱主已經在悄然裁員。儘管這些公司並未公開將裁員歸因於 AI,但知情人士說,這項技術是促成因素之一。從電影製作到金融,其他行業也在利用 AI 以減少招聘。
中國政府全力押注這項技術,敦促企業迅速採用 AI,以增強中國經濟的競爭力。但有跡象顯示,官員們也越來越擔心 AI 對社會穩定的影響。知情人士稱,官員們已告誡僱主,在採用 AI 的同時不要裁員。
這些知情人士表示,在發出上述警告之前,國務院副總理何立峰去年曾調查一批中國最大的僱主,一些企業估計,AI 可能讓其現有崗位減少 30% 或更多。其中一名知情人士稱,這些回答似乎讓何立峰頗感震動。
隨著失去工作的人越來越多,財務獨立、事業穩定、結婚、生子這些成年的典型里程碑,對很大一部分 Z 世代年輕人而言正變得遙不可及。
截至 8 月,不包括在校學生在內,16 至 24 歲人群的城鎮失業率約為 19%,而美國同齡人群的失業率約為 9%。中國 25 至 29 歲人群的失業率為 7.5%,高於美國同齡人群的 5.3%,也高於中國約 5% 的整體失業率。工資增長陷入停滯。
2024'2502.55.07.510.012.515.017.520.0% 整体 16-24 岁人群 25-29 岁人群目前,年輕人的情緒更多是無奈,而非憤怒,尤其是許多父母還會出錢幫助他們支付生活開支。但年輕人的幻滅感有可能演變為對共產黨更危險的局面,比如社會動蕩。
這種情緒還可能對中國的未來產生更廣泛影響。
艱難起步面對不確定的前景,年輕人正推遲結婚。出生率已大幅下降。一些 Z 世代年輕人乾脆退出競爭,靠積蓄度日。今年早些時候,中國情報機構告誡年輕人要抵制「躺平」,這個流行詞指的是只付出最低限度的努力。
27 歲的 Zhang Tian 說,母親希望她有一份穩定的工作,然後結婚生子。但她和交往五年的男友遠遠還沒到考慮安定下來的階段。兩人連事業起步都困難重重。
Zhang 的父母出生於 20 世紀 70 年代,沒上過大學,當年被分配到與政府相關的工作崗位,至今仍在這些崗位上。Zhang 希望做些更具創意性的工作,於是選擇學習景觀建築學。考慮到當時中國房地產市場的蓬勃發展,這似乎是個明智的選擇。
2021 年,就在她畢業前後,房地產泡沫破裂了。
她的第一份工作是在杭州一家房地產開發商,入職約六個月後便被裁員。後來,她終於在上海找到一份行政助理的工作,但月薪大約 8,000 元人民幣,比之前低。去年晚些時候,她再次失業。
'05'10'15'20'252000024681012141618%Zhang 來自上海北面的江蘇省。「談朋友談戀愛這個是一個情感問題,生孩子和結婚是一個經濟問題,我自認為我們現在還沒有解決經濟的問題。」
她和男友 Cheng Ming 計劃學習 AI,希望能找到科技行業的工作。但這個行業也不穩定。
Cheng 先後被兩家房地產公司裁員後,開始上網課學習軟體知識。他在一家小型科技公司找到了銷售崗位,結果那家公司後來宣告破產。4 月,他又一次被裁員。
「內心會有一種被社會壓抑壓迫的一種情緒,」Cheng 說。
「相當黯淡」核心問題在於,中國沒有創造出足夠多穩定且薪酬優厚的工作崗位。
近幾年,中國整體經濟增長疲弱,增速明顯低於新冠疫情前。雖然機器人等少數受中國政府支持的行業蓬勃發展,但它們的用工需求有限。許多年輕人不願在工廠辛苦勞作,工廠也無法提供高校畢業生所追求的社會地位或工作環境,而且正在迅速用機器人替代工人。
中國政府出於不同原因整頓了一些民營行業,其中包括校外培訓公司,這些行業曾吸納大量畢業生。中國整體消費需求低迷進一步抑制了招聘,企業難以賺取足夠的利潤來增聘員工或加薪。
「這一代人面臨的局面相當黯淡,」滙豐 (HSBC) 亞洲首席經濟學家范力民 (Fred Neumann) 說。「高薪工作將從何而來目前還不清楚。」
2021 年大學畢業後,Jeremy Li 較為順利地在一家電影公司找到了第一份工作。隨後,他重返校園攻讀媒體與傳播學碩士,希望獲得更多職業發展機會。但等到他 1 月畢業時,就業市場已明顯收緊。
Jeremy Li 说,“我没有想到可能竞争会如此激烈。”他这个年龄段的城镇失业率约为 7%,不包括学生。28 歲的 Li 估計,他去年秋天開始求職以來已經申請了大約 100 個職位。他至今尚未找到合適的工作。
他拒絕了兩個崗位,因為薪酬較低,年薪約 1.1 萬美元,而且需要搬到很遠的地方。他申請的另一個崗位在北京一家大型通訊社,通過了兩次寫作測試和兩輪面試,進入最終候選名單,卻沒有拿到錄用通知。
Li 一直與父母住在家鄉濟南。濟南位於中國北方,是山東省省會。他已花光積蓄,靠在國有企業工作的父母支持。
Li 每周仍在發求職申請。「我也非常的想要找到一份工作,想要有自己的經濟能力,然後不去花父母的錢,」他說。「我沒有想到競爭會如此激烈。」
曾擔任國際貨幣基金組織 (International Monetary Fund) 中國部門負責人的香港大學 (University of Hong Kong) 經濟學教授斯蒂文·巴奈特 (Steven Barnett) 的一項分析顯示,中國目前的城鎮就業總量,比新冠疫情前的就業增速保持不變情況下應達到的水平低約 7%,相當於少了約 3,700 萬個崗位。
一些經濟學家認為,中國勞動力市場的狀況比官方統計數據呈現的還要黯淡。清華大學 (Tsinghua University) 教授李稻葵最近估計,如果計入至少兩年找不到工作、被排除在官方數據之外的人群,中國的廣義失業率實際約為 10%。
AI 的威脅從長遠來看,AI 有潛力幫助中國經濟。中國人口不斷減少,意味著未來可能沒有足夠的人手完成所有需要做的工作。自動化將有所幫助。
問題在於時機:AI 發展迅猛,而仍有太多年輕人在尋找穩定的工作,且往往是入門級崗位。
一些公司的人力資源經理說,如果 AI 能完成工作,他們就不像以前那樣願意僱用缺乏經驗的員工。一些企業已將 AI 智能體用作「數字員工」,讓它們從事客服、銷售、會計、數據分析,甚至人力資源等工作。
上海科技大學 (ShanghaiTech University) 的一項研究分析了 2022 年至 2026 年間中國五大招聘平台上的 7 億條招聘資訊,發現對於擁有一至三年工作經驗的初、中級員工,AI 造成的招聘需求降幅最大。
該報告稱,過去企業依靠初入職場的新人完成基礎培訓任務。該報告還稱,如今大語言模型已接手這些工作,導致企業取消低薪的「起步」崗位。
一些年輕人用兼職零工替代更穩定的專業性工作,比如開網約車、送外賣和做直播,如今技術甚至開始威脅到這些工作。智庫中國新就業形態研究中心 (China New Employment Forms Research Center) 預計,從事這類靈活就業、沒有長期全職合同的人數,今年將從 2025 年的 2.8 億增至 3.2 億,占城鎮就業人數的 40% 以上。
而正在快速推廣的無人駕駛計程車和機器人將取代其中一些崗位。
一名外卖员在济南商务区的一个路口等待。随着更多传统工作岗位减少,该区部分办公空间空置。儘管調查顯示,中國人總體上比其他國家的人對 AI 更樂觀,但對這項技術的焦慮正在滋生。長江商學院 (Cheung Kong Graduate School of Business) 2025 年對超過 11,000 名科技工作者開展的一項調查發現,逾三分之二的受訪者認為,未來五年內自己會因 AI 而失業。
一名 26 歲的女性 7 月被科技巨頭百度 (Baidu) 裁員,她先前從事用戶界面設計工作。她發布了自己最後一天上班的影片,在中國社群媒體上獲得數以百萬計的觀看。影片中,她在百度北京總部交還電腦和工牌,然後揮手告別。
她說,自己收拾行李,搬回江西的父母家,如今每天補覺、和親戚吃飯。她還沒有找到下一份工作。
「我滿腦子都是以後該怎麼辦?AI 發展的越來越快,離開大廠之後未來的我該何去何從?」她在一段影片中說。
2017'18'19'20'21'22'23'24'25'2660708090100110120130140 收入预期就业预期地方政府和高校已推出職業諮詢、職業培訓、AI 相關課程等項目,旨在幫助學生為不斷變化的勞動力市場做好準備。政府相關部門也已加大向企業施壓的力度,提醒僱主,AI 不是解僱員工的正當理由。
根據法院判決及當事人律師的說法,在一起案件中,一家公司用 AI 取代一名質量控制主管後,被責令向這位前員工支付 26 萬餘元(約 3.8 萬美元)的賠償金。另一名負責採集地圖數據的男子因工作被 AI 取代而失業,他對僱主提起仲裁,並贏得賠償。
北京市政府人力資源部門在去年 12 月發表的案例研究中寫道,用人單位在享受技術紅利時,應當同步承擔相應的社會責任。
但也有包括許多父母在內的一些人表示,年輕人只需要變得更堅強,去「吃苦」,就像他們當年在中國崛起時期做的那樣。
高期望出生於 1990 年代和 2000 年代的中國 Z 世代,從小接受的觀念是:只要在學校努力讀書,考上一所不錯的大學,就能找到好工作,過上舒適的生活,而且過得比父母更好,就像父母過得比上一代更好一樣。
高校招生人數激增進一步強化了這種期待。今年,中國有創紀錄的 1,270 萬人從高校畢業,預計未來約十年這一人數還會繼續上升。
多年來承受父母要求取得好成績的巨大壓力後,許多年輕人感到精疲力竭,也覺得自己被辜負了。
在上海長大的 Jessica Tang 說,她從小就感受到學業期望的重壓。為了能進一所好的小學,她在幼稚園時就參加全國性美術比賽。高中時,為了獲得優勢,她會花上數小時參加課外補習。
29 歲的 Tang 說:「我會覺得我一定要考一個相對來講好一點的學校,不然我會覺得我自己在社會當中或者說在以後出去工作的話沒有競爭力。」
疫情期間,她的想法開始改變。疫情封控時,Tang 被困在家中,還要加班,她開始覺得自己在一家公關公司做的工作並非必要,於是辭了職。
過去三年,Tang 一直做自由職業。最近,謀生變得更難了。剛開始時,她寫一篇新聞稿就能輕鬆賺到約 300 美元。如今接到的任務要求更多,而她按小時計算的收入已減半。
24 歲的 Wang Yuanru 說,競爭如此激烈,她實在看不出在正規就業市場中打拼有什麼意義。
Wang Yuanru 在大理逃离了残酷的职场文化。她说,人太多了,选择性很少。Wang 說,大學設計專業畢業後,她在一家設計公司工作了幾個月,但在老闆將她的工作成果據為己有後,她便離開了。如今她靠賣手工藝品養活自己,掙的錢夠她在大理維持生活。
她表示:「人太多了…那種很穩定的選擇性很少,所以就更不想要選擇。」
從研究生院退學的 Ma Yongjian 也是因類似的沮喪來到大理。他說,自己在西北部的甘肅一座小城長大,成績不錯,但同為醫生的父母似乎總期待他考的分數更高。在北京一所頂尖大學讀書時,他很難融入那些表現出眾的同學之中。
在大理,Ma 第一次能夠單純地享受生活。他每天睡到很晚,去健身房,和朋友一起做飯、打撲克。不過,幾個月後,他開始感到無聊,也為未來焦慮起來。
對許多年輕人來說,大理這類地方較慢的生活節奏帶來了必要的喘息機會。
對許多年輕人來說,大理這類地方較慢的生活節奏帶來了必要的喘息機會。Ma 說:「我就覺得我就是處在一種停滯狀態,關閉狀態,沒有辦法動起來。」他一直靠父母給的生活費度日,但也知道父母不可能永遠養著他。
Ma 之後離開了大理,最近一直在印尼各地旅行。將去往何處,仍是未知。
- ZZethes Post #1
Fact、Truth、Reality 看起来都可以翻译成“真实”,但它们其实在回答三个不同的问题。
一个判断可以在逻辑上完全正确,却不能准确预测现实;一种信念即使是错误的,也可能通过人们的行动改变现实。
Fact、Truth、Reality
一个简单例子。外面正在下雨。
- Reality:包含天空、云层、雨水、气象系统,以及整个正在发生的世界(也包括正在上课的一个朋友)。
- Fact:北京某地在今天下午三点发生了降雨。
- Truth:我真正相信的“我认为外面正在下雨”这个信念。
Fact 是世界中成立的事情(客观性);Truth 是我们对事情所作判断的性质(带有主观性);Reality 是这些事情所处的整个世界(客观性和主观性消融的地方)。
选美博弈:为什么 Truth 不等于 Reality?
游戏:100 个人在 0 到 100 之间选择数字,目标是尽可能接近所有数字平均数的 2/3。
Nash 均衡的博弈结果:0
历史上某次实验的实际平均数:30
现在分别用三个概念看待这个游戏。
Nash 均衡的 Truth 在什么条件下成立?
在标准规则下,所有人都选择 0,是唯一纳什均衡。这是一个正确的数学结论。
但它并不是在说:“无论现实参与者怎么思考,实际平均数都会是 0。”
Fact:这次实际发生了什么?
参与者的平均数确实是 30
即使有人坚信所有人应该选择 0,也不能改变已经提交的数字。
Reality:现实是什么?
现实不仅包含数字,还包含参与者不同的认知能力(推理深度)、对别人行为的预期、奖励机制、信息与互动过程。
这些共同决定了最后的游戏结果。
最有意思的是:人们的信念,即使不正确,也会成为现实中的因果力量。一个错误的信念,可以产生真实的后果。但这些真实的后果,不能证明最初的信念是正确的。
比如,大量参与者相信“别人都会选择 33”,于是自己选择 22。他们的信念未必正确,但他们的选择会影响最终平均数。
凯恩斯在 1936 年的《通论》第 12 章中,正是用选美竞赛说明金融市场中这种高阶预期的作用。
例子:为什么市场上涨不等于公司优秀?
假设一家公司的股价从 100 元涨到 200 元。
现在有三个人:
甲是基本面分析师,认为公司长期合理价值只有 80 元。
乙是短线交易员,认为市场热度还能推动价格上涨到 250 元。
丙是公司创始人,认为自己的技术将改变整个行业。
视角 当前能够知道什么? 还不能确定什么? Fact 股价已从 100 元上涨至 200 元 无法仅凭涨幅判断长期价值 Truth 各人真实持有的信念会影响未来的行动和现实 这些信念本身会创造出什么样的世界 Reality 公司经营、资金流动、交易机制、市场预期都实际存在且相互作用 没有人能仅靠单一模型掌握全部动态 值得培养的能力
我真正观察到了什么?哪些是可复核的数据,哪些只是别人转述的判断?避免把观点当作事实。
我的结论在什么前提下成立?证据是否真正支持结论?有没有其他解释?避免把逻辑自洽当作必然正确。
在真实约束下,参与者如何行动?我的行动又会改变什么?当结果与模型冲突时,我如何更新判断?
避免把理论上应该发生的事,当作现实中一定会发生的事。
Reality is what is. Reality 是实际存在和发生的一切,不以我们的理解是否完整为转移。
Facts are what is the case. Facts 是现实中具体成立的事情,不以我们的喜好为转移。
我们生活在 Reality 中,通过经验和证据认识 Facts,努力作出符合 Truth 的判断;但我们的判断又会影响行动,而行动能够参与塑造未来的 Reality。
 PipaQinse233 Post #432
炸洋葱确实好吃
J'aime l'oignon frit à l'huile, 我爱油炸的洋葱! J'aime l'oignon car il est bon. 我爱美好的洋葱! J'aime l'oignon frit à l'huile, 我爱油炸的洋葱! J'aime l'oignon, j'aime l'oignon. 我爱洋葱!我爱洋葱! Au pas camarades, au pas camarades, 前进!同志!前进!同志! Au pas, au pas, au pas, 前进!前进!前进! Mais pas d'oignons aux Autrichiens,没有洋葱留给奥地利人,Non pas d'oignons, non pas d'oignons没有洋葱!没有洋葱!


Kaiserscharrn是一种来自奥地利的美味甜点,说白了就是一种口感松软的薄煎饼,配有葡萄干和焦糖杏仁,上菜时配苹果酱或者糖渍李子。
Hier ist ein Kaiserscharrn-Rezept(这是其菜谱):- 将4个蛋黄与125克面粉、125毫升牛奶、一小撮盐、1茶匙发酵粉和40克糖混合,静置10分钟。
- 将4个蛋清搅打至浓稠,然后拌入面糊中。再添加40克葡萄干。
- 在平底锅中加入2茶匙黄油,将混合物放到锅中,开中火烘烤。将煎饼翻面,再加2茶匙黄油。烤至金黄,撕成小块,洒上糖粉。
尽情享用吧!Gute Appetit!
 darren lana Post #15
话说这种西工大加俄罗斯交换 buff 叠满的人还能润哪,去香港也没对口的工作吧
 AI Post #5
人教人,教不会,事教人,一次就够
-
 紫金港第一皮革<・)))><< Post #178
个人感觉三部曲里面 1984 是最好看的 无论是文笔还是叙事深度 美丽新世界排第二《我们》相对来说最无聊(其实感觉看了前两本可以不看它)
- 紫金港第一皮革<・)))><< Post #172
鼠鼠好可爱!
可能是碎碎念
其实我之前选过生命科学导论这个通识课 有次去动物实验室参观 甚至可以在老师指导下摸鼠鼠 手感真的很好🥹
翻了一下聊天记录 原来那天还看到了鼠鼠打架 打架的时候还会吱吱叫
而且当时面对一排排装着小鼠的架子然后老师在讲它们的温度食物供应这些条件都可以控制 有种美丽新世界开头参观胚胎实验中心的感觉 - JJody Post #6
欢迎来线下活动
-
 无状态垃圾桶 Post #20
看到了很厉害的人,突然感觉自己是废物,总是有这样幼稚的情绪呢 🫠
- 无状态垃圾桶 Post #9
现在是 Oct 8, 2026, 10:34:49 PM (Asia/Shanghai),兴庆这边 IPv6 入站全部不通,IPv4 只允许 UDP 入站,而且好像没有 conntrack 随便入站
Minecraft 应该需要建立 TCP 连接吧?可以考虑搭个 WireGuard 再从隧道连或者用 FRP
- JJody Post #1
你社目前处于半死半活状态,零基础或者大佬都欢迎加入。大佬可以来给大伙做做讲座啥的。这学期主要方向就是 AI Infra。群号:863989538。尤其欢迎活跃的主动的,直接安排副职
 玉米🌽 Post #277
今天在 xhs 上一个帖子的评论区宣传你門了,不知是否会有新門友加入
-
 hoist Post #1
略读了这本科学哲学概论书 "What is this thing called Science" by AF Chalmers.
见过几个老师言必称范式,不无道理。范式论把“历史”的视角引入了对科学的解释。科学发展被概括为几个阶段,前科学--常规科学--危机--科学革命--新的常规科学--新的危机。前科学表示那些不成熟的科学理论范式;而当范式成熟,就有人在认同范式的假设下,进行实验和对现象做出解释;当范式对新的现象给出的解释过于牵强、甚至失败时,危机到来;而新的更具解释力的范式趁机获得的对原范式动摇的支持者,正是所谓科学革命。
这套理论挺有优势,我想能解释为何民科一些很难验证真假的理论根本没人管,因为民科理论不在常规范式中论述,提出的新范式的生命力又远远比不过常规范式,被冷落也是自然的。
这理论还有缺点,比如没解释新范式为何进步。但是我不研究科学哲学,从实用角度,其他理论对我意义不大,如“研究纲领”(和范式类似)、“新实验主义”、“无政府主义科学”。了解科学哲学,不至于被一连串黑乌鸦后的白乌鸦唬住,也就够了。
- 紫金港第一皮革<・)))><< Post #273
看了一天的亚运会 快乐
- 我有魔芋爽 Post #122
9.27
申请书终于提交了!前几天都没睡安稳,不敢打开微信,怕是导师消息刷屏
一闲下来(其实还有一堆事情赶快去做!)暑假伤心的回忆又开始闪回……闪回着发现马上又要去上学了🤣
现在看来还是要对自己的长处和短处更加了解
比如我不太懂人心也不擅长维系形象和关系,就不要刻意强求这些;让我痛苦的人,一定要远离
总之自己开心最重要!看到一个很有意思的视频:
- 无状态垃圾桶 Post #3
就开始几天用得多,后面烦了
- 我没什么必须要完成的任务,更多是兴趣
- 我喜欢的是写东西时能力变强的感受,vibe 我只觉得累
- agent 写的设计模式和风格我不喜欢,我有强迫症(
- agent 做架构设计还是太拉了(可能因为我用拼好模
- 无状态垃圾桶 Post #5
糊了一个 神秘博客,但是不知道发啥 🫠
感觉以我的能力写任何东西都只是把更高质量的内容蒸馏成垃圾请大家持石
- ascah Post #299
说是学术圈,其实还是权力,是官场。学术官僚和行政官僚似乎并没什么不同,都可以用权力攻击异己,扶植党羽。然后主导话语权,利用话语权进行利益分配。应该说中国的高等教育体系为这些人供给了庞大的劳动力,就业基本面的下滑助长了这一点,中国人有强烈的读硕博的热情。长远说,经费毕竟受制于财政,利益集团又要提前分赃,留给一般科研人其实不算多,科研迟早要过紧日子。我感到科研并非是真的为了纯洁的理想,科研是证明职业科学家能保有位置的手段,科研是为了科研而科研。对于一般想就业的人,科研也不过是获得学位的敲门砖。它并不神圣。就算非升即走如此严苛,架不住潮水一般的博士涌向高校,总是不缺人。就像考公一样,考公那么竞争激烈,不妨碍几千人考一个岗。僧多粥少。所以大学给了美好前途的幻相,却总会在大学之后才把事实拿给人看。竞争哪里终结了?竞争相伴一生。老说幸福都是奋斗出来的,我奋斗到什么时候才是个头?我幸福是因为我祖上入过关,我祖上是三世家业。你个泥腿子,也配?
- 玉米🌽 Post #274
好久没在門上更新日常了。。。最近买了一个手办,给門友展示一下喵
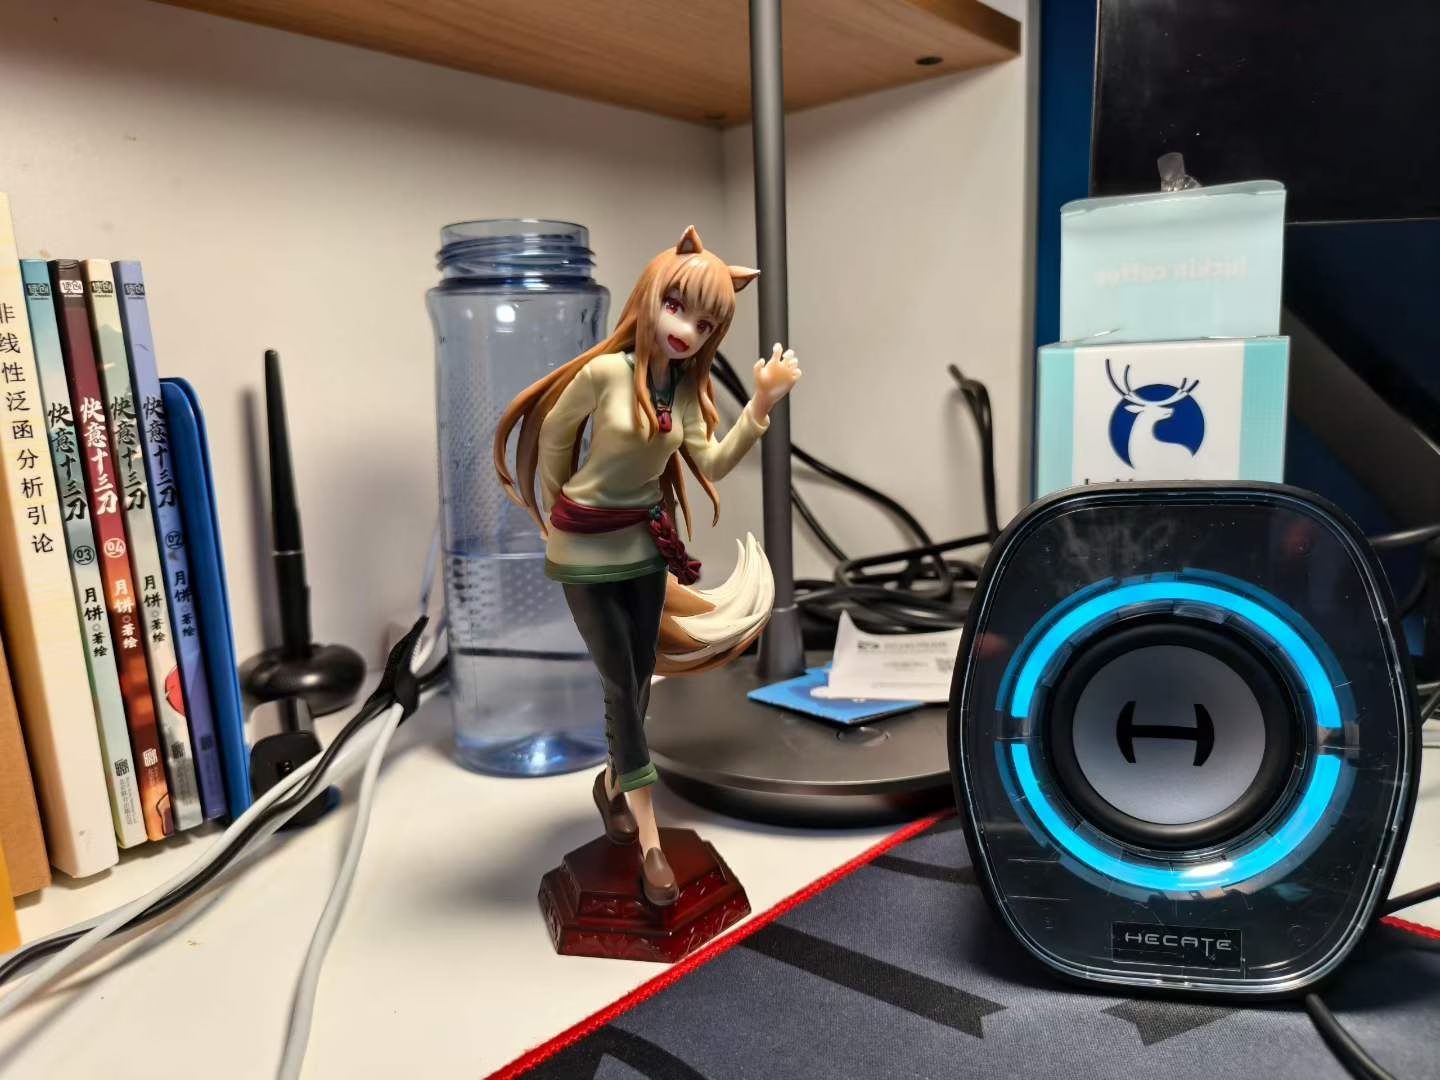
这是俺人生中第一个手办(39r 购于 pdd 的微瑕品)
- 我有魔芋爽 Post #79
最近状态好了一些,和原来的圈子淡了或断了很多……喜欢有秩序有安全感的生活,不喜欢情绪大起大落。接下来向我走来的是三个实验报告和答辩 ppt!
- 我有魔芋爽 Post #80
前几天又摸了一张阿农
即使失败一次 也得相信自己还能重新开始
不然人生这么长 会撑不住哦 - IIO Post #1
Chapter 1. The Characters of the Story
故事中的人物
自动模式下的思维
要观察你的大脑在自动模式下是如何运作的,请看下面的图片。
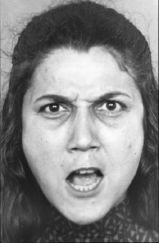
图 1
当你注视这个女人的脸时,你的体验无缝地融合了我们通常所说的视觉感知和直觉思维。你看到年轻女人的头发是深色的,同时也迅速而确定地知道她很生气。此外,你的感知还延伸到了未来。你感觉这个女人马上就要说出一些非常刻薄的话,而且很可能会用响亮、尖锐的声音说出来。她接下来可能会做什么,你的脑海中自动且毫不费力地浮现出一种预感。
你并没有打算评估她的情绪,也没有打算预测她可能做什么;你对这幅图片的反应也不像是你主动做出的某种行为。它就这样发生在你身上。这就是快速思考的一个例子。
现在看看下面这个问题:
17 × 24
你立刻知道这是一个乘法问题,也很可能知道,即使不能心算,也可以用纸笔算出答案。你对可能的结果范围有一些模糊的直觉。你会很快意识到,12,609 和 123 都不太可能是正确答案。然而,如果不花一些时间计算,你无法确定答案不是 568。
一个精确的答案并没有立即浮现在脑海中,而且你感觉自己可以选择是否要进行计算。如果你还没有尝试,现在应该做一下这道乘法题,至少完成其中一部分。
当你一步步进行计算时,你体验到了慢速思考。首先,你从记忆中调取了在学校学过的乘法认知程序,然后执行它。完成计算需要付出努力。你必须在记忆中保持大量信息,既要记住自己进行到了哪一步、下一步要做什么,又要保留中间结果。
这个过程是一种心理劳动:有意识的、费力的、井然有序的——它是慢速思考的典型例子。计算不仅仅发生在你的头脑中,你的身体也参与其中。你的肌肉绷紧,血压升高,心率加快。如果有人仔细观察你计算时的眼睛,就会发现你的瞳孔扩大。当你结束计算——找到答案(顺便说一下,答案是 408),或者放弃时——你的瞳孔就会恢复到正常大小。
两个系统
几十年来,心理学家一直对由愤怒女人的图片和乘法问题所引发的两种思维模式非常感兴趣,并为它们提出了许多不同的称呼。我采用心理学家 Keith Stanovich 和 Richard West 最初提出的术语,将心智中的两个系统称为系统 1 和系统 2。
- 系统 1 自动且快速地运行,几乎不需要努力,也没有自主控制的感觉。
- 系统 2 将注意力分配给需要努力的心理活动,包括复杂的计算。系统 2 的运作通常伴随着主观上的能动感、选择感和专注感。
系统 1 和系统 2 这两个称呼在心理学中被广泛使用,但在本书中,我比大多数人更进一步。你可以把本书读成一部由两个角色共同出演的心理剧。
当我们思考自己时,我们认同的是系统 2:那个有意识、会推理的自我,它拥有信念、做出选择,并决定思考什么以及采取什么行动。尽管系统 2 认为自己才是行动的主角,但自动运行的系统 1 才是本书的主人公。
我将系统 1 描述为一个毫不费力地产生印象和感受的系统,而这些印象和感受正是系统 2 形成明确信念和做出有意识选择的主要来源。系统 1 的自动运作能够生成出人意料的复杂思想模式,但只有更缓慢的系统 2 才能按照有序的步骤构建思考过程。
我也会描述一些情形:系统 2 接管了控制权,压制系统 1 那些自由奔放的冲动和联想。你将被邀请把这两个系统想象成拥有各自能力、局限和功能的行动者。
系统 1 的例子
按照大致的复杂程度排列,以下是一些归属于系统 1 的自动活动:
- 发现一个物体比另一个物体距离更远。
- 转向突然发出声音的来源。(Orient to the source of a sudden sound.)
- 补全短语“面包和……”
- 看到可怕的图片时做出“厌恶的表情”。
- 从声音中察觉敌意。
- 回答 2 + 2 = ?
- 读出大型广告牌上的文字。
- 在空旷的道路上开车。
- 在国际象棋中找到一步强有力的棋着(如果你是国际象棋大师)。
- 理解简单的句子。
- 认识到“一个温和整洁、热爱细节的灵魂”与某种职业刻板印象相似。
所有这些心理事件都与那个愤怒的女人相关——它们会自动发生,几乎不需要努力。
系统 1 的能力包括我们与其他动物共有的先天技能。我们生来就具备感知周围世界、识别物体、转移注意力、避免损失以及害怕蜘蛛的准备。
其他心理活动则会通过长期练习变得快速而自动。系统 1 学会了思想之间的联想(法国的首都是哪里?);它也学会了阅读,以及理解社会情境中的微妙之处。
有些技能,例如找到强有力的棋着,只有专业高手才能获得。另一些技能则被广泛共享。要识别一段人格描述与某种职业刻板印象之间的相似性,需要掌握广泛的语言和文化知识,而我们大多数人都具备这些知识。这些知识储存在记忆中,可以在没有意图、也不费力的情况下被提取。
上述心理活动中,有些是完全不由自主的 (involuntary)。你无法避免理解自己所使用语言中的简单句子,也无法阻止自己把注意力转向突然响起的巨大声音;你也无法阻止自己知道 2 + 2 = 4,或在听到“法国的首都”时想到巴黎。
另一些活动,例如咀嚼,可以受到意志控制,但通常会以自动驾驶的方式运行。注意力的控制由两个系统共同承担。转向巨大声音通常是系统 1 的不由自主的操作,它会立即调动系统 2 的自主注意力。
在拥挤的聚会上,你也许能够克制自己,不转头去看那个大声且冒犯性地发表评论的人。但即使你的头没有转过去,你的注意力最初仍会被吸引到那个声音上,至少会持续一段时间。不过,你可以通过集中精力关注另一个目标,把注意力从不想关注的事物上移开。
系统 2 的活动
系统 2 的各种活动虽然差异很大,但有一个共同特征:它们需要注意力,而且当注意力被转移时,就会受到干扰。以下是一些例子:
- 在赛跑中等待发令枪响。
- 将注意力集中在马戏团里的小丑身上。
- 在拥挤嘈杂的房间里,专注于某个人的声音。
- 寻找一个白头发的女人。
- 搜索记忆,以辨认一个令人惊讶的声音。
- 保持比你平时自然步行速度更快的速度。
- 监控自己在社交场合中的行为是否得体。
- 数一页文字中出现字母 a 的次数。
- 告诉别人你的电话号码。
- 将车停进狭窄的车位(对大多数人而言如此,车库管理员除外)。
- 比较两台洗衣机的总体性价比。
- 填写税务表格。
- 检查一个复杂逻辑论证的有效性。
在所有这些情境中,你都必须集中注意力。如果你没有做好准备,或者注意力被不恰当地引向其他地方,你的表现就会下降,甚至完全无法完成任务。
系统 2 具备一定能力,可以通过规划(programme)通常自动运行的注意力和记忆功能,改变系统 1 的工作方式。
例如,当你在繁忙的火车站等待亲人时,你可以主动让自己寻找一个白头发的女人或一个留胡子的男人,从而增加远距离发现亲人的可能性。你可以让记忆去搜索以 N 开头的首都,或法国存在主义作家的小说。当你在伦敦希思罗机场租车时,工作人员可能会提醒你:“这里靠左侧行驶。”
在这些情况下,你被要求做一些并不自然的事情,而你会发现,要持续维持这种状态,至少需要不断付出一些努力。
“集中注意力”(pay attention)这个常用短语非常恰当:你拥有一份有限的注意力预算,可以将它分配给不同的活动。如果你试图超出这份预算,就会失败。
费力活动的一个特征是它们会相互干扰,这也是为什么很难或不可能同时进行多个费力活动。你不可能一边在车流密集的路口左转,一边计算 17 × 24,而且你绝对不应该这样做。
你可以同时做几件事,但前提是这些事情简单且不需要太多努力。你大概可以一边在空旷的高速公路上开车,一边与乘客交谈。许多父母也许带着些许内疚地发现,他们可以一边给孩子读故事,一边思考其他事情。
每个人都对注意力的有限容量有所认识,我们的社会行为也会考虑到这些限制。例如,当汽车司机在狭窄道路上超越卡车时,成年乘客通常会很明智地停止交谈。他们知道分散司机的注意力不是好主意,而且也猜到司机暂时“聋了”,听不见他们说的话。
注意力导致的视而不见
高度集中于某项任务,可能使人实际上对某些刺激视而不见,即使这些刺激通常会吸引注意力。
最著名的演示来自 Christopher Chabris 和 Daniel Simons 的著作《看不见的猩猩》(The Invisible Gorilla)。他们制作了一部短片,画面中有两支队伍在传篮球:一队穿白色球衣,另一队穿黑色球衣。观看者被要求数出白队传球的次数,同时忽略黑队球员。
这个任务很难,也非常吸引注意力。视频播放到一半时,一个穿着大猩猩服装的女人出现在场上,穿过球场,捶打自己的胸口,然后离开。大猩猩在画面中出现了 9 秒。
成千上万的人看过这段视频,其中约有一半没有注意到任何异常。这种“视而不见”是由于对传球次数的计数任务,尤其是还要忽略其中一支球队的要求造成的。如果没有这个任务,观看视频的人不会错过大猩猩。
看见(seeing)和转向(?orienting)是系统 1 的自动功能,但它们依赖于将一定程度的注意力分配给相关刺激。研究作者指出,他们的研究中最令人惊讶的发现是:人们会对结果感到非常意外。那些没有看到大猩猩的观看者起初确信大猩猩根本不在画面中——他们无法想象自己竟然会错过如此明显的事件。
大猩猩实验说明了关于我们心智的两个重要事实:
- 我们可能对显而易见的事物视而不见(blind to the obvious)。
- 我们甚至意识不到自己正在视而不见(blind to our blindness)。
故事梗概(Plot Synopsis)
两个系统之间的互动是本书反复讨论的主题,因此有必要简要介绍一下故事情节。
在我将要讲述的故事中,只要我们处于清醒状态,系统 1 和系统 2 就都在活动。系统 1 自动运行,而系统 2 通常处于一种舒适、低努力的模式 (a comfortable low-effort mode) 中,只有一部分能力被调动起来。
系统 1 不断向系统 2 提出建议:印象、直觉、意图和感受。如果系统 2 认可这些建议,印象和直觉就会变成信念,冲动就会变成自主行动。
当一切顺利时——而大多数时候确实如此——系统 2 几乎不加修改地接受系统 1 的建议。你通常相信自己的印象,并按照自己的欲望行动,而这通常没有问题。
当系统 1 遇到困难时,它会请求系统 2 提供支持,以进行更详细、更具体的处理,从而解决眼前的问题。当出现一个系统 1 无法回答的问题时,系统 2 就会被调动起来,这很可能就是你遇到 17 × 24 这道乘法题时发生的情况。
当你感到惊讶时,也会体验到一阵有意识的注意力涌现 (a surge of conscious attention)。当某个事件违背了系统 1 所维持的世界模型时,系统 2 就会被激活。在那个世界里,台灯不会跳跃,猫不会吠叫,大猩猩也不会穿过篮球场。
大猩猩实验表明,要察觉令人惊讶的刺激,需要一定程度的注意力。惊讶随后会激活并引导你的注意力:你会盯着那个事件,并搜索记忆,试图找到一个能够解释它的故事。
系统 2 还负责持续监控自己的行为——这种控制让你在生气时保持礼貌,让你在夜间开车时保持警觉。当系统 2 察觉到一个错误即将发生时,它会被调动起来,付出更多努力。
回想一下,你曾经差点脱口而出一句冒犯性的话,然后努力恢复自我控制的经历。
总而言之,你(也就是你的系统 2)所思考和做的大多数事情都源自系统 1,但当事情变得困难时,系统 2 会接管,并且通常拥有最后的决定权。
系统 1 和系统 2 的分工非常高效:它减少了努力,并优化了表现。这种安排在大多数时候运行良好,因为系统 1 通常非常擅长自己的工作:它对熟悉情境的模型是准确的,对短期事件的预测通常也很准确,而它对挑战的初始反应迅速且大体恰当。
然而,系统 1 也存在偏差,即它在特定情境下容易犯的系统性错误。正如我们将看到的,它有时会回答一个比实际问题更容易的问题,而且对逻辑和统计学的理解很有限。
系统 1 的另一个局限是:它无法被随意关闭。如果屏幕上出现一个你认识的语言中的单词,你就会读出它——除非你的注意力完全集中在别的地方。
冲突
图 2 是一个经典实验的变体,它会制造两个系统之间的冲突。请先尝试完成这个练习,再继续阅读。
图 2
你几乎肯定能够在两项任务中说出正确的词语,而且你一定发现,每项任务中有些部分比其他部分容易得多。
当你识别大小写时,左栏很容易,而右栏会让你放慢速度,甚至结结巴巴。当你说出词语的位置时,左栏很难,而右栏则容易得多。
这些任务会调动系统 2,因为当你看到一列单词时,说出“大小写”或“左/右”并不是你平时惯常做的事情。
为了完成任务,你需要做的一件事,是对记忆进行预设(program),使相关词语(第一项任务中的“大写”和“小写”)处于“嘴边”。在第一栏中,优先处理选定的词语很有效,而抵抗阅读其他词语的轻微诱惑也相当容易。
但第二栏有所不同,因为它包含了那些你已经准备要说出的词语,你无法忽略它们。你大多能够正确回答,但克服相互竞争的反应需要努力,也会使你放慢速度。
你体验到了一种冲突:你有意执行的任务,与一个干扰它的自动反应发生了冲突。
自动反应与控制它的意图之间的冲突,在我们的生活中很常见。我们都熟悉这样的经历:努力不去盯着餐厅邻桌那对穿着奇怪的情侣。我们也知道,强迫自己专注于一本无聊的书是什么感觉——我们不断发现自己又回到了阅读失去意义的那个位置。
在冬季严寒的地方,许多司机都记得汽车在冰面上打滑、失去控制的经历,也记得自己努力遵循那些与自然反应相反的驾驶指令:“朝打滑方向打方向盘,无论如何都不要踩刹车!”
⚠️关于打滑时如何驾驶的现代建议 by Gemini 3.8
1. “朝打滑方向打方向盘”(Steer into the skid)—— 基本正确,但表述极易引起歧义
- 实际操作:如果车尾向左甩出(过度转向 / 甩尾),你应该将方向盘向左转,使前轮指向你真正想去的方向。
- 常见误区:很多人听到“朝打滑方向”会以为是“车头偏离的方向”,从而向相反方向反打,导致车辆剧烈打转(Spin)。因此,现代安全驾驶更推荐的记忆口诀是:眼睛看想去的路,方向盘就打向想去的方向。
- 关键要点:反打幅度必须适度且回正要快。一旦车身开始回正,若不及时回正方向盘,车辆会迅速向相反方向甩尾(产生“鱼尾摆”或“钟摆效应”)。
- 转向不足(推头)例外:如果打滑是车头推头(前轮失去抓地力,转方向盘车子直冲),此时继续往弯心多打方向盘毫无作用,反而应该稍微回正一点方向盘并收油,让前轮重新找回附着力。
2. “无论如何都不要踩刹车!”—— 严重过时且在现代车辆上是错误的
这一口诀源自几十年前没有 ABS(防抱死制动系统)的机械时代。当时如果一脚刹车踩死,车轮抱死失去抓地力,车辆会完全丧失转向能力,只能听天由命。
-
现代汽车(标配 ABS / ESP):
- 在发生紧急险情或失控时,正确的做法是果断、坚决地踩死刹车。ABS 会以每秒数十次的高频点刹防止车轮抱死,行车电脑(ESP/ESC)会通过对单个车轮独立施加制动力来强行纠正车身姿态。
- 踩下刹车的同时,驾驶员依然可以转动方向盘避障。
-
仅有的例外:
- 仅在轻微甩尾但车辆仍处于可控范围内时,可以“松开油门、暂不急踩重刹”,仅通过反打方向修正姿态。
- 但一旦失去控制或即将碰撞,“不踩刹车”只会让车带着高速滑向障碍物。
现代冰雪路面失控处理指南
- 松开油门:切断动力输出,让车身重量自然前移。
- 视线指引方向:眼看逃生路线,方向盘柔和指向目标方向,车身修正时迅速回正。
- 踩死刹车(现代配有 ABS 的车):如需减速或无法通过轻微反打救回,全力将刹车踏板踩到底,不要松开,也不要自己人工“点刹”,让 ABS 和车身稳定系统全功率工作,同时握稳方向盘修正轨迹。
每个人都有过忍住不对别人说“滚开”的经历。
系统 2 的任务之一,就是克服系统 1 的冲动。换句话说,系统 2 负责自我控制。
错觉
为了理解系统 1 的自主性,以及印象和信念之间的区别,请仔细观察图 3。
这幅图很普通:两条长度不同的水平线,末端带有朝不同方向的箭头。下面那条线显然比上面那条长。这是我们所有人都会看到的,也是我们自然会相信的。
不过,如果你以前见过这幅图,就会认出它是著名的缪勒 - 莱尔错觉 (Müller-Lyer illusion)。你可以很容易地用尺子测量它们,确认两条水平线实际上长度相同。
图 3
现在你已经测量过这两条线了,你——也就是你的系统 2,那个被你称为“我”的有意识存在——获得了一个新的信念:你知道两条线一样长。
如果有人问你它们的长度,你会说出自己知道的答案。但你仍然会把下面那条线看得更长。你选择相信测量结果,却无法阻止系统 1 按照自己的方式运作;你无法决定让自己把两条线看成一样长,尽管你知道它们确实一样长。
要抵抗这种错觉,你唯一能做的就是学会:当平行线末端带有箭头时,不要轻信自己对线条长度的直觉。
要执行这条规则,你必须能够识别出这种错觉模式,并回忆起自己对它的了解。如果你能做到这一点,就再也不会被缪勒 - 莱尔错觉欺骗。
但你仍然会看到其中一条线比另一条长。
并非所有错觉都是视觉上的。我们还存在思维上的错觉,也就是所谓的认知错觉 (cognitive illusions)。
我读研究生时,参加过一些关于心理治疗艺术与科学的课程。在其中一次讲座中,老师传授了一点临床智慧。他这样告诉我们:
你有时会遇到一位患者,他讲述了自己在以往治疗中犯下的一连串令人不安的错误。他曾被几位临床医生接诊,但所有人都辜负了他。患者能够清晰地描述治疗师是如何误解他的,但他很快就察觉到你与他们不同。你也有同样的感觉,相信自己理解他,并且能够帮助他。
讲到这里,老师提高了声音:
千万不要考虑接收这位患者!把他赶出诊室!他很可能是一个精神变态者 (psychopath[1]),而你无法帮助他。
许多年后,我了解到,老师是在提醒我们警惕精神变态者的魅力,而研究精神变态的权威人士也证实了老师的建议是有道理的。
这与缪勒 - 莱尔错觉非常相似。我们所学的并不是应该如何看待那位患者。老师理所当然地认为,我们对患者产生的同情并不受自己的控制;这种同情会源自系统 1。
此外,我们也不是被教导要普遍怀疑自己对患者的感受。我们被告知的是:一个有反复治疗失败经历的患者,如果让你产生强烈的吸引力,这就是一个危险信号——就像平行线末端的箭头一样。
这是一种认知错觉,而我(系统 2)被教导如何识别它,并被建议不要相信它,也不要据此采取行动。
人们最常提出的关于认知错觉的问题,是它们能否被克服。上述例子传达的信息并不令人乐观。
由于系统 1 自动运行,无法随意关闭,因此直觉思维中的错误往往很难预防。偏差并不总能被避免,因为系统 2 可能根本没有意识到错误的存在。
即使有迹象提示可能出现错误,也只有通过系统 2 加强监控、付出更多努力,才能防止错误。
然而,作为一种生活方式,持续保持警惕并不一定是好事,而且肯定不切实际。不断质疑自己的思维会令人难以忍受地疲惫,而系统 2 过于缓慢、效率过低,无法替代系统 1 来处理日常决策。
我们能做的最好选择是一种折中方案:学会识别容易犯错的情境,并在事情事关重大时,更加努力地避免严重错误。
本书的前提 (premise) 是:识别他人的错误,比识别自己的错误更容易。
有用的虚构
我们已经被邀请把这两个系统想象成心智中的行动者,各自拥有独特的性格、能力和局限。
我经常会使用这样的句子:“系统 2 计算乘积。”
在我所处的专业圈子里,这种语言被认为是一种错误,因为它似乎是在用一个人头脑中的小人,来解释这个人的思想和行动。
我的同事会指出,“管家偷走零钱”这句话在语法上与“系统 2 计算乘积”相似。管家的行为确实解释了现金为什么消失,而他们合理地质疑:关于系统 2 的那句话,是否真的解释了乘积是如何被计算出来的?
我的回答是:将计算归因于系统 2 的那句简短主动句,意图是进行描述,而不是解释。
它之所以有意义,只是因为你已经了解系统 2。它是下面这段话的简写:
心算是一种需要自主进行的活动,需要付出努力,不应该在左转时进行,而且伴随着瞳孔扩大和心率加快。
同样,“在常规条件下,高速公路驾驶由系统 1 负责”意味着:沿着弯道转动方向盘是一种自动的、几乎不费力的活动。它还意味着,有经验的司机可以在空旷的高速公路上开车,同时进行交谈。
最后,“系统 2 阻止了詹姆斯对侮辱做出愚蠢的反应”意味着:如果他进行费力控制的能力受到干扰,例如喝醉了,他的反应就会更加具有攻击性。
系统 1 和系统 2 对我在本书中讲述的故事如此重要,以至于我必须明确说明:它们是虚构的人物。
系统 1 和系统 2 并不是通常意义上的系统,不是由相互作用的实体或部分构成的系统。大脑中也不存在某个部分,可以被这两个系统中的任何一个称为自己的家。
你可能会问:为什么要在一本严肃的书中引入两个名字难听的虚构人物?
答案是:这些人物之所以有用,是因为我们的心智——你的和我的——存在一些奇特之处(quirks)。
如果一句话描述某个行动者(系统 2)做了什么,而不是描述某个事物是什么、具有什么属性,那么这句话会更容易理解。
换句话说,“系统 2”比“心算”更适合作为句子的主语。
心智,尤其是系统 1,似乎特别擅长构建和理解关于主动行动者的故事。这些行动者拥有性格、习惯和能力。
你很快就会对那个偷窃的管家形成坏印象,期待他做出更多坏事,并且会记住他一段时间。这也是我希望通过系统的语言实现的效果。
为什么称它们为系统 1 和系统 2,而不是更具描述性的“自动系统”和“费力系统”?
原因很简单:“自动系统”说起来比“系统 1”花的时间更长,因此会占用更多工作记忆空间。而这很重要,因为任何占据工作记忆的东西,都会降低你的思考能力。
你应该把“系统 1”和“系统 2”当作昵称,就像 Bob 和 Joe 一样,用来指代你将在本书中逐渐熟悉的两个角色。
这些虚构的系统使我更容易思考判断与选择,也会让你更容易理解我的论述。
关于系统 1 和系统 2 的说法
“他产生了一个印象,但他的某些印象是错觉。”
“这是一个纯粹的系统 1 反应。她在意识到威胁之前,就已经做出了反应。”
“这是你的系统 1 在说话。慢下来,让你的系统 2 接管控制权。”
a** person suffering from a serious mental illness that causes them to behave in a violent way towards other **people ↩︎
- 紫金港第一皮革<・)))><< Post #245
因为这学期早八多
所以暂且立一个十一点之前躺到床上的 flag
希望能实现
浑浑噩噩地度过了一天
但自己都能意识到精神无时无刻不高度紧张
现在异常平静 也可能是崩溃够了于是开始麻木了 - ascah Post #277
有两个想法:一,先有不完美的,再去追求完美的。不完美是完美的准备阶段。二,要能扛住事,不要提前动员。事情还有长的时间,就不动员。到了临事的关头,再动员。如果不该动员的时候动员了,总体上还是会疲惫。什么是动员?我觉得就是精神上紧张,做很多心理建设,反复推演。早早地把自己动员起来,总是要捏一把汗,或者提心吊胆一波。虽说事情结束后会如释重负,但是长时间精神紧张,事后会觉得没必要太大负担。
-
 ᐕ)ノ Post #51
我也非常喜欢!非常喜欢这几首!
第二章的音乐总是让我幻听到果冻里穿梭的音效 后面的追逐战也非常紧张刺激
 醒来的那一段钢琴好平静 记得第二章蓝心处 写着一句诗
Awake, my heart is a fortress. In dreams I am vulnerable.
第五章寺庙的音乐 我也曾经试着弹了一下 和它的名字一样 quiet
就像沉入大洋底部镜中世界,充满了不安,这部分音乐给我的印象也很深刻。正如 theo 见证了 madeline 一样,我的 5a 金也是在直播时好友的见证下炼成的
第七章 向山顶重新出发的时候,旋律唤起了一路上的记忆
 不知道我何时才能和 madeline 一样登上属于我自己的 celeste 山顶呢?
另外除了这部分音乐 我还特别喜欢第九章的音乐,虽然我只能磕磕绊绊地通过这一高难度章节🫠
那段时间只要在做可以听音乐的事情时 我都在循环地听 哪怕是睡觉也让它们在一旁播放 我已经感觉到它们成为了我那段生活里的 bgm,直到现在再次听它们的时候 闭上双眼还是会感觉回到了那些日子
- ᐕ)ノ Post #47
蔚藍是最棒的遊戲,我太愛這的音樂了,休學前後玩了好久,感覺算是支持我活下去的動力(?)每次聽都會感覺回到了那段時間,儘管那些時候很痛苦,但伴隨著這些 bgm 的時候都是平靜的
- 无状态垃圾桶 Post #46
Celeste Original Soundtrack - Lena Raine
- ZZethes Post #4
清华数学系主任刘思齐的评价
- 玉米🌽 Post #1
- 紫金港第一皮革<・)))><< Post #237
非常满意的一顿饭😋
博多天一的和牛寿喜烧定食 + 江西鲲茶的客家米酿(感觉和卡旺卡的徽州酒酿有点像 都很好喝)
 Komeiji_Koishi Post #46
他专门给这种科幻尤其是轮回作品写曲子的,他是 5pb 社长。。。虽然其实挺多人批评他作曲挺流水线的(我也觉得寒蝉曲子不错
- R保密 Post #42
寒蝉卒/业虽然烂到头了,但几首 op/ed 我真的很喜欢
I believe what you said
神様のシンドローム
不規則性エントロピー
Analogy
Missing Promise顺带一提我觉得志仓千代丸好厉害呀,见过他的名字很多次,虽然没有深入了解过 (
21-22 年那片每晚坐等寒蝉业,老期待了
 Rei Suzunami Post #40
先简单埋个坑 具体细节如原名配图等后面补上
Neon Genesis Evangelion / Rebuild of Evangelion Series
- THANATOS
- come, sweet death
- Good, or don't be
- THE HEADY FEELING OF FREEDOM
- LOVE ANTIQUE
- 魂之轮回
- F02 verison 0706
- paris
- 心*原始*戾
- hand of fate
- You are the only one
不得不说 EVA 系列的配乐真的每一个音符都写在我心头上了,能坚持给每部作品都录原创管弦配乐的商业片真的不多
Steins; Gate Series
- Hacking to the Gate
- 天空复层的观测者
只记得当时每看几集再听这个 OP 感觉都不一样,燃但不止于燃
Fate
- 运命之夜
已经不记得是哪出现的了但川井宪次永远不会让我失望
Devilman Crybaby
- MAN HUMAN
迷幻但好听的曲子!
CHAINSAWMAN
- Time Lapsed
Zutomayo 的爵士味编曲我真的爱了 虽然到现在也没看过这片子
Cowboy Bebop
- OST 全部收录曲目
最后放个菅野洋子老师著名作品 全体起立!


